
Créer un système de recherche hors ligne de défauts visuels à l'aide de CLIP et de la base de données VectorAI


Points clés à retenir
- CLIP et la base de données Actian VectorAI permettent aux fabricants d'effectuer des recherches d'images de défauts à partir d'un texte ou d'une photo, tout en conservant l'intégralité de l'workflow s hors ligne.
- CLIP convertit les images et le texte en un espace vectoriel commun, tandis que VectorAI DB stocke ces vecteurs avec des informations sur les défauts permettant d'effectuer des recherch métadonnées.
- métadonnées Le filtrage permet aux équipes de limiter les résultats par catégorie de pièce ou par statut de défaut dès la recherche, plutôt que de filtrer les résultats a posteriori.
- FAISS permet d'effectuer des recherches brutes plus rapides à petite échelle, tandis que VectorAI DB offre un stockage durable, un filtrage par « métadonnées » et un accès multi-machines.
- Dans le cadre des déploiements industriels, le débit d'encodage constitue souvent une contrainte plus importante que le stockage vectoriel ou la latence des requêtes dans la base de données.
Les usines de fabrication conservent souvent des années de photos de défauts sans aucun moyen de les consulter. Lorsqu’une pièce sort de la chaîne de production avec une marque inhabituelle, quelqu’un doit ouvrir des dossiers pour la rechercher. CLIP transforme les images et le texte en vecteurs que vous pouvez comparer. La base de données Actian VectorAI stocke et effectue des recherches sur ces vecteurs. Ensemble, ces deux outils remplacent les recherches dans les dossiers et fonctionnent hors ligne sur le matériel présent au sein même de l’usine.
Un ingénieur qualité peut saisir une description ou transmettre au système une photo du nouveau défaut. Les deux exemples ci-dessous sont traités par le module MVTec AD « Défauts » jeu de données.
Recherche par description :
$ uv run query.py --text "surface scratch on metal component" --part-category metal_nut

Text query: "surface scratch on metal component"  [part_category=metal_nut]
  score  category     defect           path
 0.2814  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/003.png
 0.2691  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/011.png
 0.2607  metal_nut    color            ./mvtec_ad/metal_nut/test/color/007.png
 0.2588  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/000.png
 0.2470  metal_nut    bent             ./mvtec_ad/metal_nut/test/bent/014.png

encode 18.4 ms | search 2.1 ms | total 20.5 ms
Recherche par photo :
$ uv run query.py --image ./line_capture_0412.png --defect-only

Image query: ./line_capture_0412.png  [is_defect=true]
  score  category     defect           path
 0.8912  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/006.png
 0.8744  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/002.png
 0.8593  hazelnut     print            ./mvtec_ad/hazelnut/test/print/010.png
 0.8471  hazelnut     hole             ./mvtec_ad/hazelnut/test/hole/004.png
 0.8226  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/013.png

encode 41.7 ms | search 1.9 ms | total 43.6 ms
Les scores attribués aux textes se situent autour de 0,26. Ceux attribués aux images se situent autour de 0,89. Une phrase et une photographie ne se rapprochent jamais autant que deux photographies entre elles. Comparez les scores au sein d’un même mode d’ requête , jamais entre eux.
Les deux recherches ont été effectuées avec un filtre,--part-category a limité la recherche textuelle aux images d'écrous métalliques, afin qu'aucun défaut lié à une bouteille ou à une noisette ne puisse apparaître, et--defect-only ont exclu de la recherche d’images toutes celles marquées comme « bonne pièce ». Ces deux filtres lisent les données « métadonnées » stockées à côté de chaque vecteur pendant la recherche, plutôt que de filtrer la liste des résultats une fois celle-ci terminée. Un index vectoriel simple ne prend en charge aucun de ces deux filtres, car il ne stocke que des vecteurs et des identifiants numériques, sans aucune possibilité d’ enregistrement r qu’une image montre un écrou métallique ou que la pièce était défectueuse.
Le temps d'exécution provient d'une machine fonctionnant exclusivement sous processeur. Le codage CLIP en représente la majeure partie. La recherche dans la base de données prend environ deux millisecondes. La section consacrée aux tests de performance détaille ces deux chiffres sur le matériel indiqué.
Pourquoi le FAISS ne convient pas à la production
FAISS est un index. VectorAI DB est une base de données. FAISS stocke des vecteurs et des identifiants entiers au sein d'un même processus. VectorAI DB stocke chaque vecteur avec une charge utile de type « métadonnées », effectue des filtrages sur ces champs lors de la recherche et fonctionne comme un service accessible à d'autres machines.
On entend souvent dire que FAISS ne permet pas d'enregistrer un index ni de filtrer ses résultats. Or, comme le montre cet extrait de code, FAISS permet de faire les deux.
import faiss, numpy as np, tempfile, os

d, n = 512, 1000
x = np.random.randn(n, d).astype('float32'); faiss.normalize_L2(x)
idx = faiss.IndexFlatIP(d); idx.add(x)

fd, path = tempfile.mkstemp(suffix='.faiss'); os.close(fd)
faiss.write_index(idx, path)                                  # persistence
reloaded = faiss.read_index(path)
print(np.array_equal(idx.search(x[:1], 5)[1],
                     reloaded.search(x[:1], 5)[1]))           # True

allowed = np.array([5, 10, 15, 20, 25, 30], dtype='int64')
sel = faiss.IDSelectorBatch(allowed)                          # filtering
_, ids = idx.search(x[:1], 3, params=faiss.SearchParameters(sel=sel))
print(set(ids[0]).issubset(set(allowed.tolist())))            # True
La première vérification recharge l'index à partir du disque et renvoie les mêmes voisins que l'original. La seconde limite la recherche à six identifiants autorisés, et tous les résultats figurent dans cette liste. Un responsable de FAISS a confirmé write_index depuis 2017, et IDSelector le filtrage consiste à sur le wiki.
Le FAISS vous coûte toujours trois choses sur une installation déploiement.
- Vous gérez manuellement le magasin « métadonnées » : FAISS stocke des vecteurs et des identifiants entiers. Il ne contient pas d’informations du type « il s’agit d’un écrou métallique, le défaut est une rayure, le fichier se trouve à cet emplacement ». Ces informations sont stockées dans un fichier pickle ou SQLite à côté de l’index, et c’est à vous de veiller à ce que les deux restent synchronisés. Filtrer par catégorie de pièce implique de créer une correspondance entre les catégories et les identifiants, de la charger, puis de construire un IDSelector pour chaque requête, avant de reconstruire cette correspondance à chaque modification du corpus. Lorsqu’un cycle d’ingestion s’interrompt en cours d’exécution, vous devez réconcilier manuellement l’index et le fichier sidecar.
- Le filtrage sur un index de graphe a un coût en termes de rappel, de latence, voire les deux : L'extrait ci-dessus utilise IndexFlatIP, qui est exact, donc le filtrage y est gratuit. Les corpus de production utilisent plutôt HNSW. Un filtre sélectif interagit mal avec la traversée du graphe. La traversée tombe sans cesse sur des voisins que le filtre rejette. Avec les paramètres par défaut, la recherche passe à côté de la plupart des éléments qu’elle devrait trouver et peut parfois même ne pas parvenir à remplir l’ensemble de résultats. Pour récupérer ce rappel, il faut augmenter efSearch bien au-delà de la valeur par défaut et en payer le prix en termes de temps d’ requête . La section « Benchmark » mesure ce compromis en chiffres concrets. VectorAI DB applique le filtre au sein même de la recherche au lieu de vous laisser découvrir ce paramètre par vous-même.
- Il n'y a pas de serveur : FAISS s'exécute au sein d'un seul processus Python . Deux stations d'inspection interrogeant le même corpus impliquent deux copies de l'index dans deux processus distincts, ou bien vous devez écrire vous-même la couche de service, y compris son simultanéité et son comportement de redémarrage.
VectorAI DB fournit directement ces trois éléments. Le fichier « métadonnées » se trouve dans la charge utile, les filtres s’appliquent au cours de la recherche, et la base de données s’exécute dans un conteneur accessible depuis n’importe quelle machine. Ces mêmes propriétés permettent à un pipeline de recherche en périphérie de fonctionner sans connexion Internet, et ce système les applique aux images. FAISS reste l’outil idéal pour comparer les méthodes de recherche dans un notebook. Si vous souhaitez obtenir une analyse plus complète des cas dans lesquels FAISS et les bibliothèques similaires sont adaptées par rapport à une base de données de production, consultez l’article « Best- Python -Vector Database Libraries ».
Ce que vous construisez
Vous allez créer un index unique qui répondra à ces deux types d'requête s et qui, une fois configuré, n'effectuera plus aucun appel réseau.
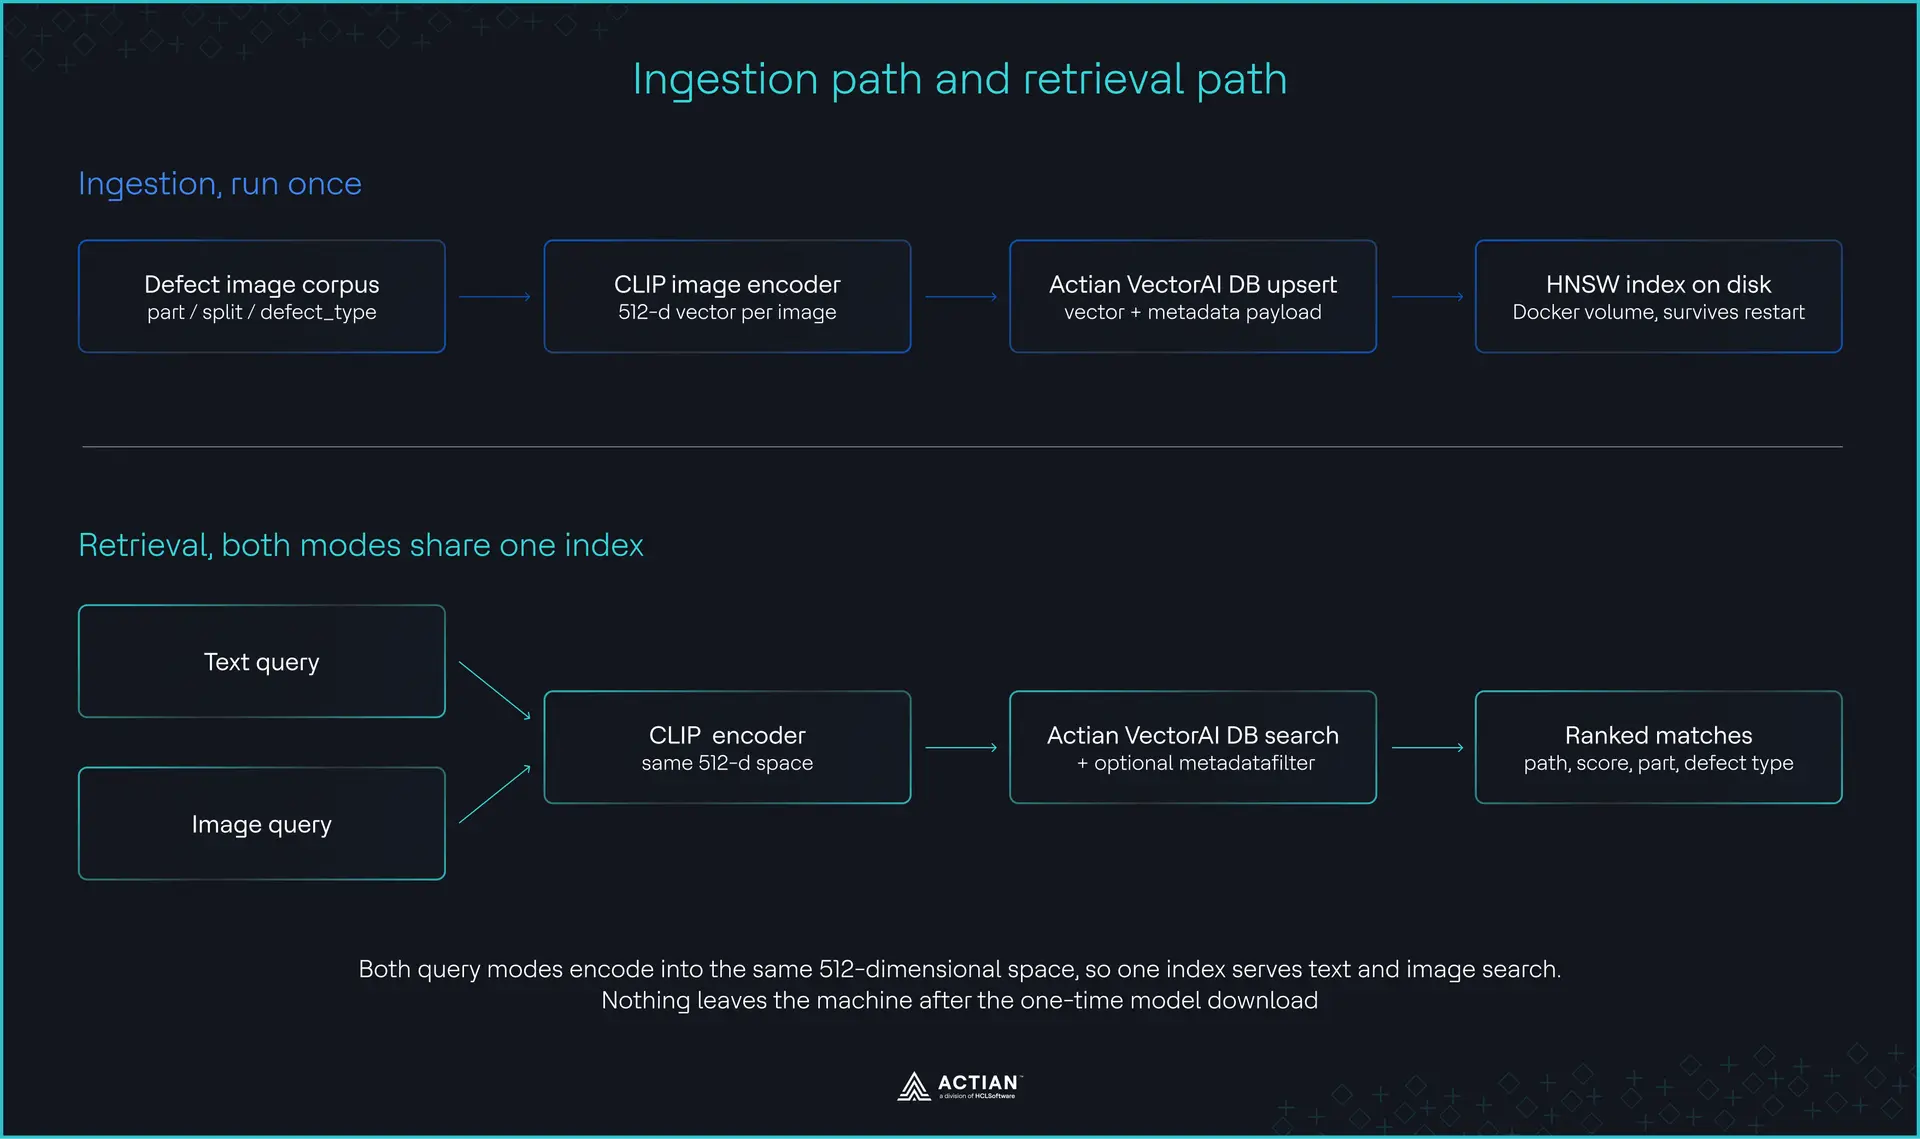
Chemin d'ingestion et chemin de récupération
C'est grâce à CLIP que ces deux modes sont possibles à partir d'un seul index. Le openai/clip-vit-base-patch32 Checkpoint utilise un encodeur d'images ViT-B/32 et un transformateur de texte à douze couches, puis projette les deux dans le même espace. Son ensembles de configurations de modèles projection_dim jusqu'à 512, de sorte qu'une photographie et une phrase deviennent toutes deux des vecteurs à 512 dimensions partageant un même système de coordonnées. C'est précisément pour cette raison qu'un seul ensemble permet de répondre aux deux questions.
La base de données VectorAI stocke chaque vecteur avec une charge utile : part_category, defect_type, image_path, et un is_defect indicateur. C'est la charge utile qui permet de passer de la recherche d'« images similaires » à celle de « défauts similaires sur des bouteilles, en excluant les unités conformes ».
Il convient toutefois de préciser un point avant de vous lancer dans cette démarche. La fiche technique du modèle fournie par OpenAI indique clairement que CLIP n’a pas été développé pour l’ déploiement générale, recommande de procéder à des tests approfondis dans le domaine concerné avant toute mise en œuvre, et souligne que les performances varient en fonction de la manière dont les classes sont définies. La qualité de la recherche doit être mesurée, et non supposée. La section consacrée aux tests de performance vous explique comment procéder.
Une fois le modèle téléchargé, aucune opération effectuée ici n'implique le réseau.
Configuration de la pile
Avant de pouvoir indexer quoi que ce soit, vous devez disposer des poids CLIP sur le disque, de la base de données en cours d'exécution avec un volume monté, ainsi que d'un corpus à analyser.
Créez le projet et ajoutez les dépendances
Ce tutoriel utilise UV, qui permet de résoudre et de fixer tous les éléments en une seule étape, tout en garantissant la reproductibilité de l'environnement.
uv init defect-search
cd defect-search
uv add torch transformers pillow actian-vectorai-client matplotlib
Si vous utilisez plutôt pip, pip install torch transformers pillow actian-vectorai-client matplotlib installe les mêmes paquets, et chacun uv run ce qui suit devient un texte simple python appel.
Téléchargez les poids CLIP tant que la machine dispose encore d'un accès au réseau, car il se peut que la machine à sa sortie d'usine n'en dispose jamais :
uv run huggingface-cli download openai/clip-vit-base-patch32Le point de contrôle pèse environ 605 Mo et est mis en cache dans ~/.cache/huggingface, où from_pretrained le retrouve à chaque exécution suivante. Pour le transférer vers une machine isolée physiquement, copiez ce répertoire et configurez HF_HUB_OFFLINE=1 La bibliothèque ne tente donc jamais de se connecter à Internet.
Lancer VectorAI DB
Créer un docker-compose.yml Fichier d'installation de VectorAI DB :
services:
  vectorai:
    image: actian/vectorai:latest
    container_name: vectorai
    ports:
      - "6573:6573"   # REST API
      - "6574:6574"   # gRPC API, used by the Python SDK
      - "6575:6575"   # local web UI
    volumes:
      - ./vectorai_data:/var/lib/actian-vectorai
    environment:
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    restart: unless-stopped
Lancez le conteneur en exécutant la commande suivante :
docker-compose up -dVous devriez voir le résultat suivant :

Démarrage de VectorAI DB
Les affectations de ports et la variable EULA proviennent du Guide d'installation de VectorAI DB sur Docker. Avant de continuer, enregistrez ce fichier sous le nom de smoke_test.py puis exécutez-la pour vérifier les réponses de la base de données :
# smoke_test.py
from actian_vectorai import VectorAIClient

with VectorAIClient("localhost:6574") as client:
    print(client.health_check())
Exécutez le test comme suit :
uv run smoke_test.pySi le programme affiche les informations relatives au serveur plutôt qu'une erreur de connexion, cela signifie que la base de données est prête.
Obtenir un corpus
Ce tutoriel utilise MVTec AD, qui contient 5 354 images haute résolution réparties en 15 catégories d'objets et de textures, comprenant cinq textures et dix objets, et présentant plus de soixante-dix types de défauts distincts.
Téléchargez-le depuis le site de MVTec et décompressez-le dans le répertoire ./mvtec_ad.
jeu de données licence : réservée à la recherche et à l'évaluation. MVTec AD est distribué sous licence CC BY-NC-SA 4.0. MVTec précise que l’« jeu de données » est destinée à un usage de recherche non commercial et ne peut pas être utilisée à des fins commerciales ; par conséquent, si vous construisez cet appareil pour une usine qui commercialise ses produits, ne l’expédiez pas avec les images MVTec intégrées. Remarque ingest.py dans votre propre archive d'inspection. Rien ici ne dépend de MVTec : le script lit n'importe quel répertoire structuré comme suit : <part_category>/<split>/<defect_type>/<image>, et scan_corpus C'est la seule fonction à modifier si la vôtre est différente.
Écrire le codeur partagé
Les deux scripts importent des éléments à partir d'un même module ; ainsi, le chemin d'accès à l'image et celui du texte ne peuvent pas diverger.
# clip_encoder.py
from __future__ import annotations

from pathlib import Path
from typing import Sequence

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

MODEL_ID = "openai/clip-vit-base-patch32"
EMBED_DIM = 512


def _features(out) -> torch.Tensor:
    """
    transformers 4.x returns a Tensor from get_image_features and
    get_text_features. transformers 5.x returns a
    BaseModelOutputWithPooling whose pooler_output holds the
    projected vector. Handle both so this does not break on upgrade.
    """
    return out if isinstance(out, torch.Tensor) else out.pooler_output


class ClipEncoder:
    def __init__(self, model_id: str = MODEL_ID, device: str | None = None) -> None:
        self.device = device or ("cuda" if torch.cuda.is_available() else "cpu")
        self.model = CLIPModel.from_pretrained(model_id).to(self.device).eval()
        self.processor = CLIPProcessor.from_pretrained(model_id)

    @torch.inference_mode()
    def encode_images(self, paths: Sequence[str | Path]) -> torch.Tensor:
        images = [Image.open(p).convert("RGB") for p in paths]
        inputs = self.processor(images=images, return_tensors="pt").to(self.device)
        vecs = _features(self.model.get_image_features(**inputs))
        return torch.nn.functional.normalize(vecs, dim=-1).cpu()

    @torch.inference_mode()
    def encode_text(self, texts: Sequence[str]) -> torch.Tensor:
        inputs = self.processor(
            text=list(texts), return_tensors="pt", padding=True, truncation=True
        ).to(self.device)
        vecs = _features(self.model.get_text_features(**inputs))
        return torch.nn.functional.normalize(vecs, dim=-1).cpu()
Cela features Cette fonction d'aide existe car Transformers 5.x a été modifié get_image_features pour renvoyer un BaseModelOutputWithPooling objet au lieu d'un tenseur. L'appel d'une seule ligne présent dans la plupart des tutoriels CLIP publiés échoue désormais sur une nouvelle installation avecAttributeError: 'BaseModelOutputWithPooling' object has no attribute 'shape', et cette fonction d'aide fonctionne avec les deux versions. La normalisation de chaque vecteur avant son renvoi transforme la similarité cosinus en un simple produit scalaire.
Indexation du corpus de défauts
Le module d'ingestion effectue l'encodage par lots et insère ou met à jour chaque vecteur avec son « métadonnées ». L'encodage CLIP constitue le goulot d'étranglement ; les écritures dans la base de données sont loin d'être aussi gourmandes en ressources.
MVTec enregistre les fichiers sous le format <part_category>/<split>/<defect_type>/<file>.png, ce qui signifie que la structure de répertoires contient déjà tous les champs métadonnées dont vous avez besoin :
# ingest.py
from __future__ import annotations

import argparse
import time
from pathlib import Path

from actian_vectorai import (
    VectorAIClient, PointStruct, VectorParams, Distance, CollectionExistsError,
)

from clip_encoder import ClipEncoder, EMBED_DIM

IMAGE_SUFFIXES = {".png", ".jpg", ".jpeg", ".bmp"}


def scan_corpus(root: Path) -> list[dict]:
    """Read metadata straight out of the directory layout."""
    records: list[dict] = []
    for path in sorted(root.rglob("*")):
        if path.suffix.lower() not in IMAGE_SUFFIXES:
            continue
        if "ground_truth" in path.parts:      # segmentation masks, not photos
            continue
        try:
            rel = path.relative_to(root)
            part_category, _split, defect_type = rel.parts[0], rel.parts[1], rel.parts[2]
        except (ValueError, IndexError):
            continue
        records.append(
            {
                "image_path": str(path),
                "part_category": part_category,
                "defect_type": defect_type,
                "is_defect": defect_type != "good",
            }
        )
    return records


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--data", default="./mvtec_ad")
    ap.add_argument("--collection", default="defect_search")
    ap.add_argument("--url", default="localhost:6574")
    ap.add_argument("--batch-size", type=int, default=32)
    args = ap.parse_args()

    records = scan_corpus(Path(args.data))
    if not records:
        raise SystemExit(f"No images found under {args.data}")
    print(f"Found {len(records)} images")

    encoder = ClipEncoder()
    print(f"CLIP running on {encoder.device}")

    with VectorAIClient(args.url) as client:
        try:
            client.collections.create(
                args.collection,
                vectors_config=VectorParams(size=EMBED_DIM, distance=Distance.Cosine),
            )
            print(f"Created collection '{args.collection}'")
        except CollectionExistsError:
            print(f"Collection '{args.collection}' already exists, appending")

        started = time.perf_counter()
        done = 0

        for start in range(0, len(records), args.batch_size):
            batch = records[start : start + args.batch_size]
            vectors = encoder.encode_images([r["image_path"] for r in batch])

            client.points.upsert(
                args.collection,
                points=[
                    PointStruct(id=start + offset, vector=vec.tolist(), payload=record)
                    for offset, (record, vec) in enumerate(zip(batch, vectors))
                ],
            )

            done += len(batch)
            elapsed = time.perf_counter() - started
            rate = done / elapsed if elapsed else 0.0
            remaining = (len(records) - done) / rate if rate else 0.0
            print(
                f"\r{done}/{len(records)} images "
                f"| {rate:.1f} img/s | ~{remaining/60:.1f} min left",
                end="", flush=True,
            )

        print(f"\nIndexed {done} images in {(time.perf_counter()-started)/60:.1f} min")
        print(f"Collection now holds {client.points.count(args.collection)} points")


if __name__ == "__main__":
    main()
Certaines lignes de ce script semblent être le fruit d'un choix arbitraire, mais les modifier entraînerait des problèmes. scan_corpus ignore le ground_truth dossiers, car ils contiennent des masques de pixels, et l'indexation des masques remplit vos résultats de formes en noir et blanc qui ne correspondent à rien de ce qu'une caméra produit. La collection est créée avec 512 dimensions et une distance cosinus pour correspondre à l'encodeur ; un décalage à ce niveau ne génère aucune erreur, mais seulement des résultats de recherche qui, petit à petit, perdent tout sens.
Les except clauses de capture CollectionExistsError précisément parce qu'un simple except Exception Cela masquerait également une connexion refusée ou un conflit de dimensions, et vous souhaitez qu’un conflit de dimensions entraîne l’arrêt immédiat du script plutôt que de se manifester des semaines plus tard sous forme de mauvais résultats.
Lancer l'ingestion :
uv run ingest.py --data ./mvtec_ad
Found 5354 images
CLIP running on cpu
Created collection 'defect_search'
5354/5354 images | 2.1 img/s | ~0.0 min left
Indexed 5354 images in 42.5 min
Collection now holds 5354 points
Prévoyez entre 45 et 90 minutes pour traiter l'intégralité du corpus sur une machine équipée uniquement d'un processeur « processeur », et quelques minutes sur un GPU moderne. Le test ci-dessus a été réalisé sur un Ryzen 7 5800X doté de 32 Go de RAM, avec uniquement un processeur « processeur ». Une taille de lot de 32 est une valeur par défaut raisonnable ; augmentez-la si vous disposez de mémoire VRAM disponible.
Le contrôle de persistance
C'est là que réside la différence avec FAISS, et il suffit de dix secondes pour le démontrer :
docker compose restart
uv run query.py --text "cracked surface"
Les résultats s'affichent immédiatement pour l'ensemble des 5 354 vecteurs. Aucun réencodage n'est nécessaire, car l'index a été écrit sur le volume monté au fur et à mesure de sa construction, et non pas sous forme d'instantané à la fin.
Exécution de requêtes
Les deux modes d'requête ion suivent les trois mêmes étapes : encodage, filtrage, recherche. Seul l'encodeur change.
# query.py
from __future__ import annotations

import argparse
import time

from actian_vectorai import VectorAIClient, FilterBuilder, Field

from clip_encoder import ClipEncoder

COLLECTION = "defect_search"   # must match the name ingest.py created


def build_filter(part_category: str | None = None, defect_only: bool = False):
    """Metadata filter, applied inside the search rather than after it."""
    builder = FilterBuilder()
    if part_category:
        builder = builder.must(Field("part_category").eq(part_category))
    if defect_only:
        builder = builder.must(Field("is_defect").eq(True))
    return None if builder.is_empty() else builder.build()


def search_by_text(client, encoder, text, part_category=None, defect_only=False, limit=5):
    vector = encoder.encode_text([text])[0].tolist()
    return client.points.search(
        COLLECTION, vector, limit=limit,
        filter=build_filter(part_category, defect_only), with_payload=True,
    )


def search_by_image(client, encoder, image_path, part_category=None, defect_only=False, limit=5):
    vector = encoder.encode_images([image_path])[0].tolist()
    return client.points.search(
        COLLECTION, vector, limit=limit,
        filter=build_filter(part_category, defect_only), with_payload=True,
    )


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--text")
    ap.add_argument("--image")
    ap.add_argument("--part-category")
    ap.add_argument("--defect-only", action="store_true")
    ap.add_argument("--limit", type=int, default=5)
    args = ap.parse_args()
    if not args.text and not args.image:
        raise SystemExit("Pass --text or --image")

    encoder = ClipEncoder()
    with VectorAIClient("localhost:6574") as client:
        t0 = time.perf_counter()
        if args.text:
            results = search_by_text(client, encoder, args.text,
                                     args.part_category, args.defect_only, args.limit)
        else:
            results = search_by_image(client, encoder, args.image,
                                      args.part_category, args.defect_only, args.limit)
        total = (time.perf_counter() - t0) * 1000

    print(f"  score  {'category':<12} {'defect':<16} path")
    for r in results:
        p = r.payload
        print(f"{r.score:7.4f}  {p['part_category']:<12} {p['defect_type']:<16} {p['image_path']}")
    print(f"\ntotal {total:.1f} ms")


if __name__ == "__main__":
    main()
Les COLLECTION le nom doit correspondre à ce qui ingest.py sont créées, ou bien chaque recherche échoue avec une erreur « collection introuvable » alors que les données restent intactes dans la base de données. Le générateur de filtres mérite également qu'on s'y attarde : FilterBuilder.must() Elle prend une condition par appel et renvoie le constructeur ; vous enchaînez donc les appels pour ajouter des conditions plutôt que d'en passer plusieurs à la fois.
Vous pouvez effectuer l'un ou l'autre type de recherche à partir de la ligne de commande :
uv run query.py --text "surface scratch on metal component" --part-category metal_nut
uv run query.py --image ./line_capture_0412.png --defect-only
Si les stations d'inspection doivent accéder au système via le réseau plutôt que d'exécuter localement Python , un petit service FastAPI peut être déployé en amont. Cette partie est facultative :
# app.py  (optional)
from fastapi import FastAPI
from actian_vectorai import VectorAIClient
from clip_encoder import ClipEncoder
from query import search_by_text

app = FastAPI()
encoder = ClipEncoder()          # load once at startup, not on every request
client = VectorAIClient("localhost:6574")
client.connect()


@app.get("/search")
def search(q: str, part_category: str | None = None, limit: int = 5):
    hits = search_by_text(client, encoder, q, part_category=part_category, limit=limit)
    return [
        {"score": h.score, "path": h.payload["image_path"], "defect_type": h.payload["defect_type"]}
        for h in hits
    ]
À ce stade, ces deux types de recherche s'appuient sur un index filtré ne dépendant pas du réseau ; vous pouvez donc les orienter vers vos propres photos d'inspection à l'aide de VectorAI DB Community Edition avant de consulter les chiffres de performance.
La référence
Mesurez deux choses : l'évolution de la latence de recherche à mesure que le corpus s'étoffe, et l'exactitude des résultats.
benchmark.py effectue 100 requêtes par taille de corpus et renvoie les valeurs p50 et p99, puis calcule le Recall@5 par rapport à la partition de test MVTec. Un résultat est considéré comme un succès lorsque l’un au moins des cinq voisins les plus proches présente le même type de défaut que l’image requête :
# benchmark.py
def measure_recall_at_k(client, encoder, collection, test_records, k=5) -> float:
    hits = 0
    for record in test_records:
        vec = encoder.encode_images([record["image_path"]])[0].tolist()
        results = client.points.search(
            collection, vector=vec, limit=k + 1, with_payload=True
        )
        neighbours = [
            r for r in results if r.payload["image_path"] != record["image_path"]
        ][:k]
        if any(r.payload["defect_type"] == record["defect_type"] for r in neighbours):
            hits += 1
    return hits / len(test_records) if test_records else 0.0
Il est obligatoire d'exclure l'image « requête ». Si vous la conservez, chaque image « requête » est identifiée comme étant elle-même, avec un coefficient de similarité de 1,0, et le Recall@5 affiche 100 %, quelle que soit la qualité des performances du modèle.
Deux règles régissent la manière dont vous devez indiquer ces chiffres.
Il faut distinguer la latence de recherche de la latence d'encodage. Leur évolution est différente, et leur moyenne ne vous apprend rien sur l’une ou l’autre. La recherche dans la base de données croît bien plus lentement que le corpus, car le parcours HNSW est sublinéaire. L’encodage CLIP est constant par requête et, sur processeur, domine le total. Présentez-les séparément, sinon votre graphique évalue le modèle plutôt que la base de données.
Précisez la configuration matérielle et ne mélangez jamais les exécutions « processeur » et « GPU » dans un même tableau. Une valeur de latence sans machine associée ne constitue pas une mesure, et le fait que le temps d'encodage d'une « processeur » figure dans la même colonne que celui d'un GPU est pire que l'absence totale de chiffre. make_chart.py considère la chaîne « hardware » comme un argument obligatoire précisément pour cette raison :
uv run benchmark.py --out benchmark.csv
uv run make_chart.py --csv benchmark.csv --hardware "Ryzen 7 5800X, 32GB RAM, CPU-only"
Voici la courbe attendue, obtenue en mesurant 100 requêtes par taille de corpus par rapport à l'index plat FAISS, utilisé comme référence :
| Corpus | VectorAI DB p50 | VectorAI DB p. 99 | FAISS plat p50 | FAISS plat p99 | Rappel@5 |
|---|---|---|---|---|---|
| 1,000 | 0,148 ms | 0,198 ms | 0,053 ms | 0,112 ms | 1.000 |
| 5,000 | 0,676 ms | 0,725 ms | 0,410 ms | 0,462 ms | 0.996 |
| 10,000 | 1,036 ms | 1,272 ms | 0,809 ms | 0,863 ms | 0.974 |
Matériel : indiquez votre processeur ( processeur), votre mémoire vive (RAM) et précisez si CLIP a été exécuté sur le processeur central ( processeur ) ou sur le processeur graphique (GPU). Temps de recherche uniquement ; l'encodage CLIP n'est pas pris en compte.
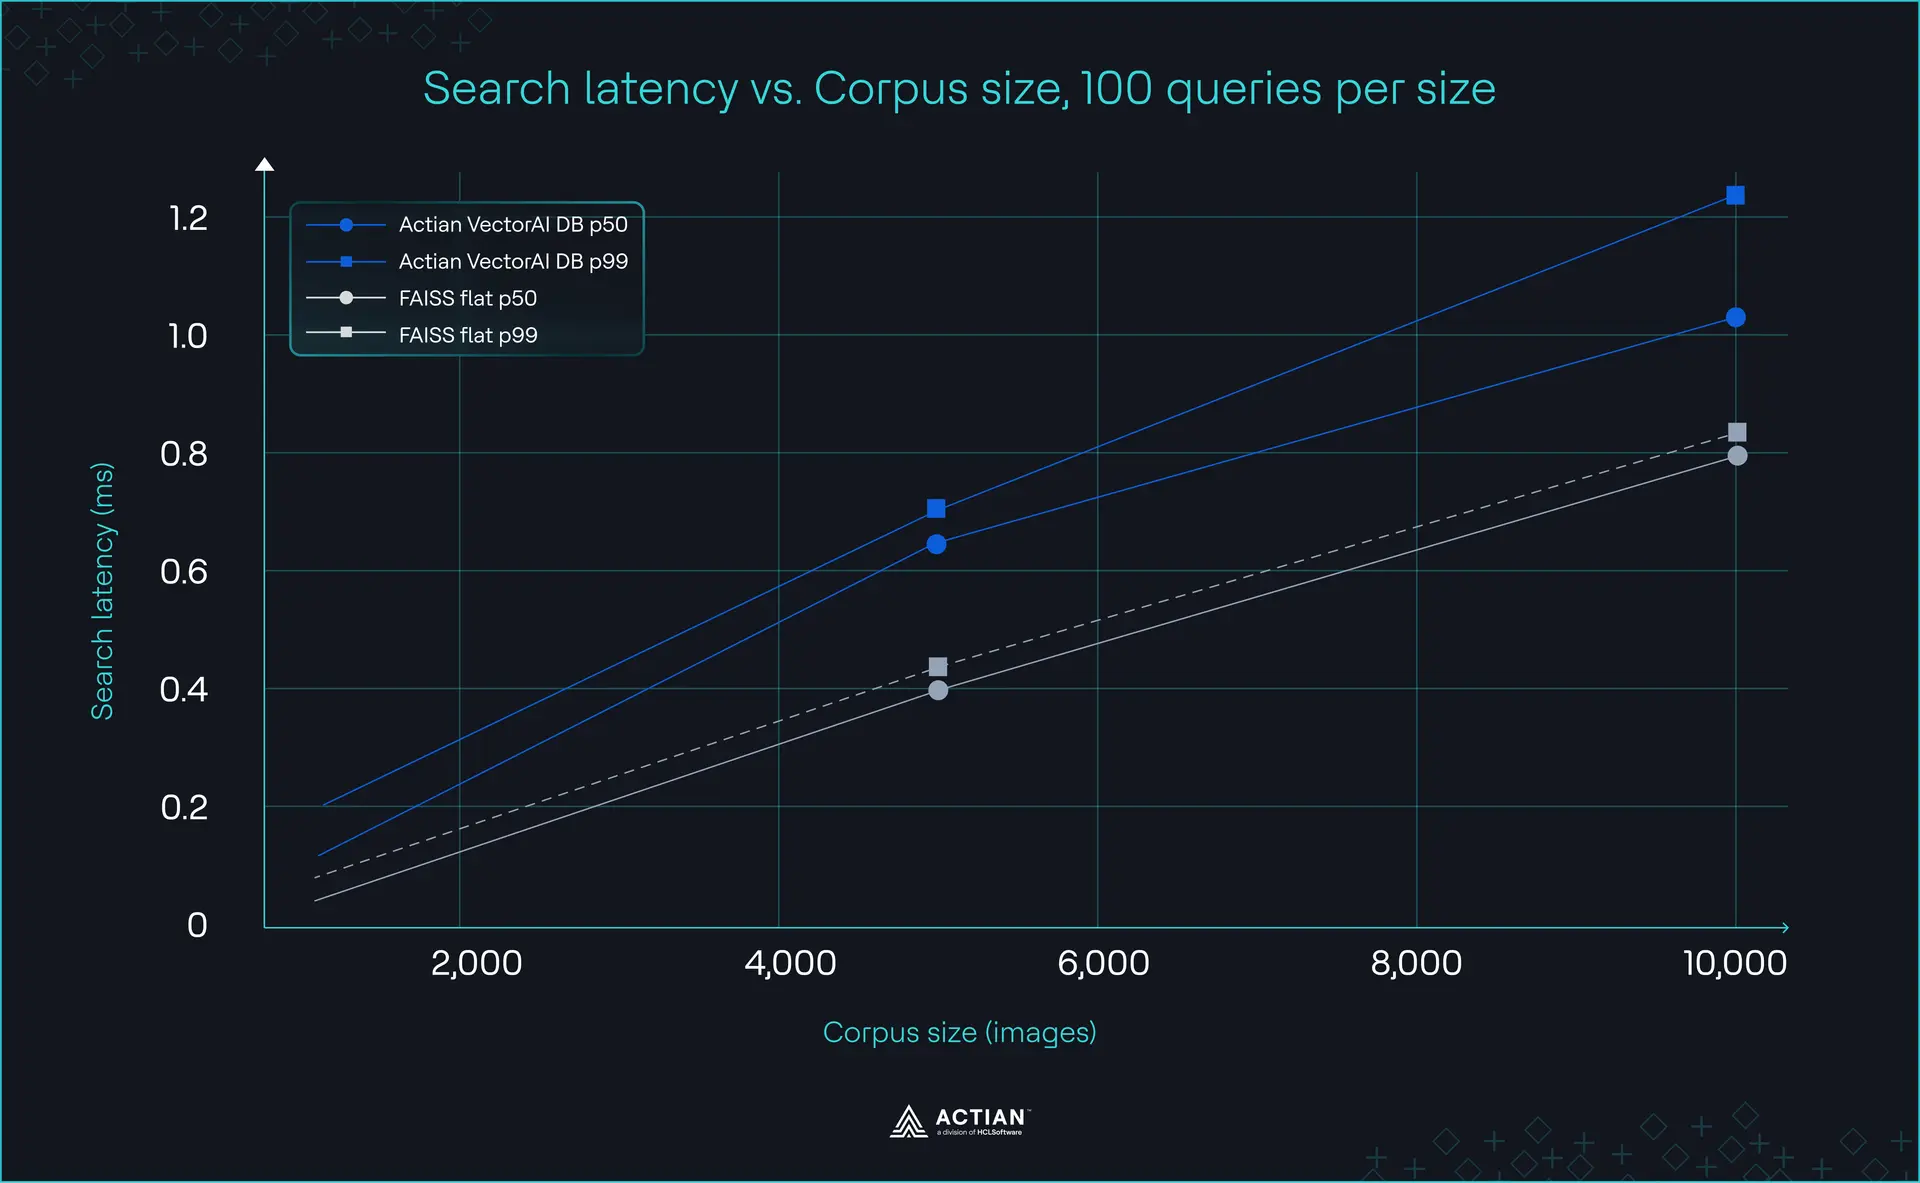
Graphique de latence : p50/p99 en fonction de la taille du corpus, généré à partir des résultats du test de performance
FAISS l'emporte en termes de temps de recherche brut à cette échelle, et c'est là la réalité. Un index plat de plus de dix mille vecteurs correspond à un produit scalaire par force brute dans le même processus, sans graphe à parcourir ni transfert entre l’ requête e et les vecteurs. VectorAI DB renvoie ses réponses via gRPC, ce qui implique un coût fixe par appel qui s’ajoute à chaque chiffre de ses colonnes. Le Recall@5 se maintient à 0,974 ou au-dessus tout au long du test ; la qualité de la recherche n’est donc pas ce que vous sacrifiez.
Ce que vous sacrifiez en une fraction de milliseconde, c'est le filtrag métadonnées , les écritures durables et un service auquel plusieurs machines peuvent requête simultanément. Sur un corpus de cette taille, ce compromis est peu coûteux. Il reste peu coûteux à mesure que le corpus s'agrandit, car l'index plat évolue linéairement avec le nombre de vecteurs, contrairement à l'index de graphe.
C'est le volume des transactions « HNSW filtrées » qui a le plus de chances de vous surprendre.
Il s'agit du coût auquel la section FAISS faisait référence. Exécution de 20 000 vecteurs avec un filtre qui admet 1 % du corpus, évaluée par rapport à une recherche filtrée exacte servant de référence :
| efSearch | Résultats affichés (sur 10) | Rappel@10 | ms/requête |
|---|---|---|---|
| 16 (par défaut) | 9.0 | 0.17 | 0.12 |
| 64 | 10.0 | 0.39 | 0.35 |
| 256 | 10.0 | 0.77 | 1.11 |
| 1024 | 10.0 | 0.99 | 2.62 |
Avec les paramètres par défaut, la recherche filtrée passe à côté de la plupart des résultats qu’elle devrait renvoyer et ne parvient pas toujours à remplir l’ensemble des résultats. Il a fallu efSearch 64 fois la valeur par défaut, ce qui a fait passer le temps de l'requête ation de 0,12 ms à 2,62 ms. Le filtre fonctionne, vous payez pour l'utiliser, et vous devez savoir vous rendre sur optimiser pour l'obtenir.
Deux précisions concernant ce tableau. Il provient d’un conteneur Intel Xeon exécutant faiss-processeur 1.15.0, et utilise des vecteurs gaussiens aléatoires, ce qui correspond à un scénario proche du pire pour la traversée de graphes. Les représentations CLIP réelles forment des grappes, donc votre taux de rappel pour un efSearch ce sera mieux. Reproduisez-le sur vos propres vecteurs avec filter_recall_test.py avant de définir la taille de quoi que ce soit dessus.
Concernant le stockage : avec 512 dimensions en float32, une représentation occupe 2 Ko ; ainsi, l’ensemble du corpus MVTec représente environ 11 Mo de vecteurs, contre environ 5 Go d’images sources. Le stockage des caractéristiques n’est pas la contrainte, ce qui est souvent mal compris dans les déploiements industriels. Prévoyez plutôt en fonction du débit d'encodage. À raison de deux images par seconde sur processeur, le traitement d'une archive de 50 000 images ne prend qu'un week-end. Vous ne payez qu'une seule fois, sauf si vous changez de modèle d'embedding, car les vecteurs issus de deux modèles différents ne sont pas comparables, même avec des dimensions identiques.
Questions fréquemment posées
Qu'est-ce que CLIP et comment fonctionne-t-il pour la recherche d'images ?
CLIP est un modèle développé par OpenAI, entraîné sur des paires image-légende, qui apprend à situer une image et sa description à proximité l’une de l’autre dans un espace vectoriel commun. Pour la recherche, cet espace commun est justement l’intérêt principal : vous encodez votre corpus d’images une seule fois, puis vous encodez soit une image requête , soit une image requête au moment de la recherche, et vous comparez les résultats à l’aide de la similarité cosinus. La variante utilisée ici,clip-vit-base-patch32, génère des vecteurs de 512 dimensions et fonctionne sur une carte graphique de type « processeur ».
Comment puis-je rechercher des images de défauts de fabrication en fonction de leur ressemblance visuelle ?
Encodez chaque image de votre archive à l’aide de l’encodeur d’images de CLIP et stockez les vecteurs dans une base de données, accompagnés d’ métadonnées s telles que la catégorie de pièce et le type de défaut. Lorsqu’un opérateur identifie un nouveau défaut, encodez cette photographie de la même manière et lancez une recherche du plus proche voisin. Les résultats correspondent à des images antérieures présentant des similitudes, classées par similarité cosinus, ce qui signifie concrètement des défauts similaires sur des pièces similaires.
Puis-je utiliser la recherche d'images CLIP hors ligne, sans service cloud ?
Oui, et c’est précisément la configuration décrite ici. Les poids CLIP sont téléchargés une seule fois (environ 605 Mo), puis s’exécutent localement sur un processeur « processeur » ou un GPU. VectorAI DB fonctionne sous forme de conteneur Docker sur votre propre matériel. Une fois le téléchargement initial effectué, aucune image, aucun fichier « requête » ni aucune intégration ne quitte la machine, ce qui rend cette approche viable dans une usine en « air-gap ».
Quelle est la différence entre FAISS et VectorAI DB pour la recherche d'images ?
FAISS est une bibliothèque de recherche par similarité qui stocke des vecteurs et des identifiants entiers au sein d'un même processus. Elle assure la persistance sur disque viawrite_index, et il permet effectivement de filtrer par ID via IDSelector, contrairement à ce que l'on entend souvent. Elle ne stocke pas d'métadonnées s aux côtés des vecteurs, ne permet pas de filtrer sur des champs nommés et ne prend pas en charge plusieurs processus. VectorAI DB offre ces trois fonctionnalités, ce qui illustre concrètement ce que signifie la distinction « base de données, et non index ».
Testez-le sur votre propre corpus :
docker pull actian/vectorai:latestL'édition Community est auto-hébergée et gratuite jusqu'à 5 000 vecteurs, ce qui correspond presque exactement au corpus MVTec. La documentation traite du réglage de la collecte et de la syntaxe des filtres, et le Discord d'Actian est le lieu où les utilisateurs de cette pile échangent leurs expériences.
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
