Déployez des agents IA dotés d’une mémoire persistante. Déployez-les partout.

Ce que les développeurs créent avec VectorAI DB
Trace
Recherche sémantique appliquée aux dossiers de personnes disparues. Comble le fossé terminologique entre les familles et les dossiers médico-légaux, entièrement sur l’appareil.

Revvec
Pipeline RAG air-gapped pour la défense, l’aérospatiale et l’industrie pharmaceutique. Fonctionne sur un seul Mac, sans connexion Internet.
FixFirst
Copilote de maintenance hors ligne pour les techniciens industriels. Recherchez dans les manuels et l’historique des incidents à partir d’un code d’erreur, d’une photo ou d’une note vocale.


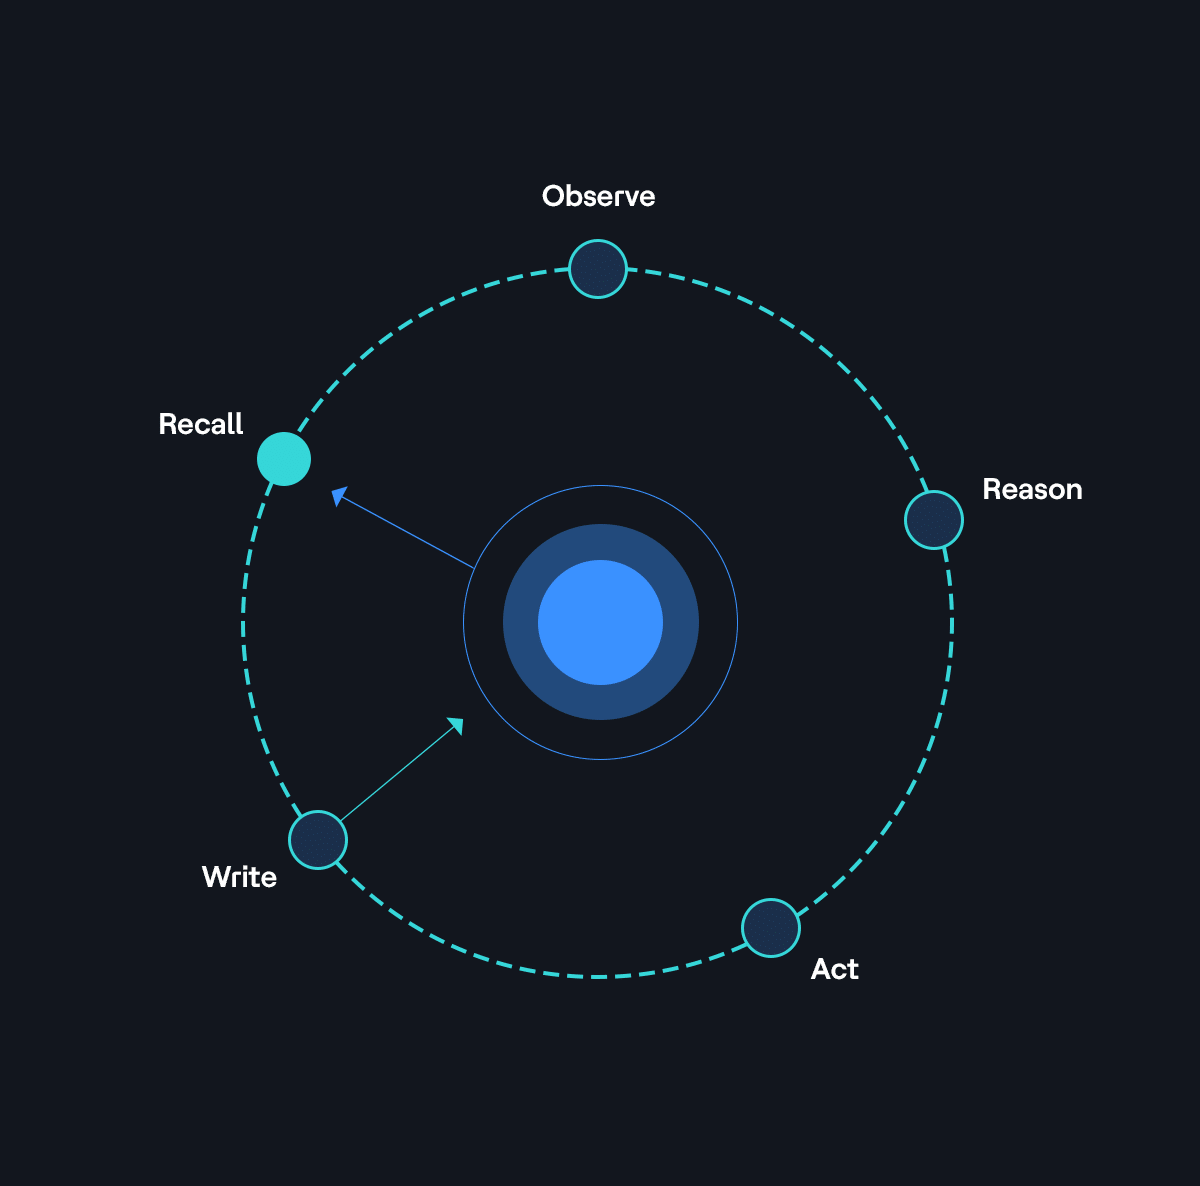
La plupart des bases de données vectorielles ont été conçues pour les modes d’interrogation humains. Les agents IA fonctionnent différemment.
/

Des performances qui tiennent la charge
Découvrez comment Actian VectorAI DB vous aide à créer et exécuter des applications d’IA partout, sans dépendance au cloud. Cette base de données vectorielle portable, conçue d’abord pour l’exécution locale, offre une recherche rapide et prévisible tout en gardant vos données et votre infrastructure entièrement sous votre contrôle.
QPS
745,2 QPS sur 10 millions de vecteurs de 768 dimensions. 22 fois plus rapide que Milvus et Qdrant.
Précision de la recherche
Latence p99
13 ms en p99 avec 99 % de recall sur le matériel auto-hébergé où s’exécutent vos agents.
Ce que vous obtenez

Une mémoire qui persiste d’une session à l’autre
Les agents se souviennent du contexte entre les sessions, à n'importe quelle échelle, à l'intérieur de votre périmètre.

Un monitoring intégré aux outils que vous utilisez déjà
Des métriques Prometheus natives directement dans vos dashboards Grafana existants.

Des requêtes parallèles sans perte de performance
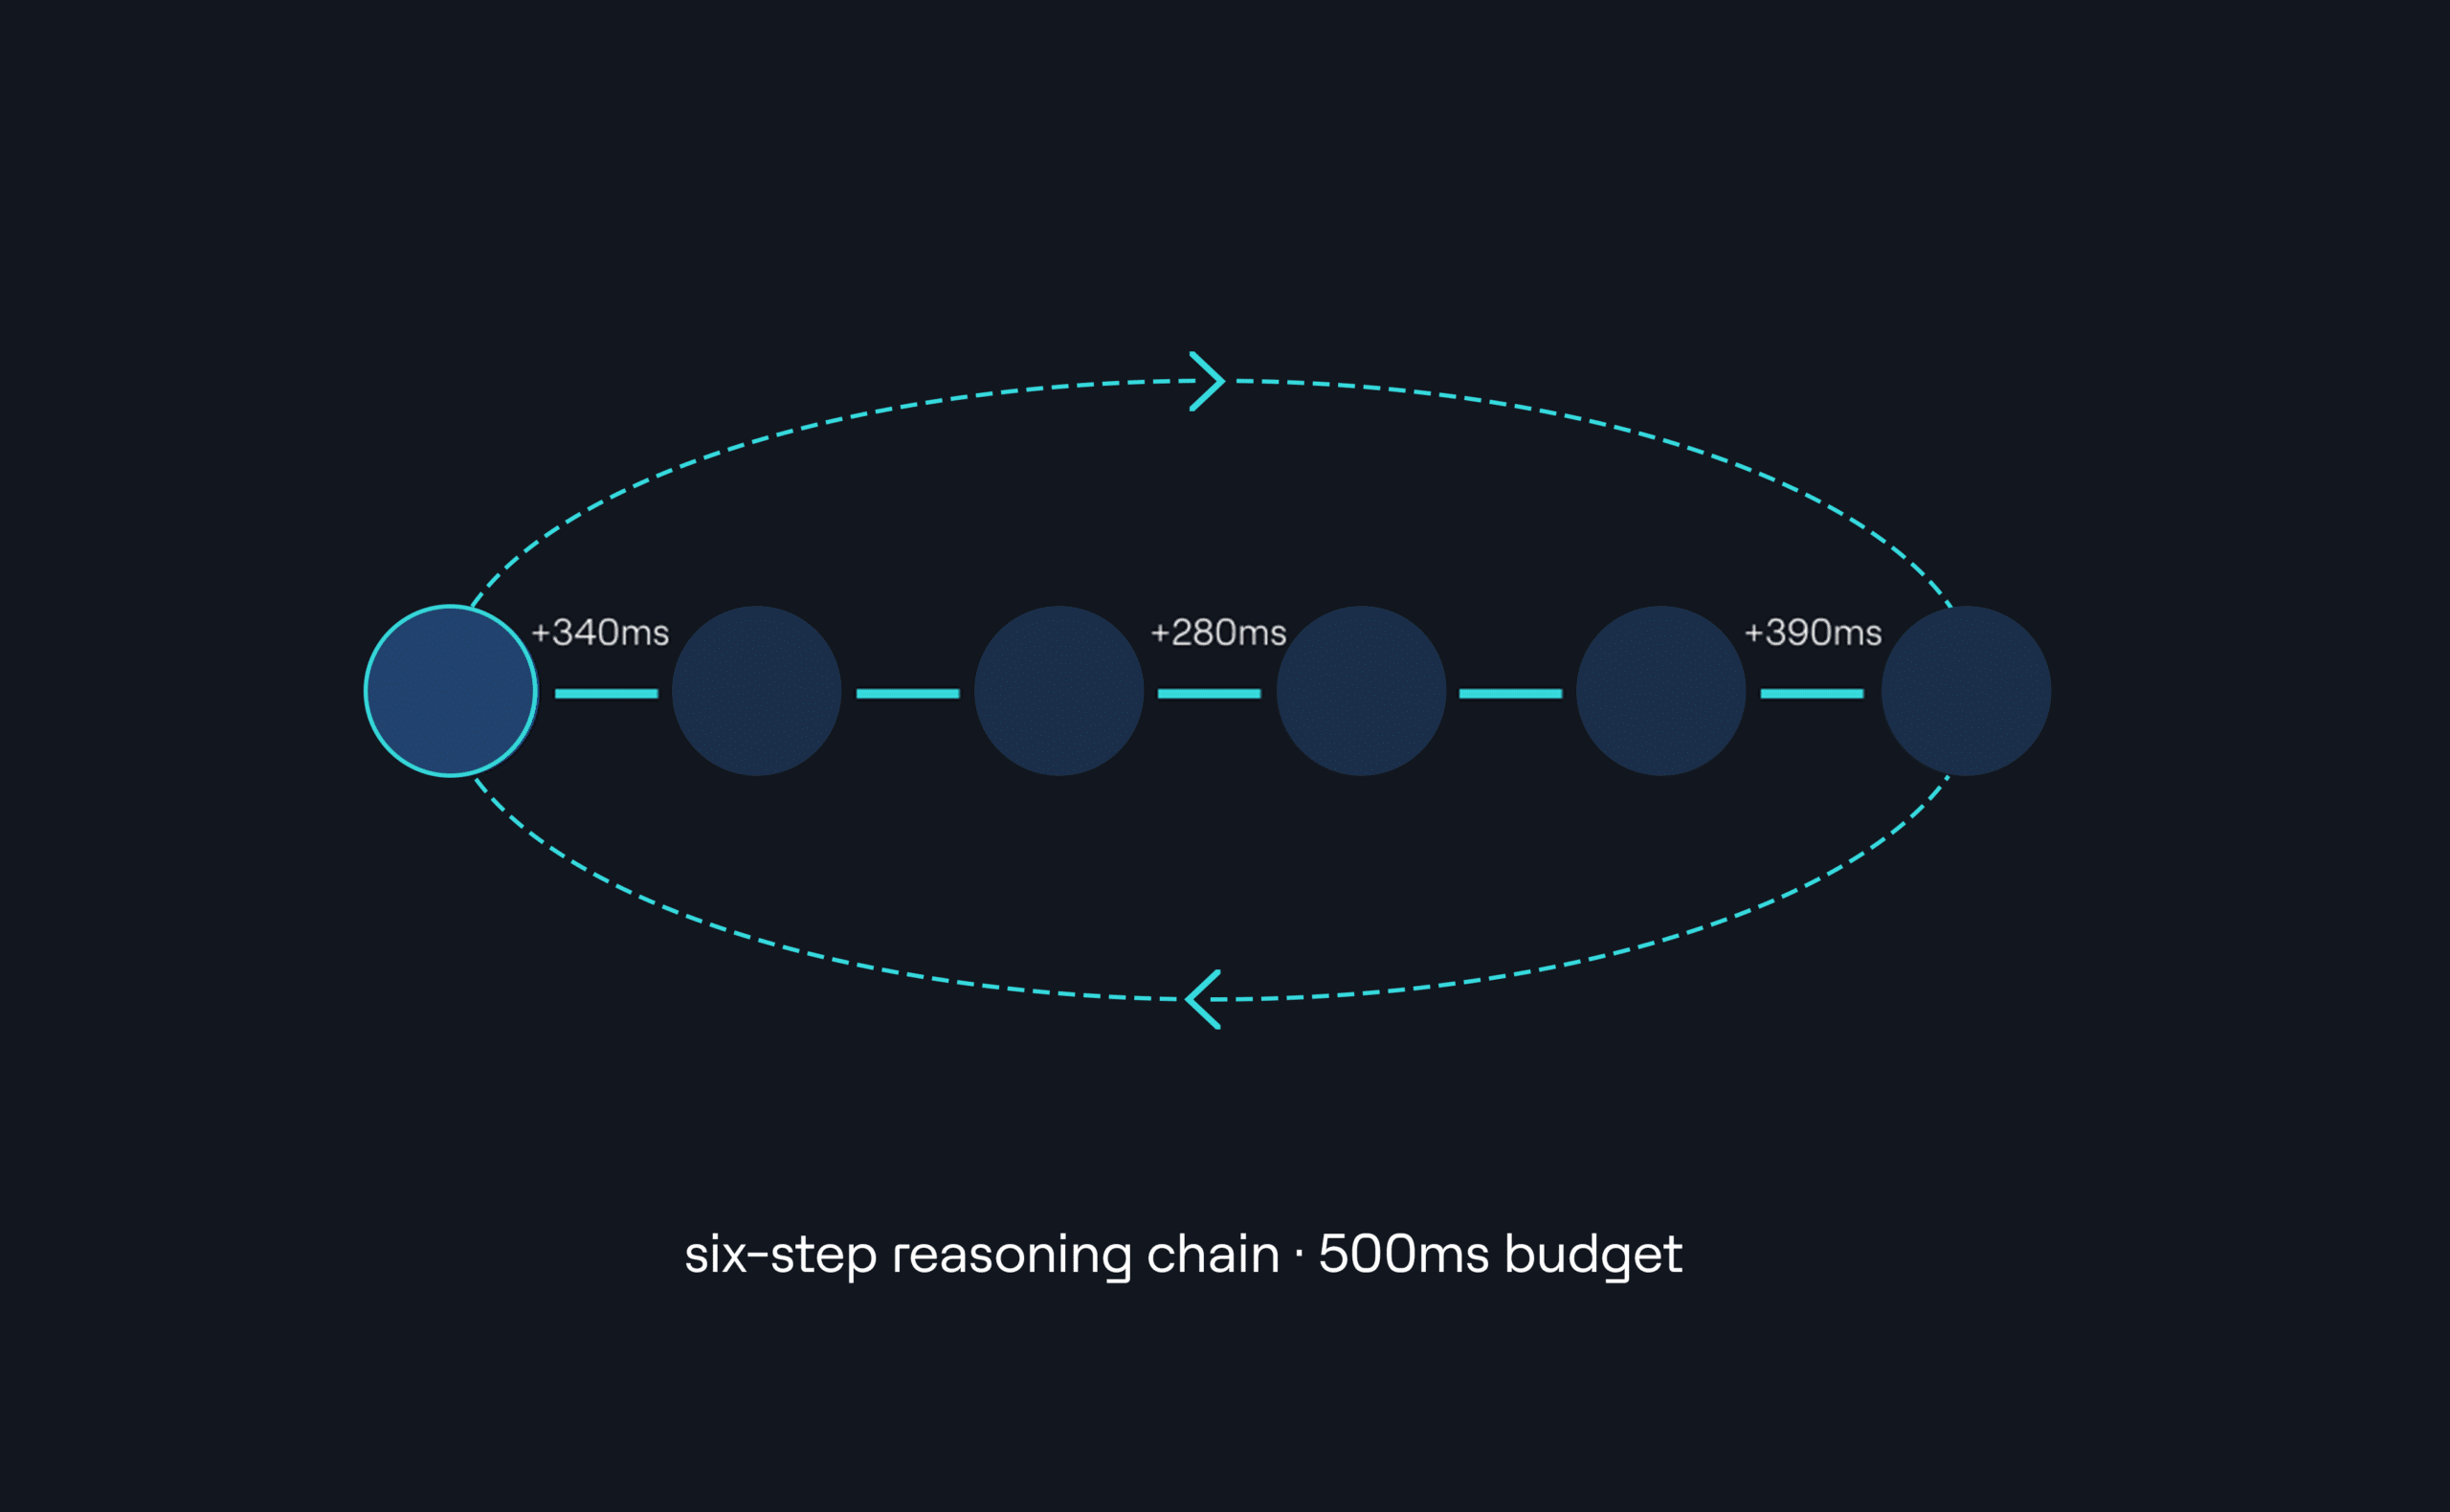
Exécutez en parallèle les étapes de raisonnement et les recherches en mémoire, sans dégrader le recall.

Déployez le même build partout
Du laptop au data center, sur n’importe quel matériel, sans aucune réécriture.

Passez les contrôles de conformité sans revoir votre architecture
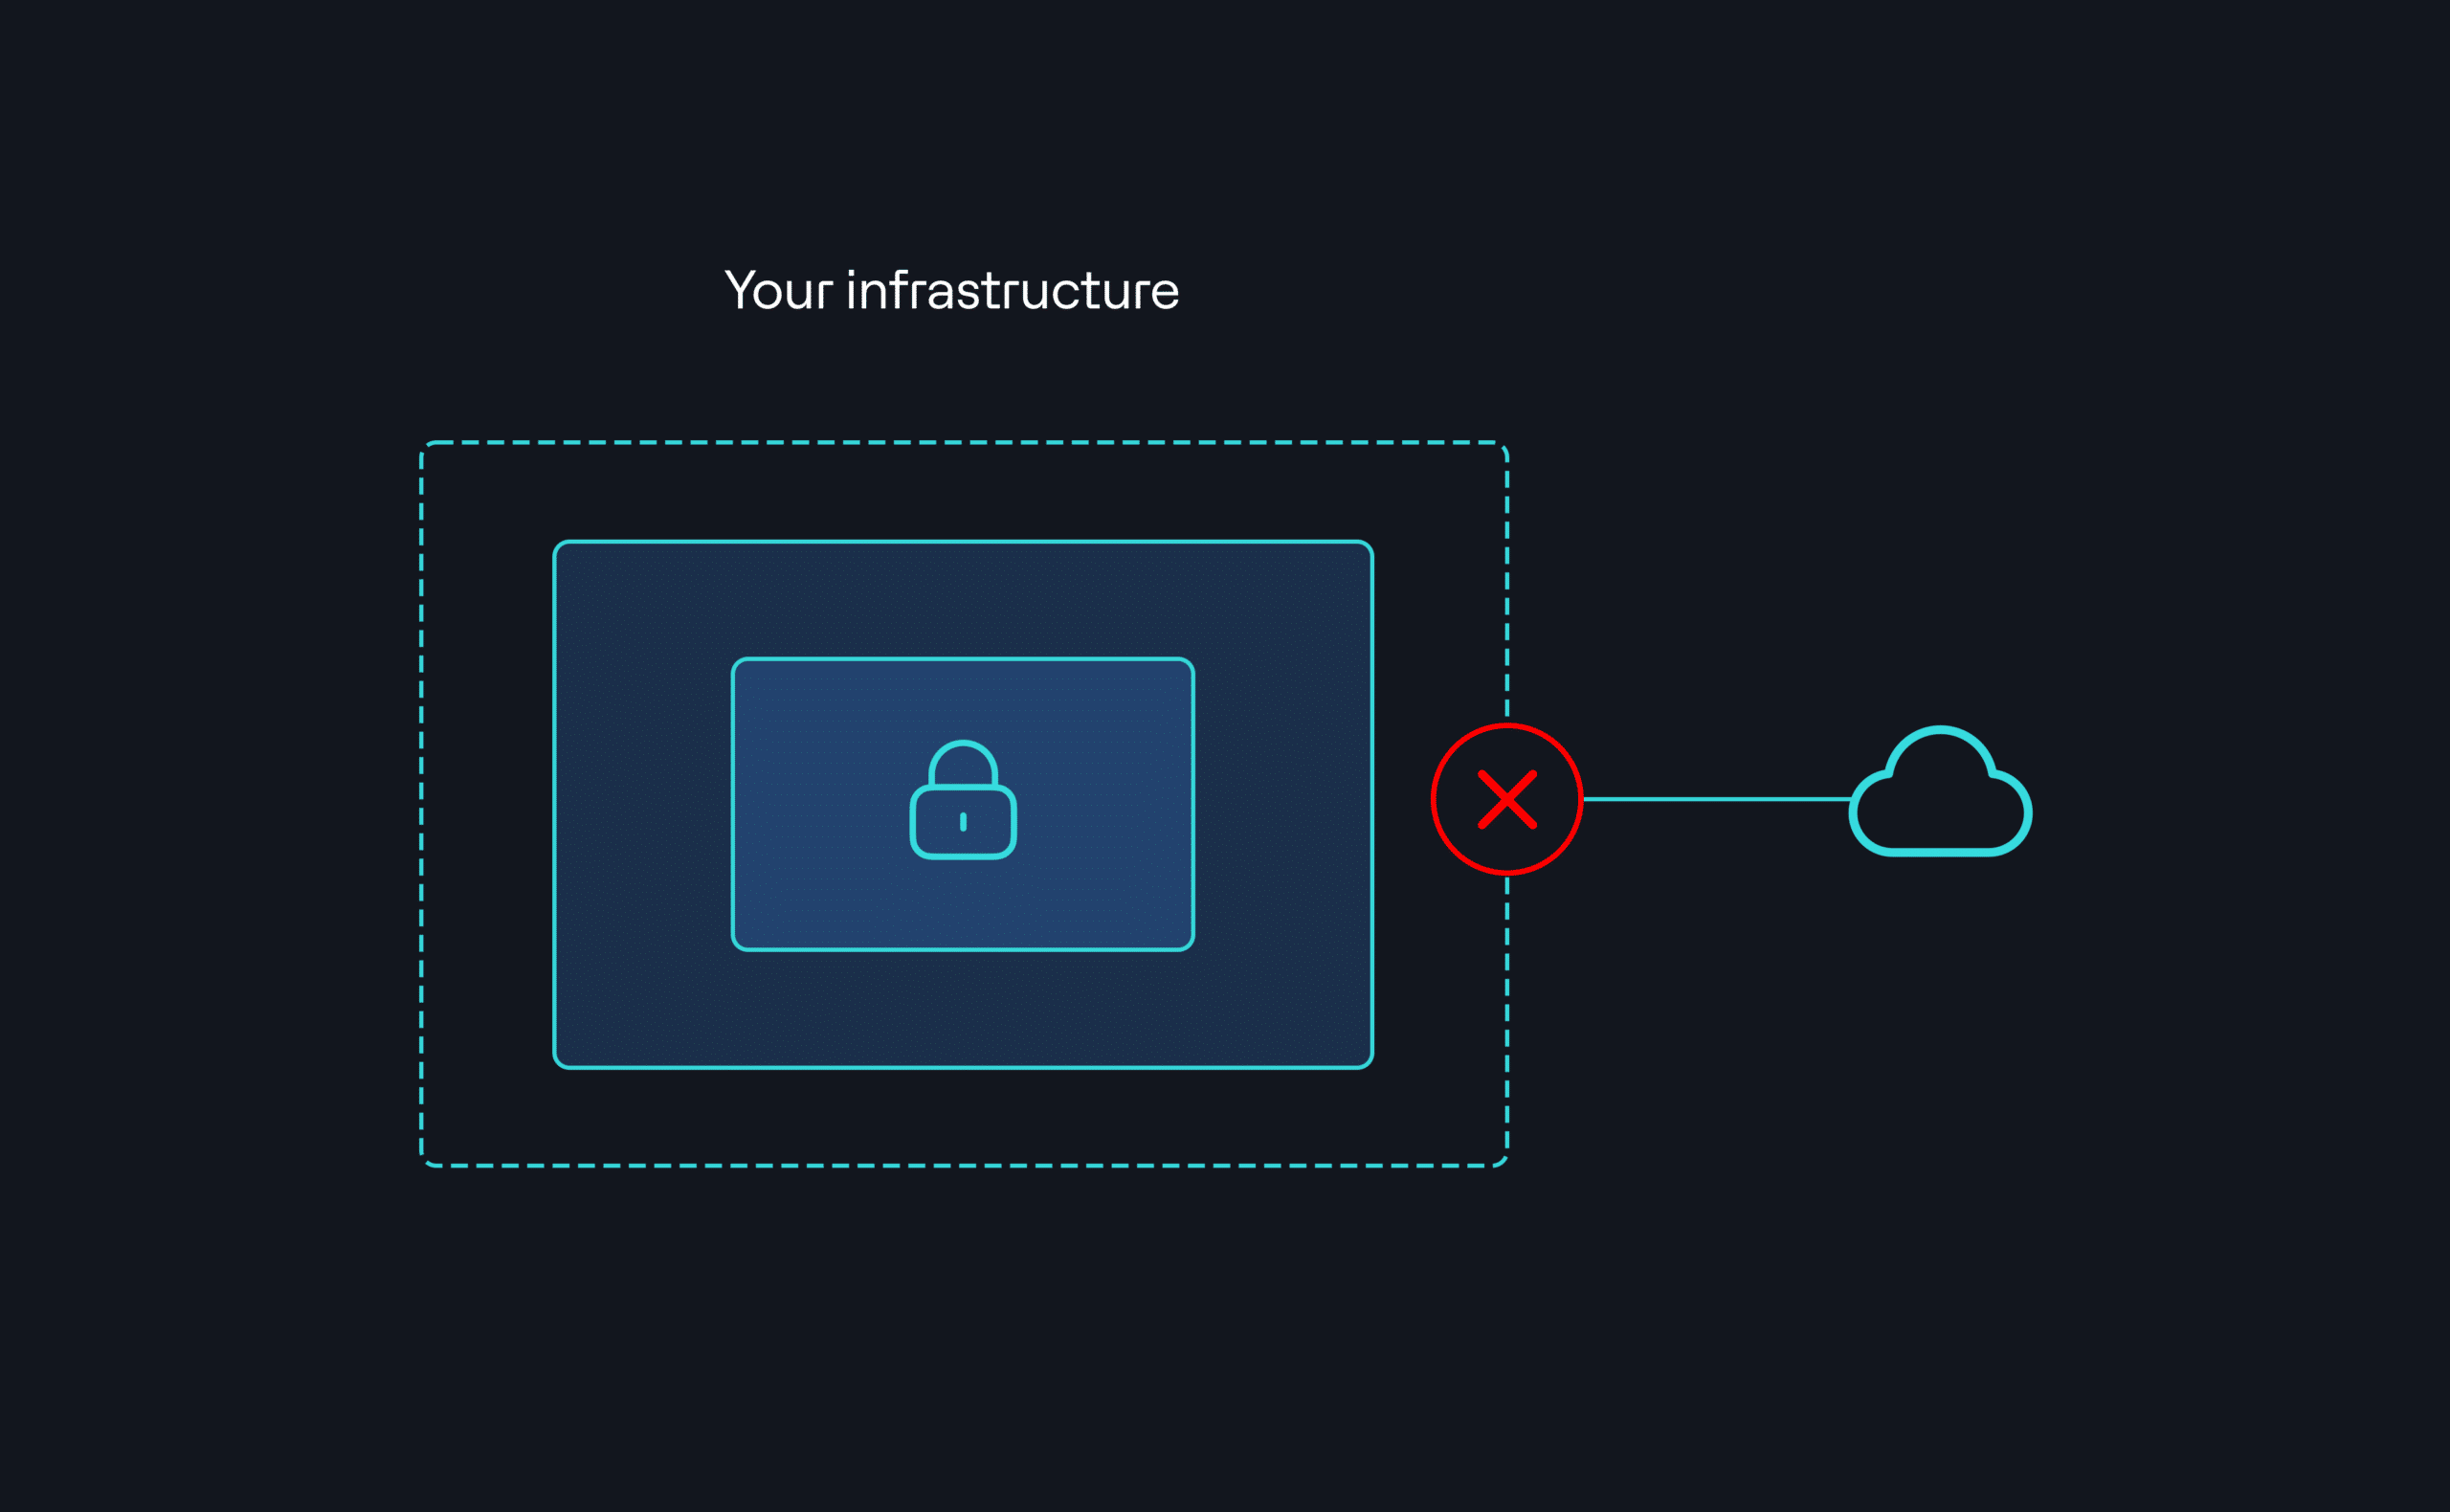
Le respect du RGPD, de HIPAA et des exigences de résidence des données découle directement de l’endroit où vos données sont hébergées.

Adaptez l'index à vos ressources matérielles
Choisissez HNSW ou IVF, ajoutez la quantification vectorielle et dimensionnez l'index en fonction de la mémoire dont vous disposez réellement.
Découvrez VectorAI DB en action
Suivez le déploiement complet d’un agent, de zéro jusqu’à sa première requête.
Démarrez avec votre framework
Intégrez VectorAI DB directement à la stack que vous utilisez déjà.
Utilisez directement le SDK Python de VectorAI DB avec n’importe quelle stack d’agents personnalisée. Vous fournissez le modèle d’embedding ; VectorAI DB prend en charge le stockage et la recherche.
# Install
pip install actian-vectorai

from actian_vectorai import VectorAIClient

client = VectorAIClient(host="localhost:8080")
client.create_collection("agent-memory", dim=768)

results = client.query(
  collection="agent-memory",
  vector=embeddings,
  top_k=10
)
Déployez VectorAI DB comme vous le souhaitez
Des SDK Python et JavaScript, une API REST et un conteneur Docker unique qui fonctionne de la même manière sur un laptop, un appareil edge ou un cluster Kubernetes.



Comparatif de VectorAI DB
Une comparaison transparente des environnements dans lesquels chaque base de données vectorielle peut fonctionner et de ses performances. Le débit est mesuré sur 10 millions de vecteurs de 768 dimensions, avec un matériel identique.
VectorAI DB |
Pinecone |
Qdrant |
Weaviate |
|
|---|---|---|---|---|
Débit sur 10 millions de vecteurs |
745 QPS |
~33 QPS |
~34 QPS |
Variable en auto-hébergement |
Fonctionne sur du matériel edge aux ressources limitées (Jetson, Pi) |
Oui |
Non |
Limité |
Limité |
Même API du prototype à la production |
Oui |
Cloud uniquement |
Oui |
Oui |
Déploiement sur site et air-gapped |
Oui |
Non |
Oui |
Oui |
Option cloud entièrement managée |
Autogéré |
Oui |
Cloud |
Cloud |
Qui développe des applications avec VectorAI DB ?
Des équipes qui déploient leurs applications là où résident les données, y compris dans des environnements où le réseau n'est pas toujours accessible.
Les données des patients restent au sein de votre périmètre pendant toute la durée de chaque requête.
Déploiement : data centers hospitaliers, serveurs de cliniques, environnements de recherche
Un fonctionnement cohérent dans les infrastructures hybrides, edge et multisites, quelles que soient les contraintes de connectivité, de conformité ou de matériel.
Déploiement : hybride, edge + cloud, multisite
FAQ
Actian VectorAI DB est une base de données vectorielle conçue pour les agents IA. Elle leur offre une mémoire persistante et une recherche à faible latence sur une infrastructure que vous contrôlez.
La plupart des bases de données vectorielles ont été conçues pour des déploiements cloud-native et des volumes de requêtes adaptés aux usages humains. VectorAI DB est conçue pour gérer les requêtes simultanées et à haute fréquence générées par des flottes d’agents, et fonctionne de manière cohérente dans les environnements edge, sur site, air-gapped et cloud, sans modification de l’architecture. Pinecone fonctionne exclusivement dans le cloud. Qdrant et Weaviate prennent en charge l’auto-hébergement, mais sont principalement conçus pour des workloads à l’échelle du cloud, et non pour les environnements edge ou déconnectés.
VectorAI DB s’intègre nativement à LangChain, LlamaIndex et Hugging Face. Des SDK Python et JavaScript sont disponibles. Des plugins communautaires étendent la prise en charge à CrewAI, LangGraph et Mastra. La documentation complète sur les intégrations est disponible dans la documentation VectorAI DB.
VectorAI DB atteint 745,2 QPS sur 10 millions de vecteurs de 768 dimensions, soit plus de 22 fois les performances de Milvus et Qdrant sur un matériel identique. Elle est conçue pour les requêtes parallèles et à haute fréquence générées par les flottes d’agents, et non pour les modes d’interrogation séquentiels des applications destinées aux utilisateurs humains.
L’offre gratuite correspond à VectorAI DB Community Edition. Elle est gratuite sans limite de durée et ne nécessite aucune configuration de facturation. Elle offre une capacité de 5 000 vecteurs, peut être déployée sur des machines de développement locales et inclut le support de la communauté.
VectorAI DB prend en charge deux types d'index : HNSW (Hierarchical Navigable Small World) et IVF (Inverted File). Tous deux peuvent être associés à la quantification vectorielle, qui compresse chaque vecteur sous une forme plus compacte afin de réduire davantage l'empreinte mémoire de l'index.
IVF ne remplace pas HNSW. Il constitue une seconde option, et le choix dépend des contraintes de votre environnement de déploiement. Privilégiez HNSW lorsque votre priorité est d'obtenir un recall élevé avec une faible latence et que la mémoire disponible n'est pas une contrainte. C'est le choix par défaut pour la plupart des workloads côté serveur.
Optez pour IVF lorsque l'index doit occuper moins de mémoire ou lorsque les données évoluent constamment. La structure en graphe à plusieurs niveaux de HNSW consomme davantage de mémoire par vecteur et nécessite des opérations de maintenance coûteuses à chaque insertion ou suppression. À l'inverse, le stockage à plat organisé en clusters d'IVF utilise moins de mémoire par vecteur, et l'affectation des vecteurs aux clusters peut être recalculée ou partiellement mise à jour à moindre coût.
VectorAI DB est indépendante des modèles et fonctionne avec les embeddings de n’importe quel fournisseur : OpenAI, Anthropic, Cohere, Hugging Face ou tout modèle personnalisé de votre choix.
Oui. VectorAI DB stocke des embeddings vectoriels issus de textes, d’images, de contenus audio et de vidéos.
Oui. Effectuez votre achat dans le cadre de votre contrat AWS existant et utilisez vos dépenses déjà engagées, y compris celles prévues dans le cadre d'un Enterprise Discount Program (EDP), sans avoir à lancer une nouvelle procédure d'évaluation d'un fournisseur.
Commencez gratuitement, sans configuration de facturation
Tout ce dont vous avez besoin pour prototyper la mémoire de vos agents sur votre propre machine, dès aujourd’hui.

Accès gratuit, sans configuration de facturation
Téléchargez VectorAI DB et commencez immédiatement à l’utiliser. Aucune configuration de facturation n’est requise.
Indexation et recherche vectorielles
Indexation ANN (HNSW et IVF), quantification vectorielle, API de recherche vectorielle et monitoring pour prendre en charge des prototypes contenant jusqu'à 5 000 embeddings vectoriels.
Configuration locale rapide
Installez VectorAI DB, indexez vos données et exécutez vos premières requêtes en quelques minutes grâce à une documentation claire, des guides de démarrage rapide et des exemples de code.