
Créer une base de données « agents IA » locale sur un Raspberry Pi 5 avec VectorAI DB


Points clés à retenir
- Un Raspberry Pi 5 peut exécuter une « agents IA » entièrement locale avec Ollama et la base de données Actian VectorAI, tout en conservant la persistance de la mémoire d'un redémarrage à l'autre.
- L'agent utilise Qwen 2.5 1.5B pour les réponses, nomic-Embarquer-text pour les représentations, et VectorAI DB pour la recherche sémantique dans la mémoire.
- Sur le Pi utilisé pour le test, les mémoires concernées ont été récupérées en 1,8 ms, tandis que l'inférence du modèle local a pris 3,6 secondes.
- VectorAI DB a renvoyé les cinq premiers résultats parmi 100 000 vecteurs, avec un temps de latence de récupération p99 inférieur à 5 ms sur le matériel testé.
- Un stockage NVMe, un refroidissement actif et une alimentation suffisante permettent au Pi de prendre en charge des charges de travail d'IA locales, tandis que les modèles plus volumineux et les systèmes multi-agents peuvent nécessiter un matériel plus puissant.
Si vous développez un agent sur un Raspberry Pi, celui-ci doit être capable de conserver en mémoire les sessions précédentes après un redémarrage du processus, un redémarrage du système, une mise hors tension puis remise sous tension, ou encore un plantage. Pour le système de surveillance de serre présenté dans ce tutoriel, cela signifie pouvoir récupérer la valeur relevée par un capteur la semaine dernière lorsque vous en faites la demande aujourd’hui.
La couche mémoire doit également fonctionner dans les limites matérielles du Pi. Certaines bases de données ralentissent à mesure que la collection s'étoffe. D'autres nécessitent un processus serveur distinct qui utilise la mémoire vive (RAM) en parallèle d'Ollama. Nous devons également savoir comment évolue la latence de récupération lorsque la mémoire de l'agent passe de 10 000 à 100 000 vecteurs. Nous avons testé cela sur un Raspberry Pi 5.
$ uv run agent.py
Agent ready on Raspberry Pi 5 Model B Rev 1.1, 8 GB RAM | LLM: qwen2.5:1.5b | 2 memories in VectorAI DB. Ctrl+C to quit.

you> Which greenhouse sensor was reading high, and what was going on in zone B?

agent> The greenhouse sensor 3 was reading 41 degrees, indicating a high temperature. In zone B, the irrigation pump was switched off for maintenance.
Ces deux données provenaient d’une session antérieure, et nous avons redémarré la base de données entre-temps. La base de données VectorAI d’Actian les a retrouvées en 1,8 ms, tandis que Qwen 2.5 1,5B a fourni une réponse en 3,6 secondes sur le Pi ( processeur), sans recourir à une API cloud.
Le matériel utilisé est un Raspberry Pi 5 de 8 Go équipé d’un SSD NVMe et du système de refroidissement officiel Active Cooler. Ollama exécute le modèle, tandis qu’Actian VectorAI DB stocke la mémoire de l’agent sur le disque. L’agent enregistre ce que vous lui dites sous forme de vecteurs, effectue des recherches parmi ceux-ci lorsque vous posez une question, puis transmet les vecteurs pertinents au modèle.
À la fin de ce tutoriel, vous aurez réussi à faire fonctionner cet agent sur votre propre Pi 5, avec une mémoire qui persiste après les redémarrages. Vous disposerez également d'un test de performance montrant comment la latence de récupération évolue à mesure que la collection passe de 1 000 à 100 000 vecteurs.
Conditions préalables
- Raspberry Pi 5 8 Go avec un module HAT PCIe NVMe, un SSD NVMe, un dissipateur thermique officiel « Active Cooler » et l'adaptateur secteur USB-C officiel de 27 W.
- Raspberry Pi OS 64 bits (Trixie).
- Docker avec le plugin Compose (
curl -fsSL https://get.docker.com | sh), ainsi que votre adresse utilisateur dans le groupe Docker (sudo usermod -aG docker “$USER”, puis déconnectez-vous et reconnectez-vous). - uv, le gestionnaire de paquets d’ Python s (il est installé à l’étape 3). Il installe pour vous une version compatible d’ Python 3.11 ou supérieure si votre système n’en dispose pas.
- Une licence VectorAI DB ou une version d'essai de 30 jours. L'édition Community gratuite limite les collections à moins de 5 000 vecteurs. Cela suffit amplement pour ce tutoriel, mais les tests de performance à 10 000 et 100 000 vecteurs nécessitent une licence.
- Tout le code se trouve dans le Dépôt GitHub. Clonez-le et exécutez-le
./setup.sh, qui couvre les étapes 1 à 5, à l'exception du redémarrage lié à la limite de mémoire ; passez ensuite à l'étape 6.
Ce que vous construisez
La configuration fonctionne sur le Pi : deux conteneurs Docker et un script « Python ».
Ollama exécute deux modèles dans un conteneur Docker dont la mémoire est limitée à 4 Go. qwen2.5:1.5b génère des réponses. nomic-embed-text transforme le texte en vecteurs de 768 dimensions. Une fois les deux chargés, Ollama occupait 1,58 GiB sur la carte de test.
Base de données Actian VectorAI fonctionne dans un deuxième conteneur limité à 2 Go. Il stocke chaque message d'utilisateur sous forme de vecteur dans un index HNSW (Hierarchical Navigable Small World) et l'écrit sur un volume SSD local, ce qui permet de conserver les données en mémoire après un redémarrage. Il a utilisé 125 Mio avec de petites collections.
agent.py les relie en moins de 100 lignes de code, sans recourir à une infrastructure de serveurs intermédiaires. Il appelle Ollama via HTTP avec requests et communique avec la base de données VectorAI via le SDK officiel Python .
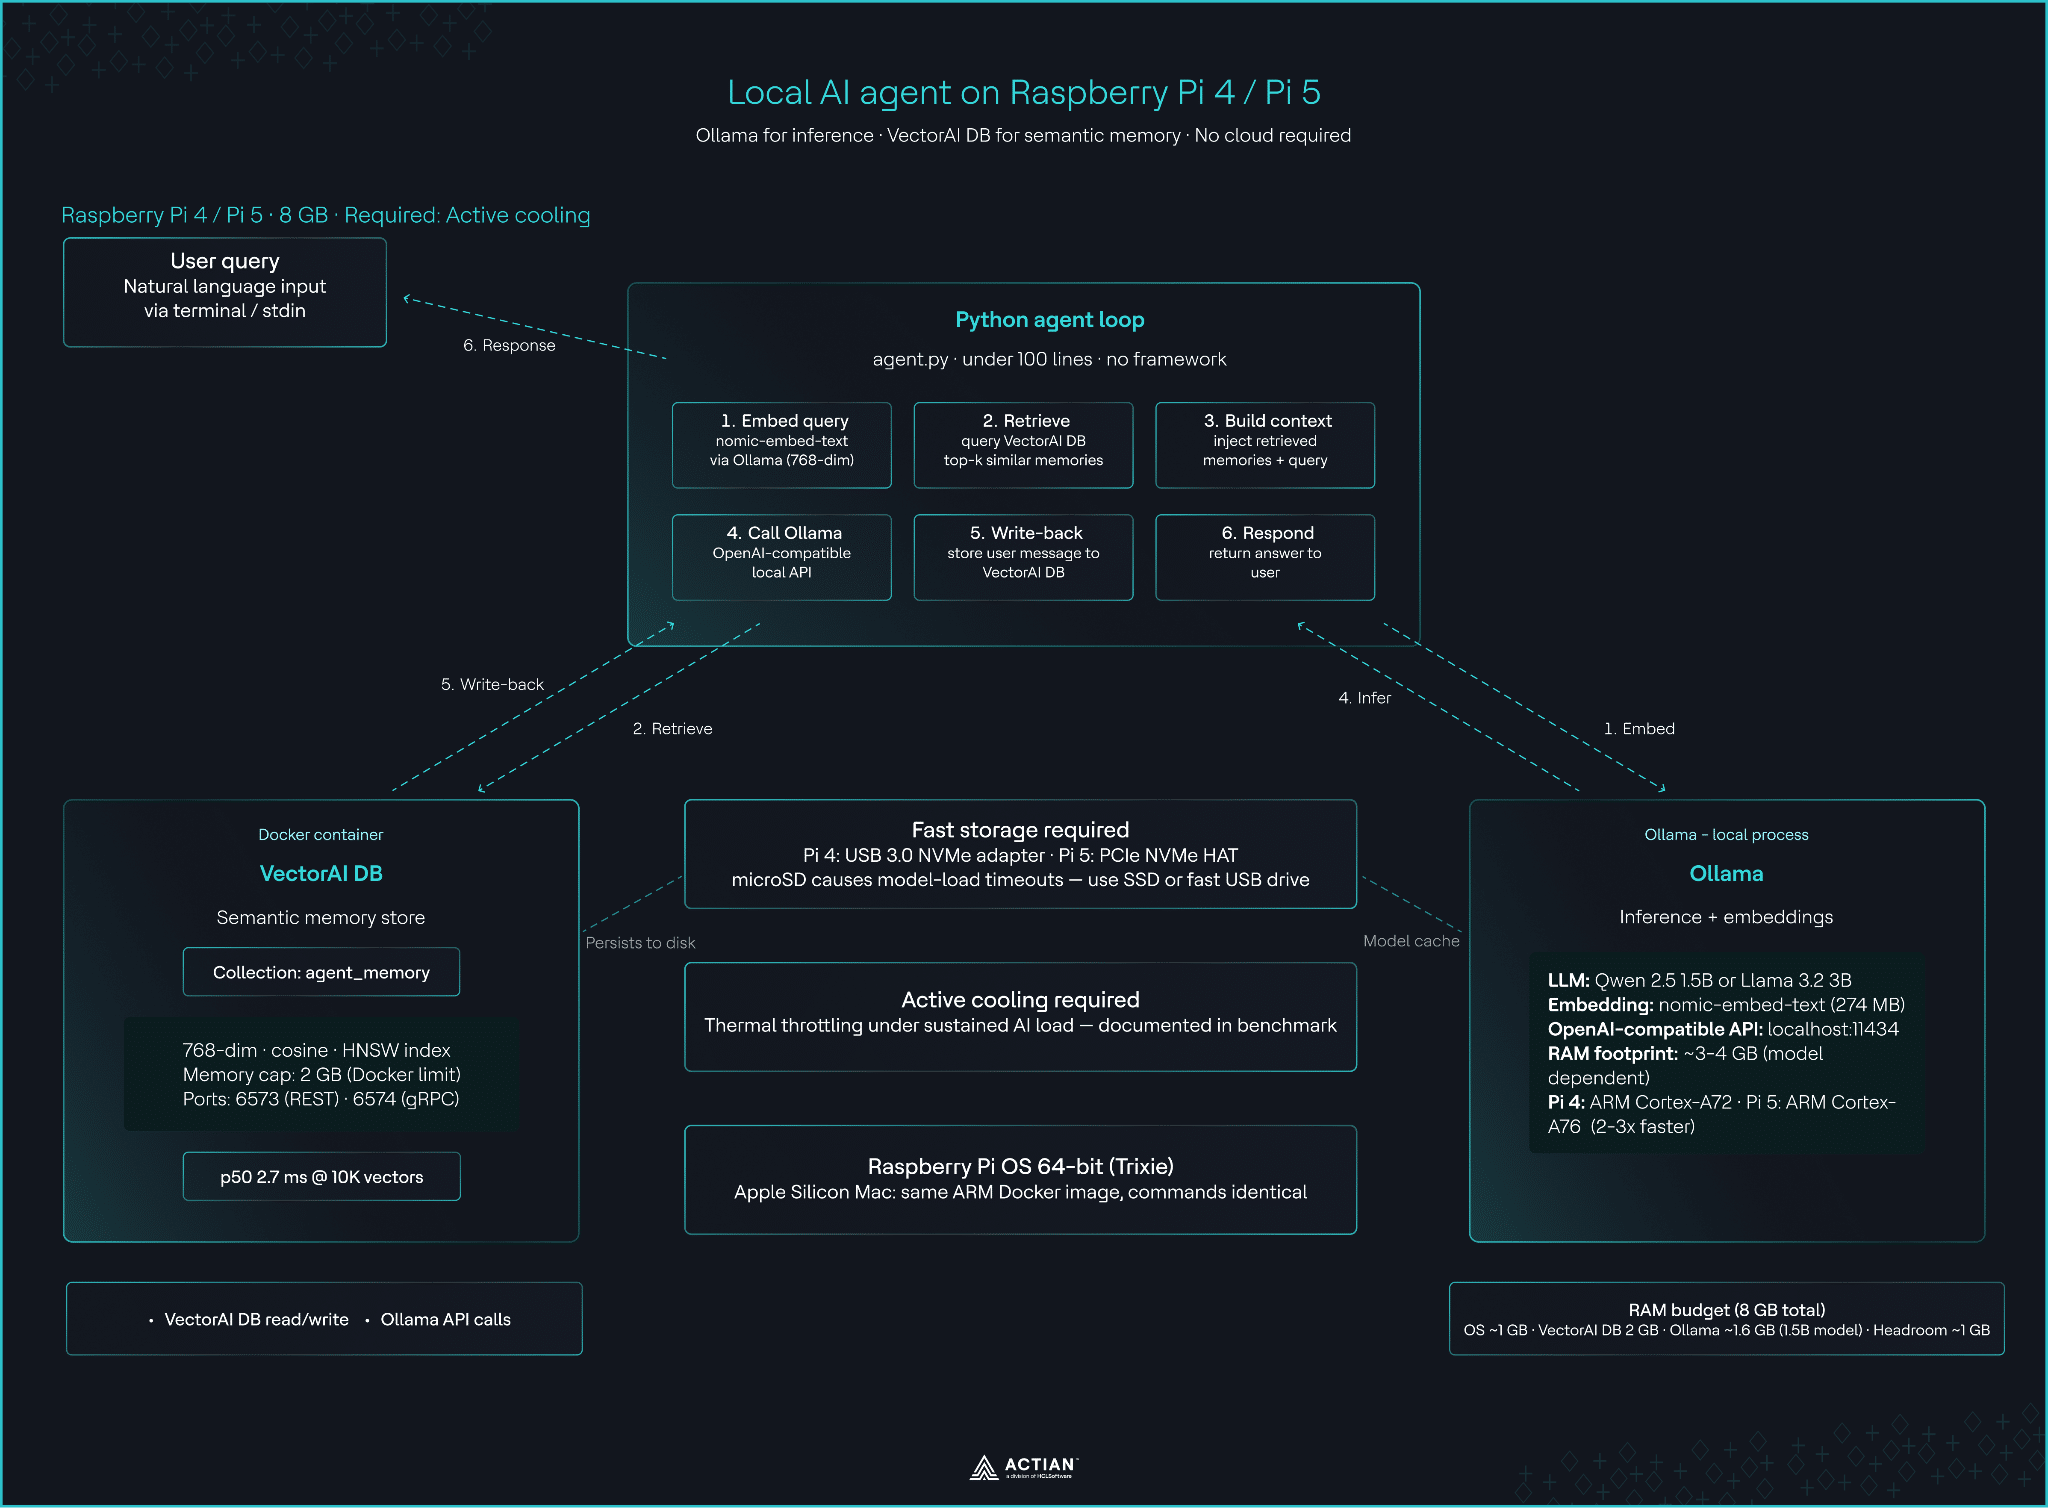
Schéma architectural. Vous posez une question. L’agent l’intègre, récupère les souvenirs associés dans la base de données VectorAI, les injecte dans la requête, appelle Qwen 2.5 1,5 milliard via Ollama, puis réenregistre votre message dans la base de données VectorAI. L’ensemble de la pile s’exécute sur la carte.
Matériel nécessaire
Utilisez un Pi 5 de 8 Go équipé d'un stockage NVMe et d'un système de refroidissement actif. Chacun des éléments ci-dessous permet d'éviter une défaillance que vous risqueriez sinon de rencontrer.
| Partie | Ce dont vous avez besoin |
| Conseil d'administration | Raspberry Pi 5, 8 Go |
| Stockage | Disque SSD NVMe sur une carte HAT PCIe |
| Refroidissement | Refroidisseur « Official Active Cooler » ou équivalent |
| Puissance | Alimentation USB-C officielle de 27 W |
| Système d'exploitation | Raspberry Pi OS 64 bits (Trixie) |
Mémoire vive. Une fois les deux modèles chargés, la pile utilisait au total 2,38 GiB : environ 630 Mo pour le système d’exploitation, 1,58 GiB pour Ollama, 125 MiB pour la base de données VectorAI (179 MiB juste après un redémarrage), et le reste pour le processus de l’agent. Une carte de 4 Go pourrait faire fonctionner cette configuration exacte, mais nous ne l’avons pas testée.
NVMe. Le Pi de test démarre à partir d'une carte microSD et ne conserve que les données de modèle et de vecteur sur le disque NVMe. À partir d'un cache « chaud », qwen2.5:1.5b s'est rechargé en 3,1 secondes et nomic-embed-text en 0,26 seconde. Juste après un redémarrage, Qwen a mis 4,4 secondes à se charger. Le Pi 5 fonctionne par défaut en PCIe Gen 2. Le test de performance a été effectué en Gen 3, que l'on active à l'aide d'une seule ligne de commande.
echo "dtparam=pciex1_gen=3" | sudo tee -a /boot/firmware/config.txt
sudo reboot
Refroidissement. Au cours du test de performance de 100 000, la température du SoC est passée de 46,6 °C à 68,6 °C et vcgencmd get_throttled signalé 0x0 avant et après, de sorte que l’ processeur e n’a jamais été bridée. Lors d’un test précédent de 100 000 cycles, le SoC avait atteint une température maximale de 77,4 °C avec le ventilateur tournant à 8 731 tr/min. Le Pi 5 commence à brider l’ processeur e à 80 °C ; un dissipateur thermique passif dépasserait donc probablement ce seuil. Un premier test réalisé avec une alimentation moins puissante a montré que 0x50000 (sous-tension) ; l'alimentation officielle de 27 W a résolu le problème.
Pas de Pi : Un Mac équipé d'Apple Silicon exécute les mêmes images arm64 et toutes les commandes présentées ici. Vos temps de latence seront inférieurs, ne les comparez donc pas directement aux résultats obtenus sur le Pi.
Étape 1 : Lancez VectorAI DB et Ollama
Commencez par activer les limites de mémoire. Le système d'exploitation Raspberry Pi démarre avec le cgroup de mémoire désactivé ; Docker ignore donc silencieusement mem_limit jusqu'à ce que vous l'allumiez :
sudo sed -i '1 s/$/ cgroup_enable=memory/' /boot/firmware/cmdline.txt
sudo reboot
Après le redémarrage, docker info ne devrait plus afficher d'avertissement No memory limit support.
Créez le répertoire du projet :
mkdir -p pi5-vectorai-agent && cd pi5-vectorai-agent
mkdir -p data ollama results
sudo chown 999:999 data     # VectorAI DB runs as UID 999 and crash-loops on a root-owned mount
Enregistrer sous le nom :docker-compose.yml
services:
  vectorai:
    image: actian/vectorai:latest
    container_name: vectorai
    # the licence is tied to the host identity; a fixed hostname keeps it valid when the container is recreated
    hostname: vectorai
    ports:
      - "6573:6573" # REST
      - "6574:6574" # gRPC
    volumes:
      # vector data persists across restarts
      - ./data:/var/lib/actian-vectorai
    environment:
      - VECTORAI_LOG_LEVEL=info
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    mem_limit: 2g
    restart: unless-stopped

  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    ports:
      - "11434:11434"
    volumes:
      - ./ollama:/root/.ollama
    mem_limit: 4g
    restart: unless-stopped
Démarrez les deux services :
docker compose up -d
docker ps
Les deux conteneurs devraient afficher Up. Le démarrage de VectorAI DB prend environ 15 secondes. Si vous souhaitez ajouter une licence, faites-le maintenant. La recréation ultérieure du conteneur (par exemple avec --force-recreate) l'invalide.
Étape 2 : Récupérer les modèles
qwen2.5:1.5b pèse environ 1,1 Go et nomic-embed-text environ 274 Mo :
docker exec ollama ollama pull qwen2.5:1.5b
docker exec ollama ollama pull nomic-embed-text
La commande « pulling » ne fait que télécharger les modèles. Ollama charge chacun d'entre eux en mémoire vive (RAM) lors de la première utilisation et le conserve chargé pendant cinq minutes après la dernière requête (réglage par défaut d'Ollama) ; par conséquent, le premier message envoyé après une pause prend plus de temps.
Étape 3 : Installation des dépendances d'Python
Ce projet utilise uv, qui gère l'environnement virtuel et installe pour vous une version compatible d'Python . Installez-le :
curl -LsSf https://astral.sh/uv/install.sh | sh
source $HOME/.local/bin/env
Enregistrer sous le nom de pyproject.toml dans le répertoire du projet :
[project]

name = "pi5-vectorai-agent"
version = "0.1.0"
description = "Offline AI agent with semantic memory on a Raspberry Pi 5: Ollama + Actian VectorAI DB"
requires-python = ">=3.11"
# uv run agent.py reads this, creates .venv and installs these on first run
dependencies = [
    "requests",                # Ollama's HTTP API
    "actian-vectorai-client",  # VectorAI DB client (gRPC); brings numpy, protobuf, grpcio
    "numpy",                   # benchmark vectors
    "matplotlib",              # benchmark chart only
]
Créez ensuite l'environnement :
uv syncuv sync dit pyproject.toml, crée .venv, puis installe les quatre paquets. À partir de là, commencez chaque commande « Python » par uv run; il n'y a pas d'environnement à activer. NumPy et Matplotlib ne servent qu'à réaliser le test de performance et le graphique.
Étape 4 : Tester le fonctionnement des deux services
Vérifiez que les deux services répondent avant d'écrire le code de l'agent :
uv run python -c 'from actian_vectorai import VectorAIClient

with VectorAIClient("localhost:6574") as c: print(c.health_check())'


curl -s http://localhost:11434/api/embed \
  -d '{"model":"nomic-embed-text","input":"hello"}' | head -c 120

curl -s http://localhost:11434/api/generate \
  -d '{"model":"qwen2.5:1.5b","prompt":"Say hi in five words.","stream":false}'
{'title': 'Actian VectorAI DB', 'version': 'Actian VectorAI DB 1.0.2 / VDE 1.0.2'}

{"model":"nomic-embed-text","embeddings":[[0.017874617,-0.0058246492,-0.17537898,...

{"model":"qwen2.5:1.5b",...,"response":"Hello there!","done":true,...}
Vérifiez la mémoire vive (RAM) avec les deux modèles installés :
docker stats --no-stream --format "{{.Name}}: {{.MemUsage}}"Sur la carte de test :
ollama: 1.58GiB / 4GiB
vectorai: 125MiB / 2GiB
Si la colonne « Limite » affiche la quantité totale de RAM au lieu de 4GiB et 2GiB, la modification du cgroup effectuée à l'étape 1 n'a pas été prise en compte.
Étape 5 : Créer la collection « Mémoire »
Créer une collection dont la taille correspond à nomic-embed-textles vecteurs à 768 dimensions :
uv run python - <<'EOF'

from actian_vectorai import VectorAIClient, VectorParams, Distance
with VectorAIClient("localhost:6574") as client:

    client.collections.create(

        "agent_memory",

        vectors_config=VectorParams(size=768, distance=Distance.Cosine),

    )

EOF
Cette étape est facultative ; l'agent crée la collection lors de sa première exécution. L'exécuter maintenant permet de vérifier que la base de données accepte les écritures. (setup.sh fait la même chose via l'API REST sur le port 6573.)
Étape 6 : Créer l'agent
Enregistrer sous le nom de agent.py:
Enregistrez ce fichier sous le nom agent.py :
"""Local AI agent with semantic memory: Ollama (Qwen 2.5 1.5B) + Actian VectorAI DB."""

import os

import sys

import time

import requests

from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams

OLLAMA = "http://localhost:11434"

VECTORAI = "localhost:6574"

CHAT_MODEL = "qwen2.5:1.5b"

EMBED_MODEL = "nomic-embed-text"

EMBED_DIM = 768            # nomic-embed-text output size

COLLECTION = "agent_memory"

TOP_K = 3

MIN_SCORE = 0.6            # unrelated memories score ~0.3-0.55 with nomic-embed-text, related ones 0.7+


def embed(text: str) -> list[float]:

    r = requests.post(f"{OLLAMA}/api/embed", json={"model": EMBED_MODEL, "input": text}, timeout=60)

    r.raise_for_status()

    return r.json()["embeddings"][0]


def chat(messages: list[dict]) -> str:

    # Ollama exposes an OpenAI-compatible endpoint, so any OpenAI client works here too

    r = requests.post(f"{OLLAMA}/v1/chat/completions", timeout=300,

                      json={"model": CHAT_MODEL, "messages": messages, "temperature": 0.3})

    r.raise_for_status()

    return r.json()["choices"][0]["message"]["content"]


# Tell the model what it runs on, so "what hardware is this?" gets a real answer

MODEL_FILE = "/proc/device-tree/model"

BOARD = open(MODEL_FILE).read().strip("\x00\n ") if os.path.exists(MODEL_FILE) else "unknown board"

HARDWARE = f"{BOARD}, {os.sysconf('SC_PAGE_SIZE')  os.sysconf('SC_PHYS_PAGES') / 1024*3:.0f} GB RAM"


def step(db: VectorAIClient, user_msg: str) -> str:

    # 1. Embed the incoming query on the Pi CPU

    t0 = time.perf_counter()

    qvec = embed(user_msg)

    t1 = time.perf_counter()

    # 2. Retrieve the closest past exchanges from VectorAI DB (HNSW index)

    hits = db.points.search(COLLECTION, vector=qvec, limit=TOP_K, with_payload=True)

    t2 = time.perf_counter()

    memories = [h.payload["text"] for h in hits if h.score >= MIN_SCORE]

    # 3. Inject retrieved memories into the system prompt, labelled as past notes

    #    so a small model doesn't mistake them for the current message

    context = "\n".join(f"- {m}" for m in memories) or "- (none)"

    messages = [

        {"role": "system", "content": f"You are a helpful assistant running fully offline on {HARDWARE} "

         f"with {CHAT_MODEL} via Ollama and Actian VectorAI DB for memory.\n"

         "Every message the user sends is saved to your memory automatically. If the user tells you "

         "a fact, confirm in one sentence that you will remember it.\n"

         "Answer in 1-3 sentences. Only use the notes below if they help answer the current message.\n\n"

         "Notes from earlier conversations:\n" + context},

        {"role": "user", "content": user_msg},

    ]


    # 4. Local inference through Ollama

    answer = chat(messages)

    t3 = time.perf_counter()


    # 5. Write the user's message back so future sessions can recall it. Only the user's

    #    side is stored: the facts come from the user, and storing the model's own replies

    #    would feed any wrong answer back into later prompts. The query vector is reused.

    db.points.upsert(COLLECTION, [PointStruct(

        id=time.time_ns() // 1000,  # microsecond timestamp as a unique integer ID

        vector=qvec,

        payload={"text": f"User said: {user_msg}", "ts": time.time()},

    )])

    t4 = time.perf_counter()


    print(f"
")

    return answer


def main() -> None:

    with VectorAIClient(VECTORAI) as db:

        if db.collections.exists(COLLECTION):

            # VectorAI DB keeps collections on disk but only loads them when opened;

            # without this, search and count fail after every DB restart

            db.vde.open_collection(COLLECTION)

        else:

            db.collections.create(COLLECTION, vectors_config=VectorParams(size=EMBED_DIM, distance=Distance.Cosine))

        print(f"Agent ready on {HARDWARE} | LLM: {CHAT_MODEL} | "

              f"{db.points.count(COLLECTION)} memories in VectorAI DB. Ctrl+C to quit.")

        if len(sys.argv) > 1:  # one-shot mode: python agent.py "your question"

            print(step(db, " ".join(sys.argv[1:])))

            return

        try:  # Ctrl+C quits cleanly, even mid-answer

            while True:

                user_msg = input("\nyou> ").strip()

                if user_msg:

                    print(f"agent> {step(db, user_msg)}")

        except (EOFError, KeyboardInterrupt):

            print()


if name == "__main__":

    main()
Chaque tour se déroule en cinq phases :
Embarquer. nomic-embed-text convertit votre message en un vecteur de 768 dimensions sur l'processeur du Pi, en environ 80 ms une fois que le modèle est prêt. Ce même vecteur est réutilisé pour la réécriture, de sorte que chaque message ne nécessite qu'une seule incorporation.
Récupération. VectorAI DB renvoie les trois messages enregistrés les plus proches de votre question, chacun étant associé à un score de similarité : plus ce score est élevé, plus le message est proche. L’agent ne conserve que ceux dont le score est égal ou supérieur à 0,6. Lors du test Pi, les messages portant sur le même sujet que la question ont obtenu un score de 0,7 ou plus, tandis que ceux sans rapport ont obtenu un score compris entre 0,3 et 0,55 ; le seuil de 0,6 se situe donc entre ces deux valeurs. Lorsque vous posez une question de culture générale à laquelle aucun élément de la mémoire ne se rapporte, l’agent ne transmet aucun élément de mémoire au modèle.
Injecter. Les souvenirs sont intégrés dans l'invite du système sous l'étiquette « Notes issues de conversations précédentes ». Un modèle de 1,5 milliard de paramètres a besoin de cette étiquette. Sans elle, les petits modèles confondent les anciennes notes avec le message actuel.
Générer. La requête est envoyée à l'API d'Ollama compatible avec OpenAI /v1/chat/completions limite. En limitant les réponses à une à trois phrases, on garantit une durée de déduction prévisible pour l'processeur . Qwen 2.5 1,5B a fonctionné à une vitesse de 12,1 tokens par seconde, identique lors des trois exécutions.
Enregistrer. Seul votre message est enregistré, jamais la réponse du modèle ; ainsi, une mauvaise réponse ne peut pas influencer les invites suivantes. L'identifiant est un horodatage en microsecondes, ce qui garantit l'unicité des entrées sans avoir recours à un générateur d'identifiants.
Lancez-le :
uv run agent.pyLa persévérance. La mémoire est conservée après les redémarrages car la base de données VectorAI DB écrit dans ./data sur le SSD. Après un redémarrage de la base de données, une collection reste sur le disque mais n'est chargée que lorsque l'application l'ouvre, c'est pourquoi main() appels db.vde.open_collection(). Sans cet appel, les opérations de recherche et de comptage échouent après chaque redémarrage. Pour le tester, indiquez un fait à l'agent, quittez, puis exécutez docker compose restart vectorai, relancez l'agent, puis renseignez-vous à ce sujet.
Pour savoir comment les agents stockent, classent et libèrent la mémoire, consultez l'article « Qu'est-ce que la mémoire d'agent ? Architecture et modèles d'déploiement ».
La référence
Sur le Pi 5 utilisé pour le test, VectorAI DB a renvoyé les 5 premiers résultats parmi 100 000 vecteurs en 4,17 ms au p50 et en 4,98 ms au p99. Voici comment reproduire ce résultat.
Méthode
- Matériel : Raspberry Pi 5 Modèle B Rév. 1.1, 8 Go ; démarrage depuis une carte microSD ; disque Kingston NV3 de 500 Go (SNV3SM3500G) NVMe monté sur un Raspberry Pi M.2 HAT+ (SC1166) en PCIe Gen 3 (8,0 GT/s) contenant
data/etollama/; Active Cooler officiel ; Raspberry Pi OS 64 bits (Trixie), noyau 6.18.50+rpt-rpi-2712 ; VectorAI DB 1.0.2 limité à 2 Go ; Ollama fonctionnant avec les deux modèles chargés. - Tailles des corpus : 1 000, 10 000 et 100 000 vecteurs, chacun dans un ensemble distinct. Les tests à 10 000 et 100 000 vecteurs ont été réalisés à l'aide d'une instance sous licence.
- Vecteurs : 768 dimensions, normalisés à l'unité, distance cosinus, paramètres HNSW par défaut de VectorAI DB.
- Requêtes : 10 recherches d'échauffement, puis 100 recherches chronométrées pour obtenir les 5 premiers résultats, en fonction de la taille du corpus.
Ces vecteurs sont des vecteurs unitaires aléatoires synthétiques, et non de véritables représentations textuelles. Les véritables représentations sont regroupées par thème, ce qui facilite la recherche pour HNSW ; ces chiffres constituent donc une estimation prudente de ce que vous observeriez en environnement de production.
benchmark.py charge chaque corpus par lots de 500, multiplie le nombre de recherches et génère un fichier CSV qui enregistre également la carte mère, la mémoire vive, le périphérique de stockage, la température finale et l'état de la limitation de puissance :
"""Retrieval latency benchmark for VectorAI DB on Raspberry Pi 5.

Loads 1K / 10K / 100K vectors (768-dim, same size as nomic-embed-text), runs

100 timed top-k searches per corpus size, and writes p50/p95/p99 to CSV.

Vectors are synthetic (random, unit-normalized) so the 100K load finishes in

minutes instead of hours of on-device embedding. Random vectors are a harder

case for HNSW than real text embeddings, so treat these numbers as conservative.
The free Community edition caps the server at 5,000 vectors; without a licence

run it with --sizes 1000 2000 4000.


Usage: python benchmark.py [--sizes 1000 10000 100000] [--queries 100]

"""

import argparse

import csv

import platform

import statistics

import subprocess

import time

from pathlib import Path


import numpy as np

from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams


DIM = 768

TOP_K = 5

BATCH = 500

WARMUP = 10


def hardware() -> dict:

    def read(path: str) -> str:

        try:

            return Path(path).read_text().strip("\x00\n ")

        except OSError:

            return "unknown"


    def cmd(*args: str) -> str:

        try:

            return subprocess.run(args, capture_output=True, text=True, timeout=5).stdout.strip()

        except (OSError, subprocess.SubprocessError):

            return "unknown"


    mem_kb = next((line.split()[1] for line in read("/proc/meminfo").splitlines() if line.startswith("MemTotal")), "0")

    # ask Docker where the vectorai container keeps its data, so the CSV names the drive

    # the database actually writes to (the NVMe), wherever this script was cloned

    data_dir = cmd("docker", "inspect", "-f", '{{range .Mounts}}{{if eq .Destination "/var/lib/actian-vectorai"}}'

                   '{{.Source}}{{end}}{{end}}', "vectorai") or str(Path(__file__).resolve().parent / "data")

    return {

        "board": read("/proc/device-tree/model"),

        "arch": platform.machine(),

        "kernel": platform.release(),

        "ram_gb": round(int(mem_kb) / 1024 / 1024, 1),

        "storage": cmd("findmnt", "-no", "SOURCE", "-T", data_dir) or "unknown",

        # vcgencmd prints "temp=48.3'C" / "throttled=0x0"; keep only the value

        "temp": cmd("vcgencmd", "measure_temp").split("=")[-1],

        "throttled": cmd("vcgencmd", "get_throttled").split("=")[-1],  # 0x0 means no throttling since boot

    }


def unit_vectors(n: int, rng: np.random.Generator) -> np.ndarray:

    v = rng.standard_normal((n, DIM)).astype(np.float32)

    return v / np.linalg.norm(v, axis=1, keepdims=True)


def load(db: VectorAIClient, name: str, n: int, rng: np.random.Generator) -> float:

    if db.collections.exists(name):

        db.collections.delete(name)

    db.collections.create(name, vectors_config=VectorParams(size=DIM, distance=Distance.Cosine))

    t0 = time.perf_counter()

    for start in range(0, n, BATCH):

        vecs = unit_vectors(min(BATCH, n - start), rng)

        db.points.upsert(name, [

            PointStruct(id=start + i, vector=v.tolist(), payload={"i": start + i})

            for i, v in enumerate(vecs)

        ])

    return time.perf_counter() - t0


def measure(db: VectorAIClient, name: str, queries: int, rng: np.random.Generator) -> list[float]:

    qs = unit_vectors(queries + WARMUP, rng).tolist()

    for q in qs[:WARMUP]:  # first searches load the collection into memory

        db.points.search(name, vector=q, limit=TOP_K)

    lat = []

    for q in qs[WARMUP:]:

        t0 = time.perf_counter()

        db.points.search(name, vector=q, limit=TOP_K)

        lat.append((time.perf_counter() - t0) * 1000)

    return lat


def pct(values: list[float], p: float) -> float:

    return float(np.percentile(values, p))


def main() -> None:

    ap = argparse.ArgumentParser()

    # Community edition (no licence) is capped at 5K vectors: use --sizes 1000 2000 4000

    ap.add_argument("--sizes", type=int, nargs="+", default=[1_000, 10_000, 100_000])

    ap.add_argument("--queries", type=int, default=100)

    ap.add_argument("--host", default="localhost:6574")

    ap.add_argument("--out", default="results/benchmark.csv")

    ap.add_argument("--keep", action="store_true", help="keep benchmark collections afterwards")

    args = ap.parse_args()


    hw = hardware()

    print("Hardware:", ", ".join(f"{k}={v}" for k, v in hw.items()))

    rng = np.random.default_rng(42)

    rows = []


    with VectorAIClient(args.host) as db:

        for n in args.sizes:

            name = f"bench_{n}"

            print(f"\n== {n:,} vectors ==")

            load_s = load(db, name, n, rng)

            print(f"  loaded in {load_s:.1f} s ({n / load_s:,.0f} vectors/s)")

            lat = measure(db, name, args.queries, rng)

            row = {

                "vectors": n, "dim": DIM, "top_k": TOP_K, "queries": len(lat),

                "p50_ms": round(pct(lat, 50), 2), "p95_ms": round(pct(lat, 95), 2),

                "p99_ms": round(pct(lat, 99), 2), "mean_ms": round(statistics.mean(lat), 2),

                "max_ms": round(max(lat), 2), "load_s": round(load_s, 1),

            }

            rows.append(row)

            print(f"  p50 {row['p50_ms']} ms | p95 {row['p95_ms']} ms | p99 {row['p99_ms']} ms")

            if not args.keep:

                db.collections.delete(name)


    hw_after = hardware()

    out = Path(args.out)

    out.parent.mkdir(parents=True, exist_ok=True)

    with out.open("w", newline="") as f:

        w = csv.DictWriter(f, fieldnames=list(rows[0]) + ["board", "ram_gb", "storage", "temp_end", "throttled_end"])

        w.writeheader()

        for r in rows:

            w.writerow({**r, "board": hw["board"], "ram_gb": hw["ram_gb"], "storage": hw["storage"],

                        "temp_end": hw_after["temp"], "throttled_end": hw_after["throttled"]})

    print(f"\nWrote {out}. End state: temp={hw_after['temp']}, throttled={hw_after['throttled']}")


if name == "__main__":

    main()
Lancez le programme, puis tracez le graphique :
uv run benchmark.py                          # licensed: 1K / 10K / 100K

uv run benchmark.py --sizes 1000 2000 4000   # Community edition

uv run plot_benchmark.py                     # writes results/benchmark.png
Résultat
| Vecteurs | p50 (ms) | p. 95 (ms) | p. 99 (ms) | Temps de chargement |
| 1,000 | 2 | 1.97 | 2.01 | 0.4 s |
| 10,000 | 3 | 3.12 | 3.47 | 28.7 s |
| 100,000 | 4 | 4.75 | 4.98 | 526 s (8,8 min) |
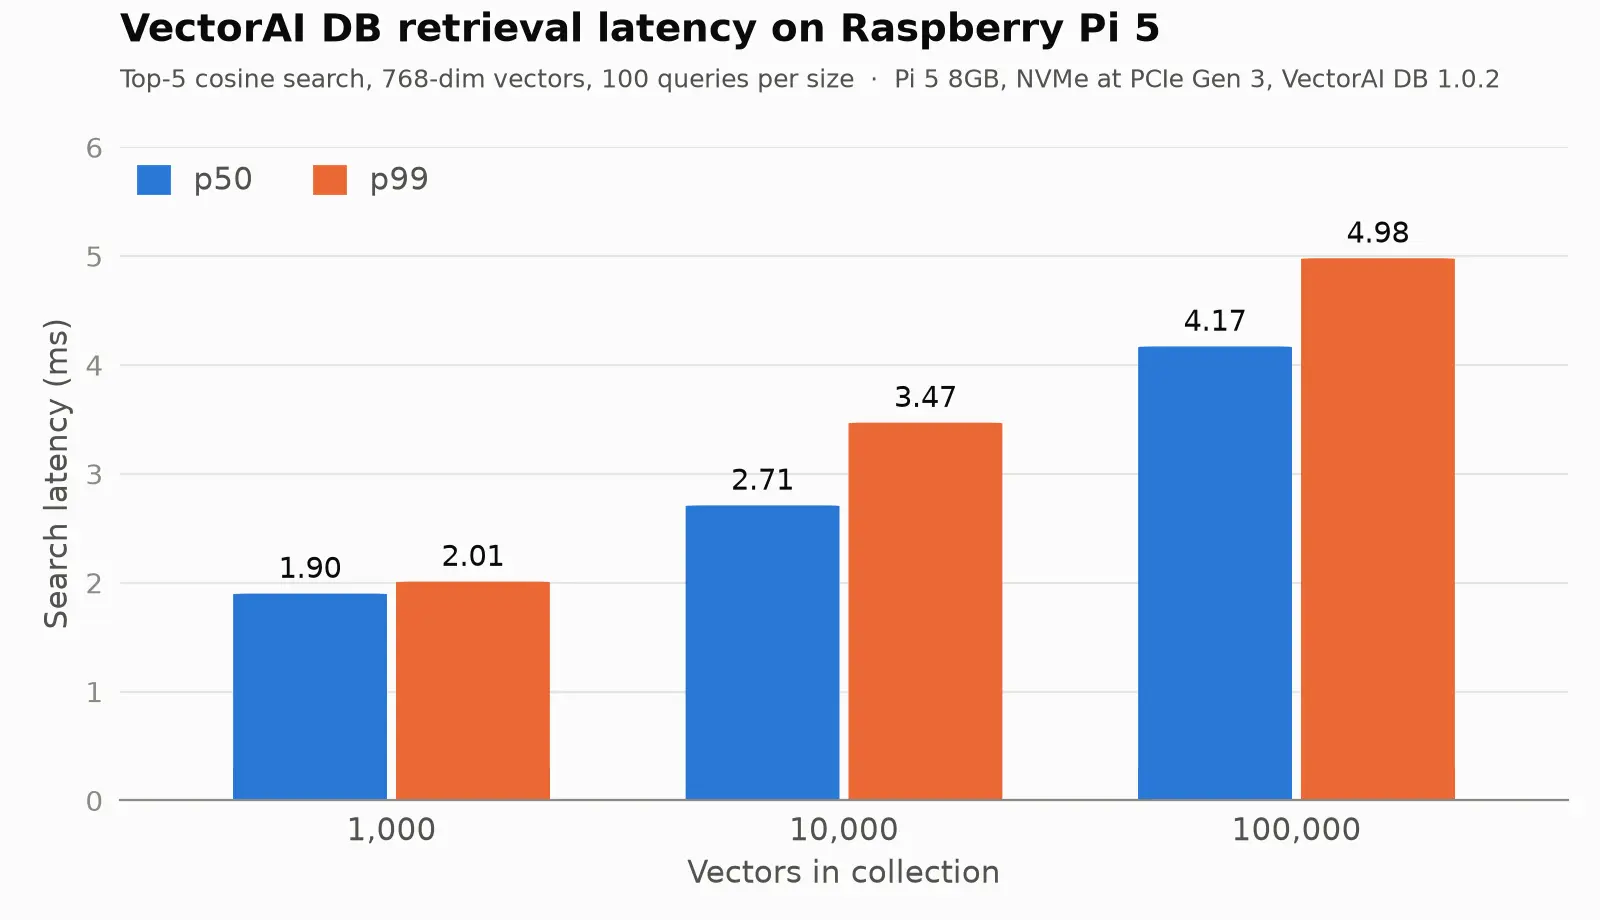
Latence des protéines p50 et p99 en fonction de la taille du corpus (results/benchmark.png)
Téléchargez VectorAI DB Community Edition et effectuez le même test de performance sur votre propre carte.
Un corpus 100 fois plus volumineux a fait passer la latence p50 de 1,90 à 4,17 ms, soit une multiplication par 2,2, tandis que la latence p99 est restée inférieure à 5 ms. Ces chiffres proviennent d’une carte équipée de PCIe Gen 3 (activé dans la section « Sur NVMe » ci-dessus). Le test de performance n’a pas été effectué en Gen 2, où les temps de chargement, en particulier, pourraient être plus longs. Le chargement de 100 000 vecteurs a pris 526 secondes, soit environ 190 vecteurs par seconde, ce qui correspond à un coût ponctuel ; l’agent ajoute une mémoire à la fois en 6 ms. La température du SoC est passée de 46,6 °C à 68,6 °C au cours de l’exécution, et vcgencmd get_throttled signalé 0x0 avant et après.
Pour votre agent, la récupération des données ne constitue pas le goulot d'étranglement. Dans la démo d'introduction, la recherche a pris 1,8 ms, l'encodage 83 ms et l'inférence 3,6 secondes. La quasi-totalité du temps d'attente est due au modèle linguistique.
Quand on atteint les limites du Pi
Un Pi 5 gère sans problème un agent équipé d'un modèle de 1,5 milliard de paramètres. Au-delà, il vaut mieux effectuer l'inférence en dehors de la carte.
Ce que le Pi gère mal :
- Configurations à plusieurs agents. Lorsque deux agents partagent une même instance de Qwen, ils fonctionnent à tour de rôle, ce qui fait que le temps de réponse double approximativement.
- Modèles plus volumineux. Un modèle 7B avec une quantification à 4 bits nécessite environ 4,5 Go rien que pour les poids, soit plus que la limite de 4 Go imposée par Ollama.
- Tâches de vision. Les modèles multimodaux sont plus volumineux et plus lents ; ils sont trop lents sur une processeur Raspberry Pi pour permettre une boucle interactive.
Compromis à prendre en compte avant de vous lancer dans le développement :
- Le SDK d'Python utilise le protocole gRPC. Le code de l'agent passe par le SDK officiel Python ou JavaScript sur le port 6574. L'API REST sur le port 6573 gère la configuration et la gestion des licences.
- La limite de 2 Go est inférieure aux recommandations générales d’Actian. Le guide d’installation indique 8 Go de RAM pour une installation type déploiement. Sur le Raspberry Pi utilisé pour les tests, le conteneur est resté bien en deçà de cette limite avec des corpus de petite taille ; la consommation pour 100 000 vecteurs n’a pas été mesurée.
- L'édition « Community » limite le nombre de collections à moins de 5 000 vecteurs. Chaque message envoyé ajoute un vecteur à ce total ; un agent très sollicité atteint donc cette limite en quelques semaines. La version d'essai de 30 jours supprime cette restriction.
- Les questions sont également conservées. L'agent enregistre chaque message, y compris les questions. Au fil des mois, une question antérieure peut prendre le pas sur l'information dont vous avez besoin pour l'un des trois emplacements de récupération. Pour un agent à longue durée de vie, ne stockez que les déclarations, ou marquez les messages et filtrez-les lors de la récupération.
Quand passer au Jetson Orin ? Pour les déploiements en production impliquant plusieurs caméras, des modèles de plus de 7 milliards de paramètres ou plusieurs agents fonctionnant simultanément, le Jetson Orin offre un GPU supplémentaire et davantage de mémoire, tout en conservant un encombrement similaire en périphérie. VectorAI DB s'exécute sur cette plateforme avec la même image arm64 et la même API, ce qui vous évite de modifier le code de votre agent.
Utilisez le Pi comme nœud de récupération. Utilisez le Pi comme nœud de récupération. Conservez la base de données VectorAI sur le Pi et transmettez les appels au modèle à une machine plus puissante de votre réseau en modifiant une constante dans agent.py:
OLLAMA = "http://192.168.1.50:11434" # inference box on your LANCela permet de transférer à la fois l'intégration et l'inférence sur cette machine. Sur celle-ci, lancez Ollama avec OLLAMA_HOST=0.0.0.0 Il accepte donc les connexions provenant du Pi et y récupère les deux modèles. Le stockage et la consultation s'effectuent sur l'appareil situé à proximité de vos capteurs, et aucune donnée ne quitte votre réseau.
Conclusion
L'agent développé dans ce tutoriel offre une fonctionnalité que la plupart des configurations LLM locales ne proposent pas. Lorsqu'il a répondu à la question sur la serre dans la démo d'introduction, les deux informations provenaient d'une session qui s'était terminée et dont la base de données avait été réinitialisée entre les deux exécutions. La recherche a pris 1,8 millisecondes.
Ce résultat est le fruit de trois choix combinés : exécuter les modèles en local afin qu’aucune donnée ne quitte la plateforme, stocker la mémoire sous forme de vecteurs pour que la recherche soit sémantique plutôt que par correspondance exacte, et utiliser VectorAI DB comme couche de mémoire afin que le stockage soit conservé après les redémarrages et s’adapte à 100 000 entrées sans modification du code.
La même image arm64 et la même API fonctionnent aussi bien sur un Jetson Orin que sur un serveur sur site . Votre agent.py ne change pas lorsque vous vous y déplacez. La seule ligne qui change est OLLAMA, si vous souhaitez délocaliser l'inférence du Pi vers une machine plus puissante de votre réseau local. Inscrivez-vous à VectorAI DB Community Edition, lire le Guide d'installation de Docker, et rejoignez le Communauté Actian sur Discord pour découvrir ce que d'autres développent sur du matériel Edge.
FAQ
Un Raspberry Pi 5 peut-il exécuter une version complète d'agents IA . en local ?
Oui. Un Raspberry Pi 5 doté de 8 Go de RAM permet d'exécuter un agent complet sans connexion au cloud. Ollama héberge Qwen 2.5 1,5B sur processeur, nomic-embed-text transforme les messages en vecteurs, et la base de données VectorAI stocke la mémoire à long terme. Sur la carte de test, l’agent a récupéré les souvenirs pertinents en 1,8 ms et a répondu en 3,6 secondes ; Qwen fonctionne à une vitesse de 12,1 tokens par seconde sur cette carte. Utilisez un stockage NVMe, un refroidissement actif et le bloc d’alimentation officiel de 27 W pour maintenir des performances stables sous une charge soutenue.
Quelle base de données vectorielles fonctionne le mieux sur un Raspberry Pi ?
Pour cette configuration, la base de données Actian VectorAI est particulièrement adaptée. Elle prend en charge l’architecture arm64, stocke les données sur disque et utilise l’algorithme HNSW pour la recherche approximative du plus proche voisin. Sur le Raspberry Pi 5, elle a renvoyé les cinq premiers résultats parmi 100 000 vecteurs en 4,12 ms au p50, avec une limite de mémoire de 2 Go. Sa persistance locale permet également à la mémoire de l’agent de subsister après les redémarrages de la base de données.
VectorAI DB est-il pris en charge sur le matériel ARM ?
Oui. Le site officiel actian/vectorai L'image Docker est disponible à la fois pour amd64 et arm64, donc docker pull actian/vectorai:1.0.2 permet d'obtenir une version native sur un Pi 5, un NVIDIA Jetson ou un Mac équipé d'Apple Silicon, sans aucune émulation. Les SDK et API Python et JavaScript sont identiques sur toutes les plateformes ; ainsi, le code que vous écrivez sur un ordinateur portable s'exécute tel quel sur du matériel en périphérie.
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
