

Comment nous avons procédé à la résolution d'entités à l'aide d'une base de données vectorielle et d'Argon


Points clés à retenir
- VectorAI DB limite chaque enregistrement à ses 10 voisins les plus proches, réduisant ainsi le nombre de combinaisons possibles pour « Abt-Buy » de 1 180 452 à 10 810, tout en conservant 99 % des correspondances exactes.
- Un seuil de similarité permet de trier les paires incontestables, et Gemini 4 Argon n'examine que la tranche incertaine de 13,2 %, en rendant une décision de correspondance accompagnée d'une justification en une phrase.
- Ce pipeline fait passer le F1 de 0,813 à 0,915 et la précision à 0,998 sur le jeu de données Abt-Buy, pour un coût d'environ 0,76 dollar aux 1 000 enregistrements.
- Le traitement Argon s'avère payant lorsque la bande couvre la plupart des erreurs du seuil et qu'Argon offre une précision supérieure d'au moins 10 points environ sur ces paires.
- VectorAI DB et le modèle d'embedding fonctionnent sur votre propre infrastructure ; ainsi, seule la bande d'incertitude quitte votre réseau.
Quelque part dans votre table de clients, de fournisseurs ou de produits, un même élément apparaît deux fois. Dans le benchmark Abt-Buy, un catalogue désigne un téléviseur sous le nom de « Sharp AQUOS 37′ Black LCD HDTV – LC37D64U », tandis qu’un autre l’appelle « Sharp AQUOS LC-37D64U 37′ LCD TV ». L’identification de telles paires relève de la résolution d’entités, et la tâche devient très vite complexe. Vérifier chaque « enregistrement » par rapport à toutes les autres implique environ 500 milliards de comparaisons pour un million de lignes. Les scores de similarité échouent également dans les cas limites. Le même catalogue vend un modèle LC37D44U : une seule lettre de différence, mais un téléviseur différent, et notre modèle d’embedding lui a attribué un score plus élevé que celui du modèle correct.

Nous avons donc réparti le travail. VectorAI DB réduit chaque enregistrement à ses 10 voisins les plus proches, ce qui a permis de réduire le nombre de paires possibles pour « Abt-Buy » de 1 180 452 à 10 810, tout en conservant 99 % des correspondances réelles. Un seuil de similarité permet de trancher les cas évidents. Les 13,2 % de cas incertains sont transmis à Gemini 4 Argon, un modèle Google Gemini qui lit les deux enregistrements et renvoie une correspondance ou une non-correspondance accompagnée d’une justification en une phrase. Nous l’avons choisi pour cette expérience car il renvoie du JSON conforme à un schéma, permet de limiter la complexité de son raisonnement et est capable de lire la référence que l’embedding rend illisible.
Le seuil seul a atteint un score F1 de 0,813 (le F1 concilie précision et rappel). Avec Argon appliqué aux paires incertaines, le F1 est passé à 0,915 et la précision à 0,998, pour un coût de 0,76 $ par 1 000 enregistrements dans le jeu de test. Dans cet article, vous allez construire ce pipeline étape par étape. Vous apprendrez à filtrer les enregistrements à l’aide d’une recherche du plus proche voisin filtrée dans VectorAI DB et à choisir la valeur de K en fonction du taux de réduction et du degré de complétude des paires. Vous définirez également la plage de seuil à partir de vos propres données et testerez si l’utilisation d’Argon est rentable avant d’y consacrer des ressources financières.
TL;DR
- Filtrage : VectorAI DB a conservé 10 810 des 1 180 452 paires Abt-Buy possibles, en éliminant 99,08 % d'entre elles, et a conservé 99,0 % des correspondances réelles.
- Seuils uniquement : F1 0,813.
- Avec l'argon sur la bande d'incertitude : F1 0,915, précision 0,998.
- Envoyé à Argon : 13,2 % des paires de candidats, soit 1 001 sur 7 570 dans le jeu de données de test.
- Coût : 1,41 $ selon les tarifs d’OpenRouter, soit 0,76 $ pour 1 000 enregistrements dans le lot de test (757 enregistrements « Abt » plus l’ensemble des 1 092 enregistrements « Buy »).
- Quand cela vaut le coup : Lorsque la bande couvre la plupart des erreurs du seuil et qu’Argon détermine les paires de bandes nettement mieux que le seuil. Dans nos tests de largeur de bande, la tranche où Argon devançait le seuil de 12 points a rapporté 1,5 point F1 ; les tranches où il ne devançait que d’environ 1 point n’ont pratiquement rien rapporté.
Conditions préalables
- Docker avec le plugin Compose.
- uv, le gestionnaire de paquets d'Python , qui installe pour vous une version compatible d'Python . La commande d'installation se trouve sous cette liste.
- Ollama, pour exécuter le modèle d'intégration en local.
- Une clé Argon pour Gemini 4: une clé OpenRouter disposant d'un crédit de quelques dollars, ou une clé Google AI Studio ou Google Cloud avec la facturation activée. Argon ne propose pas de forfait gratuit ; l'exécution de la commande Abt-Buy a coûté 1,41 $.
- VectorAI DB, sans installation distincte : l'étape 1 lance l'édition Community dans Docker. Chaque test de performance respecte la limite de 5 000 vecteurs, un à la fois.
- Environ 3 Go d'espace disque libre pour l'image de la base de données et le modèle intégré. Tout fonctionne sur un processeur processeur; aucun GPU n'est nécessaire.
Installez uv si vous ne l'avez pas encore
# macOS or Linux
curl -LsSf https://astral.sh/uv/install.sh | sh

# Windows (PowerShell)
irm https://astral.sh/uv/install.ps1 | iex
Tout le code se trouve dans le dépôt associé, et l'étape 1 permet de le cloner. Vous êtes pressé ? Suivez les étapes 1 à 3, puis passez directement à l'étape 8.
Ce que vous construisez
La résolution d'entités, également appelée « liaison d'enregistrement s » ou « mise en correspondance d'entités », se déroule en trois étapes. Le filtrage permet de réduire le nombre de paires à un ensemble de candidats. La comparaison attribue un score à chaque candidat, souvent à l'aide d'une correspondance approximative des noms et des champs. La mise en correspondance permet de prendre la décision finale. Cette version fournit un outil dédié à chaque étape :
- VectorAI DB se charge du filtrage. Pour chaque enregistrement, il renvoie les voisins les plus proches issus de l’autre table — c’est-à-dire les enregistrements dont les représentations sont les plus proches —, ce qui permet au pipeline d’évaluer 10 candidats par enregistrement au lieu de toutes les paires possibles.
- EmbeddingGemma, exécutée localement via Ollama, transforme chaque enregistrement en un vecteur de 768 dimensions.
- Un seuil de similarité permet de faire correspondre automatiquement les paires fiables et de rejeter les cas manifestement non correspondants.
- Gemini 4 Argon détermine la fourchette d'incertitude intermédiaire et donne une justification en une phrase.
resolve.pyles met en correspondance et évalue les résultats par rapport aux correspondances connues de la base de référence.
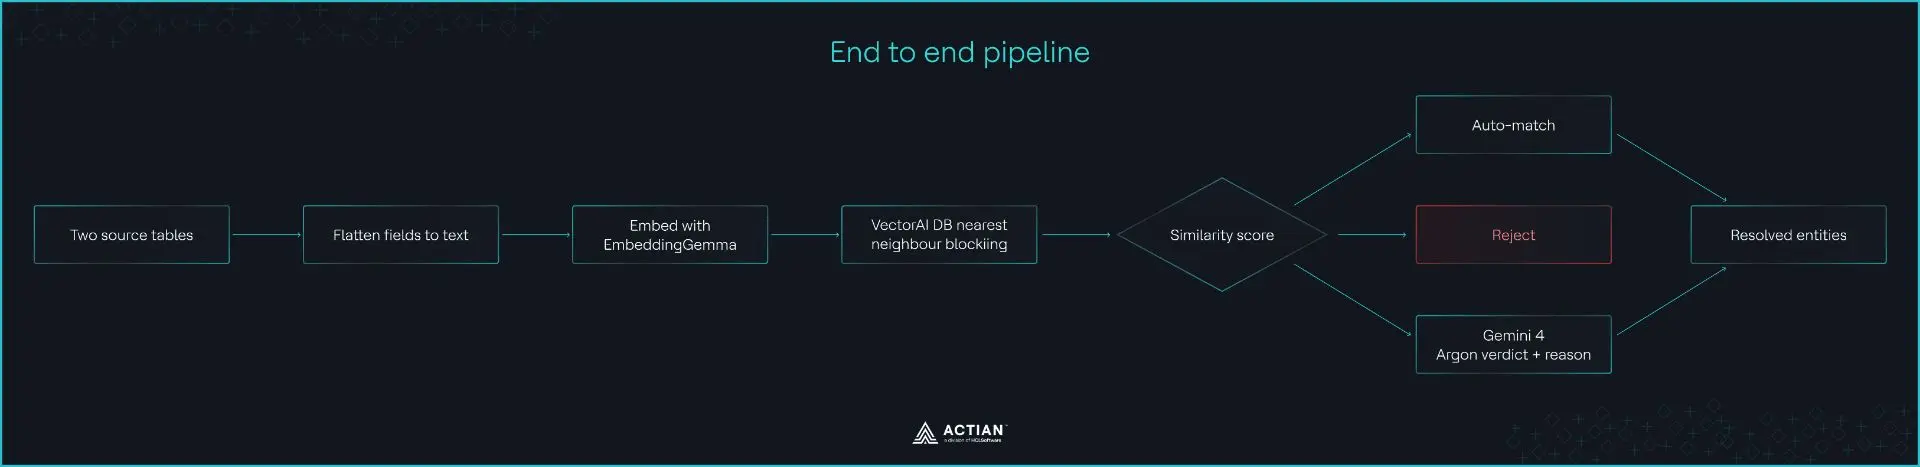
Le pipeline. Les enregistrements sont Embarqué et stockés dans la base de données VectorAI, et le score de similarité oriente chaque paire de candidats vers une mise en correspondance automatique, un rejet ou Argon.
Les exemples utilisent Abt-Buy, un ensemble de référence standard pour la mise en correspondance de données issu de la collection de Leipzig: 1 081 produits Abt et 1 092 produits Buy, avec un fichier de référence répertoriant les 1 097 correspondances exactes. Comparer chaque produit Abt enregistrement à chaque produit Buy enregistrement reviendrait à 1 081 × 1 092 = 1 180 452 paires.
Étape 1 : Démarrer VectorAI DB
Clonez le dépôt associé et accédez au dossier du projet. Toutes les commandes qui suivront s'exécuteront dans ce dossier :
git clone https://github.com/actian-devs/developer-content.git
cd developer-content/blog/entity-resolution-vectorai
Le fichier `docker-compose.yml` du dépôt lance VectorAI DB. La ligne `ACTIAN_VECTORAI_ACCEPT_EULA=YES` accepte la licence d'Actian en votre nom ; veillez donc à la lire avant de démarrer le conteneur :
services:
  vectorai:
    image: actian/vectorai:1.0.2
    container_name: vectorai
    ports:
      - "6573:6573" # REST
      - "6574:6574" # gRPC (Python SDK)
      - "6575:6575" # Local UI
    volumes:
      - ./vectorai_data:/var/lib/actian-vectorai
    environment:
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    restart: unless-stopped
C'est parti :
docker compose up -d
docker ps
Le conteneur devrait s'afficher. Le SDK d'Python communique avec lui via gRPC sur port 6574.
La limite de5 000 vecteurs de l'édition Communitys'applique à l'ensemble du serveur, et les vecteurs supprimés continuaient à être pris en compte dans ce décompte jusqu'à ce que nous redémarrions le conteneur. Le harnais supprime ses propres anciennes collections ; s'il signale toujours que la limite est atteinte, exécutez la commande `docker compose restart vectorai`.
Étape 2 : Extraire le modèle d'intégration
Installez Ollama, puis téléchargez EmbeddingGemma, qui pèse environ 620 Mo :
ollama pull embeddinggemmaOllama le sert sur localhost:11434, et le harnais l'appelle à cet endroit. À ce stade, aucune donnée ne quitte votre machine.
Étape 3 : Installation des dépendances d'Python
Le dépôt contient déjà le fichier pyproject.toml, présenté ci-dessous à titre de référence. Son fichier uv.lock fixe les versions exactes que nous avons utilisées, telles que actian-vectorai-client 1.0.3 et google-GénAI 2.31.0 :
[project]
name = "entity-resolution-vectorai"
version = "0.1.0"
description = "Entity resolution with VectorAI DB blocking and Gemini 4 Argon on the ambiguous band"
requires-python = ">=3.11,<3.14"
# uv run resolve.py reads this, creates .venv and installs these on first run
dependencies = [
    "actian-vectorai-client",  # VectorAI DB client (gRPC)
    "google-genai",            # Gemini API, for the Argon pass
    "pandas",
    "numpy",
    "pydantic",                # Argon's structured-output schema
    "requests",                # benchmark download
    "matplotlib",              # score-distribution chart
]

[project.optional-dependencies]
st = ["sentence-transformers"]   # in-process embedding models: uv sync --extra st, then --embed-backend sentence-transformers
Mettre en place l'environnement :
uv syncÀ partir de maintenant, commencez chaque commande par « uv run » ; vous n'avez pas besoin d'activer un environnement.
Étape 4 : Charger et « Embarquer r » les enregistrements
La table source est intégrée à la charge utile de chaque point, car l’étape 5 effectue un filtrage sur celle-ci ; ainsi, un enregistrement « Abt » enregistrement n’est jamais comparé qu’à des enregistrements « Buy ». L’intégration est l’étape la plus lente d’un processeur : le harnais met les vecteurs en cache, et les nouvelles exécutions l’ignorent. Le code ci-dessous constitue le cœur de trois fonctions du dépôt. load() dans er/data.py crée des enregistrements, une liste de tuples (source, enregistrement_id, texte) dans laquelle les enregistrements Abt apparaissent en premier embed() se trouve dans er/embed.pyet l'opération « upsert » est load_records() dans er/block.py.
import numpy as np
import requests
from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams

def to_text(row, fields):
    # "name: Sony Bravia 40in LCD TV | price: $899.99" (empty fields are skipped)
    return " | ".join(f"{f}: {row[f].strip()}" for f in fields if row[f].strip())

def embed(texts, model="embeddinggemma", url="http://localhost:11434", batch=64):
    out = []
    for i in range(0, len(texts), batch):
        r = requests.post(f"{url}/api/embed", json={"model": model, "input": texts[i:i + batch]}, timeout=600)
        r.raise_for_status()
        out.extend(r.json()["embeddings"])
    v = np.asarray(out, dtype=np.float32)
    return v / np.linalg.norm(v, axis=1, keepdims=True)   # unit length, so cosine score = dot product

vectors = embed([text for , , text in records])          # records: (source, record_id, text)

with VectorAIClient("localhost:6574") as db:
    if db.collections.exists("er_abt_buy"):   # start clean, so the step can be rerun
        db.collections.delete("er_abt_buy")
    db.collections.create("er_abt_buy", vectors_config=VectorParams(
        size=vectors.shape[1], distance=Distance.Cosine))
    points = [PointStruct(id=i, vector=v.tolist(), payload={"source": src, "record_id": rid, "text": t})
              for i, ((src, rid, t), v) in enumerate(zip(records, vectors))]
    for start in range(0, len(points), 500):   # upsert in batches
        db.points.upsert("er_abt_buy", points[start:start + 500])
Étape 5 : Créer un bloc avec VectorAI DB
L'requête de blocage s'exécute une fois par Abt enregistrement et demande ses K enregistrements Buy les plus proches, avec un filtre obligatoire sur le champ « source » dans la charge utile de chaque point. Ici, la règle veut qu'une correspondance relie toujours un Abt enregistrement à un Buy enregistrement; la recherche ne doit donc renvoyer que les enregistrements provenant de l'autre source. Le blocage sur des embeddings pré-entraînés de ce type a fait l'objet d'études à grande échelle : Zeakis et al. a évalué 12 modèles linguistiques sur 17 tests de référence en résolution d'entités, notamment en analysant la qualité de leurs représentations. Le code reprend à partir de l'étape 4 et constitue le cœur de neighbours() dans er/block.py.
from actian_vectorai import Field, FilterBuilder, VectorAIClient

K = 10
TOTAL_RECORDS = len(records)   # Abt + Buy: a limit this high returns every Buy record
abt_ids = [rid for src, rid,  in records if src == "abt"]
abtvectors = vectors[:len(abt_ids)]   # records lists every Abt record first
other_source = FilterBuilder().must(Field("source").eq("buy")).build()

def search(db, vectors, limit):
    out = []
    for i in range(0, len(vectors), 100):   # search_batch takes up to 100 queries per call
        out += db.points.search_batch("er_abt_buy", [
            {"vector": v.tolist(), "limit": limit, "filter": other_source, "with_payload": True}
            for v in vectors[i:i + 100]])
    return out

ranked, todo, limit = {}, list(range(len(abt_ids))), K  10   # over-fetch, then keep the top K
with VectorAIClient("localhost:6574") as db:
    while todo:
        short = []
        for i, hits in zip(todo, search(db, abt_vectors[todo], limit)):
            ranked[abt_ids[i]] = sorted(((h.payload["record_id"], h.score) for h in hits),
                                        key=lambda x: -x[1])[:K]
            if len(hits) < K and limit < TOTAL_RECORDS:   # stop once the limit covers the table
                short.append(i)
        todo, limit = short, min(limit  4, TOTAL_RECORDS)   # retry any record still short
Surcharge lors du filtrage. Nous avons mesuré ce phénomène sur VectorAI DB 1.0.2 avec le client Python 1.0.3 et l'ensemble des 2 173 enregistrements Abt-Buy regroupés dans une seule collection. Un appel search_batch avec limit=10 et le filtre source = buy a renvoyé un nombre insuffisant de résultats pour 1 075 des 1 081 enregistrements Abt, avec une moyenne de 3,9 résultats. Une recherche non filtrée portant sur les 10 voisins les plus proches a renvoyé des enregistrements Abt dans 75,5 % des cas. Les résultats filtrés correspondaient donc aux enregistrements « Buy » figurant parmi les enregistrements globalement les plus proches (à peu près dans la limite fixée), et non aux 10 enregistrements « Buy » les plus proches. Le guide des filtres de prédicats de VectorAI DB indique que les filtres s’appliquent pendant la recherche ; il convient donc de considérer ce comportement comme celui observé avec la version 1.0.2 sur notre collection, et non comme un comportement documenté.
Élevage hnsw_ef, le fait de porter l’étendue de recherche de l’index HNSW à 256 n’a rien changé. La création d’un index de données utiles sur la source n’était pas envisageable : la version 1.0.2 refuse d’en ajouter un à une collection existante (« la création dynamique d’index n’est pas encore implémentée »), et le client Python de la version 1.0.3 ne dispose d’aucun paramètre permettant d’en déclarer un lors de la création de la collection. Demander 10 × K tout en conservant le top K fixe a résolu le problème : chaque enregistrement a obtenu ses 10 candidats, et 99,95 % d’entre eux correspondent à une recherche par force brute exacte.
En ce qui concerne les données clients ou fournisseurs, la clause « same must » peut définir des règles qui excluent complètement une paire, comme un pays différent ou une personne par opposition à une entreprise. Les clauses « should » peuvent privilégier les candidats partageant un champ, tel qu’un code postal, sans pour autant exclure les autres. Budget pour le même « over-fetch » : dans la version 1.0.2, plus un filtre exclut d’enregistrements, moins il laisse passer d’enregistrements proches ; il faut donc augmenter la limite jusqu’à ce que chaque enregistrement reçoive son K.
Lisez simultanément le rapport de réduction et le degré d'exhaustivité des paires
Deux chiffres permettent de caractériser le blocage, mais pris isolément, chacun d'entre eux peut induire en erreur :
- Taux de réduction correspond à la proportion de toutes les paires supprimées par le blocage : 1 − candidats / toutes les paires.
- Exhaustivité des paires est la proportion de correspondances réelles qui ont survécu au filtrage : correspondances réelles parmi les candidats / toutes les correspondances réelles.
import pandas as pd

candidates = {(abt_id, buy_id): score for abt_id, hits in ranked.items() for buy_id, score in hits}
n_buy = len(records) - len(abt_ids)
gold = set(map(tuple, pd.read_csv("data/abt-buy/abt_buy_perfectMapping.csv").astype(str).values))
rr = 1 - len(candidates) / (len(abt_ids) * n_buy)
pc = len(gold & candidates.keys()) / len(gold)
Le harnais effectue les calculs à la fois en blocking_quality() dans er/block.py. Chaque correspondance exacte perdue à cause d'un blocage est définitivement perdue ; ainsi, la complétude des paires limite la récupération pour l'ensemble du pipeline. Nous avons balayé K :
| K | Paires de candidats | Rapport de réduction | Exhaustivité des paires |
|---|---|---|---|
| 1 | 1,081 | 99.91% | 81.9% |
| 3 | 3,243 | 99.73% | 94.5% |
| 5 | 5,405 | 99.54% | 97.0% |
| 10 | 10,810 | 99.08% | 99.0% |
| 20 | 21,620 | 98.17% | 99.7% |
Nous avons conservé K = 10. Cela a permis d'éliminer 99,08 % de l'espace de comparaison tout en conservant 99,0 % des correspondances réelles. Passer à K = 20 ajoute 0,7 point d'exhaustivité des paires pour un nombre de candidats deux fois plus élevé. Considérez ces deux chiffres comme un compromis avant de vous fier à l'un ou à l'autre : chaque paire écartée représente une comparaison évitée et, potentiellement, une correspondance perdue à jamais. Choisissez la plus petite valeur de K pour laquelle l’exhaustivité des paires vous convient, car ce chiffre correspond au plafond de rappel pour toutes les étapes suivantes.
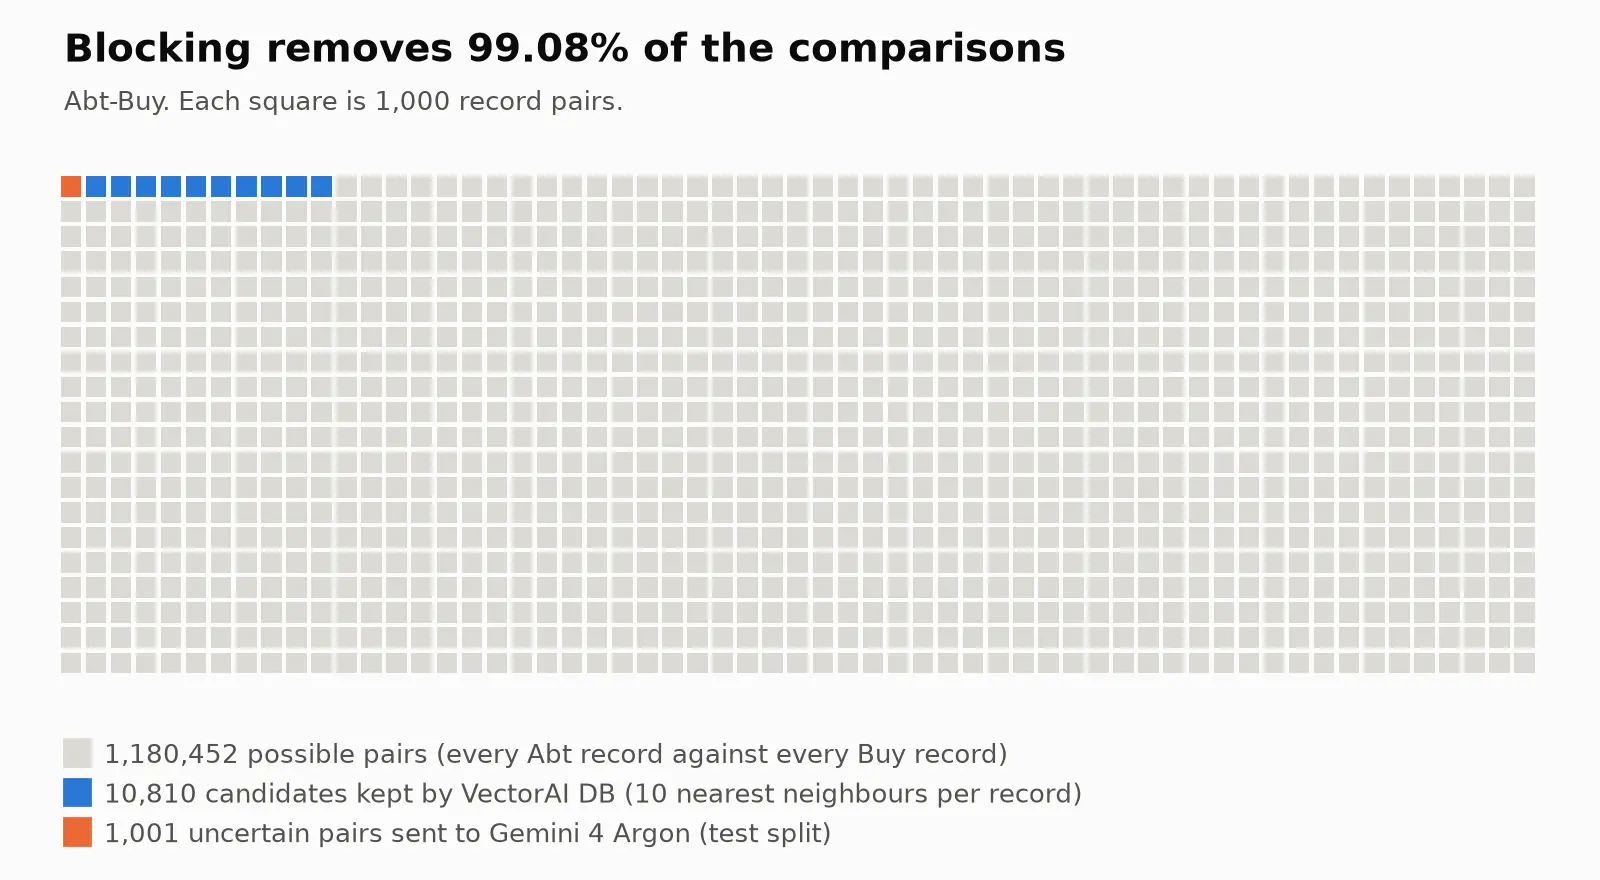
L'espace de comparaison sur Abt-Buy : un carré pour 1 000 paires. La base de données VectorAI a conservé 10 810 des 1 180 452 paires possibles, et Argon en a lu 1 001.
Étape 6 : Noter les candidats et définir la fourchette de notes
Un seuil unique conduit à des erreurs dans l’identification des paires proches dans les deux sens ; c’est pourquoi le pipeline divise les candidats en trois tranches et ne transmet qu’à celle du milieu à Argon. La méthode de référence utilise un seuil de « meilleure correspondance » : chaque candidat le plus proche d’un « Abt enregistrement» est considéré comme une correspondance si sa similarité dépasse un seuil donné. La précision correspond à la proportion de correspondances prédites qui sont réelles, le rappel à la proportion de correspondances réelles trouvées, et le F1 établit un équilibre entre les deux. Sur le split de test Abt-Buy, le seuil optimal était de 0,562 : précision de 0,820, rappel de 0,806, F1 de 0,813. Un seuil global appliqué aux 10 candidats par enregistrement n’a obtenu qu’un score de 0,522.

Similitude de chaque candidat « Buy » le plus proche pour chaque Abt enregistrementsur le split de test. Les 136 fausses correspondances se situent toutes dans la fourchette comprise entre 0,56 et 0,84, mélangées aux vraies correspondances ; il n’existe donc pas de seuil unique permettant de les distinguer.
Sélectionnez les limites de bande à partir des données
Nous avons réservé 30 % des enregistrements Abt pour le partage de données de développement, défini le seuil et les deux limites de la distribution des scores, puis nous avons rapporté tous les résultats obtenus sur les 70 % restants. Le code ci-dessous provient de er/bands.py, qui contient également les fonctions auxiliaires qu’il utilise : info associe chaque candidat à son rang et à son écart (rank_and_gap()), dev_best conserve le candidat le plus proche de chaque enregistrementde développement (best_match()), et best_cutoff correspond au seuil de la méthode de base (best_threshold()). Les arêtes fonctionnent comme suit :
- Limite supérieure : Le score le plus bas au-delà duquel les correspondances optimales atteignent une précision de 95 % sur le jeu de données de développement. Les correspondances optimales situées au-dessus de ce seuil sont automatiquement associées.
- Limite inférieure : Le score le plus élevé en dessous duquel se situent au maximum 5 % des correspondances réelles, plafonné au seuil de la référence afin que le pipeline ne rejette jamais une paire que la référence accepterait. Les paires situées en dessous de ce seuil sont rejetées.
- Équivalences : Un candidat classé deuxième ou troisième dont le score se situe à moins de 0,03 de celui du meilleur candidat de son « enregistrement» est également inclus dans la fourchette. À eux seuls, les candidats les plus proches limitent le taux de rappel à 82 %, car 18 % des correspondances réelles ne correspondent pas au meilleur candidat de leur « enregistrement».
import numpy as np

def band_edges(cand, gold, target_precision, max_miss):
    pairs = sorted(cand.items(), key=lambda kv: kv[1], reverse=True)
    s = np.array([score for , score in pairs])
    y = np.array([p in gold for p,  in pairs], dtype=float)
    precision_above = np.cumsum(y) / np.arange(1, len(y) + 1)
    ok = np.where(precision_above >= target_precision)[0]
    upper = s[ok.max()] if len(ok) else s[0] + 1e-9   # nothing reaches the target: auto-match nothing
    missed_below = (y.sum() - np.cumsum(y)) / y.sum()   # share of matches scoring below each position
    lower = s[np.where(missed_below <= max_miss)[0].min()]
    return float(min(lower, upper)), float(upper)

def near_tie_band(cand, info, lower, upper, max_rank=3, max_gap=0.03):
    band = []
    for pair, score in cand.items():
        rank, gap = info[pair]   # rank among the record's candidates, distance below its best
        if score < lower:
            continue
        if (rank == 1 and score < upper) or (2 <= rank <= max_rank and gap <= max_gap):
            band.append(pair)
    return band

lower, upper = band_edges(dev_best, dev_gold, target_precision=0.95, max_miss=0.05)
lower = min(lower, best_cutoff)   # never reject a pair the baseline accepts
band = near_tie_band(test_candidates, info, lower, upper)
Les limites se sont établies à 0,562 et 0,841. La bande a retenu 1 001 des 7 570 candidats testés, soit 13,2 %, et 206 des 279 erreurs de la référence se trouvaient à l’intérieur de celle-ci. Si Argon classait correctement chaque paire de fourchettes, le taux de rappel pourrait passer de 0,806 à 0,897. Mesurez cette proportion sur vos propres données avant toute autre chose : un seuil unique force toutes les paires proches à se situer d’un seul côté, et seules les erreurs qui se trouvent dans la fourchette peuvent être transmises à un deuxième passage. Si la plupart d’entre elles se situent ailleurs, aucun deuxième passage ne permettra de les corriger.
En quoi le seuil est erroné
Ces paires proviennent de la bande. Leurs vecteurs sont proches, et la bonne réponse dépend d'un détail que l'intégration rend flou. Le tableau ne présente que les noms des produits. Le harnais intègre, puis envoie à Argon, tous les champs de chaque « enregistrement » : nom, description et prix pour «Abt», et nom, description, fabricant et prix pour «Buy».
| enregistrement A (Abt) | enregistrement B (Acheter) | Score | La vérité | Selon Baseline, |
|---|---|---|---|---|
| Téléviseur HD LCD Sharp AQUOS 37′ noir – LC37D64U | Téléviseur LCD Sharp AQUOS LC37D44U 37′ – LC37D44U | 0.832 | Aucun résultat | Match |
| Téléviseur HD LCD Sharp AQUOS 37′ noir – LC37D64U | Téléviseur LCD Sharp AQUOS LC-37D64U 37′ | 0.814 | Match | Aucune correspondance (2e candidat) |
| Support mural pour enceinte Omnimount – 20WLBK | Support d'enceinte OmniMount en acier inoxydable – 20.0 WALL-W | 0.830 | Aucun résultat | Match |
| Support mural pour enceinte Omnimount – 20WLBK | Kit de fixation murale universel pour enceintes OmniMount – 20.0 WALL-B | 0.829 | Match | Aucune correspondance (2e candidat) |
| Support à ventouse réglable pour véhicule Garmin – 0101082303 | Support à ventouse Garmin pour véhicule | 0.832 | Aucun résultat | Match |
Le bon modèle, le enregistrement , est souvent le deuxième candidat, juste en dessous d’un modèle erroné presque identique : le Sharp LC-37D64U, qui est le bon, obtient un score inférieur de 0,018 à celui du LC37D44U. Les deux modèles dépassent largement tout seuil de sélection. Le numéro de modèle constitue la différence la plus évidente, et les descriptions en ajoutent d’autres, comme un rapport de contraste de 10 000:1 contre 7 500:1. Voici la première paire telle que la perçoivent le modèle d’intégration et Argon :
Record A (Abt): name: Sharp AQUOS 37' Black LCD HDTV - LC37D64U | description: Sharp AQUOS 37' Black LCD HDTV - LC37D64U/ 1920 x 1080p Pixel Resolution/ Up To 60,000 Hours Lamp Life/ Built-In ATSC/QAM/NTSC Tuner/ 10,000:1 Dynamic Contrast Ratio/ 4ms Response Time/ 4-Wavelength Backlight System/ Black Finish

Record B (Buy): name: Sharp AQUOS LC37D44U 37' LCD TV - LC37D44U | description: Sharp AQUOS LC-37D44U - 37' Widescreen LCD HDTV - 7500:1 Dynamic Contrast Ratio - 6ms Response Time | manufacturer: Sharp
Étape 7 : Envoyer le ruban à Argon
Chaque paire de bandes est envoyée à Argon et revient avec un résultat (« correspond » ou « ne correspond pas ») accompagné d’une justification en une phrase. La réponse est un format structuré, au format JSON conforme à un schéma, ce qui vous évite d’avoir à analyser le contenu manuellement. Un modèle général peut effectuer cette étape sans données d’ apprentissage : Peeters, Steiner et Bizer a montré que les meilleurs modèles de langage de grande envergure (LLM), même sans exemples ou avec très peu d’exemples, atteignent des performances comparables à celles des modèles de langage pré-entraînés puis affinés à partir de milliers de paires étiquetées. La prompt et le schéma ci-dessous sont ceux du dépôt, testés sur le split de développement, et le code correspond au cœur de la classe `Adjudicator` dans le fichier `er/adjudicate.py`. Cet extrait de code appelle directement l’API Gemini avec GEMINI_API_KEY; le harnais peut également être utilisé avec ce même modèle via OpenRouter.
import json
from google import genai
from google.genai import types
from pydantic import BaseModel

class Verdict(BaseModel):
    match: bool
    reason: str   # one sentence, logged for audit

PROMPT = """You are resolving product records from two catalogues.
Decide whether Record A and Record B describe the same product: same model, size, and variant.
Answer from the records only. Give a one-sentence reason.

Record A: {a}
Record B: {b}"""

client = genai.Client()   # reads GEMINI_API_KEY from the environment

def adjudicate(a_text: str, b_text: str) -> tuple[Verdict, int, int]:
    resp = client.models.generate_content(
        model="gemini-4-argon",
        contents=PROMPT.format(a=a_text, b=b_text),
        config=types.GenerateContentConfig(
            response_mime_type="application/json",
            response_schema=Verdict,
            temperature=0,
            thinking_config=types.ThinkingConfig(thinking_level="LOW"),
        ),
    )
    usage = resp.usage_metadata
    # thinking tokens are billed at the output rate, so count them with the visible answer
    out_tokens = (usage.candidates_token_count or 0) + (usage.thoughts_token_count or 0)
    return Verdict.model_validate_json(resp.text), usage.prompt_token_count or 0, out_tokens
Chaque verdict est consigné dans un journal avec sa justification ; ainsi, si une fusion est remise en question ultérieurement, vous pouvez expliquer pourquoi Argon l'a effectuée. La boucle ignore les paires déjà présentes dans le journal, ce qui évite de payer deux fois lors d'une nouvelle exécution ; le harnais ajoute en outre des tentatives supplémentaires en cas de limites de débit :
import os

text_of = {(src, rid): text for src, rid, text in records}

os.makedirs("results", exist_ok=True)
log_path = "results/argon_verdicts.jsonl"
done = set()
if os.path.exists(log_path):   # pairs already paid for on an earlier run
    with open(log_path) as f:
        done = {(r["abt"], r["buy"]) for r in map(json.loads, f)}

tokens_in = tokens_out = 0
with open(log_path, "a") as log:
    for abt_id, buy_id in band:
        if (abt_id, buy_id) in done:
            continue
        verdict, t_in, t_out = adjudicate(text_of["abt", abt_id], text_of["buy", buy_id])
        tokens_in += t_in
        tokens_out += t_out
        log.write(json.dumps({"abt": abt_id, "buy": buy_id, **verdict.model_dump()}) + "\n")
        log.flush()   # a crash mid-run keeps every verdict written so far
Les exécutions mentionnées dans cet article ont été transmises à Argon via OpenRouter, qui achemine les requêtes vers les points de terminaison de Google et indique le coût exact par appel. Le paramètre « Thinking » était réglé sur « LOW », car les jetons « thinking » sont facturés et qu’une décision de correspondance ne nécessite pas de raisonnement approfondi.
Définissez votre clé avant de lancer le harnais, dans l'environnement et jamais dans le code. L'extrait ci-dessus indique : GEMINI_API_KEY Le backend OpenRouter du harnais (–argon-backend openrouter) lit OPENROUTER_API_KEY:
# macOS or Linux
export OPENROUTER_API_KEY="<YOUR_OPENROUTER_API_KEY>"

# Windows (PowerShell)
$env:OPENROUTER_API_KEY="<YOUR_OPENROUTER_API_KEY>"
Le harnais impose également un plafond de dépenses : –budget-usd calcule le coût exact de chaque appel sur l'ensemble des exécutions et s'arrête avant d'atteindre ce plafond.
Ce qu'Argon a décidé
Comme indiqué ci-dessus, le tableau ne présente que les noms ; Argon a consulté les fiches complètes. La rubrique « Achat » de la ligne « Garmin », par exemple, mentionne la référence 010-10723-03 citée par Argon.
| enregistrement A (Abt) | enregistrement B (Acheter) | La vérité | Argon | La raison d'être d'Argon |
|---|---|---|---|---|
| Téléviseur HD LCD Sharp AQUOS 37′ noir – LC37D64U | Téléviseur LCD Sharp AQUOS LC37D44U 37′ – LC37D44U | Aucun résultat | Aucun résultat | Différents modèles Sharp AQUOS de 37 pouces, le LC37D64U et le LC37D44U, qui présentent également des rapports de contraste différents. |
| Téléviseur HD LCD Sharp AQUOS 37′ noir – LC37D64U | Téléviseur LCD Sharp AQUOS LC-37D64U 37′ | Match | Match | Le même téléviseur HD LCD Sharp AQUOS de 37 pouces, portant le même numéro de modèle (LC37D64U / LC-37D64U) et doté d'une résolution de 1920 x 1080. |
| Support mural pour enceinte Omnimount – 20WLBK | Support d'enceinte OmniMount en acier inoxydable – 20.0 WALL-W | Aucun résultat | Aucun résultat | enregistrement A correspond à la version noire (20WLBK, finition noire) ; enregistrement B correspond à une autre version (20.0 WALL-W). |
| Support mural pour enceinte Omnimount – 20WLBK | Kit de fixation murale universel pour enceintes OmniMount – 20.0 WALL-B | Match | Match | Il s'agit du même support en acier inoxydable noir, d'une capacité nominale de 20 livres ; les références 20WLBK et 20.0 WALL-B correspondent au même modèle. |
| Support à ventouse réglable pour véhicule Garmin – 0101082303 | Support à ventouse Garmin pour véhicule | Aucun résultat | Aucun résultat | Références différentes : 0101082303 contre 010-10723-03. |
Argon a correctement identifié 960 paires de groupes sur 1 001, soit 95,9 %, y compris toutes les paires que le seuil avait jugées erronées. Sur ses 41 erreurs, 40 correspondaient à des correspondances réelles qu’il a rejetées, et l’analyse des raisons qu’il a consignées permet de les classer en trois groupes :
- Une enregistrement trop vague pour être vérifiée (19). Buy mentionne « Four à micro-ondes à poser LG de 2,0 cu.ft. », sans préciser de numéro de modèle ni de couleur ; Argon ne considérerait donc pas qu’il s’agit du même produit qu’un modèle spécifique.
- Une différence de variante, de couleur ou de pack (7). Un Canon PowerShot noir par opposition à un modèle argenté, ou une carte SD vendue avec un lecteur de carte par opposition à la carte seule. Le benchmark considère ces cas comme des correspondances ; Argon, non.
- Différentes références (14). Plusieurs d'entre eux semblent être des erreurs d'étiquetage dans le test de performance lui-même, comme le Weber Summit S-650 comparé au S-450 et le Time Capsule 500 Go d'Apple comparé au modèle 1 To.
La 41e erreur allait dans le sens inverse : Argon a comparé un réfrigérateur LG à portes françaises d'une capacité annoncée de 25,0 cu. ft. à un autre d'une capacité annoncée de 24,7 cu. ft., en partant du principe que 24,7 correspondait à la capacité exacte du même modèle, alors que la référence indique qu'ils diffèrent.
Ces raisons montrent que le modèle applique une définition plus stricte de la notion de « même produit » que les étiquettes de référence. Elles indiquent également où se situe la solution. Une instruction plus précise ne peut pas fournir un numéro de modèle qu’ enregistrement e pas, et une plage plus large n’apporte rien aux paires qu’Argon identifie déjà. Pour les 19 paires ambiguës, la solution consiste à disposer d’enregistrements suffisamment détaillés, et pour les 14 paires de numéros de modèle, il s’agit de vérifier les étiquettes.
Étape 8 : Exécuter l'intégralité du pipeline
Le code complet, comprenant le blocage, la sélection des bandes, le « pass » Argon et le calcul des scores par rapport aux « gold labels », se trouve dans le dépôt associé. Les versions suivantes sont épinglées :
| Composant | Version |
|---|---|
| VectorAI DB | actian/vectorai : 1.0.2 |
| Modèle d'intégration | Intégration de Gemma (embeddinggemma) via Ollama |
| Arbitre | gemini-4-argon, exécution le 23 octobre 2026 via OpenRouter, niveau de réflexion FAIBLE |
| jeux de données | Abt-Buy et Amazon-Google, base de données de référence de Leipzig, téléchargée le 19 octobre 2026 |
Exécuter l'intégralité du pipeline sur Abt-Buy :
uv run resolve.py --dataset abt-buy --argon-backend openrouter --workers 2 --budget-usd 10Remplacez « amazon-google » par «jeu de données » pour le deuxième test de performance, ou ajoutez l’option « –no-argon » pour exécuter le blocage et le seuil sans aucun appel d’API.
Le script affiche toutes les métriques présentées dans cet article pour les deux approches, ainsi que la proportion de paires envoyées à Argon et le coût. Voici un extrait des résultats de l'exécution « Abt-Buy » :
abt-buy: 1081 abt + 1092 buy records, 1097 true matches

Blocking (all records, hnsw_ef=256):
  K=1   candidates=  1,081  reduction ratio=0.9991  pair completeness=0.8186  returned/record: mean 1.0, min 1, short 0
  K=3   candidates=  3,243  reduction ratio=0.9973  pair completeness=0.9453  returned/record: mean 3.0, min 3, short 0
  K=5   candidates=  5,405  reduction ratio=0.9954  pair completeness=0.9699  returned/record: mean 5.0, min 5, short 0
  K=10  candidates= 10,810  reduction ratio=0.9908  pair completeness=0.9900  returned/record: mean 10.0, min 10, short 0
  K=20  candidates= 21,620  reduction ratio=0.9817  pair completeness=0.9973  returned/record: mean 20.0, min 20, short 0

Test split: 7,570 candidates, 767 true matches
  Global cutoff, all candidates (reference, 0.7672): P=0.5734 R=0.4785 F1=0.5217
  Best-match threshold (baseline, 0.5618): P=0.8196 R=0.8057 F1=0.8126
  Band [0.5618, 0.8405) + near-ties (rank <= 3, gap <= 0.03): 1,001 pairs (13.2% of candidates), holding 206/279 of the baseline's errors; recall ceiling 0.8970
  With Argon: P=0.9985 R=0.8449 F1=0.9153  (960/1001 band verdicts correct, $1.4081)
Les résultats, mesurés
Le passage en mode Argon a augmenté le score F1 d’environ 10 points sur les deux benchmarks, passant de 0,813 à 0,915 sur Abt-Buy et de 0,597 à 0,691 sur Amazon-Google, tout en traitant 13 à 14 % des paires candidates. Il ne s’agit pas d’une erreur d’arrondi : sur Abt-Buy, il a éliminé 135 des 136 fausses correspondances acceptées par le seuil. La pertinence d’un tel gain sur vos données dépend du coût que représente pour vous une fusion erronée ou une correspondance manquée. Un gain d’un ou deux points serait difficile à distinguer d’un simple décalage du seuil et ne justifierait pas le coût d’une API.
| jeu de données | Rapport de réduction | Exhaustivité des paires | F1, seuil de meilleure correspondance | F1, avec de l'argon | Partage envoyé à Argon | Coût pour 1 000 enregistrements |
|---|---|---|---|---|---|---|
| Abt-Achat | 99.08% | 99.0% | 0.813 | 0.915 | 13.2% | $0.76 |
| Amazon-Google | 99.69% | 94.1% | 0.597 | 0.691 | 14.0% | $0.58 |
La précision et le rappel permettent de comprendre d'où provient cette amélioration. Sur Abt-Buy, la précision est passée de 0,820 à 0,998 et le rappel de 0,806 à 0,845. Au sein de la fourchette, Argon a rejeté 135 des 136 fausses correspondances que le seuil avait acceptées, et a accepté 59 vraies correspondances qui constituaient le deuxième ou le troisième meilleur candidat selon l’ enregistrement, ce qu’un seuil de meilleure correspondance ne peut jamais sélectionner. Le rappel n’a pas atteint le plafond de 0,897 de la fourchette, car Argon a rejeté des paires dans lesquelles l’une des enregistrement était trop vague, ou dans lesquelles les produits différaient par leur variante, leur couleur ou leur offre groupée.
Le cas d’Amazon-Google est plus complexe : ses titres de logiciels varient en termes d’édition, de version et de conditionnement, et le filtrage a retenu 94,1 % des correspondances réelles. La précision est passée de 0,581 à 0,684 et le rappel de 0,614 à 0,698, et Argon a donné le bon résultat pour 76,4 % de la plage. La plupart de ses 316 erreurs (290) correspondaient à des éléments rejetés par le fichier de référence. Sur un échantillon aléatoire de 12 éléments, sept partagent un numéro de modèle, une référence ou une version explicite avec la fiche correspondante, comme le VPN01L de Netgear, ce qui met en évidence des lacunes dans les étiquettes de référence. Tous les scores présentés ici utilisent toujours le fichier de référence tel qu’il a été publié.
Coût. Au tarif exact d’OpenRouter par appel, y compris les jetons de réflexion, les 1 001 appels Abt-Buy ont coûté 1,41 $, et les 1 338 appels Amazon-Google ont coûté 2,42 $. Pour 1 000 enregistrements dans chaque partition de test, en comptant les enregistrements de la partition de test de la première table plus l’intégralité de la deuxième table (1 849 enregistrements pour Abt-Buy, 4 181 pour Amazon-Google), cela représente respectivement 0,76 $ et 0,58 $. Le prix catalogue d’Argon double le 1er décembre 2026, selon la page de tarification de l’API Gemini de Google, ce qui ferait environ doubler ces chiffres. À titre de référence, AWS Entity Resolution facture 0,25 $ pour 1 000 enregistrements traités pour la mise en correspondance basée sur des règles ou sur l’apprentissage automatique, à chaque « enregistrement » plutôt que par tranche.
Latence. Sur un ordinateur portable équipé uniquement d’ processeur et de 8 Go de RAM, l’intégration des 2 173 enregistrements Abt-Buy a pris 771 secondes, et le blocage a duré 35 secondes. Les appels Argon ont pris 54 minutes pour Abt-Buy et 88 minutes pour Amazon-Google, avec 2 requêtes en parallèle ; avec 8 requêtes en parallèle, nos appels ont renvoyé 429 erreurs de limitation de débit. L’intégration est un coût ponctuel : le harnais met les vecteurs en cache, de sorte que les nouvelles exécutions démarrent dès le blocage.
Par rapport à la littérature.Li et al. indiquent que Ditto, un outil de correspondance optimisé sur des paires étiquetées, atteint un F1 de 89,33 sur Abt-Buy et de 75,58 sur Amazon-Google (0,893 et 0,756 sur l’échelle utilisée ici) sur les versions ER-Magellan de ces benchmarks. Ditto a été évalué sur un ensemble présélectionné de paires étiquetées, tandis que nos résultats proviennent de la résolution des tableaux complets après le regroupement ; considérez donc ses scores comme un point de référence. Notre pipeline ne nécessite aucune donnée d’ apprentissage , et son rappel est limité par ce que le regroupement conserve et par les candidats qui atteignent la fourchette.
Pourquoi cela fonctionne sur votre propre infrastructure ?
Les données de résolution concernent les clients, les patients et les contreparties : il s’agit d’enregistrements qui, bien souvent, ne peuvent pas sortir d’un périmètre réglementé. Dans ce cas, VectorAI DB et le modèle d’embedding s’exécutent sur vos propres machines ; ainsi, les embeddings, le filtrage et les entités résolues restent au sein de votre réseau. Seul l’appel Argon envoie des données vers l’extérieur : la bande, soit 13,2 % des paires candidates, à raison de deux enregistrements à la fois. Pour les données réglementées, choisissez l’une des deux options suivantes :
- Anonymisez les données. Supprimez ou masquez les noms, adresses e-mail et numéros de compte, et n'envoyez que les champs permettant d'établir la correspondance, si votre politique autorise la transmission de données.
- Conservez le deuxième passage en local. Si aucun champ ne peut être exporté, remplacez la fonction adjudicate() par un appel à un modèle que vous hébergez. La structure du code reste la même. Nous n'avons pas évalué de modèle local lors de cette exécution ; attendez-vous donc à des chiffres différents en termes de précision et de coût.
Quand la collaboration en vaut la peine, et quand ce n'est pas le cas
Cette prise de position s'inscrit dans un débat d'actualité sur l'utilisation des LLM dans la résolution d'entités. Jeff Jonas, fondateur de Senzing, explique qu'on lui demande souvent pourquoi ne pas simplement utiliser un LLM pour la résolution d'entités, et répond que ce n'est « pas une bonne idée ». Il cite la comparaison réalisée par Clair Sullivan entre Claude Opus 4.8 et le moteur de Senzing, dans laquelle le LLM s’est révélé bien plus lent et coûteux, et met en avant les résultats déterministes et l’explicabilité. Le pipeline présenté ici fait le choix de l’évolutivité et évite de recourir au LLM pour la quasi-totalité des paires ; VectorAI DB et le seuil déterminent 87 % des candidats, tandis qu’Argon n’intervient que dans la bande où le seuil n’est pas fiable. Il répond également en partie à la question de l’explicabilité, puisque chaque verdict est consigné avec sa justification. Cela ne rend pas Argon déterministe, mais une nouvelle exécution reprend les verdicts enregistrés au lieu de poser à nouveau la question.
Lancez le passage Argon lorsque deux conditions sont remplies pour vos données : la bande regroupe la plupart des erreurs du seuil, et Argon détermine les paires de bandes avec une précision supérieure d’au moins 10 points à celle du seuil. Ces deux conditions étaient remplies pour les deux tests de performance, et à chaque fois, ce passage a permis de gagner environ 10 points F1 pour moins d’un dollar par 1 000 enregistrements.
| jeu de données | Les erreurs de Threshold au sein du groupe | Seuil directement sur les paires de bandes | Paires d'argon sur la bande | Gain F1 | Coût pour 1 000 enregistrements |
|---|---|---|---|---|---|
| Abt-Achat | 206 sur 279 (74 %) | 79.4% | 95.9% | +10.3 | $0.76 |
| Amazon-Google | 500 sur 697 (72 %) | 62.6% | 76.4% | +9.4 | $0.58 |
L'avance d'Argon sur les paires de bandes était de 16,5 points sur Abt-Buy et de 13,8 points sur Amazon-Google. Pour déterminer à quel moment cette avance cesse d'influencer les achats de F1, nous avons réexécuté la bande en divisant sa largeur par deux et en la doublant sur les deux sites jeux de données. Chaque résultat provenait du même journal, de sorte que chaque ligne indique ce qu'a apporté la tranche supplémentaire de la bande :
| jeu de données | Largeur de bande | Paires envoyées à Argon | F1 à l'argon | Coût de l'argon | L'avance d'Argon dans la catégorie par paires a été renforcée |
|---|---|---|---|---|---|
| Abt-Achat | 0.5× | 803 | 0.901 | $1.13 | (base) |
| Abt-Achat | 1× | 1,001 | 0.915 | $1.41 | +12,1 points sur 198 paires |
| Abt-Achat | 2× | 1,079 | 0.916 | $1.53 | +1,3 point sur 78 paires |
| Amazon-Google | 0.5× | 1,269 | 0.6905 | $2.32 | (base) |
| Amazon-Google | 1× | 1,338 | 0.6909 | $2.42 | +1,4 point sur 69 paires |
| Amazon-Google | 2× | 1,348 | 0.6924 | $2.44 | +20 points sur 10 paires |
Les tranches où Argon a dépassé le seuil ont clairement porté leurs fruits. Sur Abt-Buy, la tranche « demi à pleine », avec une avance de 12,1 points, a rapporté 1,5 point F1 pour 0,28 $. Sur Amazon-Google, les 10 dernières paires, avec une avance de 20 points, ont rapporté 0,15 point pour 0,02 $. Les tranches où l’avance était d’environ un point ont rapporté moins d’un dixième de point chacune : les 78 paires suivantes d’Abt-Buy ont rapporté 0,07 point pour 0,12 $, et la tranche « demi-tranche à tranche entière » sur Amazon-Google a rapporté 0,04 point pour 0,09 $. Ainsi, les dépenses supplémentaires ont cessé de générer des points F1 quelque part entre une avance de 1 point et une avance de 12 points. Deux jeux de données ne permettent pas de déterminer cette limite avec plus de précision ; considérez donc la barre des 10 points comme une règle empirique se situant à l’intérieur de cette fourchette.
Le forfait cesse d'être valable dans les trois cas suivants :
- Le seuil se situe déjà exactement sur la bande. Si vos paires de bandes basées sur le seuil s'accordent presque aussi bien que celles d'Argon, le passage consomme des ressources pour confirmer ce que le seuil savait déjà.
- Les erreurs se situent en dehors de la bande. Si le filtrage élimine des correspondances exactes, ou si celles-ci sont classées trop bas pour être considérées comme des quasi-correspondances, elles ne sont pas prises en compte lors de la deuxième étape. Dans le cas d’Amazon-Google, cela a limité le taux de rappel à 0,727 avant même qu’Argon n’ait lu une seule paire.
- La bande est trop large. En doublant la largeur de la bande sur Abt-Buy, 78 paires supplémentaires ont été envoyées vers Argon (1 079 au lieu de 1 001) et cela a coûté 0,12 $ de plus selon les tarifs mesurés par OpenRouter, mais une seule erreur supplémentaire par rapport au seuil s'est retrouvée dans cette bande. F1 est passé de 0,9153 à 0,9160, soit moins d'un dixième de point. Définissez les limites à partir de vos données, puis ne les modifiez plus.
Pour vérifier vos propres données, étiquetez manuellement environ 200 paires de bandes, puis comparez la fréquence à laquelle le seuil et Argon les identifient correctement. Cet échantillon coûte environ 30 centimes en appels Argon aux tarifs indiqués ici, et il vous permet de savoir si le traitement complet sera rentable avant de le lancer.
Conclusion
Le pipeline présenté dans cet article a correctement identifié les téléviseurs Sharp dès le début. Le seuil a sélectionné le modèle LC37D44U car son vecteur avait obtenu un score plus élevé ; Argon a lu les deux enregistrements, a associé le modèle LC37D64U à partir de son numéro de modèle et a consigné la raison de ce choix. Sur l'échantillon de test Abt-Buy, ce deuxième passage a fait passer le F1 de 0,813 à 0,915 pour un coût de 0,76 $ par 1 000 enregistrements.
Ce résultat découle de trois décisions qui se complètent :
- Effectuez une recherche par voisins les plus proches filtrée dans la base de données VectorAI, de sorte que 99 % de l'espace de comparaison disparaisse tandis que 99 % des correspondances réelles sont conservées.
- Définissez les limites de la fourchette à partir des données étiquetées, de sorte que seuls les 13,2 % de candidats incertains entraînent un coût.
- Envoyez uniquement cette bande à un modèle capable de lire une référence.
VectorAI DB et le modèle d'embedding fonctionnent sur votre propre matériel ; ainsi, tout reste au sein de votre réseau, à l'exception de la bande passante.
Ce même harnais s'exécute sur vos propres tables. Pointez le chargeur vers vos enregistrements clients, fournisseurs ou produits, définissez vos règles d'exclusion dans la clause « must » du filtre de blocage, puis exécutez-le sur VectorAI DB Community Edition. Téléchargez l'image pour commencer :
docker pull actian/vectorai:latest
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
