

Cessez de vous fier à votre taux de réussite du cache. 7 tests vous expliquent pourquoi.


Points clés à retenir
- Un taux élevé de réussite du cache sémantique ne garantit pas l'exactitude des réponses ; il convient donc de mesurer le taux de faux positifs parallèlement au taux de réussite, à la latence et aux économies réalisées.
- Lors des tests menés par Banking77, un seuil de similarité de 0,83 a permis d'obtenir un taux de faux positifs de 4,8 % et un taux de réussite de 70,1 % sur les requêtes non utilisées pour l'entraînement ; toutefois, les seuils à eux seuls ne permettent pas de détecter les négations, les modifications de chiffres ou de dates, les correspondances entre différents locataires, ni les réponses obsolètes.
- Les mesures de sécurité ciblées sont plus efficaces : vérifications précises de la négation et des valeurs, filtres OBLIGATOIRES basés sur le locataire et l'intention, invalidation des entrées périmées et vérification locale facultative pour les intentions à haut risque.
- Définissez un objectif de précision, ajustez les seuils en fonction de vos propres requêtes étiquetées, puis validez chaque mesure de sécurité avant le déploiement en production.
La mise en cache sémantique permet de réduire les coûts liés aux grands modèles linguistiques (LLM) et de diminuer la latence en réutilisant les réponses à des requêtes similaires, plutôt que d’interroger le modèle à chaque fois. Si vous utilisez un cache sémantique, vous en mesurez probablement l’efficacité à l’aune du taux de réussite et du nombre d’appels au modèle qu’il permet d’éviter. Cependant, un accès au cache ne garantit pas une réponse correcte. Un cache peut renvoyer une réponse sûre, mais non pertinente, tout en affichant un taux de réussite satisfaisant.
Le problème réside dans la manière dont le cache détermine quelles requêtes sont suffisamment similaires pour partager une même réponse. La plupart des caches sémantiques utilisent un seuil de similarité pour prendre cette décision. Si l'on abaisse ce seuil, davantage de requêtes obtiennent une correspondance. Si on l'augmente, le cache rejette davantage de correspondances et envoie davantage de requêtes au modèle.
Nous avons évalué ce problème à travers sept tests afin de déterminer à quelle fréquence la mise en cache sémantique renvoie une réponse erronée et ce que vous pouvez faire pour y remédier. Ces tests visent à vérifier si un cache est capable de distinguer des requêtes qui semblent similaires mais qui nécessitent des réponses différentes. Nous mesurons le taux de faux positifs parallèlement au taux de réussite, plutôt que de considérer un nombre plus élevé de résultats positifs comme une amélioration automatique.
Si vous développez ou exploitez des applications LLM, cet article vous explique comment évaluer votre cache avant de l'utiliser en production.

TL;DR
- Un taux élevé de réussite dans le cache sémantique ne garantit pas l'exactitude des réponses. Il convient de mesurer le taux de faux positifs (FPR) parallèlement au taux de réussite, à la latence et aux économies réalisées.
- Lors de tests réalisés avec Banking77, un seuil de similarité de 0,83 a permis d'obtenir un taux de faux positifs (FPR) de 4,8 % et un taux de réussite de 70,1 % sur les requêtes non utilisées lors de l'apprentissage.
- Les seuils de similitude ne suffisent pas à eux seuls à empêcher les correspondances erronées dues à la négation, à la modification de chiffres et de dates, aux requêtes inter-locataires ou aux réponses obsolètes. Recourez à des vérifications ciblées, à des filtres et à l'invalidation du cache.
- Définissez un objectif de précision, testez-le à l'aide de vos propres requêtes et validez les mesures de sécurité avant de déployer votre cache sémantique en production.
La promesse du taux de réussite
Le taux de réussite indique uniquement la fréquence à laquelle le cache trouve une correspondance selon le seuil défini. Il ne permet pas de savoir si la réponse stockée répond correctement à la nouvelle requête . Si vous assouplissez le seuil, davantage de requêtes pourront correspondre à des entrées existantes. Votre tableau de bord peut afficher davantage de réussites de cache et des économies potentielles plus importantes, même si certaines de ces correspondances associent des questions nécessitant des réponses différentes.
Le guide de TrueFoundry sur la mise en cache sémantique explique comment la comparaison de similarité basée sur l'encodage permet aux applications de réutiliser des réponses à des requêtes formulées différemment. Mais ces gains ne permettent pas de savoir si le cache a renvoyé la bonne réponse.
Prenons l’exemple d’un assistant d’ support s bancaires. Un utilisateur demande : « Comment puis-je résilier ma carte bancaire ? » Un autre demande : « Comment puis-je éviter que ma carte bancaire soit résiliée ? » Leurs requêtes contiennent plusieurs mots en commun et peuvent présenter des représentations similaires, mais leurs intentions diffèrent. Si le cache renvoie les instructions de résiliation au deuxième utilisateur, la requête est tout de même comptabilisée comme un résultat pertinent. Le système économise un appel au modèle, mais l’ utilisateur reçoit une réponse erronée.
C'est là que réside la différence entre les performances du cache et son exactitude. Vous devez continuer à suivre le taux de réussite, la latence et les coûts d'inférence, car ces indicateurs permettent de déterminer si la mise en cache améliore l'efficacité. Cependant, vous devez également mesurer la fréquence à laquelle un résultat positif renvoie une réponse qui n'aurait pas dû être réutilisée. Sans cette mesure, vous ne pouvez pas savoir si un taux de réussite plus élevé reflète une meilleure mise en cache ou si le cache est prêt à accepter des correspondances douteuses.
Pour comprendre ce compromis, il faut examiner le seuil de similarité et évaluer l'évolution du taux de réussite et du taux de faux positifs lorsque l'on modifie ce seuil.
Le seuil est un équilibre entre deux échecs
Un seuil de similarité plus élevé permet de réduire le nombre de résultats erronés, mais il rejette également davantage de requêtes qui auraient pu réutiliser une réponse correcte. Le seuil adéquat est celui qui vous permet d'atteindre votre objectif en matière de taux de faux positifs tout en conservant autant de résultats fiables que possible.
Un cache sémantique convertit généralement une requête ( requête ) en un vecteur de représentation (embedding), le compare aux vecteurs de représentation stockés ( requête ) et vérifie si la correspondance la plus proche atteint le seuil défini. Si c'est le cas, le cache renvoie la réponse stockée. Dans le cas contraire, l'application envoie la requête ( requête ) au modèle. Le seuil détermine dans quelle mesure le cache accepte une correspondance, mais il ne permet pas d'établir que deux requêtes ont la même intention.
Un seuil plus élevé exige une correspondance plus précise, tandis qu'un seuil plus bas accepte un éventail plus large de requêtes. Ce paramètre unique influe sur la fréquence à laquelle votre cache fournit une réponse existante et sur celle à laquelle il rejette une requête requête qui aurait pu en bénéficier.
Un seuil trop strict peut compromettre les économies que vous souhaitiez réaliser en mettant en place la mise en cache. Les utilisateurs formulent rarement la même question de manière identique, et de légères différences de formulation n'indiquent pas toujours un changement d'intention. Si votre cache rejette trop de correspondances valides, votre application effectue des appels inutiles au modèle. Vous payez pour des réponses que vous auriez pu réutiliser, et la latence augmente.
Un seuil trop large engendre le problème inverse. Le cache accepte davantage de correspondances, mais la similitude sous-jacente ne garantit pas que deux requêtes nécessitent la même réponse. Comme l'explique le guide de Portkey sur les seuils de mise en cache sémantique, le seuil détermine dans quelle mesure le système réutilise une réponse, et un paramètre trop permissif peut entraîner des faux positifs.
Aucun de ces deux extrêmes ne constitue une base fiable pour choisir un seuil. Il faut connaître le taux de réutilisation associé à chaque paramètre et la fréquence à laquelle le cache renvoie une réponse qui n’appartient pas à l’ requête. Cela nécessite d’évaluer conjointement le taux de réussite et le taux de faux positifs, plutôt que de régler un seul indicateur de manière isolée isolement.
En pratique, il convient de définir d'abord un objectif de précision, puis de déterminer quel seuil permet de l'atteindre sans sacrifier plus que nécessaire l'efficacité du cache. Le réglage approprié dépend de vos requêtes, des conséquences d'une réponse erronée et des résultats de votre propre évaluation.
Ce qu'un coup manqué coûte réellement
Un échec de mise en cache vous coûte un appel supplémentaire au modèle. Un faux positif peut fournir une réponse erronée à votre utilisateur alors même que votre application signale une réussite de la mise en cache.
L’analyse de Tian Pan sur la mise en cache sémantique en environnement de production met en évidence le risque de renvoyer des réponses erronées avec un niveau de confiance élevé. Un cache sémantique ne sait pas nécessairement quand une correspondance proche modifie le sens d’une « requête ». Il peut trouver une réponse présentant une grande similitude d’embedding même lorsque l’« utilisateur » nécessite une réponse différente.
La négation met particulièrement bien en évidence ce problème. Comparez « annuler ma carte » et « ne pas annuler ma carte ». Ces deux requêtes partagent presque tous leurs mots, mais elles expriment des instructions opposées. La réutilisation d’une réponse erronée pourrait amener une application à agir à l’encontre de la volonté de l’ utilisateur. On ne peut pas supposer qu’un score de similarité élevé signifie que les requêtes sont interchangeables.
Les chiffres et les dates constituent un autre risque. Un accès erroné au cache peut renvoyer une réponse qui semble plausible, mais qui contient une valeur obsolète ou incorrecte. Dans le test n° 3, la requête « Fixer ma limite quotidienne à 2 500 » a donné lieu à une correspondance avec une page mise en cache ( requête ) utilisant la valeur « 250 », avec un score de similarité de 0,962. Malgré ce score élevé, les deux requêtes spécifient des limites différentes. Cet exemple montre pourquoi la similarité à elle seule ne suffit pas à protéger les valeurs qui modifient le sens d’une requête.
Ce sont là les modes de défaillance que le taux de réussite ne permet pas de détecter. Votre cache peut considérer chaque correspondance comme un succès, même lorsqu’un mot, un montant ou une date modifié(e) rend la réponse stockée inadaptée. Le coût va bien au-delà d’un simple appel supplémentaire au modèle. Selon votre application, une réponse erronée peut induire un client en erreur, déclencher une action incorrecte ou nuire à la confiance dans le système.
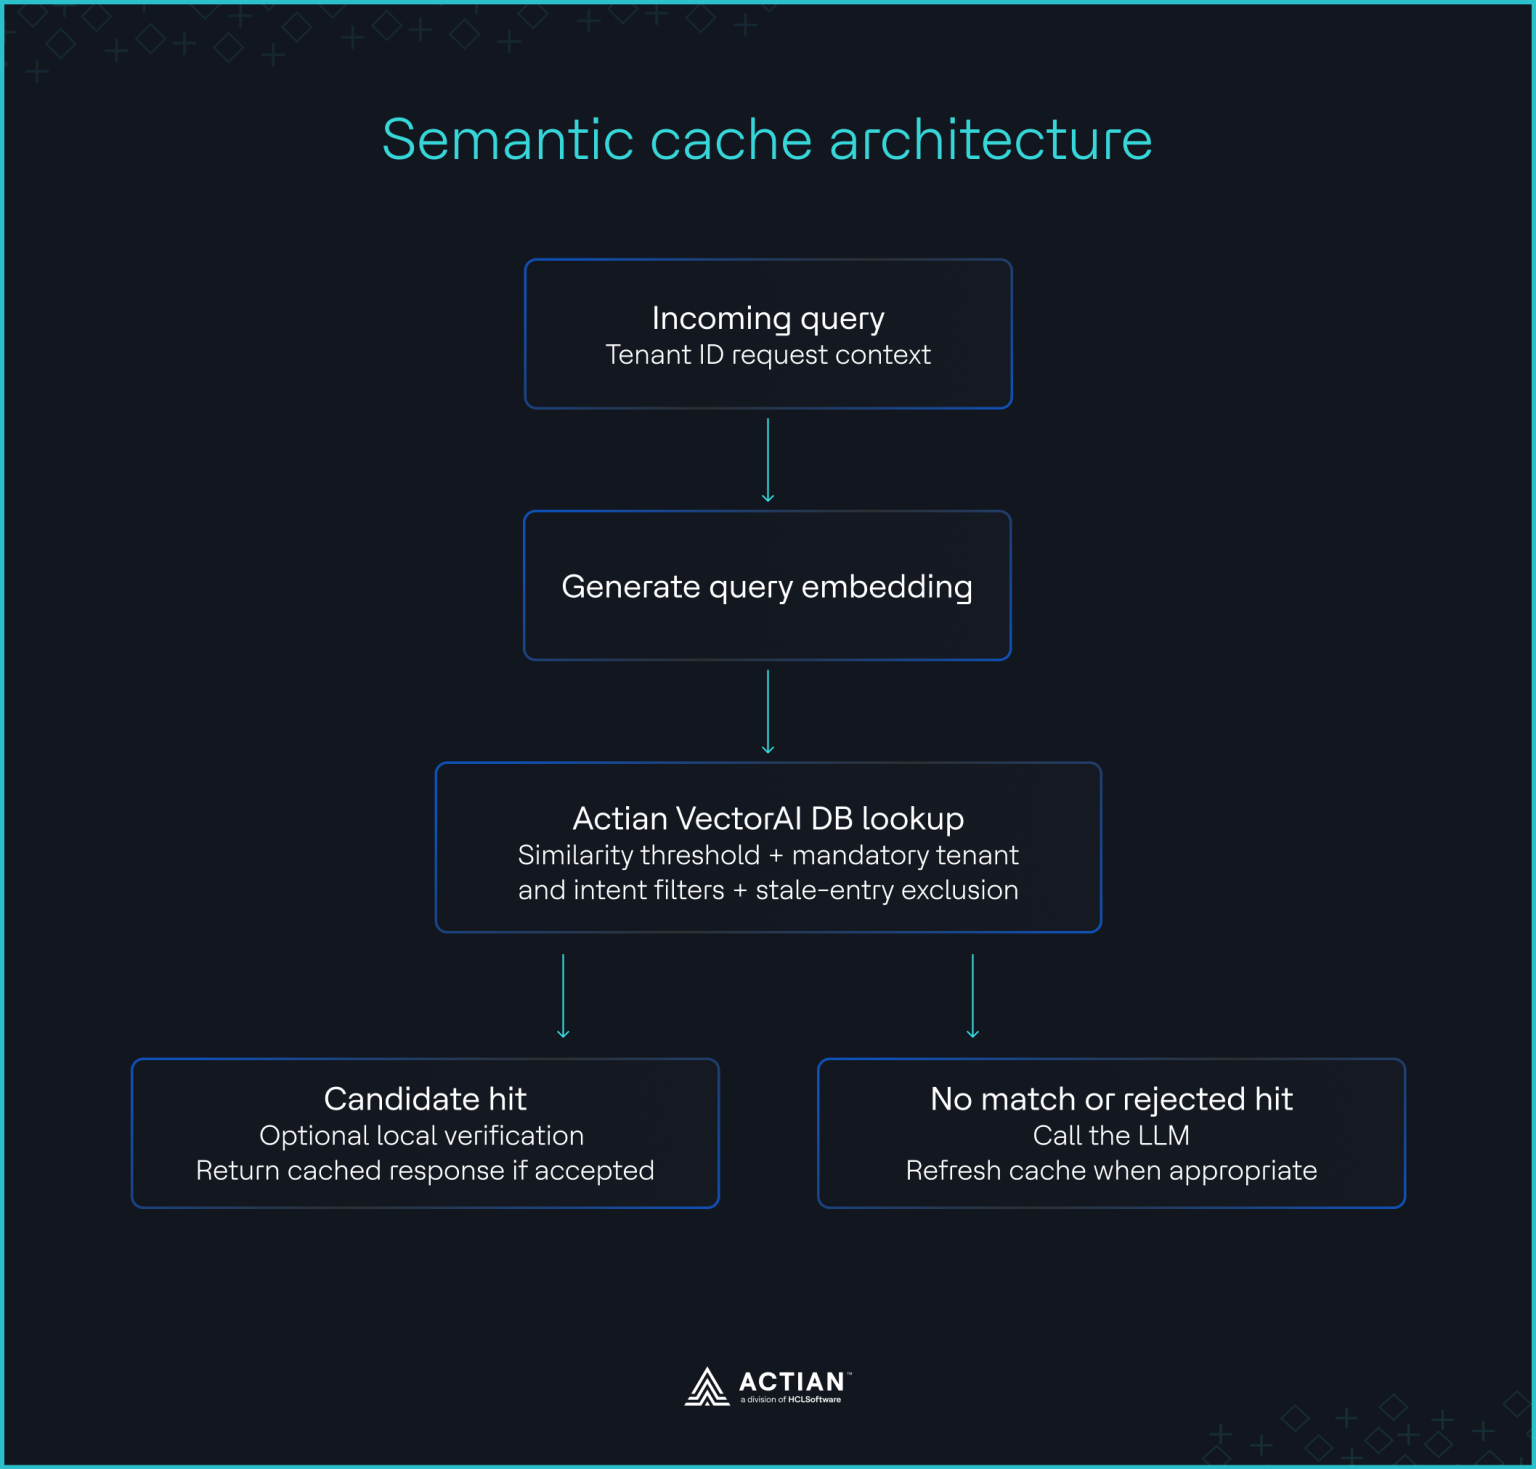
Architecture de cache sémantique
Conditions préalables et configuration
Pour reproduire les expériences, vous aurez besoin de Docker pour exécuter VectorAI DB en local, d'Python pour exécuter les scripts de test, et d'uv pour gérer l'environnement d'Python et les dépendances.
Avant de commencer, installez les éléments suivants :
- Docker Desktop ou Docker Engine avec Docker Compose
- Python 3.11 ou 3.12
- uv, le gestionnaire d'Python s et d'environnements utilisé par le projet
Clonez le dépôt « dépôt » et lancez VectorAI DB
Dans votre terminal, clonez le contenu pour développeurs d'Actian dépôt, puis accédez au répertoire du projet « semantic cache ».
git clone https://github.com/actian-devs/developer-content.git
cd developer-content/blog/semantic-cache-fp
Lancez VectorAI DB avec Docker Compose.
docker-compose up -dVous devriez voir le résultat suivant :
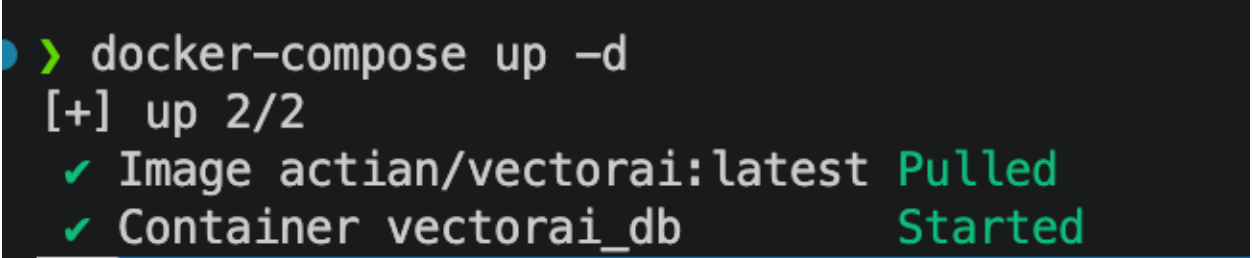
Démarrage de VectorAI DB
Installez les dépendances d'Python et créez l'environnement virtuel.
uv syncAttendez que VectorAI DB ait fini de démarrer avant d'exécuter les tests. Vous pouvez vérifier l'état du conteneur à l'aide de la commande ` docker ps`.
Effectuez les sept tests
Commencez par lancer le balayage des seuils. Celui-ci évalue les seuils compris entre 0,50 et 0,99 et identifie le seuil qui respecte l'objectif d'un taux de faux positifs de 5 % sur les données d'étalonnage.
uv run python test1_threshold_sweep.py --threshold 0.80Utilisez la valeur 0,80 pour reproduire les résultats des sept tests présentés dans cet article. Le balayage des seuils permet également de déterminer quel seuil respecte l'objectif d'un taux de faux positifs de 5 %. Dans notre évaluation, la valeur 0,83 a atteint cet objectif sur l'échantillon de validation.
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
uv run python test4_partitions.py --threshold 0.80
uv run python test6_query_length.py --threshold 0.80
uv run python test7_stale_answers.py --threshold 0.80
Le test 5 exécute un petit modèle de vérification. Exportez d'abord les recherches dans le cache, puis exécutez le modèle sur celles-ci. decider-0.8b fonctionne sur un ordinateur portable. Les modèles plus volumineux, tels que decider-4b, nécessitent un GPU.
uv run python test5_decider_verify.py \
  --threshold 0.80 \
  --export-hits data/test5_lookups.json
uv run --extra decider python test5_decider_verify.py \
  --threshold 0.80 \
  --model Mapika/decider-0.8b \
  --max-hits 100 \
  --hits-file data/test5_lookups.json
Une fois les tests terminés, établissez le tableau des résultats.
uv run python make_table.pyLes scripts enregistrent leurs résultats dans le fichier répertoire «results/ » . Ceux-ci comprennent les données de balayage des seuils, les données utilisées pour générer le tableau de résultats, ainsi que des fichiers JSON individuels contenant les mesures de chaque test. La première exécution télécharge l’ jeu de données e et le modèle d’intégration ; elle peut donc prendre plus de temps que les exécutions suivantes.
Sept tests, une image
Avec un seuil de similarité de 0,80, le cache a renvoyé 610 résultats positifs sur 770 requêtes de recherche, soit un taux de réussite de 79,2 %. Parmi ces résultats positifs, 39 étaient erronés, ce qui correspond à un taux de faux positifs de 6,4 %. L'analyse des différents seuils a permis d'identifier 0,83 comme le paramètre permettant d'atteindre l'objectif de 5 % de faux positifs sur le sous-ensemble d'évaluation réservé. Sur ce sous-ensemble, le cache a atteint un taux de réussite de 70,1 % et un taux de faux positifs de 4,8 %.
Dans le cadre de ces expériences, VectorAI DB a été utilisé pour stocker les représentations de 3 075 questions issues de Banking77, une base de données publique jeu de données regroupant des requêtes relatives à l'support bancaire classées selon 77 intentions. Ce nombre respecte la limite de 5 000 vecteurs imposée par l'édition Community. Nous avons recherché 770 questions supplémentaires provenant du même site jeu de données à l'aide de la sentence-transformers/all-MiniLM-L6-v2 modèle d'intégration. Pour chaque requête « requête », VectorAI DB renvoyait la question enregistrée la plus proche. Une correspondance était considérée comme un résultat positif lorsque sa similarité cosinus atteignait le seuil de 0,80.
Nous avons défini un résultat erroné comme un résultat pour lequel la question mise en cache avait une intention différente, appartenait à un autre locataire simulé ou faisait référence à une source ayant changé. Le taux de faux positifs (FPR) correspond au nombre de résultats erronés divisé par le nombre total de résultats. Notre objectif était d'atteindre un FPR inférieur ou égal à 5 %. Nous avons calibré les seuils sur la moitié de l'ensemble de recherche et les avons évalués sur l'autre moitié.
L'« jeu de données » est un échantillon et non la collection Banking77 dans son intégralité. Nous avons simulé des locataires et des modifications de source, puis généré à partir de modèles les paires utilisées dans les tests de négation et de nombre. Les résultats montrent donc comment ces modes de défaillance se comportent dans des conditions contrôlées, et non à quelle fréquence ils se produisent dans chaque cache de production.
Test n° 1 : balayage du seuil
Ce que ce test évalue : La plupart des caches sémantiques reposent sur un paramètre principal : le seuil de similarité. Ce test vise à déterminer comment la précision évolue lorsque vous modifiez ce seuil. Vous interrogez le cache avec 770 questions à chaque seuil compris entre 0,50 et 0,99, et vous comptabilisez deux éléments à chaque étape : la fréquence à laquelle le cache fournit une réponse (taux de réussite) et la fréquence à laquelle sa réponse est erronée (taux de faux positifs).
Avec un taux de 0,80, le cache a renvoyé 39 réponses erronées sur 610 résultats. Cela correspond à un taux de faux positifs (FPR) de 6,4 %, soit environ cinq réponses erronées pour 100 requêtes entrantes. Certaines correspondances erronées présentaient des scores de similarité très élevés. Par exemple, la question « Pourquoi n’ai-je pas pu effectuer un virement ? » a été associée à « Pourquoi n’ai-je pas pu finaliser mon virement ? » avec un score de 0,921, alors même que ces questions correspondaient à des intentions Banking77 différentes, à savoir « declined_transfer » et « failed_transfer ».
Le fait de relever le seuil à 0,83 a permis d’atteindre un taux de faux positifs (FPR) de 4,8 % sur l’ensemble d’évaluation de validation, ce qui correspond à l’objectif de 5 %. Le taux de réussite a quant à lui chuté à 70,1 %. C’est là le compromis que masque une é tableau de bord axée uniquement sur le taux de réussite. Le seuil plus élevé a réduit les réutilisations erronées, mais a également entraîné une augmentation du nombre de requêtes adressées au modèle.
La figure 2 représente graphiquement le taux de réussite et le taux de faux positifs pour les différents seuils testés. Utilisez cette courbe pour choisir un point de fonctionnement en fonction d'un objectif de précision, plutôt que de considérer le taux de réussite le plus élevé comme l'objectif à atteindre.

Taux de réussite et taux de faux positifs en fonction des seuils de similarité
Lancez le test 1 sur votre terminal :
uv run python test1_threshold_sweep.py --threshold 0.80Exercices 2 et 3 : Négation, nombres et dates
Ce qu’ils évaluent : Ces tests évaluent si un cache sémantique est capable de distinguer des questions similaires ayant des significations différentes, tout en réutilisant les réponses pour les questions qui ont le même sens. Par exemple, « Annuler ma carte » et « Ne pas annuler ma carte » ne diffèrent que par un mot, mais nécessitent des réponses opposées. De même, « Envoyer 250 $ » et « Envoyer 2 500 $ » ne diffèrent que par un chiffre, mais indiquent des montants différents. Les tests mettent en cache une question de chaque paire et posent l’autre pour vérifier que le cache ne réutilise pas à tort la réponse mise en cache. Ils incluent également des questions reformulées ayant la même signification afin de vérifier que le cache réutilise correctement ces réponses.
Le cache sémantique a eu du mal à distinguer les questions dont le sens était opposé, même lorsqu’elles ne différaient que par un seul mot. Il a réutilisé à tort les réponses mises en cache pour 74 des 75 questions négatives (98,7 %). Par exemple, la question « Ne devrais-je pas annuler ma carte ? » a été associée à « Devrais-je annuler ma carte ? » avec un score de similarité de 0,990, malgré une intention opposée.
Le réglage du seuil n’a pas suffi à résoudre ce problème. Les paires rejetées présentaient une similarité médiane de 0,946, supérieure à celle de 0,936 enregistrée pour les paraphrases qui préservaient l’intention initiale. Aucun seuil, même fixé à 0,99, n’a permis d’éviter au moins 95 % des erreurs de négation. En revanche, un simple contrôle rejetant les correspondances dès lors qu’une seule des « requête s » contenait une négation a réduit la part des questions négatives servies de 98,7 % à 4,0 %, tout en conservant un taux de paraphrase de 72,1 %.
Les chiffres et dates modifiés ont posé un défi similaire. Les 38 paires dont les valeurs avaient été modifiées présentaient une similarité médiane de 0,906, proche de la médiane de 0,911 observée pour les 44 paires de paraphrases. Le cache a traité l’ensemble des 38 requêtes comportant des valeurs modifiées. Par exemple, « Fixer ma limite quotidienne de carte à 2 500 $ » correspondait à « Fixer ma limite quotidienne de carte à 250 $ » avec un score de 0,962. De même, une question concernant un prélèvement le 21 juin correspondait à une autre concernant le 21 juillet avec un score de 0,964.
Pour bloquer au moins 95 % de ces requêtes comportant des valeurs modifiées, il a fallu appliquer un seuil de 0,97, ce qui a fait passer le taux de paraphrase de 95,5 % à 13,6 %. Une vérification de correspondance exacte pour les nombres et les termes de date a permis de bloquer toutes les valeurs modifiées lors de ce test, tout en maintenant le taux de paraphrase à 95,5 %.
Ces vérifications sont volontairement simples et présentent certaines limites. La vérification de la négation peut ne pas détecter les changements de sens indirects, tandis que la vérification de la valeur ne reconnaît pas les formats équivalents tels que « cinquante dollars » et « 50 $ ».
Exécutez les tests 2 et 3 sur votre terminal :
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
Test n° 4 : Limites de la propriété et de l'intention
Ce que ce test vérifie : Ce test vérifie si un cache peut empêcher que des réponses soient partagées entre différents clients (locataires) ou entre des sujets sans rapport entre eux. Par exemple, un client ne devrait pas recevoir la réponse mise en cache d’un autre client, et une question sur les frais de carte ne devrait pas renvoyer une réponse concernant les virements. Le test utilise trois locataires simulés pour identifier les correspondances incorrectes dans le cache, puis répète les recherches à l’aide des filtres de la base de données VectorAI afin de vérifier si le fait de restreindre les recherches par locataire et par sujet permet d’éviter ces erreurs.
Sans filtres, 425 des 610 résultats correspondaient à des erreurs, ce qui correspond à un taux de faux positifs de 69,7 %. Parmi ces résultats, 409, soit 67,1 % du total, dépassaient les limites d'un locataire. Les résultats erronés restants comprenaient des requêtes qui correspondaient à une intention erronée au sein d'un même locataire.
Un filtre « MUST » appliqué au locataire a permis d'éliminer les correspondances entre locataires et de réduire le taux global de faux positifs (FPR) à 9,1 %, avec un taux de correspondance de 61,4 %. Les erreurs restantes concernaient des correspondances avec des intentions voisines. Chaque partition de locataire contenant moins d'exemples par intention, la correspondance la plus proche disponible était plus susceptible de provenir d'une intention différente.
L'ajout d'un deuxième filtre « MUST » pour l'intention prédite par un classificateur allégé a permis de ramener le taux de faux positifs (FPR) à 4,7 %, avec un taux de réussite de 58,4 %. Le classificateur a prédit la bonne intention dans 88,4 % des cas. Le fait d'autoriser les correspondances issues des deux principales intentions identifiées par le classificateur via un filtre « SHOULD » a permis d'obtenir un taux de réussite plus élevé, à 60,6 %, mais le taux de faux positifs (FPR) est remonté à 7,9 %.
Les seuils par intention n'ont pas permis d'améliorer les résultats dans le cadre de cette expérience. Avec seulement environ cinq questions par intention disponibles pour l'étalonnage, le taux de faux positifs (FPR) sur les requêtes non utilisées pour l'étalonnage s'élevait à 9,6 %. Il s'agit là d'une limite de cet échantillon, et non d'une preuve que les seuils par intention ne peuvent pas fonctionner avec davantage de données.
Ces résultats montrent pourquoi la similitude ne constitue pas à elle seule un mécanisme de contrôle d'accès. Une recherche dans le cache doit respecter les limites des locataires et, le cas échéant, restreindre les candidats en fonction de l'intention avant de sélectionner une réponse.
Lancez le test n° 4 sur votre terminal :
uv run python test4_partitions.py --threshold 0.80Test n° 5 : Vérification locale
Ce qu'il vérifie : Les seuils et les filtres laissent encore passer certaines réponses erronées. Ce test apporte un deuxième avis : avant que le cache ne renvoie un résultat, un petit modèle local analyse les deux questions et détermine si une seule réponse peut convenir aux deux. Le test mesure le nombre de résultats erronés détectés par le modèle, le nombre de résultats corrects rejetés par erreur, ainsi que le temps supplémentaire généré par chaque vérification.
Afin de tester une mesure de sécurité supplémentaire, nous avons envoyé 100 résultats sélectionnés au modèle « decider-0.8b » de Mapika sur un MacBook équipé d’un processeur Apple Silicon M3.
Avec un seuil de probabilité de « oui » fixé à 0,5, le vérificateur a détecté quatre des six faux positifs de l'échantillon. Il a également rejeté 25 des 94 vrais positifs, soit 26,6 %. Le temps de vérification médian était de 106 millisecondes par résultat, avec un 95e centile de 116 millisecondes sur l'ordinateur portable pour une taille de lot égale à un.
Un seuil inférieur de 0,3 n’a rejeté que deux résultats valides, mais n’a détecté qu’un seul résultat erroné. Ces résultats illustrent le compromis entre la détection des correspondances erronées et la préservation des résultats de cache utiles. L’échantillon ne contenant que six résultats erronés, il s’agit d’un résultat préliminaire et non d’une estimation fiable de l’efficacité du vérificateur. Une évaluation complète portant sur l’ensemble des 610 résultats positifs reste nécessaire. La latence mesurée ne constitue pas un benchmark de production. Considérez la vérification locale comme une mesure de sécurité qu’il convient de tester pour les intentions à enjeux élevés, et non comme une solution éprouvée.
Test n° 6 : requêtes courtes contre requêtes longues
Ce que ce test évalue : les questions courtes, telles que « la carte ne fonctionne pas », contiennent peu de détails ; par conséquent, des questions courtes sans rapport entre elles peuvent se ressembler. Ce test répartit les 770 questions en trois catégories (courtes, moyennes et longues), compare la fréquence des réponses erronées pour chaque groupe et vérifie si l'application d'un seuil plus strict pour les questions courtes s'avère utile.
requête La longueur a également eu une incidence sur la fiabilité. Les requêtes comportant huit mots ou moins représentaient 43 % de l'ensemble de recherche et étaient à l'origine de 27 des 39 résultats erronés. Avec un seuil de 0,80, leur taux de faux positifs (FPR) était de 9,4 %, contre 2,9 % pour les requêtes de longueur moyenne (de neuf à onze mots) et 4,6 % pour les requêtes de plus de onze mots.
Pour atteindre l'objectif de 5 %, les seuils calibrés étaient de 0,87 pour les requêtes courtes, de 0,80 pour les requêtes moyennes et de 0,83 pour les requêtes longues. L'application de ces seuils adaptés à la longueur des requêtes a permis de réduire le taux de faux positifs (FPR) à 2,0 % sur les requêtes non utilisées pour l'apprentissage, avec un taux de réussite de 64,2 %. À titre de comparaison, le seuil unique de 0,83 a donné un FPR de 4,8 % et un taux de réussite de 70,1 %.
Les seuils adaptés à la longueur ont amélioré la précision sur cet échantillon, au prix d'une diminution du nombre de résultats positifs. Vous devriez valider ce même modèle par rapport à votre propre distribution d'requête s avant d'adopter des seuils différents en fonction de la longueur.
Lancez le test n° 6 sur votre terminal :
uv run python test6_query_length.py --threshold 0.80Test n° 7 : réponses obsolètes après des modifications du code source
Ce que ce test vérifie : Une réponse mise en cache peut correspondre parfaitement à la question tout en étant erronée, car la politique sur laquelle elle repose a changé depuis sa mise en cache. Ce test modifie 20 % des politiques sous-jacentes après la mise en cache, puis vérifie à quelle fréquence le cache fournit une réponse obsolète. Il marque ensuite les entrées concernées comme obsolètes dans la base de données VectorAI et effectue une nouvelle vérification.
Nous avons traité chaque intention de Banking77 comme une source et avons modifié 15 des 77 sources après la mise en cache. Avant l'invalidation, le taux de faux positifs (FPR) a atteint 24,9 %. Sur 113 résultats, le cache a trouvé une question correspondant à la bonne intention, mais a renvoyé une réponse obsolète.
Nous avons utilisé un seul appel « set_payload » filtré pour marquer les 600 entrées provenant des sources modifiées comme obsolètes, puis nous avons ajouté un filtre « MUST NOT » afin d’exclure les entrées obsolètes des recherches. Le taux de faux positifs (FPR) est passé de 24,9 % à 11,4 %, et le taux de réussite s’est établi à 67,4 %. Cela a permis de réduire le problème sans toutefois l’éliminer. Certaines requêtes concernant des politiques modifiées correspondaient à une intention voisine qui dépassait encore le seuil de similarité. L’invalidation doit donc être associée à un rafraîchissement du cache ou à un filtrage approprié des intentions, suivi d’une nouvelle évaluation visant à détecter les erreurs restantes.
Exécutez le test n° 7 sur votre terminal :
uv run python test7_stale_answers.py --threshold 0.80Les résultats présentés dans un tableau
| Test | Mode de défaillance | Atténuation | Résultat |
| 1. Balayage de seuil | Un seuil donné autorise trop de correspondances erronées | Effectuer l'étalonnage en visant un taux de faux positifs (FPR) de 5 % | Avec un taux de 0,83, le FPR s'élevait à 4,8 % et le taux de réussite à 70,1 % sur les requêtes non utilisées. |
| 2. La négation | Les questions négatives sont notées comme des paraphrases | Vérifier les différences de négation | La part des requêtes rejetées est passée de 98,7 % à 4,0 % ; le taux de reformulation est resté stable à 72,1 %. |
| 3. Chiffres et dates | Les valeurs modifiées correspondent toujours | Exiger des correspondances exactes pour les chiffres et les mots désignant les dates | Le nombre de requêtes traitées avec des valeurs modifiées est passé de 100 % à 0 % ; le taux de paraphrase est resté stable à 95,5 %. |
| 4. Limites relatives au locataire et à l'intention | Correspond aux partitions croisées ou aux intentions | MUST applique des filtres sur le locataire et l'intention prévue | Le FPR a reculé à 4,7 %, avec un taux de réussite de 58,4 % |
| 5. Vérification sur place | Les résultats erronés dépassent le seuil et les filtres | Vérifier les résultats échantillonnés avec Decider-0.8b | Le FPR est passé de 6,0 % à 2,8 % sur un échantillon de 100 résultats ; ces résultats sont provisoires. |
| 6. Longueur de l'requête | Les requêtes courtes génèrent davantage de résultats erronés | Calibrer les seuils en fonction de la longueur d'requête | Le taux de FPR a chuté à 2,0 %, avec un taux de réussite de 64,2 % sur les requêtes non incluses dans l'échantillon |
| 7. Réponses obsolètes | Les réponses mises en cache ont une durée de vie plus longue que leurs données sources | Marquer les entrées obsolètes et les exclure de la recherche | Le FPR est passé de 24,9 % à 11,4 % ; filtrage des intentions de réapprovisionnement ou d'ajout |
Le FPR global de 0,80 masquait des échecs concentrés sur certains types d’ requête s et certaines conditions de cache. La négation et les valeurs modifiées ont contourné les seuils de similarité, les limites entre locataires ont nécessité l’application de filtres, et les réponses obsolètes ont nécessité une invalidation. Les requêtes courtes ont bénéficié d’un seuil plus strict, tandis que la vérification locale s’est révélée prometteuse mais nécessite une évaluation plus approfondie.
Ces résultats dépendent du modèle d'intégration choisi, de l'échantillon Banking77 et de la définition donnée dans le cadre de l'expérience à une « mauvaise réponse ». Les étiquettes d'intention ne constituent qu'un indicateur imparfait permettant de déterminer si deux questions peuvent sans risque partager une même réponse ; certaines correspondances peuvent donc être classées à tort dans un sens ou dans l'autre. Ces résultats fournissent des indications utiles sur des modes de défaillance spécifiques, mais ne constituent pas une prédiction universelle des performances en production.
Gérer un cache fiable
Partez d'un objectif de précision, et non d'un objectif de taux de réussite. Déterminez le nombre de réponses erronées que votre application peut tolérer, puis concevez le cache de manière à respecter ce nombre.
Définir le seuil en fonction d'un objectif de justesse
Mesurez le taux de faux positifs sur un échantillon étiqueté de votre propre trafic, variez la valeur du seuil et choisissez le réglage le plus bas qui vous permette d'atteindre votre objectif. Indiquez le taux de faux positifs à côté du taux de réussite sur chaque page tableau de bord. Utilisez un seuil plus strict pour les requêtes courtes.
Divisez l'espace de manière à ce qu'un accès ne puisse pas franchir une limite
Enregistrez le locataire, l'intention et la source avec chaque entrée mise en cache, et laissez VectorAI DB les utiliser comme critères de filtrage lors de la recherche. Un filtre « MUST » sur le locataire garantit que chaque client reste dans ses propres données. Un filtre sur l'intention empêche une question relative à une carte de recevoir une réponse concernant un virement. Un filtre « MUST NOT » sur un indicateur de péremption exclut les réponses obsolètes après un changement de source.
Vérifiez les résultats pour lesquels vous ne pouvez pas vous permettre de vous tromper
Avant de valider un résultat, comparez les détails qui ne correspondent pas : négations, montants et dates. Pour les opérations à enjeux élevés, telles que les remboursements et les annulations, ajoutez un modèle de vérification local. Suivez les résultats erronés qu’il détecte, les résultats valides qu’il rejette et la latence qu’il génère.
Effectuez cette vérification à intervalles réguliers. Un taux de détection n'a de sens que si vous indiquez également le taux de faux positifs.
Pour conclure
Un taux de réussite élevé indique que votre cache sémantique fonctionne, mais pas qu’il est correct. Les sept tests montrent que les réponses erronées se concentrent là où elles coûtent le plus cher : requêtes négatives, montants et dates modifiés, données d’un autre client et politiques obsolètes. Un seuil à lui seul ne suffit pas à les détecter. Définissez ce seuil en fonction d’un objectif d’exactitude, partitionnez le cache à l’aide des filtres VectorAI DB afin qu’un résultat ne puisse pas dépasser les limites d’un client ou d’une intention, et vérifiez les résultats pour lesquels vous ne pouvez pas vous permettre de vous tromper.
Pour évaluer les performances de votre propre cache, commencez par utiliser Actian VectorAI DB Community Edition. Effectuez les mêmes vérifications sur un échantillon étiqueté de vos propres requêtes, mesurez la fréquence à laquelle les accès au cache renvoient des réponses incorrectes, puis utilisez ces résultats pour ajuster ( optimiser ) votre seuil et vos mesures de sécurité.
Téléchargez l'image Docker « Community Edition » pour commencer.
docker pull actian/vectorai:latestSuivez ensuite les instructions de la documentation de VectorAI DB pour démarrer la base de données et lancer votre évaluation. L'édition Community prend en charge jusqu'à 5 000 vecteurs, ce qui la rend idéale pour reproduire ces expériences sur une machine de développement locale. Rejoignez la communauté Actian sur Discord pour obtenir de l'aide et participer aux discussions.
Rejoignez Discord
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
