
Phi-4-Mini, Gemma 4 et Qwen3 : quel est le meilleur LLM pour le Raspberry Pi 5 ?


Résumé
- Phi-4-Mini, Gemma 4 et Qwen3 sont chacun adaptés à différentes charges de travail d'IA en périphérie, en fonction du matériel, de la latence et des besoins des applications.
- Gemma 4 est particulièrement performant pour les applications multimodales, tandis que Phi-4-Mini met l'accent sur le raisonnement et la génération de code.
- Qwen3 se distingue par ses agents IA de production qui nécessitent un appel d'outils fiable et une large gamme d'support s multilingues.
- Le matériel a une incidence considérable sur les performances : le Raspberry Pi privilégie les modèles plus compacts, tandis que le Jetson offre des options plus puissantes grâce à l'accélération par GPU.
- La sélection du modèle ne constitue qu'une partie de l'déploiement en périphérie ; la quantification et l'architecture de recherche déterminent également les performances globales.
L'IA locale a atteint un niveau de maturité tel qu'un Raspberry Pi 5 peut désormais exécuter des modèles linguistiques performants. Phi-4-Mini, Gemma 4 et Qwen3 présentent des différences en matière de raisonnement, d'appel d'outils, d'support multimodale et d'efficacité matérielle. Votre choix dépendra du matériel que vous prévoyez de déployer, de la latence que vous pouvez tolérer et des charges de travail que votre agents IA devra traiter.
Cet article s'adresse aux ingénieurs de plateforme et aux ingénieurs en IA qui déploient des LLM locaux sur Raspberry Pi 5, Jetson Orin Nano et d'autres appareils similaires aux ressources mémoire limitées. Vous pourrez ainsi comparer les débits confirmés, les besoins en mémoire et la compatibilité matérielle, plutôt que de vous fier uniquement aux résultats des tests de performance. Si vous envisagez d'exécuter des modèles tels que Gemma avec une base de données vectorielle locale comme Actian VectorAI DB sur un Raspberry Pi 5, comprendre les compromis entre ces modèles vous aidera à choisir une configuration adaptée à votre matériel et à votre charge de travail.
Dans cet article, vous comparerez ces modèles disponibles selon les niveaux de matériel pertinents pour l'déploiement en périphérie.
Niveaux de matériel
Avant de comparer les modèles, déterminez la catégorie de matériel qui vous intéresse. Un même modèle peut offrir des performances très différentes selon les ressources disponibles, telles que la mémoire, la puissance de calcul et le refroidissement. Chaque chiffre de débit mentionné dans cet article correspond à une classe d’ déploiement s spécifique ; par conséquent, comparer les chiffres de différents appareils sans tenir compte de ce contexte peut conduire à un mauvais choix de modèle.
Le Raspberry Pi 5 avec 8 Go de RAM représente le niveau le plus limité. Toutes les inférences s'exécutent sur l'processeur, ce qui fait de la pression sur la mémoire la principale contrainte. Les recherches menées par Build Fast with AI montrent que, sur un Raspberry Pi 5, Gemma 4 E2B atteint environ 7,6 tok/s. Avec une quantification Q4_K_M, Gemma 4 E4B fonctionne à un débit d’environ 2 à 5 tok/s, car il repose fortement sur la mémoire d’échange. Dans les mêmes conditions, Qwen2.5-3B atteint environ 8,2 tok/s en décodage et Qwen3-4B atteint environ 5 à 7 tok/s.
Le Jetson Orin Nano se positionne dans une catégorie de performances différente. Il est livré avec 8 Go de mémoire, un accélérateur IA de 67 TOPS et une inférence accélérée par GPU. Les modèles qui peinent sur du matériel fonctionnant uniquement en mode « processeur » deviennent beaucoup plus réactifs, selon le modèle et le niveau de quantification. Au niveau le plus élevé, les serveurs et systèmes en périphérie, tels que le Mac Mini M4 doté de 16 à 32 Go de mémoire unifiée, offrent une marge suffisante pour des fenêtres de contexte plus vastes, une quantification de plus haute précision et plusieurs charges de travail d’inférence simultanées.
| Niveau matériel | Mémoire | Débit approximatif au niveau de Q4_K_M |
| Raspberry Pi 5 | 8 Go | 2 à 8,2 tok/s (selon le modèle) |
| Jetson Orin Nano | 8 Go, 67 TOPS | Jusqu'à 25,5 tok/s (selon le modèle) |
| Serveur périphérique / Mac Mini M4 | 16 à 32 Go de mémoire unifiée | Non vérifié |
Niveaux de matériel pour les LLM locaux déploiement
Profils des mannequins
Gemma 4 E2B et E4B
Les modèles Gemma 4 E2B et E4B utilisent une architecture dense avec des encodages par couche (PLE). Plutôt que d'ajouter davantage de couches au modèle, le PLE attribue à chaque couche du décodeur son propre petit encodage pour chaque token. Le modèle « Mixture of Experts » (MoE) de la famille Gemma 4 correspond à la variante distincte de 26 milliards de paramètres.
Gemma 4 E2B compte 2,3 milliards de paramètres effectifs et 5,1 milliards de paramètres au total. E4B porte ces chiffres à 4,5 milliards de paramètres effectifs et 8 milliards de paramètres au total. Les deux modèles sont distribués sous licence Apache 2.0 et offrent une fenêtre de contexte de 128 Ko.
Sur le Raspberry Pi 5, Gemma 4 E2B atteint environ 7,6 tok/s, ce qui le rend adapté à l’ processeur interactive sur un système de 8 Go. Gemma 4 E4B fonctionne quant à lui à un débit d’environ 2 à 5 tok/s, car il dépend fortement de la mémoire swap. Sur le Jetson Orin Nano avec accélération GPU, Gemma 4 E2B atteint environ 25,5 tok/s, avec une fenêtre de contexte de 8 k, ce qui rend ce modèle plus volumineux beaucoup plus pratique sur du matériel de périphérie équipé d’un GPU. Gemma 4 E4B atteint environ 11 à 14 tok/s.
Gemma 4 prend également en charge la saisie multimodale native. Elle accepte les entrées de type texte, image, audio et vidéo, et prend en charge l'appel de fonctions natives via des jetons spéciaux dédiés. Ces fonctionnalités réduisent la complexité de l'orchestration nécessaire lors du développement d'applications d'IA multimodales en périphérie.
Phi-4-Mini
Phi-4-Mini est un modèle comptant 3,8 milliards de paramètres, publié sous licence MIT. Il se distingue par ses performances en matière de raisonnement plutôt que par ses capacités multimodales ou son utilisation d'outils. Sur les benchmarks standard de raisonnement, il obtient un score de 88,6 % sur GSM8K et de 83,7 % sur ARC-C.
Des tests contrôlés réalisés sur des appareils mobiles (iPhone 14 Pro, Pixel 8, appareils Android de milieu de gamme) montrent que Phi-4-Mini offre un débit supérieur d’environ 15 à 20 % à celui de Qwen3-4B. Phi-4-Mini fonctionne également à une vitesse d’environ 5 à 8 tok/s sur un Raspberry Pi 5.
Une autre différence apparaît lorsque les agents sont soumis à des charges de travail soutenues. Phi-4-Mini produit des traces de raisonnement plus claires lors de raisonnements en plusieurs étapes, ce qui le rend particulièrement adapté aux tâches de planification et de raisonnement. Cependant, sa précision dans l’appel des outils est inférieure à celle de Qwen3 en configuration par défaut ; les flux de travail qui reposent fortement sur des appels de fonctions structurés peuvent donc nécessiter un réglage supplémentaire des invites.
Qwen3 (variantes 4B)
Les variantes de Qwen3-4B s'adressent aux développeurs qui créent des agents IA de production nécessitant une intégration fiable des outils. Ces modèles sont distribués sous licence Apache 2.0 et, selon la fiche technique officielle du modèle Qwen3-4B, ils prennent en charge plus de 100 langues (support ).
D’après les tests de performance disponibles pour le Raspberry Pi 5, Qwen3-4B atteint environ 5 à 7 tok/s sur un système de 8 Go utilisant la quantification Q4. Qwen3 se distingue par la précision de ses appels d’outils dès son installation. Il nécessite moins d’ingénierie d’intégration que le Phi-4-Mini pour les workflows qui font appel à des API, des bases de données ou des services locaux, ce qui en fait un choix de premier ordre pour les agents IA qui reposent sur des appels de fonctions structurés.
| Modèle | Paramètres actifs | Raspberry Pi 5 (tok/s) | Jetson Orin Nano (tok/s) | Licence | Précision de l'appel d'outils | Multimodal support |
| Gemma 4 E2B | 2,3 milliards effectifs (5,1 milliards au total) | ~7.6 | 25,5 (avec 8 000 jetons) | Apache 2.0 | Natif | Texte, image, audio, vidéo |
| Gemma 4 E4B | 4,5 milliards effectifs (8 milliards au total) | ~2 à 5 | ~ 11 à 14 | Apache 2.0 | Natif | Texte, image, audio, vidéo |
| Phi-4-Mini | 3.8B | ~ 5 à 8 | Non vérifié | MIT | Standard | Texte uniquement (le mode multimodal nécessite la version de base Phi-4) |
| Qwen3-4B | 4B | environ 5 à 7 | Non vérifié | Apache 2.0 | Précision maximale | Texte, image |
Caractéristiques techniques des modèles, débit et capacités par plateforme
Quel modèle pour quelle situation ?
Si vous effectuez un déploiement sur un Raspberry Pi 5 doté de 8 Go de RAM, optez pour un modèle modeste. La mémoire est la ressource limitante, et le débit détermine si votre application offre une expérience interactive. Gemma 4 E2B est un choix judicieux, avec environ 7,6 tok/s, tout en vous offrant des capacités natives d'entrée multimodale et d'appel de fonctions. Qwen3-4B offre un débit d’environ 5 à 7 tok/s, mais il propose la meilleure précision d’appel d’outils prête à l’emploi et prend en charge plus de 100 langues. Gemma 4 E4B fonctionne techniquement sur ce matériel, mais son recours à la mémoire swap réduit le débit à environ 2 à 5 tok/s, ce qui rend difficile de le recommander pour des charges de travail interactives.
Le Jetson Orin Nano redéfinit les compromis. L’accélération par GPU élimine bon nombre des contraintes de mémoire et de calcul qui pèsent sur le Raspberry Pi 5. Le Gemma 4 E4B devient ainsi une option viable, atteignant environ 11 à 14 tok/s tout en conservant ses capacités multimodales natives, l’appel de fonctions et sa fenêtre de contexte de 128 Ko. Si votre application repose sur l’utilisation d’outils, le Qwen3 reste également un excellent choix, bien que les chiffres de débit vérifiés pour le Jetson ne soient pas encore disponibles. Le Phi-4-Mini est une excellente option pour les agents nécessitant un raisonnement intensif, mais vous devriez vérifier les performances sur votre matériel cible avant de passer en production.
Sur les serveurs en périphérie ou les systèmes tels que le Mac Mini M4 doté de 16 à 32 Go de mémoire unifiée, le choix du modèle dépend davantage de l’ charge de travail que du matériel. Optez pour le Phi-4-Mini pour le raisonnement et la génération de code, pour le Gemma 4 E4B pour les applications d’IA multimodales, et pour le Qwen3 lorsque la fiabilité de l’appel d’outils et l’ support multilingue constituent les priorités absolues. À ce niveau de matériel, il n’y a pas de gagnant incontestable, car chaque modèle optimise une capacité différente.
La quantification a autant d'impact sur l'déploiement que le choix du modèle. Pour la plupart des matériels en périphérie, le paramètre Q4_K_M offre le meilleur compromis entre utilisation de la mémoire, débit et qualité. Il préserve environ 97 à 99 % de la qualité FP16 tout en réduisant les besoins en mémoire et en améliorant la vitesse d'inférence. Si votre charge de travail implique un raisonnement sensible à la précision ou la génération de code, et si votre matériel dispose d'une mémoire suffisante, il est généralement intéressant d'essayer les paramètres Q5_K_M ou Q8_0.
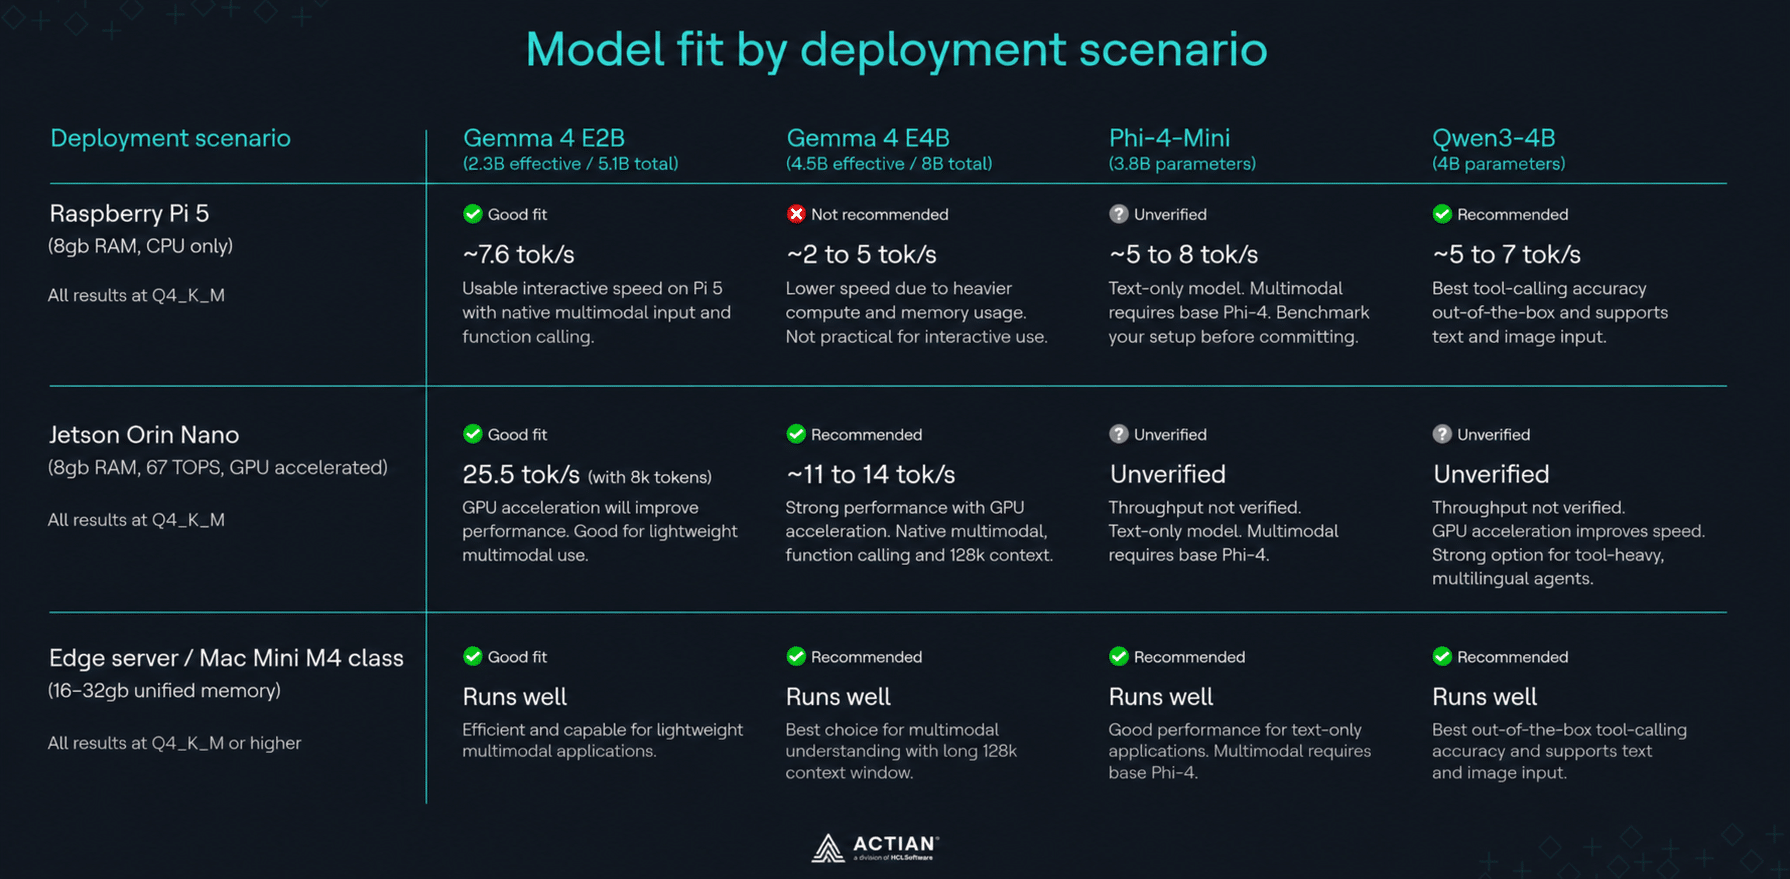
Ajustement du modèle selon le scénario « déploiement »
Ce que cette comparaison ne prend pas en compte
Le choix du bon modèle n’est que la première étape dans la création d’un système d’ agents IA s embarqué. Une fois que vous avez sélectionné un modèle et un niveau de quantification adaptés à votre matériel, la décision suivante consiste à déterminer comment votre agent va récupérer et mémoriser les informations. C’est là que la couche de récupération prend autant d’importance que la couche d’inférence.
La génération assistée par recherche (RAG) associe un modèle d'inférence à un magasin de vecteurs qui récupère les informations pertinentes avant la génération. Il s’agit de composants distincts ayant des besoins en ressources différents. Un modèle qui s’inscrit parfaitement dans votre budget matériel peut tout de même afficher de mauvaises performances si la couche de recherche consomme trop de mémoire ou d’espace de stockage.
À ce stade, trois options s'offrent à vous pour l'déploiement :
- in-memory récupération. Les représentations restent en mémoire vive (RAM), ce qui garantit une latence de récupération minimale. Cependant, toutes les données indexées sont perdues au redémarrage de l’application.
- Base de données de vecteurs d'Embarqué s basée sur un système de fichiers. Les représentations sont stockées sur disque, ce qui garantit leur persistance sans nécessiter de serveur distinct. Cette option est particulièrement adaptée aux périphériques en périphérie disposant de ressources limitées.
- Base de données vectorielle locale dédiée. Une base de données locale gère l'indexation, le filtrage et la recherche à l'échelle de la production, parallèlement au processus d'inférence. Cette approche prend en charge des charges de travail de recherche plus importantes jeux de données et plus avancées, mais nécessite des ressources système supplémentaires.
Le choix approprié dépend de la taille de votre base de connaissances, de vos exigences en matière de latence et des ressources matérielles disponibles après l'inférence du modèle.
Pour conclure
Phi-4-Mini, Gemma 4 et Qwen3 ont chacun trouvé un rôle bien défini dans les déploiements d'IA en périphérie. Gemma 4 est le choix le plus judicieux lorsque votre application repose sur des entrées multimodales natives et de longues fenêtres de contexte. Phi-4-Mini privilégie la qualité du raisonnement et le débit pour les charges de travail liées à la planification et à la génération de code. Qwen3 se distingue pour les agents IA en production qui nécessitent un appel d’outils fiable et une large cap support multilingue. Plutôt que de rechercher un seul gagnant, adaptez le modèle à votre matériel, à votre objectif de latence et à vos besoins en matière d’ charge de travail.
Le matériel est tout aussi important que le choix du modèle. Un Raspberry Pi 5 doté de 8 Go de RAM est particulièrement adapté aux modèles plus petits et quantifiés de manière efficace, tandis que le Jetson Orin Nano permet d’utiliser de manière pratique des modèles plus volumineux, tels que le Gemma 4 E4B, grâce à l’accélération par GPU. Sur les serveurs en périphérie et les systèmes disposant de 16 à 32 Go de mémoire unifiée, c’est votre « charge de travail » qui devient le facteur déterminant, et non plus les contraintes matérielles. Dans tous les cas, le niveau de quantification et l’architecture de recherche déterminent les performances de votre application.
Commencez dès aujourd'hui à utiliser Actian VectorAI DB Community Edition. Consultez la documentation et rejoignez la communauté Discord pour obtenir de l'support s et participer aux discussions.
Foire aux questions (FAQ)
Puis-je faire tourner tous les modèles sur un Raspberry Pi 5 doté de 8 Go de RAM ?
Oui, mais les performances varient considérablement. Le Gemma 4 E2B fonctionne à environ 7,6 tok/s et convient à une utilisation interactive. Le Gemma 4 E4B fonctionne également, mais un recours intensif à la mémoire swap réduit le débit à environ 2 à 5 tok/s, ce qui le rend trop lent pour les charges de travail conversationnelles. Qwen3-4B atteint environ 5 à 7 tok/s, ce qui est acceptable pour une utilisation interactive et offre la meilleure précision d’appel d’outils parmi les trois. Phi-4-Mini atteint environ 5 à 8 tok/s.
Et si j'avais besoin à la fois d'support s multilingues et d'appels de fonction ?
Optez pour Qwen3. Il offre la plus grande précision d’appel d’outils dès son installation et prend en charge plus de 100 langues. Gemma 4 intègre l’appel de fonctions en natif, mais n’égale pas les capacités multilingues de Qwen3. Phi-4-Mini privilégie le raisonnement plutôt que l’utilisation d’outils.
Le modèle Q4_K_M est-il suffisamment performant pour la production ?
Pour la plupart des déploiements en périphérie, oui. Q4_K_M conserve environ 97 à 99 % de la qualité FP16 tout en réduisant l'utilisation de la mémoire et en multipliant le débit par deux ou trois. Optez pour Q5_K_M ou Q8_0 pour les charges de travail sensibles à la précision, telles que la génération de code ou le raisonnement complexe, lorsque votre matériel dispose d'une mémoire suffisante.
Problèmes courants
Le modèle dépasse la mémoire vive disponible au quatrième trimestre
Optez pour une variante de modèle plus petite si la qualité est votre priorité. Si vous devez conserver le même modèle, utilisez un niveau de quantification plus agressif, tel que Q3_K_M, mais attendez-vous à une baisse plus importante de la qualité du raisonnement.
Artefacts de quantification dans les résultats de raisonnement
Utilisez Q5_0 ou Q8_0 pour le raisonnement et la génération de code si la mémoire le permet. Q4_K_M est le meilleur choix pour l'inférence générale, où le débit et l'efficacité mémoire priment sur la précision maximale.
Les appels aux outils sont lents ou mal formés
Vérifiez que votre instruction respecte le format d'appel d'outils attendu par le modèle. Si la fiabilité est essentielle, optez pour Qwen3, qui offre, parmi les trois modèles, les meilleures performances d'appel d'outils prêtes à l'emploi.
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
