

Wie wir die Entitätsauflösung mit einer Vektordatenbank und Argon durchgeführt haben


Wichtigste Erkenntnisse
- VectorAI DB filtert bei jedem „ Aufzeichnung “ die 10 nächsten Nachbarn heraus, wodurch die Anzahl der möglichen Paare bei „Abt-Buy“ von 1.180.452 auf 10.810 reduziert wird, während 99 % der echten Übereinstimmungen erhalten bleiben.
- Ein Ähnlichkeitsschwellenwert filtert die eindeutigen Paare heraus, und Gemini 4 Argon überprüft nur den unsicheren Bereich von 13,2 % und gibt eine Übereinstimmungsentscheidung mit einer Begründung in einem Satz aus.
- Die Pipeline erhöht den F1-Wert bei Abt-Buy von 0,813 auf 0,915 und die Präzision auf 0,998 – bei Kosten von etwa 0,76 US-Dollar pro 1.000 Datensätze.
- Der Argon-Durchlauf zahlt sich aus, wenn die Band den Großteil der Fehler des Schwellenwerts abdeckt und Argon bei diesen Paaren um mindestens etwa 10 Punkte genauer ist.
- VectorAI DB und das Einbettungsmodell laufen auf Ihrer eigenen Infrastruktur, sodass lediglich das Unsicherheitsband Ihr Netzwerk verlässt.
Irgendwo in Ihrer Kunden-, Lieferanten- oder Produkttabelle ist derselbe Eintrag doppelt aufgeführt. Im Abt-Buy-Benchmark wird ein Fernseher in einem Katalog als „Sharp AQUOS 37′ Black LCD HDTV – LC37D64U“ bezeichnet, im anderen hingegen als „Sharp AQUOS LC-37D64U 37′ LCD TV“. Das Auffinden solcher Paare wird als Entitätsauflösung bezeichnet – und das wird sehr schnell sehr schwierig. Jeden „ Aufzeichnung “ mit jedem anderen zu vergleichen, bedeutet bei einer Million Zeilen etwa 500 Milliarden Abgleiche. Auch Ähnlichkeitswerte versagen bei knappen Fällen. Derselbe Katalog verkauft einen „LC37D44U“ – ein Zeichen Unterschied und ein anderer Fernseher –, und unser Einbettungsmodell bewertete ihn höher als das richtige Modell.

Also haben wir die Arbeit aufgeteilt. VectorAI DB grenzt jeden „ Aufzeichnung “ auf seine 10 nächsten Nachbarn ein, wodurch Abt-Buy von 1.180.452 möglichen Paaren auf 10.810 reduziert wurde und 99 % der tatsächlichen Übereinstimmungen erhalten blieben. Ein Ähnlichkeitsschwellenwert sorgt für eindeutige Entscheidungen. Die unsicheren 13,2 % werden an Gemini 4 Argon weitergeleitet, ein Google-Gemini-Modell, das beide Datensätze auswertet und eine Übereinstimmung oder keine Übereinstimmung mit einer einzeiligen Begründung zurückgibt. Wir haben es für dieses Experiment ausgewählt, da es JSON-Daten zurückgibt, die einem Schema entsprechen, man die Rechenleistung begrenzen kann und es die Teilenummer lesen kann, die durch das Embedding unscharf dargestellt wird.
Der Schwellenwert allein erreichte einen F1-Wert von 0,813 (der F1-Wert bildet ein Gleichgewicht zwischen Präzision und Recall). Mit Argon für die unsicheren Paare stieg der F1-Wert auf 0,915 und die Präzision auf 0,998 – bei Kosten von 0,76 $ pro 1.000 Datensätze im Test-Split. In diesem Artikel werden Sie diese Pipeline Schritt für Schritt aufbauen. Sie lernen, wie Sie Datensätze mit einer gefilterten Nearest-Neighbor-Suche in VectorAI DB aussortieren und den K-Wert anhand des Reduktionsverhältnisses und der Paarkomplettheit festlegen. Außerdem legen Sie den Schwellenwertbereich anhand Ihrer eigenen Daten fest und testen, ob sich der Einsatz von Argon lohnt, bevor Sie Geld dafür ausgeben.
TL;DR
- Filterung: VectorAI DB behielt 10.810 der 1.180.452 möglichen Abt-Buy-Paare bei, entfernte damit 99,08 % und behielt 99,0 % der tatsächlichen Übereinstimmungen bei.
- Nur Schwellenwert: F1 0,813.
- Mit Argon auf der unbestimmten Bande: F1 0,915, Präzision 0,998.
- An Argon gesendet: 13,2 % der Kandidatenpaare, 1.001 von 7.570 im Test-Split.
- Kosten: 1,41 $ gemäß den Tarifen von OpenRouter oder 0,76 $ pro 1.000 Datensätze im Test-Split (757 „Abt“-Datensätze plus alle 1.092 „Buy“-Datensätze).
- Wann es sich lohnt: Wenn das Band den Großteil der Fehler des Schwellenwerts abdeckt und Argon Bandpaare deutlich besser unterscheidet als der Schwellenwert. In unseren Bandbreitentests brachte der Ausschnitt, in dem Argon den Schwellenwert um 12 Punkte übertraf, 1,5 F1-Punkte ein; Ausschnitte, in denen der Vorsprung bei etwa 1 Punkt lag, brachten fast nichts ein.
Voraussetzungen
- Docker mit dem Compose-Plugin.
- uv, der Paketmanager von „ Python “, der eine kompatible Version von „ Python “ für Sie installiert. Der Befehl zur Installation finden Sie unterhalb dieser Liste.
- Ollama, um das Einbettungsmodell lokal auszuführen.
- Ein Gemini-4-Argon-Schlüssel: ein OpenRouter-Schlüssel mit einem Guthaben von einigen Dollar oder ein Google-AI-Studio- bzw. Google- Cloud -Schlüssel mit aktivierter Abrechnung. Argon bietet keine kostenlose Nutzungsstufe an; der Abt-Buy-Lauf kostete 1,41 US-Dollar.
- VectorAI DB, ohne separate Installation: In Schritt 1 wird die Community Edition in Docker ausgeführt. Jeder Benchmark passt unter die Obergrenze von 5.000 Vektoren, wobei jeweils nur ein Benchmark gleichzeitig ausgeführt wird.
- Etwa 3 GB freier Speicherplatz für das Datenbank-Image und das Einbettungsmodell. Alles läuft auf einem „ CPU “; eine GPU wird nicht benötigt.
Installiere uv, falls du es noch nicht hast
# macOS or Linux
curl -LsSf https://astral.sh/uv/install.sh | sh

# Windows (PowerShell)
irm https://astral.sh/uv/install.ps1 | iex
Der gesamte Code befindet sich im zugehörigen Repository, und in Schritt 1 wird dieses geklont. Sie haben es eilig? Befolgen Sie die Schritte 1 bis 3 und fahren Sie dann mit Schritt 8 fort.
Was du baust
Die Entitätsauflösung, auch als „ Aufzeichnung -Verknüpfung“ oder „Entitätsabgleich“ bezeichnet, erfolgt in drei Schritten. Beim „Blocking“ wird die Anzahl der Paare auf eine Auswahl von Kandidaten reduziert. Beim „Comparison“ wird jeder Kandidat bewertet, häufig mithilfe eines unscharfen Abgleichs von Namen und Feldern. Der „Matching“-Schritt trifft die endgültige Entscheidung. In dieser Version verfügt jeder Schritt über ein eigenes Tool:
- VectorAI DB übernimmt die Filterung. Für jeden „ Aufzeichnung “ gibt es die nächsten Nachbarn aus der anderen Tabelle zurück – also die Datensätze, deren Einbettungen am nächsten liegen –, sodass die Pipeline pro „ Aufzeichnung “ 10 Kandidaten bewertet, anstatt jedes mögliche Paar.
- EmbeddingGemma, das lokal über Ollama ausgeführt wird, wandelt jedes „ Aufzeichnung “ in einen 768-dimensionalen Vektor um.
- Ein Ähnlichkeitsschwellenwert ordnet Paare mit hoher Übereinstimmungswahrscheinlichkeit automatisch zu und verwirft eindeutige Nichtübereinstimmungen.
- Gemini 4 Argon entscheidet über den ungewissen Bereich dazwischen und gibt eine Begründung in einem Satz an.
resolve.pyvergleicht diese miteinander und bewertet die Ergebnisse anhand der bekannten Übereinstimmungen des Benchmarks.
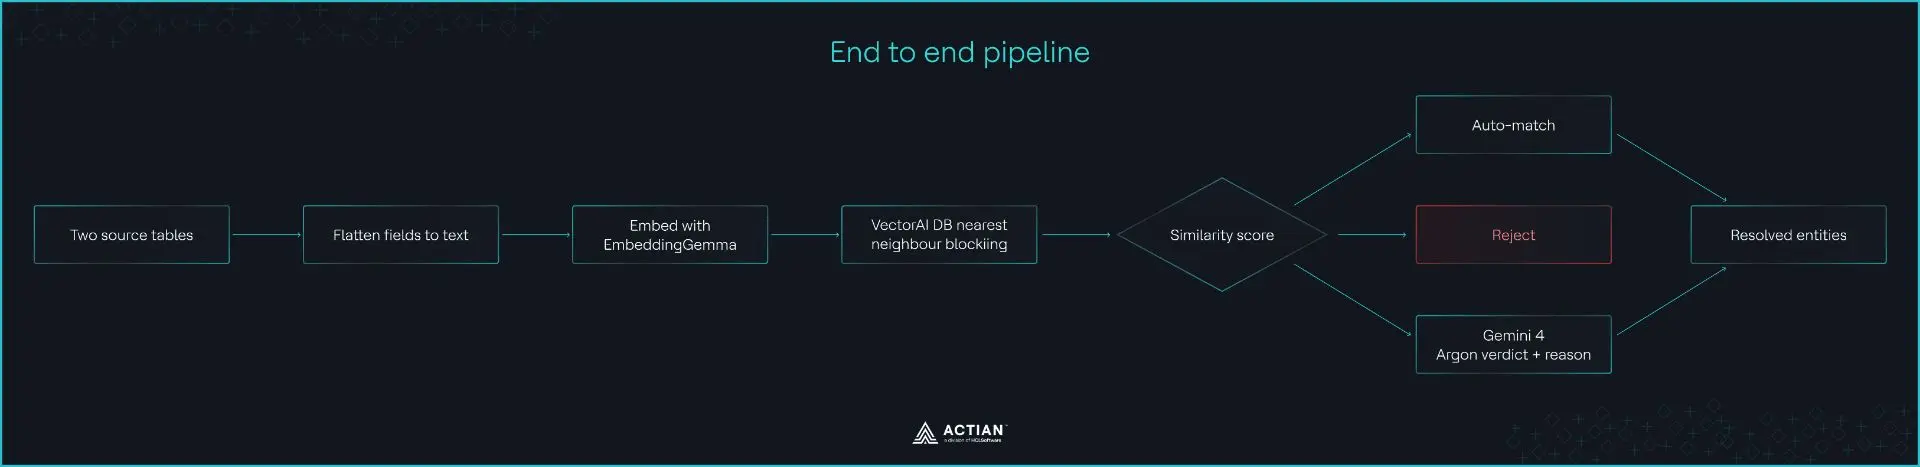
Der Prozessablauf: Die Datensätze werden in der VectorAI-Datenbank unter eingebettet gespeichert und gesperrt, und der Ähnlichkeitswert leitet jedes Kandidatenpaar entweder an einen automatischen Abgleich, eine Ablehnung oder an Argon weiter.
In den Beispielen wird „Abt-Buy“ verwendet, ein Standard-Benchmark für den Datenabgleich aus der Leipziger Sammlung: 1.081 Abt-Produkte und 1.092 Buy-Produkte, wobei eine Referenzdatei die 1.097 echten Übereinstimmungen auflistet. Ein Vergleich jedes Abt- Aufzeichnung s mit jedem Buy- Aufzeichnung würde 1.081 × 1.092 = 1.180.452 Paare ergeben.
Schritt 1: VectorAI DB starten
Klonen Sie das zugehörige Repository und wechseln Sie in den Projektordner. Alle folgenden Befehle werden in diesem Ordner ausgeführt:
git clone https://github.com/actian-devs/developer-content.git
cd developer-content/blog/entity-resolution-vectorai
Die Datei „docker-compose.yml“ des Repos startet die VectorAI-Datenbank. Die Zeile „ACTIAN_VECTORAI_ACCEPT_EULA=YES“ akzeptiert die Lizenz von Actian in Ihrem Namen. Lesen Sie diese daher bitte durch, bevor Sie den Container starten:
services:
  vectorai:
    image: actian/vectorai:1.0.2
    container_name: vectorai
    ports:
      - "6573:6573" # REST
      - "6574:6574" # gRPC (Python SDK)
      - "6575:6575" # Local UI
    volumes:
      - ./vectorai_data:/var/lib/actian-vectorai
    environment:
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    restart: unless-stopped
Los geht’s:
docker compose up -d
docker ps
Der Container sollte nun angezeigt werden. Das „ Python “-SDK kommuniziert über gRPC mit ihm auf port 6574.
Die Obergrenze von5.000 Vektoren der Community Editiongilt für den gesamten Server, und gelöschte Vektoren wurden weiterhin auf diese Obergrenze angerechnet, bis wir den Container neu gestartet haben. Das Test-Framework löscht seine eigenen alten Sammlungen; falls die Obergrenze weiterhin gemeldet wird, führen Sie den Befehl „docker compose restart vectorai“ aus.
Schritt 2: Das Einbettungsmodell abrufen
Installieren Sie Ollama und laden Sie anschließend EmbeddingGemma herunter (ca. 620 MB):
ollama pull embeddinggemmaOllama stellt es unter localhost:11434 bereit, und der Harness ruft es dort auf. Zu diesem Zeitpunkt verlässt noch nichts Ihren Rechner.
Schritt 3: Installieren Sie die Abhängigkeiten von „ Python “
Das Repo enthält bereits die Datei „pyproject.toml“, die nachfolgend zur Veranschaulichung aufgeführt ist. In der Datei „uv.lock“ sind die genauen Versionen festgehalten, die wir verwendet haben, beispielsweise „actian-vectorai-client“ 1.0.3 und „google-genai “ 2.31.0:
[project]
name = "entity-resolution-vectorai"
version = "0.1.0"
description = "Entity resolution with VectorAI DB blocking and Gemini 4 Argon on the ambiguous band"
requires-python = ">=3.11,<3.14"
# uv run resolve.py reads this, creates .venv and installs these on first run
dependencies = [
    "actian-vectorai-client",  # VectorAI DB client (gRPC)
    "google-genai",            # Gemini API, for the Argon pass
    "pandas",
    "numpy",
    "pydantic",                # Argon's structured-output schema
    "requests",                # benchmark download
    "matplotlib",              # score-distribution chart
]

[project.optional-dependencies]
st = ["sentence-transformers"]   # in-process embedding models: uv sync --extra st, then --embed-backend sentence-transformers
Die Umgebung erstellen:
uv syncBeginnen Sie von nun an jeden Befehl mit „uv run“; Sie müssen keine Umgebung mehr aktivieren.
Schritt 4: Laden und „ einbetten “ der Datensätze
Die Quelltabelle fließt in die Nutzdaten jedes Punktes ein, da in Schritt 5 danach gefiltert wird; somit wird ein „Abt“- Aufzeichnung immer nur mit „Buy“-Datensätzen verglichen. Das Einbetten ist der langsamste Schritt bei einem „ CPU “ – das Test-Harness speichert die Vektoren im Cache, und bei erneuten Ausführungen wird dieser Schritt übersprungen. Der folgende Code bildet den Kern von drei Funktionen im Repository load() in er/data.py Erstellt Datensätze, eine Liste von Tupeln (Quelle, Aufzeichnung_id, Text), wobei die Abt-Datensätze an erster Stelle stehen embed() befindet sich in er/embed.pyund der „Upsert“ lautet load_records() in er/block.py.
import numpy as np
import requests
from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams

def to_text(row, fields):
    # "name: Sony Bravia 40in LCD TV | price: $899.99" (empty fields are skipped)
    return " | ".join(f"{f}: {row[f].strip()}" for f in fields if row[f].strip())

def embed(texts, model="embeddinggemma", url="http://localhost:11434", batch=64):
    out = []
    for i in range(0, len(texts), batch):
        r = requests.post(f"{url}/api/embed", json={"model": model, "input": texts[i:i + batch]}, timeout=600)
        r.raise_for_status()
        out.extend(r.json()["embeddings"])
    v = np.asarray(out, dtype=np.float32)
    return v / np.linalg.norm(v, axis=1, keepdims=True)   # unit length, so cosine score = dot product

vectors = embed([text for , , text in records])          # records: (source, record_id, text)

with VectorAIClient("localhost:6574") as db:
    if db.collections.exists("er_abt_buy"):   # start clean, so the step can be rerun
        db.collections.delete("er_abt_buy")
    db.collections.create("er_abt_buy", vectors_config=VectorParams(
        size=vectors.shape[1], distance=Distance.Cosine))
    points = [PointStruct(id=i, vector=v.tolist(), payload={"source": src, "record_id": rid, "text": t})
              for i, ((src, rid, t), v) in enumerate(zip(records, vectors))]
    for start in range(0, len(points), 500):   # upsert in batches
        db.points.upsert("er_abt_buy", points[start:start + 500])
Schritt 5: Blockieren mit VectorAI DB
Der Blocking- abfragen läuft einmal pro Abt- Aufzeichnung und fragt die K nächstgelegenen Buy-Datensätze ab, wobei ein „must“-Filter auf das Feld „source“ in der Nutzlast jedes Datensatzes angewendet wird. Hier gilt die Regel, dass eine Übereinstimmung immer einen Abt- Aufzeichnung mit einem Buy- Aufzeichnung verknüpft, sodass die Suche nur Datensätze aus der anderen Quelle zurückgeben sollte. Das Blocking bei vortrainierten Embeddings wie diesem wurde in großem Maßstab untersucht: Zeakis et al. Es wurden 12 Sprachmodelle anhand von 17 Benchmarks zur Entitätsauflösung bewertet, unter anderem hinsichtlich der Qualität ihrer Embeddings. Der Code knüpft an Schritt 4 an und bildet den Kern von neighbours() in er/block.py.
from actian_vectorai import Field, FilterBuilder, VectorAIClient

K = 10
TOTAL_RECORDS = len(records)   # Abt + Buy: a limit this high returns every Buy record
abt_ids = [rid for src, rid,  in records if src == "abt"]
abtvectors = vectors[:len(abt_ids)]   # records lists every Abt record first
other_source = FilterBuilder().must(Field("source").eq("buy")).build()

def search(db, vectors, limit):
    out = []
    for i in range(0, len(vectors), 100):   # search_batch takes up to 100 queries per call
        out += db.points.search_batch("er_abt_buy", [
            {"vector": v.tolist(), "limit": limit, "filter": other_source, "with_payload": True}
            for v in vectors[i:i + 100]])
    return out

ranked, todo, limit = {}, list(range(len(abt_ids))), K  10   # over-fetch, then keep the top K
with VectorAIClient("localhost:6574") as db:
    while todo:
        short = []
        for i, hits in zip(todo, search(db, abt_vectors[todo], limit)):
            ranked[abt_ids[i]] = sorted(((h.payload["record_id"], h.score) for h in hits),
                                        key=lambda x: -x[1])[:K]
            if len(hits) < K and limit < TOTAL_RECORDS:   # stop once the limit covers the table
                short.append(i)
        todo, limit = short, min(limit  4, TOTAL_RECORDS)   # retry any record still short
Übermäßiges Abrufen beim Filtern. Wir haben dies auf VectorAI DB 1.0.2 mit dem 1.0.3- Python -Client und allen 2.173 Abt-Buy-Datensätzen in einer Sammlung gemessen. Ein search_batch-Aufruf mit limit=10 und dem Filter „source = buy“ lieferte für 1.075 der 1.081 Abt-Datensätze zu wenige Ergebnisse, mit durchschnittlich 3,9 Ergebnissen. Eine ungefilterte Suche nach den 10 nächsten Datensätzen lieferte in 75,5 % der Fälle Abt-Datensätze. Die gefilterten Ergebnisse entsprachen also den „Buy“-Datensätzen unter den insgesamt ungefähr „limit“ nächsten Datensätzen, nicht den 10 nächsten „Buy“-Datensätzen. Laut der Anleitung zu den Prädikatsfiltern der VectorAI DB werden Filter während der Suche angewendet; betrachten Sie dies daher als das Verhalten von Version 1.0.2 in unserer Sammlung und nicht als dokumentiertes Verhalten.
Erziehung hnsw_ef, die Suchbreite des HNSW-Index auf 256 zu setzen, änderte nichts. Ein Payload-Index für die Quelle kam nicht in Frage: Version 1.0.2 lehnt das Hinzufügen eines solchen zu einer bestehenden Sammlung ab („dynamische Indexerstellung noch nicht implementiert“), und der Python -Client der Version 1.0.3 verfügt über keine Einstellung, um einen solchen bei der Erstellung der Sammlung anzugeben. Die Angabe von 10 × K bei gleichbleibendem Top-K-Wert löste das Problem: Jede „ Aufzeichnung “ erhielt ihre 10 Kandidaten, und 99,95 % davon stimmten mit einer exakten Brute-Force-Suche überein.
Bei Kunden- oder Lieferantendaten kann die „same“-Klausel Regeln enthalten, die ein Paar vollständig ausschließen, wie beispielsweise ein anderes Land oder eine Person im Gegensatz zu einem Unternehmen. „Should“-Klauseln können Kandidaten bevorzugen, die ein gemeinsames Merkmal aufweisen, wie beispielsweise eine Postleitzahl, ohne die übrigen auszuschließen. Budget für denselben Over-Fetch: In Version 1.0.2 gilt: Je mehr Datensätze ein Filter ausschließt, desto weniger der nächstgelegenen Datensätze passieren ihn; erhöhen Sie daher das Limit, bis jeder „ Aufzeichnung “ sein K erhält.
Lies das Reduktionsverhältnis und die Paarvollständigkeit zusammen
Zwei Zahlen beschreiben das Blockieren, und jede für sich genommen führt in die Irre:
- Reduktionsverhältnis ist der Anteil aller Paare, die durch das Blockieren entfernt wurden: 1 − Kandidaten / alle Paare.
- Paarvollständigkeit ist der Anteil der echten Übereinstimmungen, die die Filterung überstanden haben: echte Übereinstimmungen unter den Kandidaten / alle echten Übereinstimmungen.
import pandas as pd

candidates = {(abt_id, buy_id): score for abt_id, hits in ranked.items() for buy_id, score in hits}
n_buy = len(records) - len(abt_ids)
gold = set(map(tuple, pd.read_csv("data/abt-buy/abt_buy_perfectMapping.csv").astype(str).values))
rr = 1 - len(candidates) / (len(abt_ids) * n_buy)
pc = len(gold & candidates.keys()) / len(gold)
Der Harness berechnet beides in blocking_quality() in er/block.py. Jede echte Übereinstimmung, bei der es zu einer Blockierung kommt, geht endgültig verloren, sodass die Paarkomplettheit die Rückholung für die gesamte Pipeline begrenzt. Wir haben K durchlaufen:
| K | Kandidatenpaare | Untersetzungsverhältnis | Paarvollständigkeit |
|---|---|---|---|
| 1 | 1,081 | 99.91% | 81.9% |
| 3 | 3,243 | 99.73% | 94.5% |
| 5 | 5,405 | 99.54% | 97.0% |
| 10 | 10,810 | 99.08% | 99.0% |
| 20 | 21,620 | 98.17% | 99.7% |
Wir haben K = 10 beibehalten. Dadurch wurden 99,08 % des Vergleichsraums eliminiert und 99,0 % der tatsächlichen Übereinstimmungen beibehalten. Bei K = 20 erhöht sich die Paarkomplettheit um 0,7 Punkte bei doppelt so vielen Kandidaten. Betrachten Sie diese beiden Zahlen als Abwägung, bevor Sie sich auf eine davon verlassen: Jeder Rückgang bei der Paarkomplettheit bedeutet einen eingesparten Vergleich und möglicherweise eine für immer verlorene Übereinstimmung. Wählen Sie den kleinsten K-Wert, dessen Paarkomplettheit für Sie akzeptabel ist, denn dieser Wert stellt die Obergrenze für den Recall bei jedem folgenden Schritt dar.
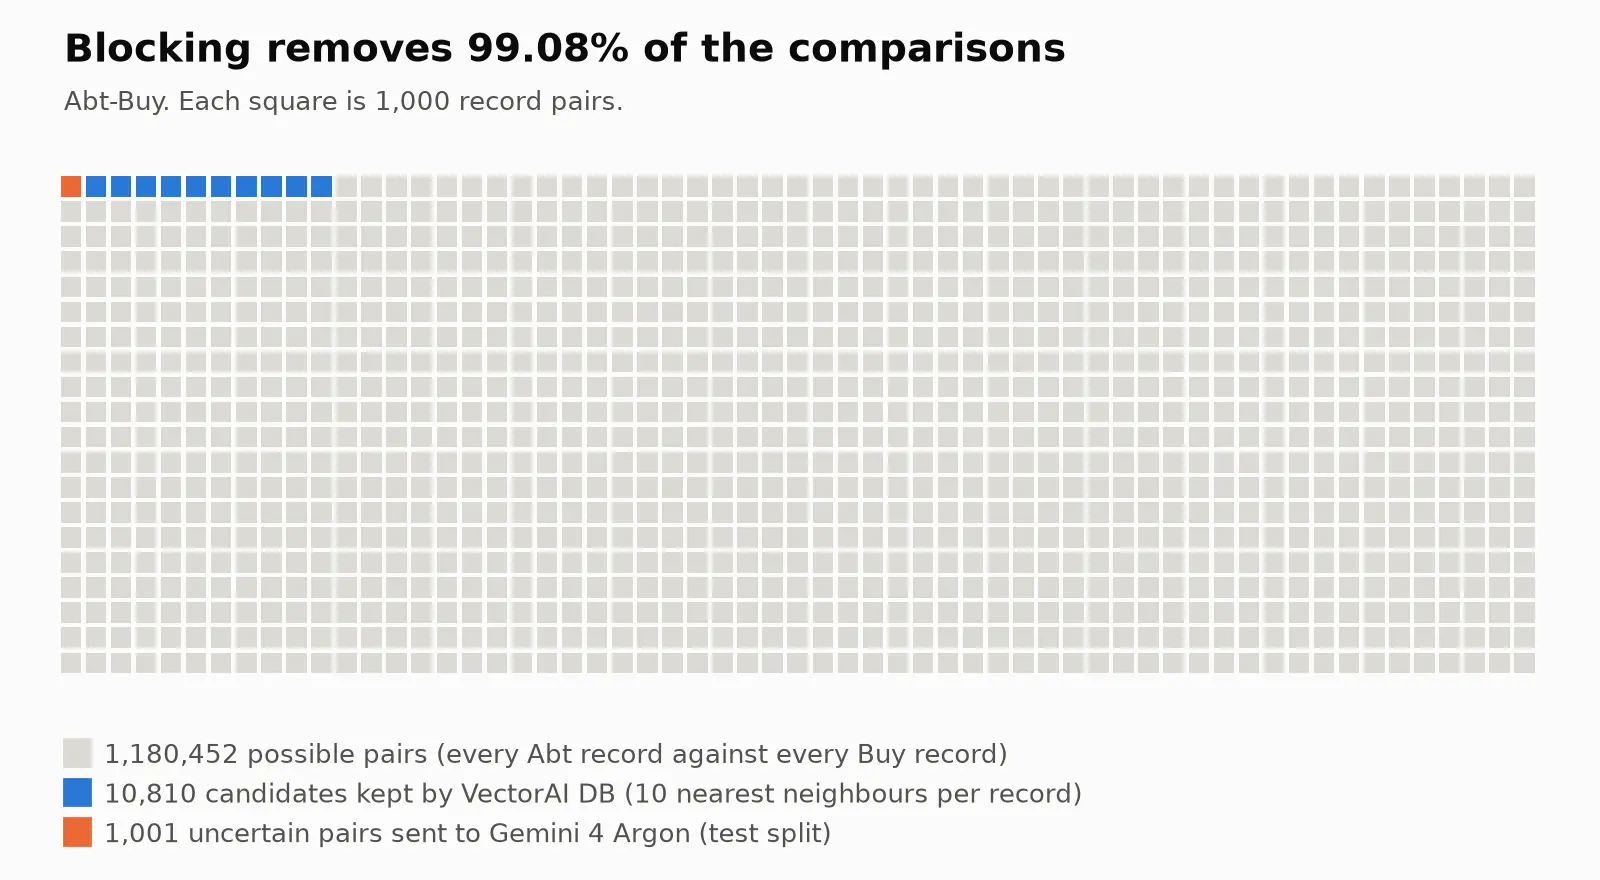
Der Vergleichsraum auf Abt-Buy: ein Quadrat pro 1.000 Paare. Die VectorAI-Datenbank behielt 10.810 der 1.180.452 möglichen Paare bei, und Argon las 1.001 davon aus.
Schritt 6: Bewerten Sie die Kandidaten und legen Sie die Punktbandbreite fest
Ein einziger Schwellenwert führt dazu, dass die eng verwandten Paare in beide Richtungen falsch erkannt werden; daher unterteilt die Pipeline die Kandidaten in drei Bereiche und leitet nur den mittleren an Argon weiter. Die Basislinie ist ein Schwellenwert für die beste Übereinstimmung: Jeder nächstgelegene Kandidat eines Abt- Aufzeichnungs gilt als Übereinstimmung, wenn seine Ähnlichkeit einen Schwellenwert überschreitet. Die Präzision ist der Anteil der vorhergesagten Übereinstimmungen, die tatsächlich zutreffen, der Recall ist der Anteil der tatsächlich gefundenen Übereinstimmungen, und der F1-Wert bildet ein Gleichgewicht zwischen beiden. Auf dem Abt-Buy-Testdatensatz lag der beste Schwellenwert bei 0,562: Präzision 0,820, Recall 0,806, F1 0,813. Ein globaler Schwellenwert für alle 10 Kandidaten pro Aufzeichnung erzielte lediglich 0,522.

Ähnlichkeit jedes „nächstgelegenen Kaufkandidaten“ eines Abt- Aufzeichnungs im Test-Split. Alle 136 falschen Übereinstimmungen liegen innerhalb des Bereichs zwischen 0,56 und 0,84, vermischt mit echten Übereinstimmungen, sodass sie sich nicht durch einen einzigen Schwellenwert abgrenzen lassen.
Wähle die Bandkanten aus den Daten aus
Wir haben 30 % der Abt-Datensätze als Entwicklungsstichprobe beiseite gelegt, den Schwellenwert sowie die beiden Extremwerte aus der Punktverteilung festgelegt und berichten nun über alle Ergebnisse der verbleibenden 70 %. Der folgende Code stammt aus er/bands.py, das auch die von ihm verwendeten Hilfsfunktionen enthält: info ordnet jeden Kandidaten seinem Rang und seiner Lücke zu (rank_and_gap()), dev_best speichert für jeden Entwicklungs Aufzeichnungen den nächstgelegenen Kandidaten (best_match()), und best_cutoff ist der Schwellenwert der Basislinie (best_threshold()). Die Kanten funktionieren wie folgt:
- Obergrenze: Der niedrigste Wert, ab dem die besten Übereinstimmungen im Entwicklungssplit eine Präzision von 95 % erreichen. Bessere Übereinstimmungen darüber werden automatisch zugeordnet.
- Untergrenze: Die höchste Punktzahl, unterhalb derer höchstens 5 % der echten Übereinstimmungen liegen, begrenzt auf den Schwellenwert der Baseline, sodass die Pipeline niemals ein Paar ablehnt, das die Baseline akzeptieren würde. Paare unterhalb dieses Werts werden abgelehnt.
- Knappe Ergebnisse: Ein Kandidat auf Platz zwei oder drei, dessen Punktzahl innerhalb von 0,03 seines „ Aufzeichnung“ liegt, wird ebenfalls in die Gruppe aufgenommen. Allein die Kandidaten mit den geringsten Abweichungen begrenzen die Wiederauffindbarkeit auf 82 %, da 18 % der echten Treffer nicht der Spitzenkandidat ihres „ Aufzeichnung“ sind.
import numpy as np

def band_edges(cand, gold, target_precision, max_miss):
    pairs = sorted(cand.items(), key=lambda kv: kv[1], reverse=True)
    s = np.array([score for , score in pairs])
    y = np.array([p in gold for p,  in pairs], dtype=float)
    precision_above = np.cumsum(y) / np.arange(1, len(y) + 1)
    ok = np.where(precision_above >= target_precision)[0]
    upper = s[ok.max()] if len(ok) else s[0] + 1e-9   # nothing reaches the target: auto-match nothing
    missed_below = (y.sum() - np.cumsum(y)) / y.sum()   # share of matches scoring below each position
    lower = s[np.where(missed_below <= max_miss)[0].min()]
    return float(min(lower, upper)), float(upper)

def near_tie_band(cand, info, lower, upper, max_rank=3, max_gap=0.03):
    band = []
    for pair, score in cand.items():
        rank, gap = info[pair]   # rank among the record's candidates, distance below its best
        if score < lower:
            continue
        if (rank == 1 and score < upper) or (2 <= rank <= max_rank and gap <= max_gap):
            band.append(pair)
    return band

lower, upper = band_edges(dev_best, dev_gold, target_precision=0.95, max_miss=0.05)
lower = min(lower, best_cutoff)   # never reject a pair the baseline accepts
band = near_tie_band(test_candidates, info, lower, upper)
Die Grenzen lagen bei 0,562 und 0,841. Das Band umfasste 1.001 der 7.570 Testkandidaten (13,2 %), und 206 der 279 Fehler der Basislinie lagen innerhalb dieses Bandes. Wenn Argon jedes Bandpaar korrekt entscheiden würde, könnte der Recall von 0,806 auf 0,897 steigen. Messen Sie diesen Anteil zunächst anhand Ihrer eigenen Daten: Ein einzelner Schwellenwert zwingt jedes enge Paar auf eine Seite, und nur die Fehler, die im Band landen, können an einen zweiten Durchlauf weitergeleitet werden. Wenn die meisten von ihnen anderswo landen, wird kein zweiter Durchlauf sie beheben können.
Was an der Schwelle falsch ist
Diese Paare stammen aus dem Band. Ihre Vektoren liegen nahe beieinander, und die richtige Antwort hängt von einem Detail ab, das bei der Einbettung verwischt wird. Die Tabelle enthält ausschließlich Produktnamen. Das Harness-System bettet jedes Feld jedes „ Aufzeichnung “ ein und sendet es anschließend an Argon: Name, Beschreibung und Preis für „Abt“ sowie Name, Beschreibung, Hersteller und Preis für „Buy“.
| Aufzeichnung A (Abt) | Aufzeichnung B (Kaufen) | Ergebnis | Wahrheit | Baseline sagt |
|---|---|---|---|---|
| Sharp AQUOS 37′ LCD-HD-Fernseher, schwarz – LC37D64U | Sharp AQUOS LC37D44U 37′ LCD-Fernseher – LC37D44U | 0.832 | Keine Übereinstimmung | Spiel |
| Sharp AQUOS 37′ LCD-HD-Fernseher, schwarz – LC37D64U | Sharp AQUOS LC-37D64U 37′ LCD-Fernseher | 0.814 | Spiel | Keine Übereinstimmung (2. Kandidat) |
| Omnimount Wandhalterung für Lautsprecher – 20WLBK | OmniMount-Lautsprecherhalterung aus Edelstahl – 20,0 WALL-W | 0.830 | Keine Übereinstimmung | Spiel |
| Omnimount Wandhalterung für Lautsprecher – 20WLBK | OmniMount Universal-Wandhalterungsset für Lautsprecher – 20.0 WALL-B | 0.829 | Spiel | Keine Übereinstimmung (2. Kandidat) |
| Garmin-Saugnapfhalterung für Fahrzeuge, verstellbar – 0101082303 | Garmin-Saugnapfhalterung für das Auto | 0.832 | Keine Übereinstimmung | Spiel |
Das richtige Modell „ Aufzeichnung “ ist oft der zweite Kandidat, direkt unter einem fast identischen falschen Modell: Das korrekte Modell „Sharp LC-37D64U“ liegt 0,018 Punkte unter dem Modell „LC37D44U“. Beide Modelle erfüllen alle Grenzwerte. Die Modellnummer ist der deutlichste Unterschied, und die Beschreibungen liefern weitere Hinweise, wie beispielsweise ein Kontrastverhältnis von 10.000:1 gegenüber 7.500:1. Hier ist das erste Paar, wie es das Einbettungsmodell und Argon sehen:
Record A (Abt): name: Sharp AQUOS 37' Black LCD HDTV - LC37D64U | description: Sharp AQUOS 37' Black LCD HDTV - LC37D64U/ 1920 x 1080p Pixel Resolution/ Up To 60,000 Hours Lamp Life/ Built-In ATSC/QAM/NTSC Tuner/ 10,000:1 Dynamic Contrast Ratio/ 4ms Response Time/ 4-Wavelength Backlight System/ Black Finish

Record B (Buy): name: Sharp AQUOS LC37D44U 37' LCD TV - LC37D44U | description: Sharp AQUOS LC-37D44U - 37' Widescreen LCD HDTV - 7500:1 Dynamic Contrast Ratio - 6ms Response Time | manufacturer: Sharp
Schritt 7: Das Band an Argon senden
Jedes Bandpaar wird an Argon gesendet und kommt als „Übereinstimmung“ oder „Keine Übereinstimmung“ mit einer einzeiligen Begründung zurück. Die Antwort ist eine strukturierte Ausgabe im JSON-Format, die einem Schema entspricht, sodass Sie nichts manuell parsen müssen. Ein allgemeines Modell kann diesen Schritt ohne „ Training “-Daten ausführen: Peeters, Steiner und Bizer Es hat sich gezeigt, dass die besten LLMs bei wenigen oder gar keinen Beispielen mit vortrainierten Sprachmodellen mithalten können, die anhand Tausender beschrifteter Paare feinabgestimmt wurden. Die unten aufgeführte Eingabeaufforderung und das Schema stammen aus dem Repository und wurden auf den Entwicklungssplit angepasst; der Code bildet den Kern der Klasse „Adjudicator“ in der Datei „er/adjudicate.py“. Dieser Codeausschnitt ruft die Gemini-API direkt auf mit GEMINI_API_KEY; der Kabelbaum kann über OpenRouter ebenfalls an dasselbe Modell angeschlossen werden.
import json
from google import genai
from google.genai import types
from pydantic import BaseModel

class Verdict(BaseModel):
    match: bool
    reason: str   # one sentence, logged for audit

PROMPT = """You are resolving product records from two catalogues.
Decide whether Record A and Record B describe the same product: same model, size, and variant.
Answer from the records only. Give a one-sentence reason.

Record A: {a}
Record B: {b}"""

client = genai.Client()   # reads GEMINI_API_KEY from the environment

def adjudicate(a_text: str, b_text: str) -> tuple[Verdict, int, int]:
    resp = client.models.generate_content(
        model="gemini-4-argon",
        contents=PROMPT.format(a=a_text, b=b_text),
        config=types.GenerateContentConfig(
            response_mime_type="application/json",
            response_schema=Verdict,
            temperature=0,
            thinking_config=types.ThinkingConfig(thinking_level="LOW"),
        ),
    )
    usage = resp.usage_metadata
    # thinking tokens are billed at the output rate, so count them with the visible answer
    out_tokens = (usage.candidates_token_count or 0) + (usage.thoughts_token_count or 0)
    return Verdict.model_validate_json(resp.text), usage.prompt_token_count or 0, out_tokens
Jedes Urteil wird zusammen mit der Begründung in ein Protokoll eingetragen, sodass man später, falls eine Zusammenführung in Frage gestellt wird, nachweisen kann, warum Argon diese Entscheidung getroffen hat. Die Schleife überspringt Paare, die bereits im Protokoll enthalten sind, sodass bei einer erneuten Ausführung niemals zweimal gezahlt wird; das Test-Harness fügt zusätzlich Wiederholungsversuche für Ratenbegrenzungen hinzu:
import os

text_of = {(src, rid): text for src, rid, text in records}

os.makedirs("results", exist_ok=True)
log_path = "results/argon_verdicts.jsonl"
done = set()
if os.path.exists(log_path):   # pairs already paid for on an earlier run
    with open(log_path) as f:
        done = {(r["abt"], r["buy"]) for r in map(json.loads, f)}

tokens_in = tokens_out = 0
with open(log_path, "a") as log:
    for abt_id, buy_id in band:
        if (abt_id, buy_id) in done:
            continue
        verdict, t_in, t_out = adjudicate(text_of["abt", abt_id], text_of["buy", buy_id])
        tokens_in += t_in
        tokens_out += t_out
        log.write(json.dumps({"abt": abt_id, "buy": buy_id, **verdict.model_dump()}) + "\n")
        log.flush()   # a crash mid-run keeps every verdict written so far
Die Abfragen in diesem Artikel wurden über OpenRouter an Argon weitergeleitet, das sie an die Endpunkte von Google weiterleitet und die genauen Kosten pro Aufruf meldet. Die Einstellung „Thinking“ war auf „LOW“ gesetzt, da Thinking-Token in Rechnung gestellt werden und eine Übereinstimmungsentscheidung keine tiefgreifende Argumentation erfordert.
Legen Sie Ihren Schlüssel fest, bevor Sie den Harness ausführen – in der Umgebung und niemals im Code. Der obige Codeausschnitt lautet GEMINI_API_KEY Das OpenRouter-Backend des Harness (–argon-backend openrouter) liest OPENROUTER_API_KEY:
# macOS or Linux
export OPENROUTER_API_KEY="<YOUR_OPENROUTER_API_KEY>"

# Windows (PowerShell)
$env:OPENROUTER_API_KEY="<YOUR_OPENROUTER_API_KEY>"
Der Harness setzt zudem eine Ausgabenobergrenze durch: –budget-usd addiert die genauen Kosten jedes Aufrufs über alle Durchläufe hinweg und bricht den Vorgang ab, sobald die Obergrenze erreicht ist.
Was Argon beschlossen hat
Wie oben erwähnt, enthält die Tabelle lediglich Bezeichnungen; Argon hat die vollständigen Datensätze ausgelesen. Die „Kauf“-Beschreibung in der Garmin-Zeile enthält beispielsweise die von Argon angegebene Teilenummer 010-10723-03.
| Aufzeichnung A (Abt) | Aufzeichnung B (Kaufen) | Wahrheit | Argon | Argons Begründung |
|---|---|---|---|---|
| Sharp AQUOS 37′ LCD-HD-Fernseher, schwarz – LC37D64U | Sharp AQUOS LC37D44U 37′ LCD-Fernseher – LC37D44U | Keine Übereinstimmung | Keine Übereinstimmung | Verschiedene 37-Zoll-Modelle der Sharp AQUOS-Reihe, nämlich das LC37D64U und das LC37D44U, die zudem unterschiedliche Kontrastverhältnisse aufweisen. |
| Sharp AQUOS 37′ LCD-HD-Fernseher, schwarz – LC37D64U | Sharp AQUOS LC-37D64U 37′ LCD-Fernseher | Spiel | Spiel | Derselbe 37-Zoll-LCD-HD-Fernseher der Marke Sharp AQUOS mit derselben Modellnummer (LC37D64U / LC-37D64U) und einer Auflösung von 1920 x 1080. |
| Omnimount Wandhalterung für Lautsprecher – 20WLBK | OmniMount-Lautsprecherhalterung aus Edelstahl – 20,0 WALL-W | Keine Übereinstimmung | Keine Übereinstimmung | Aufzeichnung A ist die schwarze Variante (20WLBK, schwarze Oberfläche); Aufzeichnung B ist eine andere Variante (20.0 WALL-W). |
| Omnimount Wandhalterung für Lautsprecher – 20WLBK | OmniMount Universal-Wandhalterungsset für Lautsprecher – 20.0 WALL-B | Spiel | Spiel | Es handelt sich um dieselbe Halterung aus schwarzem Edelstahl mit einer Tragkraft von 20 lbs; 20WLBK und 20.0 WALL-B sind dasselbe Modell. |
| Garmin-Saugnapfhalterung für Fahrzeuge, verstellbar – 0101082303 | Garmin-Saugnapfhalterung für das Auto | Keine Übereinstimmung | Keine Übereinstimmung | Unterschiedliche Artikelnummern: 0101082303 gegenüber 010-10723-03. |
Argon hat 960 der 1.001 Bandpaare richtig erkannt, das sind 95,9 %, darunter alle Paare, bei denen der Schwellenwert einen Fehler angezeigt hatte. Vierzig seiner 41 Fehler waren echte Übereinstimmungen, die es abgelehnt hat, und unsere Auswertung der protokollierten Begründungen lässt sich in drei Gruppen einteilen:
- Ein „ Aufzeichnung “ ist zu vage, um dies zu bestätigen (19). Buy listet „LG 2,0 cu.ft. Over-the-Range-Mikrowelle“ ohne Modellnummer oder Farbangabe auf, daher würde Argon es nicht als dasselbe Produkt wie ein bestimmtes Modell bezeichnen.
- Ein Unterschied bei der Variante, der Farbe oder dem Paket (7). Eine schwarze Canon PowerShot im Vergleich zur silbernen oder eine SD-Karte, die zusammen mit einem Kartenlesegerät verkauft wird, im Vergleich zur Karte allein. Der Benchmark wertet diese als Übereinstimmungen; Argon tut dies nicht.
- Unterschiedliche Modellnummern (14). Einige davon scheinen auf Fehler in der Beschriftung des Benchmarks selbst zurückzuführen zu sein, wie beispielsweise der Vergleich des Weber Summit S-650 mit dem S-450 und der Vergleich von Apples 500-GB-Time-Capsule mit dem 1-TB-Modell.
Der 41. Fehler ging in die andere Richtung: Argon verglich einen LG-Kühlschrank mit Flügeltüren, der mit 25,0 cu. ft. angegeben war, mit einem Modell, das mit 24,7 cu. ft. angegeben war, mit der Begründung, dass 24,7 genau dem Fassungsvermögen desselben Modells entspricht, während der Referenzwert angibt, dass sie sich unterscheiden.
Die Gründe zeigen, dass das Modell einen strengeren Begriff von „demselben Produkt“ anwendet als die Bezeichnungen des Referenzindex. Sie zeigen auch, wo die Lösung liegt. Eine bessere Eingabeaufforderung kann keine Modellnummer liefern, die Aufzeichnung nicht enthält, und ein breiterer Bereich hilft nicht bei Paaren, die Argon bereits erkennt. Für die 19 unklaren Paare besteht die Lösung darin, Datensätze zu erstellen, die ausreichend aussagekräftig sind, und für die 14 Modellnummernpaare darin, die Bezeichnungen zu überprüfen.
Schritt 8: Die gesamte Pipeline ausführen
Der vollständige Code, einschließlich Blockierung, Bandauswahl, Argon-Pass und Wertung anhand der Gold-Labels, befindet sich im zugehörigen Repository. Die Versionen sind angeheftet:
| Komponente | Version |
|---|---|
| VectorAI-DB | actian/vectorai:1.0.2 |
| Einbettungsmodell | Einbettung von Gemma (embeddinggemma) über Ollama |
| Schiedsrichter | gemini-4-argon, ausgeführt am 23. Oktober 2026 über OpenRouter, Denkstufe LOW |
| Datensätze | Abt-Buy und Amazon-Google, Leipziger Benchmark-Sammlung, abgerufen am 19. Oktober 2026 |
Führen Sie die gesamte Pipeline auf Abt-Buy aus:
uv run resolve.py --dataset abt-buy --argon-backend openrouter --workers 2 --budget-usd 10Ersetzen Sie „Datensatz amazon-google“ für den zweiten Benchmark oder fügen Sie „–no-argon“ hinzu, um „Blocking“ und „Threshold“ ohne API-Aufrufe auszuführen.
Das Skript gibt für beide Ansätze alle in diesem Artikel genannten Kennzahlen aus, dazu den Anteil der an Argon gesendeten Paare und die Kosten. Auszug aus der Ausgabe des Abt-Buy-Laufs:
abt-buy: 1081 abt + 1092 buy records, 1097 true matches

Blocking (all records, hnsw_ef=256):
  K=1   candidates=  1,081  reduction ratio=0.9991  pair completeness=0.8186  returned/record: mean 1.0, min 1, short 0
  K=3   candidates=  3,243  reduction ratio=0.9973  pair completeness=0.9453  returned/record: mean 3.0, min 3, short 0
  K=5   candidates=  5,405  reduction ratio=0.9954  pair completeness=0.9699  returned/record: mean 5.0, min 5, short 0
  K=10  candidates= 10,810  reduction ratio=0.9908  pair completeness=0.9900  returned/record: mean 10.0, min 10, short 0
  K=20  candidates= 21,620  reduction ratio=0.9817  pair completeness=0.9973  returned/record: mean 20.0, min 20, short 0

Test split: 7,570 candidates, 767 true matches
  Global cutoff, all candidates (reference, 0.7672): P=0.5734 R=0.4785 F1=0.5217
  Best-match threshold (baseline, 0.5618): P=0.8196 R=0.8057 F1=0.8126
  Band [0.5618, 0.8405) + near-ties (rank <= 3, gap <= 0.03): 1,001 pairs (13.2% of candidates), holding 206/279 of the baseline's errors; recall ceiling 0.8970
  With Argon: P=0.9985 R=0.8449 F1=0.9153  (960/1001 band verdicts correct, $1.4081)
Die gemessenen Ergebnisse
Der Argon-Durchlauf steigerte den F1-Wert bei beiden Benchmarks um etwa 10 Punkte, bei Abt-Buy von 0,813 auf 0,915 und bei Amazon-Google von 0,597 auf 0,691, wobei 13 bis 14 % der Kandidatenpaare ausgewertet wurden. Das ist kein Rundungsfehler: Bei Abt-Buy wurden 135 der 136 falschen Übereinstimmungen entfernt, die der Schwellenwert akzeptiert hatte. Ob sich eine Steigerung bei Ihren Daten lohnt, hängt davon ab, was Sie eine falsche Zusammenführung oder eine übersehene Übereinstimmung kostet. Eine Steigerung um ein oder zwei Punkte wäre kaum von einer Verschiebung des Schwellenwerts zu unterscheiden und würde die Kosten für die API-Nutzung nicht rechtfertigen.
| Datensatz | Untersetzungsverhältnis | Paarvollständigkeit | F1, Schwellenwert für die beste Übereinstimmung | F1, mit Argon | Beitrag an Argon gesendet | Kosten pro 1.000 Datensätze |
|---|---|---|---|---|---|---|
| Abt-Kauf | 99.08% | 99.0% | 0.813 | 0.915 | 13.2% | $0.76 |
| Amazon – Google | 99.69% | 94.1% | 0.597 | 0.691 | 14.0% | $0.58 |
Präzision und Recall zeigen, woher die Verbesserung stammt. Bei Abt-Buy stieg die Präzision von 0,820 auf 0,998 und der Recall von 0,806 auf 0,845. Innerhalb des Bandes lehnte Argon 135 der 136 falschen Übereinstimmungen ab, die der Schwellenwert akzeptiert hatte, und akzeptierte 59 echte Übereinstimmungen, die bei Aufzeichnungals zweit- oder drittbester Kandidat gelistet waren – was ein Schwellenwert für die beste Übereinstimmung niemals auswählen kann. Der Recall blieb unter der Obergrenze des Bandes von 0,897, da Argon Paare ablehnte, bei denen ein Aufzeichnung zu vage war oder bei denen sich die Produkte in Variante, Farbe oder Bundle unterschieden.
Amazon-Google ist schwieriger: Die Softwaretitel variieren hinsichtlich Ausgabe, Version und Verpackung, und durch das Blockieren wurden 94,1 % der echten Übereinstimmungen zurückgehalten. Die Präzision stieg von 0,581 auf 0,684 und die Sensitivität von 0,614 auf 0,698, und Argon lag bei 76,4 % des Bereichs richtig. Die meisten der 316 Fehler (290) waren Übereinstimmungen mit den in der Referenzdatei abgelehnten Einträgen. In einer Zufallsstichprobe von 12 Einträgen weisen sieben eine identische Modellnummer, Teilenummer oder Version wie der abgeglichene Eintrag auf, beispielsweise Netgears VPN01L, was auf Lücken in den Referenzbezeichnungen hindeutet. Alle hier angegebenen Werte basieren weiterhin auf der veröffentlichten Referenzdatei.
Kosten. Bei den genauen Gebühren pro Aufruf von OpenRouter, einschließlich „Thinking Tokens“, kosteten die 1.001 Abt-Buy-Aufrufe 1,41 $ und die 1.338 Amazon-Google-Aufrufe 2,42 $. Pro 1.000 Datensätze in jedem Test-Split – dabei werden die Datensätze des Test-Splits aus der ersten Tabelle sowie die gesamte zweite Tabelle gezählt (1.849 Datensätze für „Abt-Buy“, 4.181 für „Amazon-Google“) – sind das 0,76 $ bzw. 0,58 $. Laut der Preisseite der Gemini-API von Google verdoppelt sich der Listenpreis von Argon am 1. Dezember 2026, was diese Zahlen in etwa verdoppeln würde. Als Vergleichswert: AWS Entity Resolution berechnet 0,25 $ pro 1.000 verarbeitete Datensätze für regelbasierten oder ML-basierten Abgleich, und zwar pro „ Aufzeichnung “ und nicht nach einem Preisband.
Latenz. Auf einem Laptop, auf dem ausschließlich „ CPU “ installiert war und der über 8 GB RAM verfügte, dauerte das Einbetten der 2.173 Abt-Buy-Datensätze 771 Sekunden, und das Blockieren dauerte 35 Sekunden. Die Argon-Aufrufe dauerten bei Abt-Buy 54 Minuten und bei Amazon-Google 88 Minuten, bei 2 parallelen Anfragen; bei 8 parallelen Anfragen kam es bei unseren Aufrufen zu 429 Rate-Limit-Fehlern. Das Einbetten ist ein einmaliger Aufwand: Der Harness speichert die Vektoren im Cache, sodass erneute Ausführungen direkt mit dem Blockieren beginnen.
Im Gegensatz zur Literatur.Li et al. berichten, dass Ditto, ein auf beschriftete Paare feinabgestimmter Matcher, bei den ER-Magellan-Versionen dieser Benchmarks einen F1-Wert von 89,33 bei Abt-Buy und 75,58 bei Amazon-Google erreicht (0,893 bzw. 0,756 auf der hier verwendeten Skala). Ditto wurde anhand eines vorab ausgewählten Satzes von beschrifteten Paaren bewertet, während unsere Zahlen aus der Auswertung der vollständigen Tabellen nach dem Blocking stammen; betrachten Sie die Ergebnisse von Ditto daher als Anhaltspunkt. Unsere Pipeline benötigt keine „ Training “-Daten, und ihr Recall wird dadurch begrenzt, was beim Blocking erhalten bleibt und welche Kandidaten das Band erreichen.
Warum es auf Ihrer eigenen Infrastruktur läuft
Bei den Auflösungsdaten handelt es sich um Datensätze zu Kunden, Patienten und Geschäftspartnern, die oft nicht über regulierte Grenzen hinausgelangen dürfen. Hier laufen VectorAI DB und das Einbettungsmodell auf Ihren eigenen Rechnern, sodass die Einbettungen, die Blockierung und die aufgelösten Entitäten innerhalb Ihres Netzwerks verbleiben. Nur der Argon-Aufruf sendet Daten nach außen: das Band, 13,2 % der Kandidatenpaare, jeweils zwei Datensätze auf einmal. Für regulierte Daten wählen Sie einen von zwei Wegen:
- Anonymisieren Sie die Datenreihe. Entfernen oder maskieren Sie Namen, E-Mail-Adressen und Kontonummern und übermitteln Sie nur die Felder, die für den Abgleich entscheidend sind, sofern Ihre Richtlinien die Weitergabe von Daten zulassen.
- Führen Sie den zweiten Durchlauf lokal durch. Wenn kein Feld das System verlassen darf, tauschen Sie `adjudicate()` gegen einen Aufruf eines von Ihnen gehosteten Modells aus. Die Codestruktur bleibt dabei unverändert. Da wir in diesem Durchlauf kein lokales Modell gemessen haben, ist mit abweichenden Genauigkeits- und Kostenwerten zu rechnen.
Wann sich Zusammenarbeit lohnt – und wann nicht
Diese Meinungsverschiedenheit steht im Zusammenhang mit einer aktuellen Debatte über LLMs bei der Entitätsauflösung. Jeff Jonas, der Gründer von Senzing, schreibt, dass er oft gefragt werde, warum man nicht einfach ein LLM für die Entitätsauflösung nutze, und antwortet, dass dies „keine gute Idee“ sei. Er verweist auf Clair Sullivans Vergleich von Claude Opus 4.8 mit der Senzing-Engine, bei dem das LLM deutlich langsamer und kostspieliger war, sowie auf deterministische Ergebnisse und Erklärbarkeit. Die hier vorgestellte Pipeline setzt auf Skalierbarkeit und hält das LLM von fast jedem Paar fern; VectorAI DB und der Schwellenwert entscheiden über 87 % der Kandidaten, und Argon liest nur den Bereich aus, in dem der Schwellenwert unzuverlässig ist. Damit wird auch ein Teil des Problems der Erklärbarkeit gelöst, da jedes Ergebnis mit seiner Begründung protokolliert wird. Das macht Argon zwar nicht deterministisch, aber bei einer erneuten Ausführung werden die protokollierten Ergebnisse wiedergegeben, anstatt erneut abzufragen.
Führen Sie den Argon-Durchlauf durch, wenn bei Ihren Daten zwei Bedingungen erfüllt sind: Das Band deckt den Großteil der Fehler des Schwellenwerts ab, und Argon bestimmt Bandpaare um mindestens 10 Punkte genauer als der Schwellenwert. Beide Bedingungen waren bei beiden Benchmarks erfüllt, und jedes Mal brachte der Durchlauf etwa 10 F1-Punkte für weniger als 1 Dollar pro 1.000 Datensätze ein.
| Datensatz | Fehler von Threshold innerhalb der Bandbreite | Schwellenwert direkt auf Bandpaaren | Argon direkt auf Bandpaaren | F1-Verstärkung | Kosten pro 1.000 Datensätze |
|---|---|---|---|---|---|
| Abt-Kauf | 206 von 279 (74 %) | 79.4% | 95.9% | +10.3 | $0.76 |
| Amazon – Google | 500 von 697 (72 %) | 62.6% | 76.4% | +9.4 | $0.58 |
Argons Vorsprung bei den Bandpaaren betrug 16,5 Punkte bei „Abt-Buy“ und 13,8 Punkte bei „Amazon-Google“. Um herauszufinden, ab wann dieser Vorsprung keine F1-Käufe mehr auslöst, haben wir das Band bei beiden Datensätzen mit der halben und der doppelten Breite erneut durchlaufen lassen. Alle Ergebnisse stammen aus demselben Protokoll, sodass jede Zeile zeigt, was der zusätzliche Teil des Bandes beigetragen hat:
| Datensatz | Bandbreite | An Argon gesendete Paare | F1 mit Argon | Argonkosten | Argons Vorsprung bei den Paaren wurde ausgebaut |
|---|---|---|---|---|---|
| Abt-Kauf | 0.5× | 803 | 0.901 | $1.13 | (Basis) |
| Abt-Kauf | 1× | 1,001 | 0.915 | $1.41 | +12,1 Punkte bei 198 Paaren |
| Abt-Kauf | 2× | 1,079 | 0.916 | $1.53 | +1,3 Punkte bei 78 Paaren |
| Amazon – Google | 0.5× | 1,269 | 0.6905 | $2.32 | (Basis) |
| Amazon – Google | 1× | 1,338 | 0.6909 | $2.42 | +1,4 Punkte bei 69 Paaren |
| Amazon – Google | 2× | 1,348 | 0.6924 | $2.44 | +20 Punkte für 10 Paare |
Die Segmente, in denen Argon den Schwellenwert deutlich übertraf, haben sich ausgezahlt. Bei Abt-Buy, dem Segment „halb bis ganz“ (mit einem Vorsprung von 12,1 Punkten), wurden 1,5 F1-Punkte für 0,28 Dollar hinzugewonnen. Bei Amazon-Google, den letzten 10 Paaren (mit einem Vorsprung von 20 Punkten), wurden 0,15 Punkte für 0,02 Dollar hinzugewonnen. Die Segmente, in denen der Vorsprung bei etwa einem Punkt lag, brachten jeweils weniger als ein Zehntelpunkt ein: Die nächsten 78 Abt-Buy-Paare brachten 0,07 Punkte für 0,12 $ ein, und das Segment „halb bis ganz“ bei Amazon-Google brachte 0,04 Punkte für 0,09 $ ein. Die zusätzlichen Ausgaben führten also nur noch zu einem Anstieg des F1-Werts bei einem Vorsprung zwischen 1 und 12 Punkten. Da zwei Datensätze diese Grenze nicht genauer bestimmen können, betrachten Sie den 10-Punkte-Balken als Faustregel, die innerhalb dieser Lücke liegt.
In drei Fällen wird die Karte nicht mehr gutgeschrieben:
- Der Schwellenwert liegt bereits genau auf dem Band. Wenn Ihre schwellenwertbasierten Bandpaare fast so gut zusammenpassen wie bei Argon, werden bei diesem Durchlauf Ressourcen darauf verwendet, zu bestätigen, was der Schwellenwert bereits wusste.
- Die Fehler liegen außerhalb des Bereichs. Wenn durch das Blockieren echte Übereinstimmungen verloren gehen oder diese in der Rangliste zu weit unten stehen, um als Beinahe-Übereinstimmungen zu gelten, werden sie in der zweiten Stufe nicht berücksichtigt. Bei Amazon-Google lag der Recall-Wert bei 0,727, bevor Argon auch nur ein einziges Paar auslesen konnte.
- Das Band ist zu breit. Durch die Verdopplung der Bandbreite bei Abt-Buy wurden 78 weitere Paare an Argon gesendet (1.079 statt 1.001) und es entstanden bei den von OpenRouter gemessenen Gebühren zusätzliche Kosten von 0,12 $, doch nur ein weiterer Fehler des Schwellenwerts fiel in diesen Bereich. F1 verschob sich von 0,9153 auf 0,9160, also um weniger als ein Zehntelpunkt. Legen Sie die Grenzwerte anhand Ihrer Daten fest und belassen Sie sie dann unverändert.
Um Ihre eigenen Daten zu überprüfen, kennzeichnen Sie etwa 200 Bandpaare von Hand und vergleichen Sie anschließend, wie oft der Schwellenwert und Argon die richtigen Ergebnisse liefern. Diese Stichprobe kostet bei den hier ermittelten Tarifen etwa 30 Cent an Argon-Anrufen und gibt Ihnen Aufschluss darüber, ob sich der vollständige Durchlauf lohnt, bevor Sie ihn ausführen.
Fazit
Die in diesem Artikel beschriebene Pipeline hat die Sharp-Fernseher bereits zu Beginn korrekt identifiziert. Der Schwellenwert wählte das Modell LC37D44U aus, da dessen Vektor eine höhere Punktzahl erzielte; Argon las beide Datensätze aus, ordnete das Modell LC37D64U anhand seiner Modellnummer zu und protokollierte den Grund dafür. Über die Abt-Buy-Testaufteilung hinweg steigerte dieser zweite Durchlauf den F1-Wert von 0,813 auf 0,915 bei Kosten von 0,76 Dollar pro 1.000 Datensätze.
Dieses Ergebnis ergibt sich aus dem Zusammenspiel dreier Entscheidungen:
- Blockieren Sie mithilfe einer gefilterten Suche nach den nächsten Nachbarn in der VectorAI-Datenbank, sodass 99 % des Vergleichsraums verschwinden, während 99 % der echten Übereinstimmungen erhalten bleiben.
- Legen Sie die Bandbreiten anhand der gekennzeichneten Daten fest, sodass nur die unsicheren 13,2 % der Kandidaten Kosten verursachen.
- Senden Sie genau dieses Band an ein Modell, das eine Teilenummer lesen kann.
VectorAI DB und das Einbettungsmodell laufen auf Ihrer eigenen Hardware, sodass bis auf die Datenübertragung alles innerhalb Ihres Netzwerks bleibt.
Das gleiche Skript läuft auch auf Ihren eigenen Tabellen. Verweisen Sie den Loader auf Ihre Kunden-, Lieferanten- oder Produktdatensätze, fügen Sie Ihre Ausschlussregeln in die „must“-Klausel des Blockierfilters ein und führen Sie es in der VectorAI DB Community Edition aus. Laden Sie das Bild herunter, um zu beginnen:
docker pull actian/vectorai:latest
Bleiben Sie in Verbindung
Datenanalysen direkt bei Ihnen.
(z. B. sales@..., support@...)
