Stellen Sie KI-Agenten mit persistentem Gedächtnis bereit. Setzen Sie sie überall ein.

Was Entwickler mit VectorAI DB realisieren
Trace
Semantische Suche für Vermisstenfälle. Überbrückt die terminologische Kluft zwischen den Angaben von Angehörigen und forensischen Unterlagen – vollständig auf dem Gerät.

Revvec
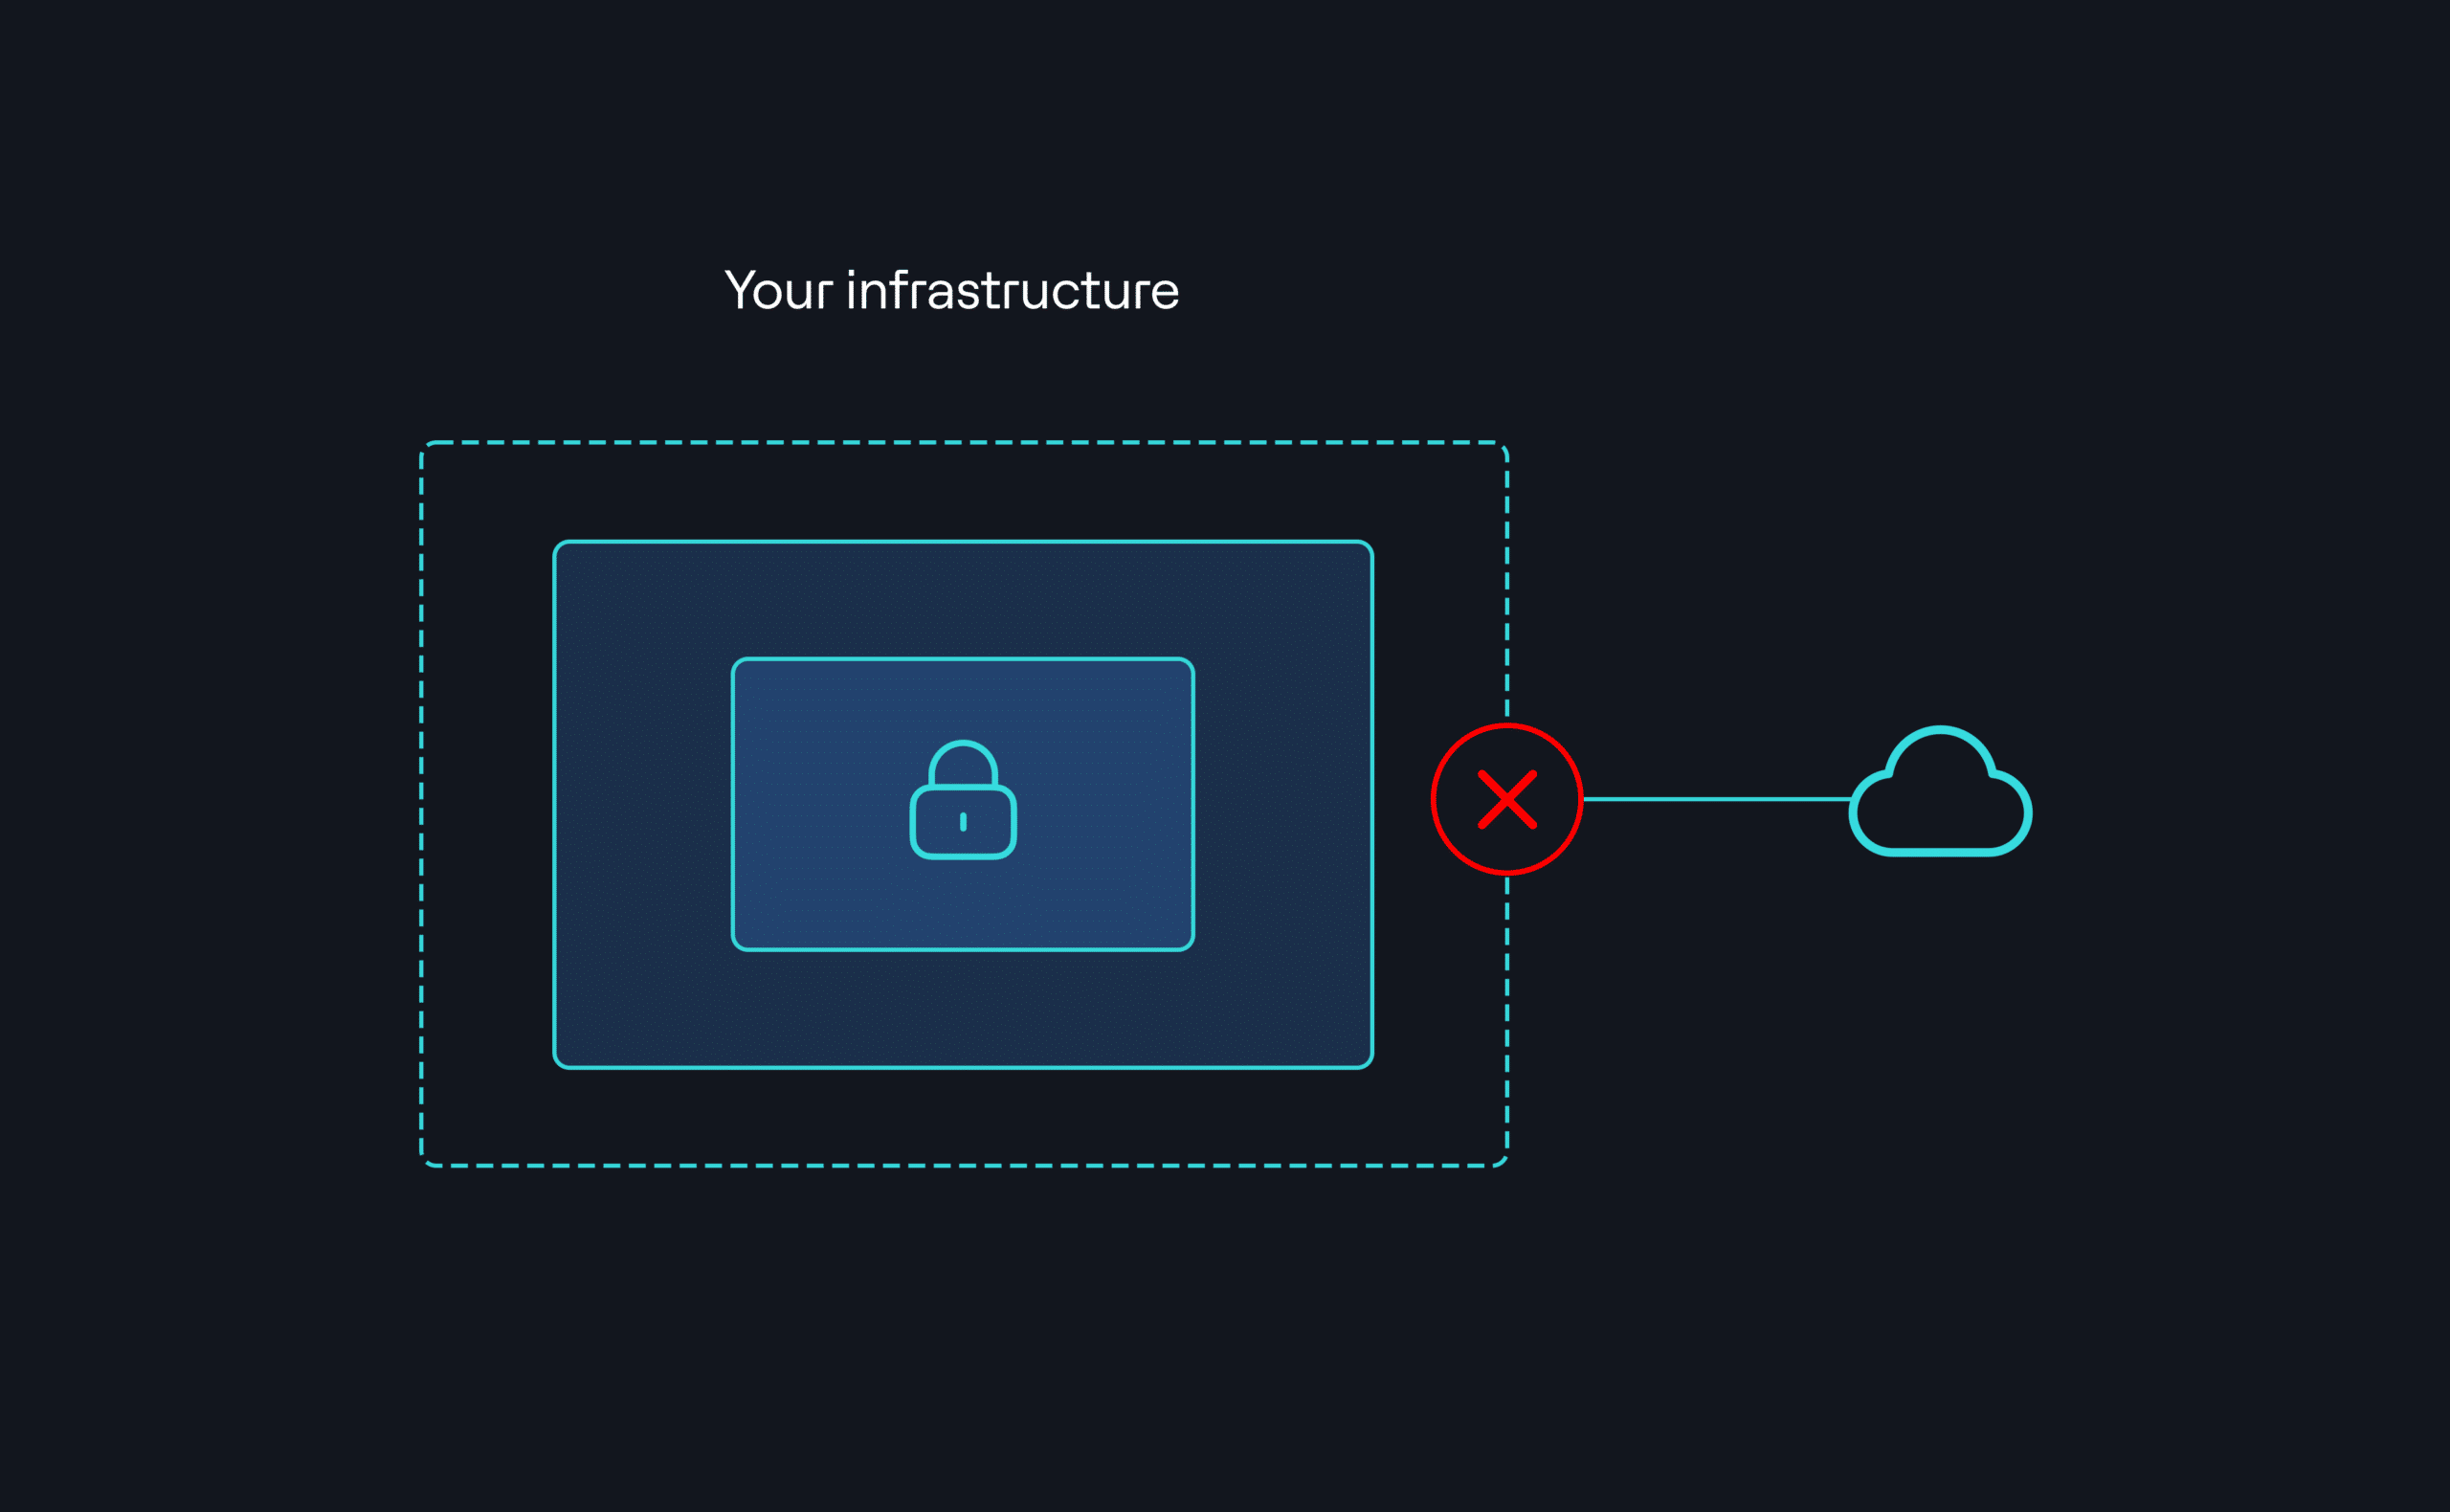
RAG-Pipeline für Air-Gapped-Umgebungen in Verteidigung, Luft- und Raumfahrt sowie Pharmaindustrie. Läuft auf einem einzigen Mac; keine Internetverbindung erforderlich.
FixFirst
Offline-Wartungsassistent für Industrietechniker. Durchsuchen Sie Handbücher und den Störungsverlauf nach Fehlercode, Foto oder Sprachnotiz.


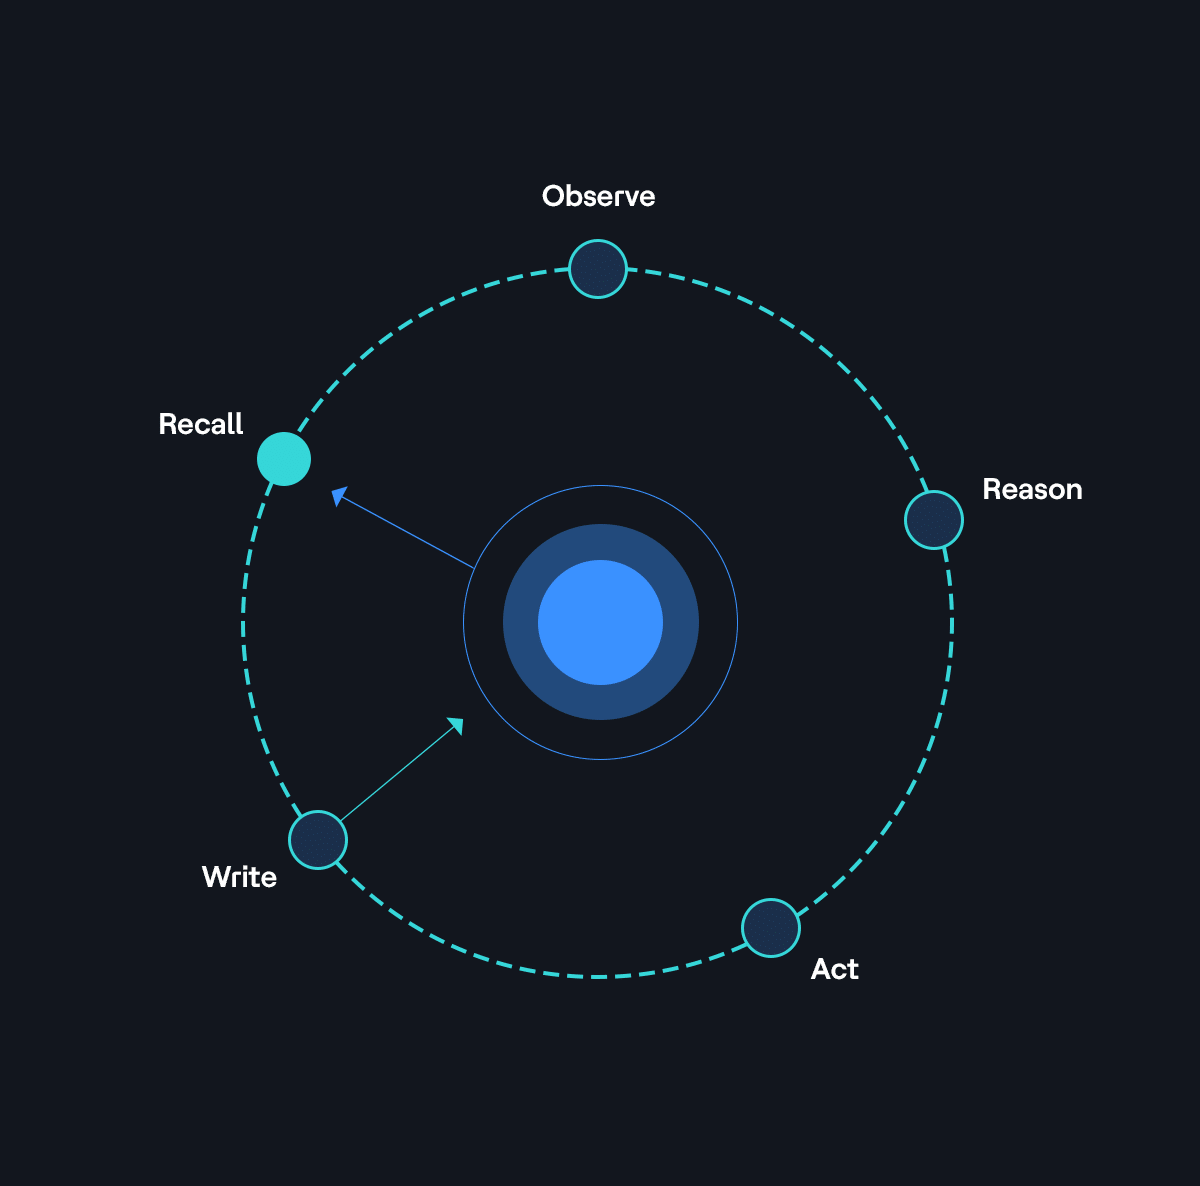
Die meisten Vektordatenbanken wurden für menschliche Abfragemuster entwickelt. Bei KI-Agenten ist das anders.
/

Leistungswerte, die auch unter Last Bestand haben
QPS
745,2 QPS bei 10 Millionen Vektoren mit 768 Dimensionen. 22-mal schneller als Milvus und Qdrant.
Abrufgenauigkeit
p99-Latenz
13 ms p99-Latenz bei einer Recall-Rate von 99 % auf Ihrer eigenen Hardware, auf der Ihre Agenten laufen.
Was Sie erhalten

Ein Gedächtnis, das über jede Session hinaus erhalten bleibt
Agenten rufen den Kontext über Sitzungen hinweg, in jedem Umfang und innerhalb Ihres Netzwerkbereichs ab.

Überwachen Sie das System mit den Tools, die Sie bereits nutzen
Native Prometheus-Metriken in Ihren bestehenden Grafana-Dashboards.

Parallele Abfragen ohne Leistungseinbußen
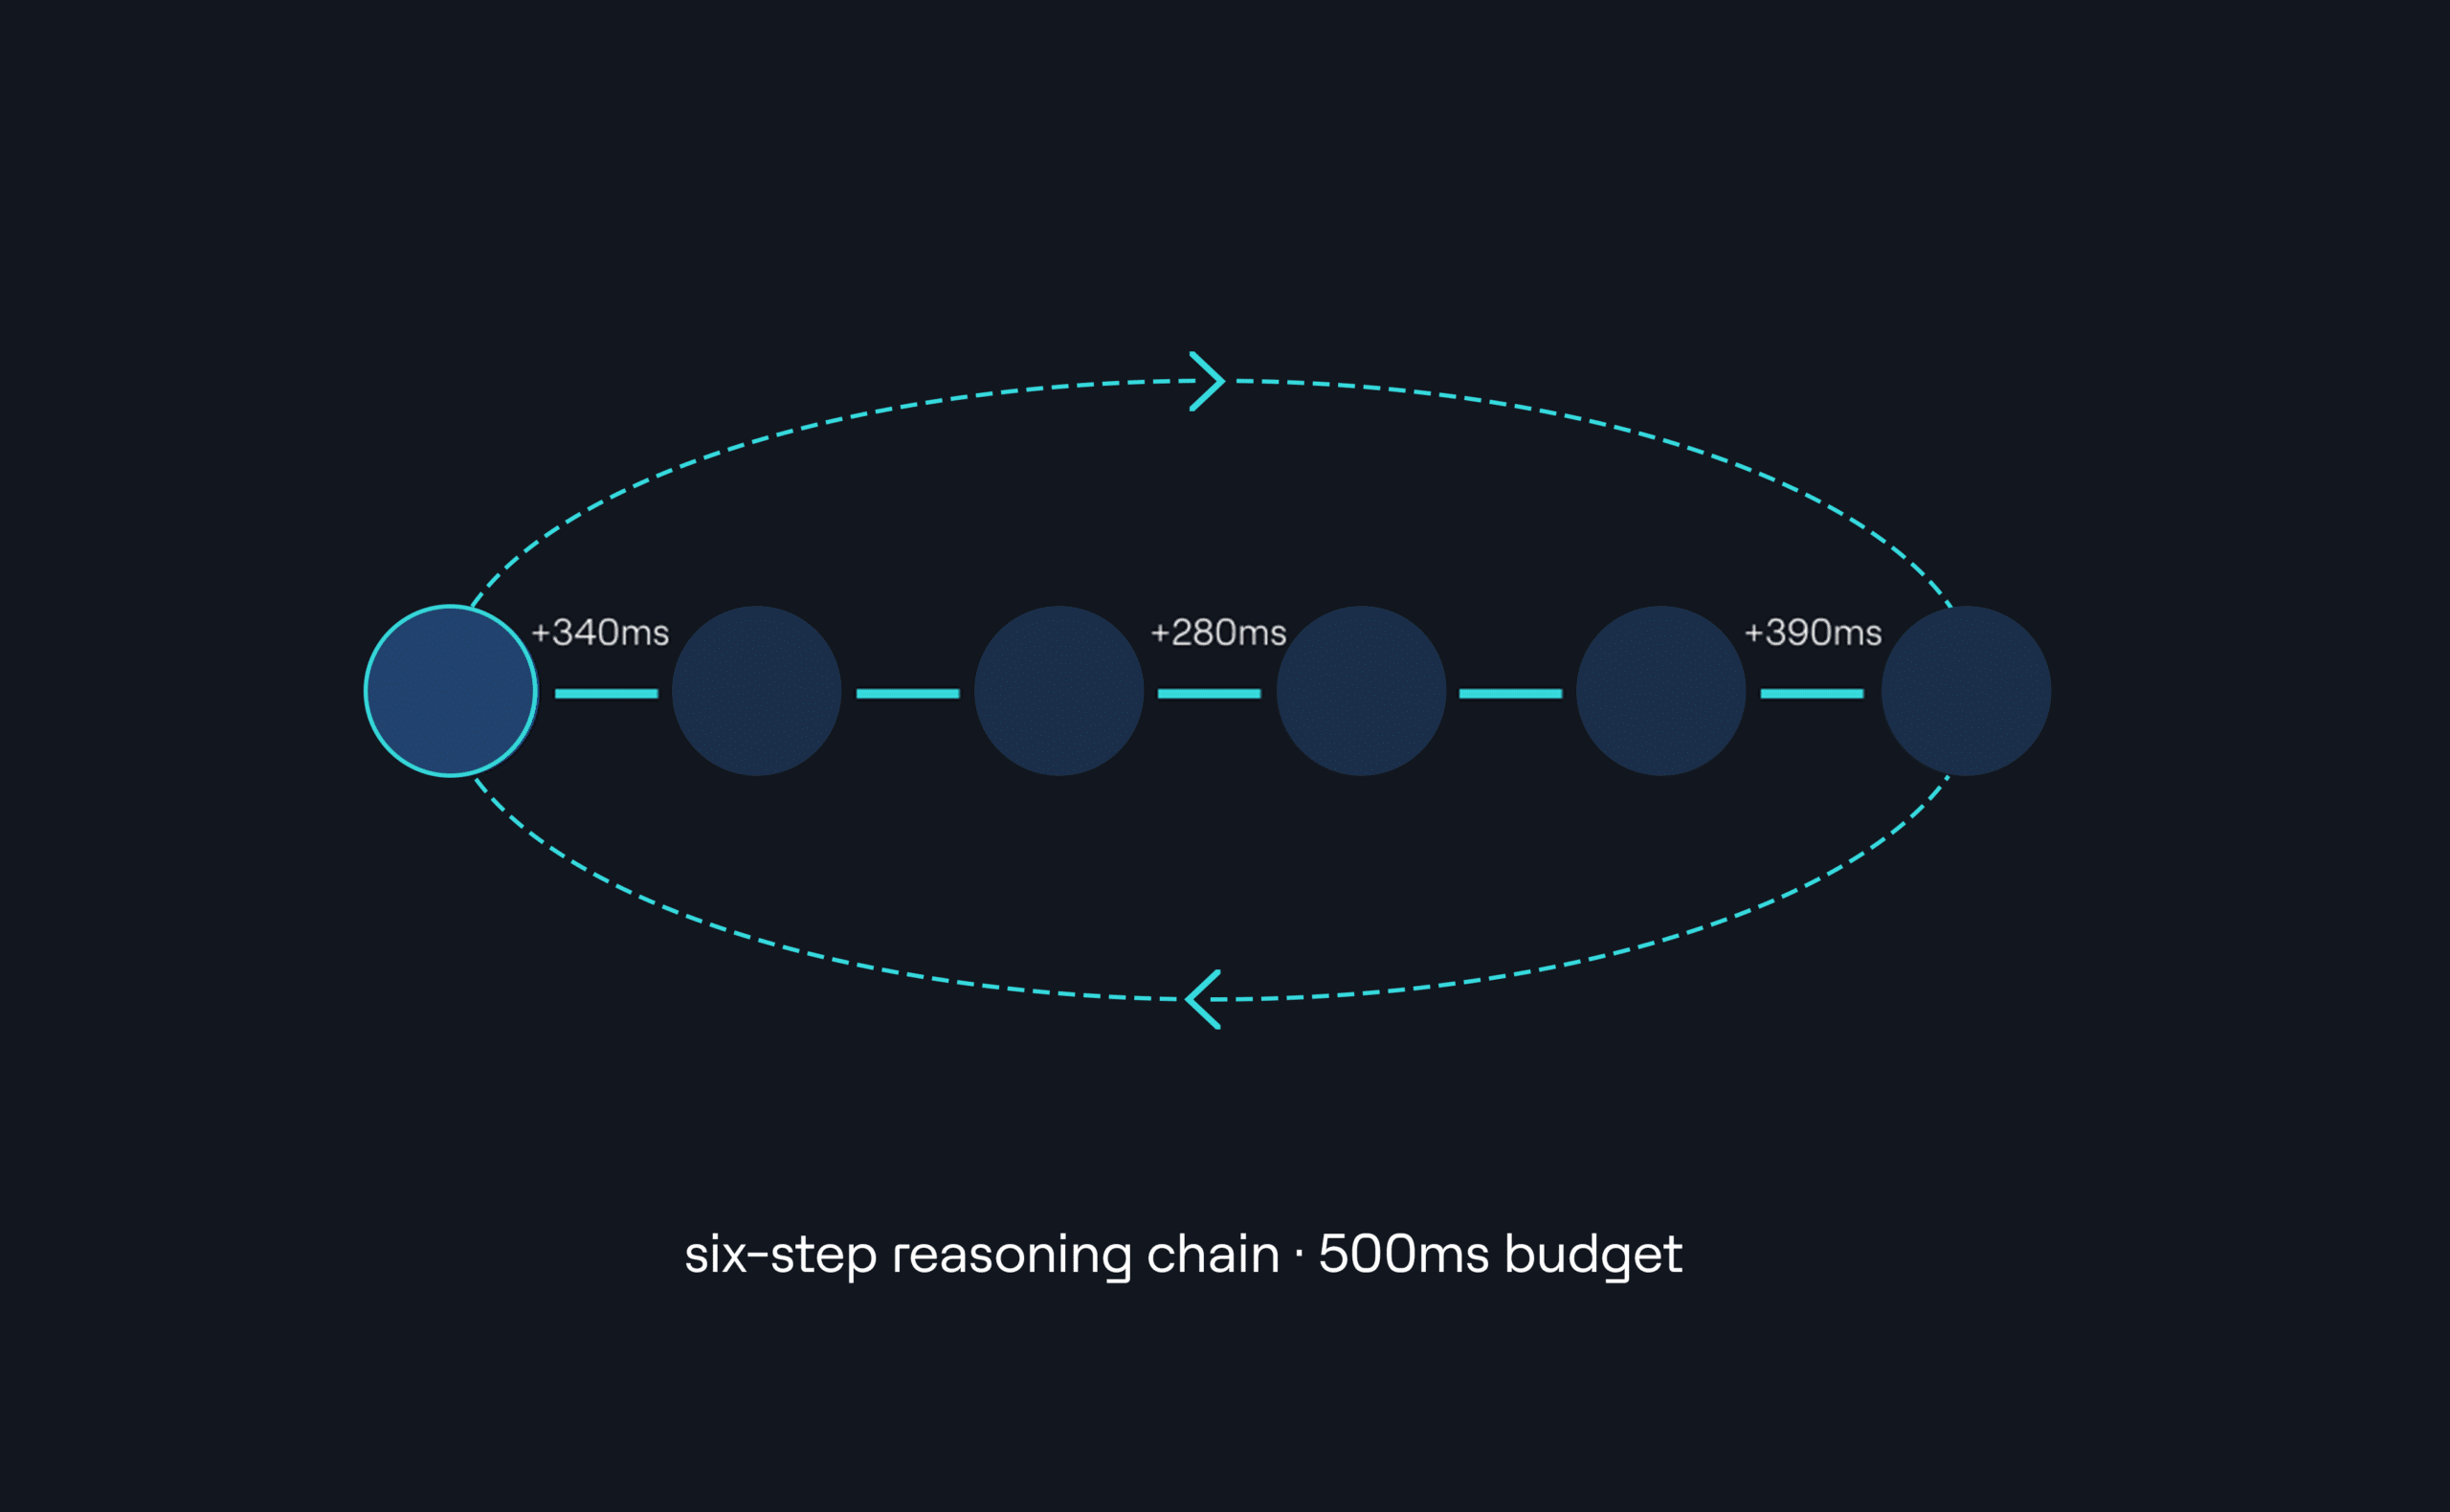
Parallele Reasoning-Schritte und Zugriffe auf das Gedächtnis – bei unverändertem Recall.

Denselben Build überall bereitstellen
Vom Laptop bis zum Rechenzentrum – ohne Neuprogrammierung, auf jeder Hardware.

Die Compliance-Prüfung bestehen, ohne die Architektur neu aufzusetzen
DSGVO-, HIPAA- und Data-Residency-Anforderungen lassen sich dadurch erfüllen, dass die Daten am vorgeschriebenen Speicherort verbleiben.

Passen Sie den Index an die vorhandene Hardware an.
Wählen Sie HNSW oder IVF, fügen Sie Quantisierung hinzu und passen Sie die Indexgröße an den tatsächlich verfügbaren Speicher an.
Erleben Sie VectorAI DB in Aktion
Sehen Sie sich die vollständige Bereitstellung eines Agenten von Grund auf bis zur ersten Abfrage an.
Erste Schritte mit Ihrem Framework
Integrieren Sie VectorAI DB einfach in Ihren bestehenden Tech-Stack.
Nutzen Sie das VectorAI DB-Python-SDK direkt für jeden individuellen Agenten-Stack. Sie stellen das Embedding-Modell bereit; VectorAI DB übernimmt Speicherung und Suche.
# Install
pip install actian-vectorai

from actian_vectorai import VectorAIClient

client = VectorAIClient(host="localhost:8080")
client.create_collection("agent-memory", dim=768)

results = client.query(
  collection="agent-memory",
  vector=embeddings,
  top_k=10
)
Betreiben Sie VectorAI DB dort, wo Sie es benötigen
SDKs für Python und JavaScript, eine REST-API und ein einziger Docker-Container, der auf einem Laptop, einem Edge-Gerät oder in einem Kubernetes-Cluster identisch läuft.



VectorAI DB im Vergleich
Ein transparenter Vergleich, in welchen Umgebungen die einzelnen Vektordatenbanken laufen und welche Leistung sie erzielen. Der Durchsatz wurde anhand von 10 Millionen Vektoren mit 768 Dimensionen auf identischer Hardware gemessen.
VectorAI-DB |
Pinecone |
Qdrant |
Weaviate |
|
|---|---|---|---|---|
Durchsatz bei 10 Millionen Vektoren |
745 QPS |
~33 QPS |
~34 QPS |
Selbst gehostete Varianten |
Läuft auf Edge-Hardware mit begrenzten Ressourcen (Jetson, Pi) |
Ja |
Nein |
Begrenzt |
Begrenzt |
Dieselbe API vom Prototyp bis zum Produktivbetrieb |
Ja |
Nur Cloud |
Ja |
Ja |
On-Premises-Bereitstellung und Bereitstellung in Air-Gapped-Umgebungen |
Ja |
Nein |
Ja |
Ja |
Vollständig verwaltete Cloud-Option |
Selbstverwaltet |
Ja |
Cloud |
Cloud |
Wer baut auf der VectorAI-Datenbank auf?
Teams, die Anwendungen entwickeln, bei denen die Daten gespeichert sind und das Netzwerk sie nicht immer erreichen kann.
Die Patientendaten verbleiben während jeder Abfrage vollständig innerhalb Ihrer eigenen Infrastruktur.
Bereitstellung in: Krankenhaus-Rechenzentren, Klinikservern, Forschung
Konsistent über Hybrid-, Edge- und standortübergreifende Infrastrukturen hinweg – unabhängig von Konnektivität, Compliance-Anforderungen oder Hardwarebeschränkungen.
Bereitstellung in: Hybridumgebungen, Edge und Cloud, standortübergreifend
FAQ
Actian VectorAI DB ist eine speziell für KI-Agenten entwickelte Vektordatenbank und bietet ihnen ein persistentes Gedächtnis sowie einen Abruf mit niedriger Latenz auf Ihrer eigenen Infrastruktur.
Die meisten Vektordatenbanken wurden für Cloud-native Bereitstellungen und menschliche Abfragemuster entwickelt. VectorAI DB ist auf die parallele, hochfrequente Arbeitsweise von Agentenflotten ausgelegt und läuft konsistent in Edge-, On-Premises-, Air-Gapped- und Cloud-Umgebungen, ohne dass Änderungen an der Architektur erforderlich sind. Pinecone ist ausschließlich in der Cloud verfügbar. Qdrant und Weaviate unterstützen selbst gehostete Bereitstellungen, sind jedoch in erster Linie für Cloud-Workloads in großem Maßstab und nicht für Edge-Umgebungen oder Umgebungen ohne Netzwerkverbindung konzipiert.
VectorAI DB lässt sich nativ in LangChain, LlamaIndex und Hugging Face integrieren. Es stehen SDKs für Python und JavaScript zur Verfügung. Über Community-Plugins werden auch CrewAI, LangGraph und Mastra unterstützt. Die vollständige Integrationsdokumentation finden Sie unter docs.vectoraidb.actian.com.
VectorAI DB erreicht 745,2 QPS bei 10 Millionen Vektoren mit 768 Dimensionen und ist damit auf identischer Hardware mehr als 22-mal schneller als Milvus und Qdrant. Es ist auf die parallelen, hochfrequenten Abfragemuster von Agentenflotten ausgelegt und nicht auf die sequenziellen Muster nutzerorientierter Anwendungen.
Der kostenlose Tarif ist die VectorAI DB Community Edition. Sie ist dauerhaft kostenlos und erfordert keine Einrichtung der Abrechnung. Sie umfasst eine Kapazität von 5.000 Vektoren, lässt sich auf lokalen Entwicklungsrechnern bereitstellen und bietet Community-Support.
VectorAI DB unterstützt zwei Indextypen: HNSW (Hierarchical Navigable Small World) und IVF (Inverted File). Beide können mit Vektorquantisierung kombiniert werden, wodurch jeder Vektor komprimiert und der Indexbedarf weiter reduziert wird.
IVF ist kein Ersatz für HNSW. Es ist eine zweite Option, und die richtige Wahl hängt von Ihren individuellen Bedürfnissen ab. Deployment Einschränkungen. Verwenden Sie HNSW, wenn die Priorität auf dem Abruf mit geringer Latenz liegt und der Speicherplatz nicht die Einschränkung darstellt. Dies ist die Standardeinstellung für die meisten serverseitigen Workloads.
Verwenden Sie IVF, wenn der Index weniger Speicherplatz benötigen muss oder sich die Daten ständig ändern. Der geschichtete Graph von HNSW benötigt mehr Speicher pro Vektor und ist bei jedem Einfügen und Löschen aufwändig zu reparieren. Der flache, gruppierte Speicher von IVF benötigt weniger Speicher pro Vektor und seine Cluster Aufgaben lassen sich günstiger neu erstellen oder teilweise aktualisieren.
VectorAI DB ist modellunabhängig und funktioniert mit Embeddings von jedem Anbieter – OpenAI, Anthropic, Cohere, Hugging Face oder jedem eigenen Modell.
Ja. VectorAI DB speichert Vektor-Embeddings aus Text, Bildern, Audio und Video.
Ja. Sie können Transaktionen über Ihren bestehenden AWS-Vertrag abwickeln und zugesagte Ausgaben, einschließlich EDP-Zusagen, abrufen, ohne eine neue Anbieterprüfung einzuleiten.
Kostenlos starten – ganz ohne Abrechnung.
Alles, was Sie brauchen, um noch heute auf Ihrem eigenen Rechner ein Agentengedächtnis prototypisch umzusetzen.

Kostenloser Zugang
Laden Sie VectorAI DB herunter und legen Sie sofort los. Ganz ohne Abrechnung.
Vektorindizierung und -suche
ANN-Indexierung (HNSW und IVF), Vektorquantisierung, Vektorsuch-APIs und Überwachung zur Unterstützung von Prototypen mit bis zu 5.000 Vektoreinbettungen.
Schnelle Einrichtung vor Ort
Installieren Sie VectorAI DB, indizieren Sie Daten und führen Sie innerhalb weniger Minuten Abfragen durch – mit klarer Dokumentation, Quickstarts und Codebeispielen.