
Entwicklung eines lokalen KI-Agenten auf einem Raspberry Pi 5 mit VectorAI DB


Wichtigste Erkenntnisse
- Auf einem Raspberry Pi 5 lässt sich mit Ollama und der Actian VectorAI-Datenbank ein vollständig lokal ausgeführter KI-Agent betreiben, wobei der Speicher auch nach einem Neustart erhalten bleibt.
- Der Agent nutzt Qwen 2.5 1.5B für die Antworten, nomic-einbetten-text für die Einbettungen und VectorAI DB für den Abruf aus dem semantischen Speicher.
- Auf dem Test-Pi wurden relevante Erinnerungen in 1,8 ms abgerufen, während die lokale Modellinferenz 3,6 Sekunden dauerte.
- VectorAI DB lieferte auf der getesteten Hardware die fünf besten Ergebnisse aus 100.000 Vektoren, wobei die p99-Abrufverzögerung unter 5 ms lag.
- NVMe-Speicher, aktive Kühlung und ausreichende Leistung ermöglichen es dem Pi, lokale KI-Workloads zu bewältigen, während größere Modelle und Multi-Agenten-Systeme möglicherweise leistungsstärkere Hardware erfordern.
Wenn Sie einen Agenten auf einem Raspberry Pi erstellen, muss dieser sich nach einem Neustart des Prozesses, einem Systemneustart, dem Aus- und Einschalten oder einem Absturz an vergangene Sitzungen erinnern können. Für den Gewächshaus-Monitor in diesem Tutorial bedeutet das, dass heute ein Sensorwert aus der letzten Woche abgerufen werden kann, wenn Sie danach fragen.
Die Speicherschicht muss zudem innerhalb der Hardware-Grenzen des Pi funktionieren. Manche Datenbanken werden langsamer, je größer die Datensammlung wird. Andere erfordern einen separaten Serverprozess, der neben Ollama auch RAM nutzt. Außerdem müssen wir wissen, wie sich die Latenz beim Abruf verändert, wenn der Speicher des Agenten von 10.000 auf 100.000 Vektoren anwächst. Wir haben dies auf einem Raspberry Pi 5 getestet.
$ uv run agent.py
Agent ready on Raspberry Pi 5 Model B Rev 1.1, 8 GB RAM | LLM: qwen2.5:1.5b | 2 memories in VectorAI DB. Ctrl+C to quit.

you> Which greenhouse sensor was reading high, and what was going on in zone B?

agent> The greenhouse sensor 3 was reading 41 degrees, indicating a high temperature. In zone B, the irrigation pump was switched off for maintenance.
Beide Fakten stammten aus einer früheren Sitzung, und wir hatten die Datenbank zwischendurch neu gestartet. Die VectorAI-Datenbank von Actian fand sie in 1,8 ms, und Qwen 2.5 1.5B lieferte die Antwort in 3,6 Sekunden auf dem Pi unter CPU – ohne die API „ Cloud “.
Als Hardware kommt ein Raspberry Pi 5 mit 8 GB Speicher, einer NVMe-SSD und dem offiziellen Active Cooler zum Einsatz. Ollama führt das Modell aus, und Actian VectorAI DB speichert den Arbeitsspeicher des Agenten auf der Festplatte. Der Agent speichert Ihre Eingaben als Vektoren, durchsucht diese, wenn Sie eine Frage stellen, und leitet die relevanten Vektoren an das Modell weiter.
Am Ende dieses Tutorials wird dieser Agent auf Ihrem eigenen Pi 5 laufen, wobei der Speicher auch nach einem Neustart erhalten bleibt. Außerdem erhalten Sie einen Benchmark, der zeigt, wie sich die Abruf-Latenz verändert, wenn die Sammlung von 1.000 auf 100.000 Vektoren anwächst.
Voraussetzungen
- Raspberry Pi 5 mit 8 GB, einem PCIe-NVMe-HAT, einer NVMe-SSD, einem offiziellen Active Cooler und dem offiziellen 27-W-USB-C-Netzteil.
- Raspberry Pi OS 64-Bit (Trixie).
- Docker mit dem Compose-Plugin (
curl -fsSL https://get.docker.com | sh), und Ihr „ Nutzer “ in der Docker-Gruppe (sudo usermod -aG docker “$USER”, dann abmelden und wieder anmelden). - uv, der Paketmanager von „ Python “ (wird in Schritt 3 installiert). Er installiert für Sie eine kompatible Version von „ Python “ 3.11+, falls auf Ihrem System noch keine vorhanden ist.
- Eine VectorAI-DB-Lizenz oder eine 30-tägige Testversion. Die kostenlose Community-Edition beschränkt die Anzahl der Vektoren in einer Sammlung auf unter 5.000. Das reicht für dieses Tutorial völlig aus, für die Benchmark-Läufe mit 10.000 und 100.000 Vektoren ist jedoch die Lizenz erforderlich.
- Der gesamte Code befindet sich in der GitHub-Repo. Kopiere es und führe es aus
./setup.sh, das die Schritte 1 bis 5 abdeckt – mit Ausnahme des Neustarts zur Anpassung der Speichergrenze –, fahren Sie dann mit Schritt 6 fort.
Was du baust
Die Konfiguration läuft auf dem Pi: zwei Docker-Container und ein „ Python “-Skript.
Ollama führt zwei Modelle in einem Docker-Container aus, der auf 4 GB begrenzt ist. qwen2.5:1.5b liefert Antworten. nomic-embed-text wandelt Text in 768-dimensionale Vektoren um. Nachdem beide geladen waren, belegte Ollama auf der Testplatine 1,58 GiB.
Actian VectorAI DB läuft in einem zweiten Container mit einer Obergrenze von 2 GB. Es speichert jede „ Nutzer “-Nachricht als Vektor in einem HNSW-Index (Hierarchical Navigable Small World) und schreibt diese auf ein lokales SSD-Volume, sodass der Speicher bei Neustarts erhalten bleibt. Bei kleinen Sammlungen wurden 125 MiB belegt.
agent.py verbindet sie in weniger als 100 Zeilen ohne Agent- Framework. Es ruft Ollama über HTTP mit requests und kommuniziert mit der VectorAI-Datenbank über das offizielle SDK unter Python .
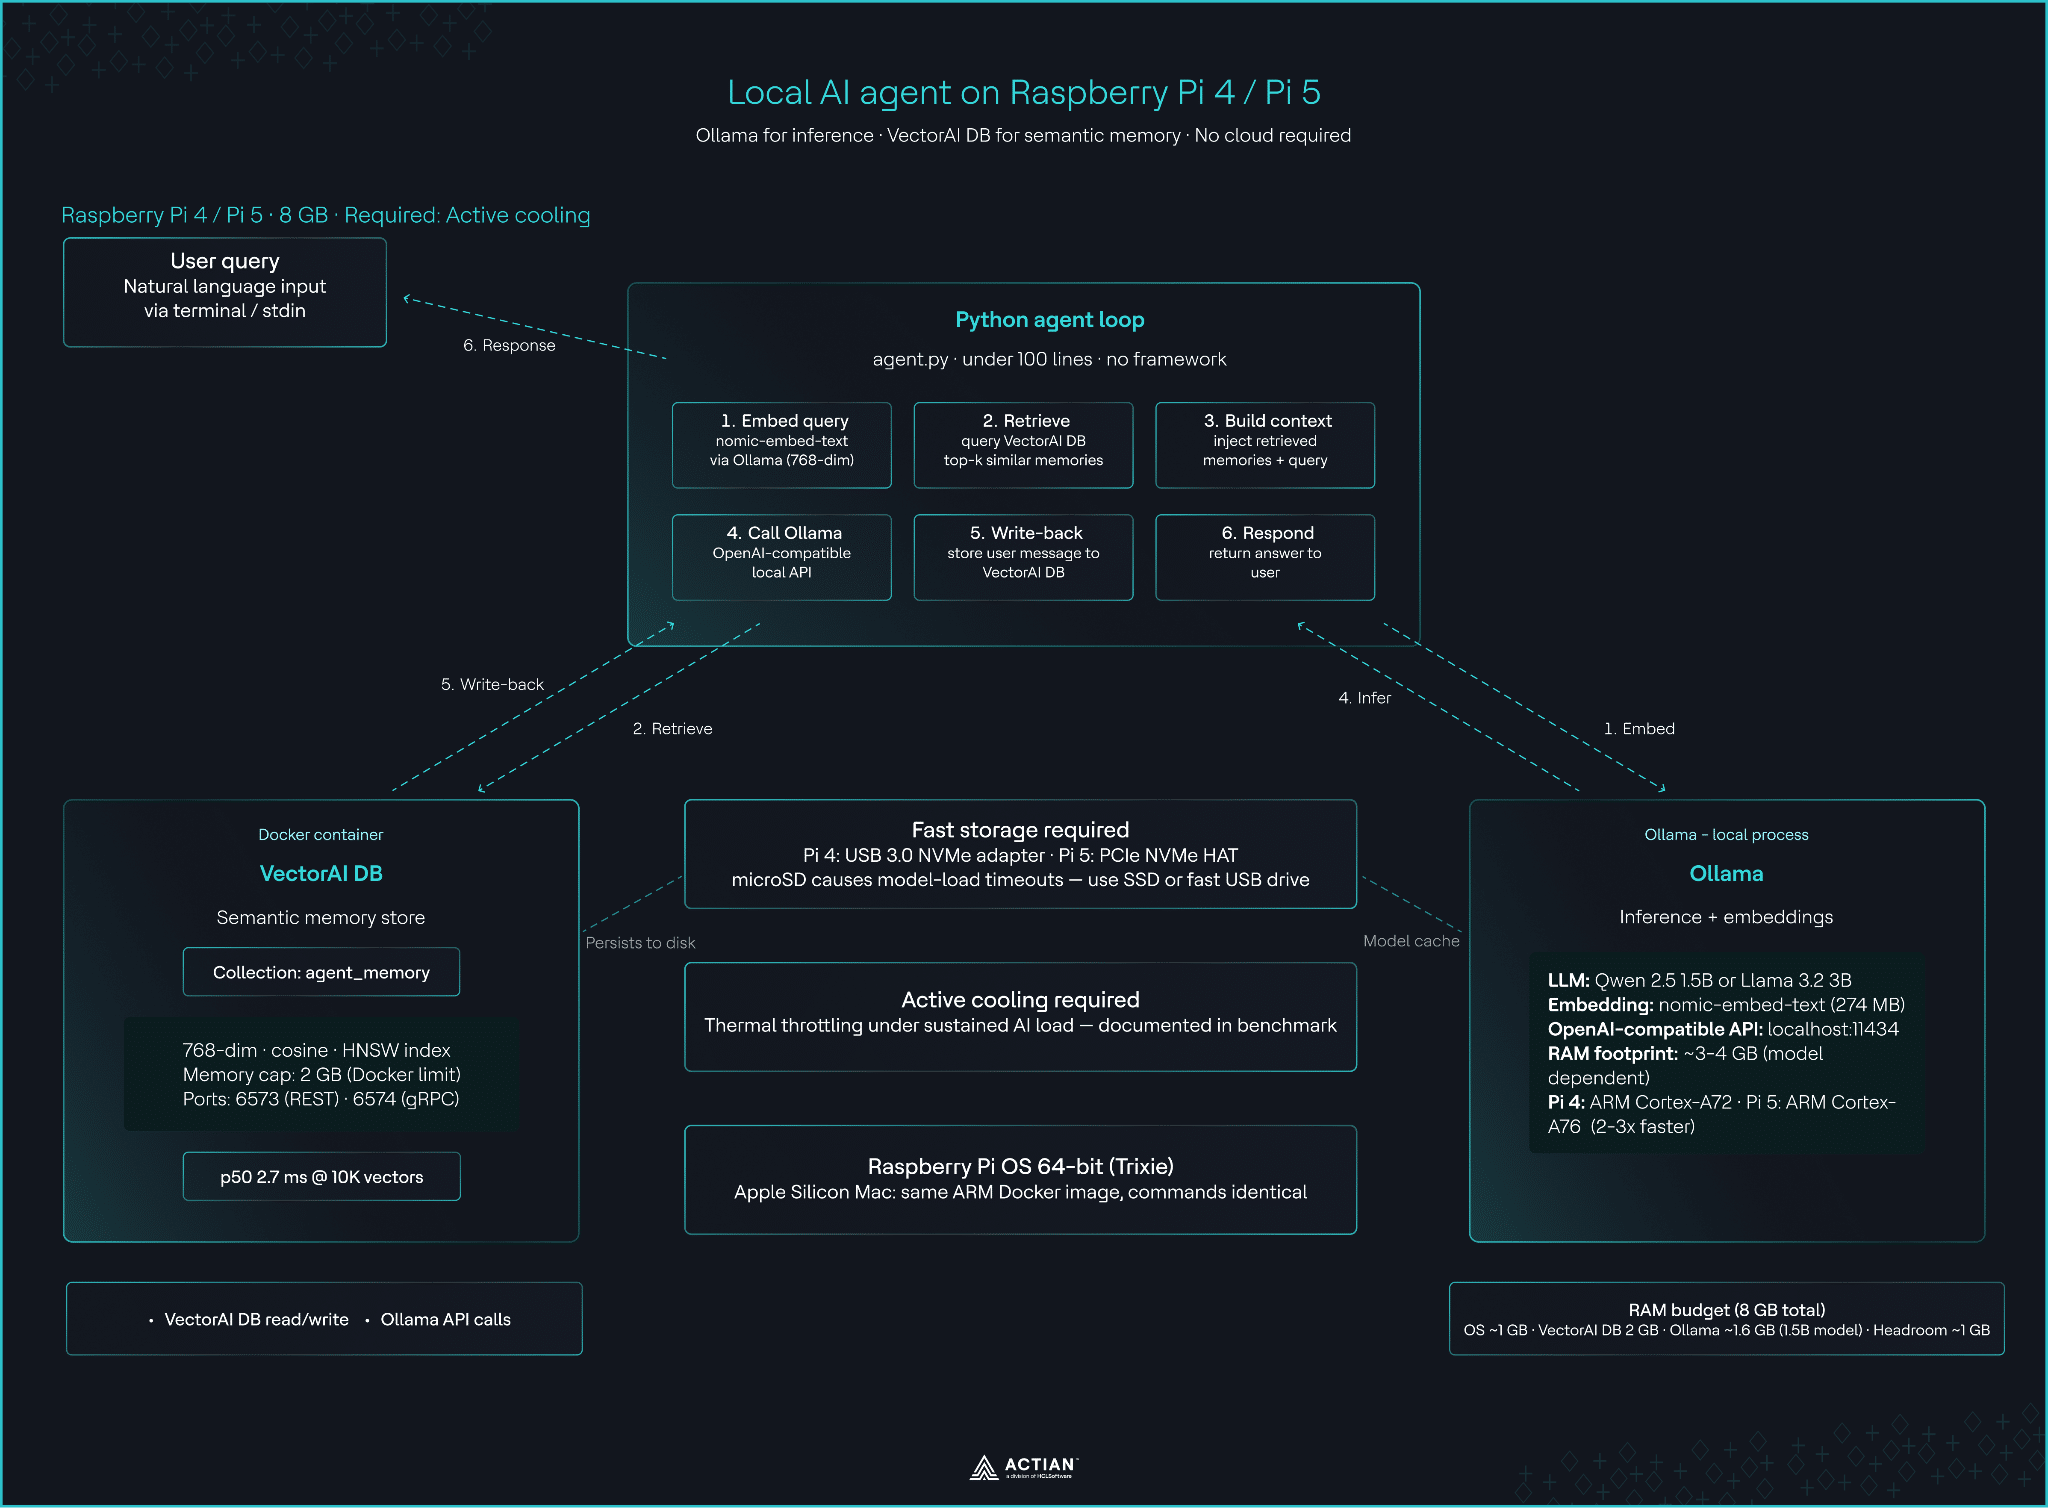
Architekturdiagramm. Sie stellen eine Frage. Der Agent bettet diese ein, ruft relevante Erinnerungen aus der VectorAI-Datenbank ab, fügt sie in die Eingabe ein, ruft Qwen 2.5 1,5B über Ollama auf und speichert Ihre Nachricht wieder in der VectorAI-Datenbank. Der gesamte Stack läuft auf der Platine.
Benötigte Hardware
Verwenden Sie einen Pi 5 mit 8 GB, NVMe-Speicher und aktiver Kühlung. Jeder der folgenden Punkte behebt einen Fehler, auf den Sie andernfalls stoßen würden.
| Teil | Was Sie benötigen |
| Vorstand | Raspberry Pi 5, 8 GB |
| Lagerung | NVMe-SSD auf einem PCIe-HAT |
| Kühlung | Offizieller „Active Cooler“ oder ein gleichwertiges Produkt |
| Leistung | Offizielles 27-W-USB-C-Netzteil |
| Betriebssystem | Raspberry Pi OS 64-Bit (Trixie) |
RAM. Bei geladenen Modellen belegte der Stack insgesamt 2,38 GiB: etwa 630 MB für das Betriebssystem, 1,58 GiB für Ollama, 125 MiB für die VectorAI-Datenbank (179 MiB unmittelbar nach einem Neustart) und der Rest für den Agentenprozess. Eine 4-GB-Karte könnte diese Konfiguration möglicherweise ausführen, wir haben dies jedoch nicht getestet.
NVMe. Der Test-Pi bootet von der microSD-Karte und speichert lediglich die Modell- und Vektordaten auf dem NVMe-Laufwerk. Ausgehend von einem vorgewärmten Cache, qwen2.5:1.5b in 3,1 Sekunden neu geladen und nomic-embed-text in 0,26 Sekunden. Unmittelbar nach einem Neustart benötigte Qwen 4,4 Sekunden zum Laden. Der Pi 5 läuft standardmäßig mit PCIe der Generation 2. Der Benchmark wurde mit Generation 3 durchgeführt, was man mit einer einzigen Zeile aktivieren kann.
echo "dtparam=pciex1_gen=3" | sudo tee -a /boot/firmware/config.txt
sudo reboot
Kühlung. Während des 100K-Benchmarks stieg die Temperatur des SoC von 46,6 °C auf 68,6 °C und vcgencmd get_throttled gemeldet 0x0 vorher und nachher, sodass der „ CPU “ nie gedrosselt wurde. Bei einem früheren 100K-Lauf erreichte der SoC eine Höchsttemperatur von 77,4 °C bei einer Lüfterdrehzahl von 8.731 U/min. Der Pi 5 beginnt bei 80 °C mit der Drosselung seiner „ CPU “, sodass ein passiver Kühlkörper diesen Schwellenwert wahrscheinlich überschreiten würde. Ein früherer Lauf mit einem schwächeren Netzteil zeigte 0x50000 (Unterspannung); das Problem wurde durch das offizielle 27-W-Netzteil behoben.
Kein Pi: Ein Apple-Silicon-Mac führt dieselben arm64-Images und alle hier aufgeführten Befehle aus. Ihre Latenzwerte werden niedriger sein, vergleichen Sie diese daher nicht direkt mit den Ergebnissen des Pi.
Schritt 1: Starten Sie VectorAI DB und Ollama
Aktivieren Sie zunächst die Speicherbegrenzungen. Das Raspberry Pi OS startet mit deaktivierter Speicher-cgroup, sodass Docker diese stillschweigend ignoriert. mem_limit bis man es einschaltet:
sudo sed -i '1 s/$/ cgroup_enable=memory/' /boot/firmware/cmdline.txt
sudo reboot
Nach dem Neustart, docker info sollte keine Warnung mehr anzeigen No memory limit support.
Erstellen Sie das Projektverzeichnis:
mkdir -p pi5-vectorai-agent && cd pi5-vectorai-agent
mkdir -p data ollama results
sudo chown 999:999 data     # VectorAI DB runs as UID 999 and crash-loops on a root-owned mount
Als … speichern:docker-compose.yml
services:
  vectorai:
    image: actian/vectorai:latest
    container_name: vectorai
    # the licence is tied to the host identity; a fixed hostname keeps it valid when the container is recreated
    hostname: vectorai
    ports:
      - "6573:6573" # REST
      - "6574:6574" # gRPC
    volumes:
      # vector data persists across restarts
      - ./data:/var/lib/actian-vectorai
    environment:
      - VECTORAI_LOG_LEVEL=info
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    mem_limit: 2g
    restart: unless-stopped

  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    ports:
      - "11434:11434"
    volumes:
      - ./ollama:/root/.ollama
    mem_limit: 4g
    restart: unless-stopped
Starten Sie beide Dienste:
docker compose up -d
docker ps
Beide Container sollten Folgendes anzeigen: Up. Der Startvorgang von VectorAI DB dauert etwa 15 Sekunden. Wenn Sie eine Lizenz hinzufügen möchten, tun Sie dies jetzt. Das spätere Neuerstellen des Containers (beispielsweise mit --force-recreate) macht sie ungültig.
Schritt 2: Die Modelle abrufen
qwen2.5:1.5b ist etwa 1,1 GB groß und nomic-embed-text ca. 274 MB:
docker exec ollama ollama pull qwen2.5:1.5b
docker exec ollama ollama pull nomic-embed-text
Mit „Pulling“ werden lediglich die Modelle heruntergeladen. Ollama lädt jedes Modell bei der ersten Verwendung in den Arbeitsspeicher und hält es dort noch fünf Minuten nach der letzten Anfrage (Ollama-Standardeinstellung) geladen, sodass die erste Nachricht nach einer Pause etwas länger dauert.
Schritt 3: Installieren Sie die Abhängigkeiten von „ Python “
Dieses Projekt nutzt „uv“, das die virtuelle Umgebung verwaltet und eine kompatible „ Python “ für Sie installiert. So installieren Sie es:
curl -LsSf https://astral.sh/uv/install.sh | sh
source $HOME/.local/bin/env
Als … speichern pyproject.toml im Projektverzeichnis:
[project]

name = "pi5-vectorai-agent"
version = "0.1.0"
description = "Offline AI agent with semantic memory on a Raspberry Pi 5: Ollama + Actian VectorAI DB"
requires-python = ">=3.11"
# uv run agent.py reads this, creates .venv and installs these on first run
dependencies = [
    "requests",                # Ollama's HTTP API
    "actian-vectorai-client",  # VectorAI DB client (gRPC); brings numpy, protobuf, grpcio
    "numpy",                   # benchmark vectors
    "matplotlib",              # benchmark chart only
]
Erstellen Sie anschließend die Umgebung:
uv syncuv sync lautet pyproject.toml, erzeugt .venv, und installiert die vier Pakete. Von nun an beginnen Sie jeden Befehl „ Python “ mit uv run; es gibt keine Umgebung, die aktiviert werden muss. numpy und matplotlib dienen ausschließlich dem Benchmark und der Grafik.
Schritt 4: Funktionstest beider Dienste
Vergewissern Sie sich, dass beide Dienste reagieren, bevor Sie den Agent-Code schreiben:
uv run python -c 'from actian_vectorai import VectorAIClient

with VectorAIClient("localhost:6574") as c: print(c.health_check())'


curl -s http://localhost:11434/api/embed \
  -d '{"model":"nomic-embed-text","input":"hello"}' | head -c 120

curl -s http://localhost:11434/api/generate \
  -d '{"model":"qwen2.5:1.5b","prompt":"Say hi in five words.","stream":false}'
{'title': 'Actian VectorAI DB', 'version': 'Actian VectorAI DB 1.0.2 / VDE 1.0.2'}

{"model":"nomic-embed-text","embeddings":[[0.017874617,-0.0058246492,-0.17537898,...

{"model":"qwen2.5:1.5b",...,"response":"Hello there!","done":true,...}
RAM-Speicher bei geladenen Modellen überprüfen:
docker stats --no-stream --format "{{.Name}}: {{.MemUsage}}"Auf der Testplatine:
ollama: 1.58GiB / 4GiB
vectorai: 125MiB / 2GiB
Wenn in der Spalte „Limit“ statt 4GiB und 2GiB, die in Schritt 1 vorgenommene Änderung an der cgroup wurde nicht übernommen.
Schritt 5: Erstellen Sie die Erinnerungssammlung
Erstellen Sie eine Sammlung in der Größe von nomic-embed-textdie 768-dimensionalen Vektoren:
uv run python - <<'EOF'

from actian_vectorai import VectorAIClient, VectorParams, Distance
with VectorAIClient("localhost:6574") as client:

    client.collections.create(

        "agent_memory",

        vectors_config=VectorParams(size=768, distance=Distance.Cosine),

    )

EOF
Dieser Schritt ist optional; der Agent legt die Sammlung beim ersten Ausführen an. Wenn Sie ihn jetzt ausführen, wird überprüft, ob die Datenbank Schreibvorgänge akzeptiert. (setup.sh macht dasselbe über die REST-API auf Port 6573.)
Schritt 6: Den Agenten erstellen
Als … speichern agent.py:
Speichere dies unter dem Namen „agent.py“:
"""Local AI agent with semantic memory: Ollama (Qwen 2.5 1.5B) + Actian VectorAI DB."""

import os

import sys

import time

import requests

from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams

OLLAMA = "http://localhost:11434"

VECTORAI = "localhost:6574"

CHAT_MODEL = "qwen2.5:1.5b"

EMBED_MODEL = "nomic-embed-text"

EMBED_DIM = 768            # nomic-embed-text output size

COLLECTION = "agent_memory"

TOP_K = 3

MIN_SCORE = 0.6            # unrelated memories score ~0.3-0.55 with nomic-embed-text, related ones 0.7+


def embed(text: str) -> list[float]:

    r = requests.post(f"{OLLAMA}/api/embed", json={"model": EMBED_MODEL, "input": text}, timeout=60)

    r.raise_for_status()

    return r.json()["embeddings"][0]


def chat(messages: list[dict]) -> str:

    # Ollama exposes an OpenAI-compatible endpoint, so any OpenAI client works here too

    r = requests.post(f"{OLLAMA}/v1/chat/completions", timeout=300,

                      json={"model": CHAT_MODEL, "messages": messages, "temperature": 0.3})

    r.raise_for_status()

    return r.json()["choices"][0]["message"]["content"]


# Tell the model what it runs on, so "what hardware is this?" gets a real answer

MODEL_FILE = "/proc/device-tree/model"

BOARD = open(MODEL_FILE).read().strip("\x00\n ") if os.path.exists(MODEL_FILE) else "unknown board"

HARDWARE = f"{BOARD}, {os.sysconf('SC_PAGE_SIZE')  os.sysconf('SC_PHYS_PAGES') / 1024*3:.0f} GB RAM"


def step(db: VectorAIClient, user_msg: str) -> str:

    # 1. Embed the incoming query on the Pi CPU

    t0 = time.perf_counter()

    qvec = embed(user_msg)

    t1 = time.perf_counter()

    # 2. Retrieve the closest past exchanges from VectorAI DB (HNSW index)

    hits = db.points.search(COLLECTION, vector=qvec, limit=TOP_K, with_payload=True)

    t2 = time.perf_counter()

    memories = [h.payload["text"] for h in hits if h.score >= MIN_SCORE]

    # 3. Inject retrieved memories into the system prompt, labelled as past notes

    #    so a small model doesn't mistake them for the current message

    context = "\n".join(f"- {m}" for m in memories) or "- (none)"

    messages = [

        {"role": "system", "content": f"You are a helpful assistant running fully offline on {HARDWARE} "

         f"with {CHAT_MODEL} via Ollama and Actian VectorAI DB for memory.\n"

         "Every message the user sends is saved to your memory automatically. If the user tells you "

         "a fact, confirm in one sentence that you will remember it.\n"

         "Answer in 1-3 sentences. Only use the notes below if they help answer the current message.\n\n"

         "Notes from earlier conversations:\n" + context},

        {"role": "user", "content": user_msg},

    ]


    # 4. Local inference through Ollama

    answer = chat(messages)

    t3 = time.perf_counter()


    # 5. Write the user's message back so future sessions can recall it. Only the user's

    #    side is stored: the facts come from the user, and storing the model's own replies

    #    would feed any wrong answer back into later prompts. The query vector is reused.

    db.points.upsert(COLLECTION, [PointStruct(

        id=time.time_ns() // 1000,  # microsecond timestamp as a unique integer ID

        vector=qvec,

        payload={"text": f"User said: {user_msg}", "ts": time.time()},

    )])

    t4 = time.perf_counter()


    print(f"
")

    return answer


def main() -> None:

    with VectorAIClient(VECTORAI) as db:

        if db.collections.exists(COLLECTION):

            # VectorAI DB keeps collections on disk but only loads them when opened;

            # without this, search and count fail after every DB restart

            db.vde.open_collection(COLLECTION)

        else:

            db.collections.create(COLLECTION, vectors_config=VectorParams(size=EMBED_DIM, distance=Distance.Cosine))

        print(f"Agent ready on {HARDWARE} | LLM: {CHAT_MODEL} | "

              f"{db.points.count(COLLECTION)} memories in VectorAI DB. Ctrl+C to quit.")

        if len(sys.argv) > 1:  # one-shot mode: python agent.py "your question"

            print(step(db, " ".join(sys.argv[1:])))

            return

        try:  # Ctrl+C quits cleanly, even mid-answer

            while True:

                user_msg = input("\nyou> ").strip()

                if user_msg:

                    print(f"agent> {step(db, user_msg)}")

        except (EOFError, KeyboardInterrupt):

            print()


if name == "__main__":

    main()
Jede Runde besteht aus fünf Phasen:
einbetten. nomic-embed-text wandelt Ihre Nachricht in einen 768-dimensionalen Vektor auf dem „ CPU “ des Pi um – in etwa 80 ms, sobald das Modell aufgewärmt ist. Derselbe Vektor wird für das Zurückschreiben wiederverwendet, sodass jede Nachricht eine Einbettung kostet.
Abrufen. VectorAI DB gibt die drei gespeicherten Nachrichten zurück, die Ihrer Frage am nächsten kommen – je höher der Ähnlichkeitswert, desto näher liegt die Nachricht an Ihrer Frage. Der Agent behält nur diejenigen bei, die einen Wert von 0,6 oder höher erreichen. Im Test „Pi“ erreichten Nachrichten zum gleichen Thema wie die Frage einen Wert von 0,7 oder höher, während nicht themenbezogene Nachrichten Werte zwischen 0,3 und 0,55 erzielten; 0,6 liegt also genau in der Lücke dazwischen. Wenn Sie eine Frage zum Allgemeinwissen stellen, zu der es im Speicher keinen Bezug gibt, übermittelt der Agent keine Erinnerungen an das Modell.
Einfügen. Erinnerungen werden unter der Bezeichnung „Notizen aus früheren Gesprächen“ in die System-Eingabeaufforderung übernommen. Ein 1,5-Milliarden-Modell benötigt diese Bezeichnung. Ohne sie verwechseln kleinere Modelle alte Notizen mit der aktuellen Nachricht.
Generieren. Die Eingabe wird an Ollamas OpenAI-kompatibles System gesendet /v1/chat/completions Endpunkt. Durch die Begrenzung der Antworten auf ein bis drei Sätze bleibt die Inferenzzeit von „ CPU “ vorhersehbar. Qwen 2.5 1,5B lief mit 12,1 Token pro Sekunde, was bei allen drei Durchläufen identisch war.
Speichern. Es wird nur Ihre Nachricht gespeichert, niemals die Antwort des Modells, sodass eine falsche Antwort nicht in spätere Eingabeaufforderungen einfließen kann. Die ID ist ein Zeitstempel im Mikrosekundenbereich, der die Eindeutigkeit der Einträge auch ohne ID-Generator gewährleistet.
Ausführen:
uv run agent.pyBeharrlichkeit. Der Speicher bleibt auch nach einem Neustart erhalten, da VectorAI DB in die ./data auf der SSD. Nach einem Neustart der Datenbank verbleibt eine Collection auf der Festplatte, wird jedoch erst geladen, wenn die Anwendung sie öffnet, weshalb main() Anrufe db.vde.open_collection(). Ohne diesen Aufruf schlagen „search“ und „count“ nach jedem Neustart fehl. Um dies zu testen, gib dem Agenten eine Tatsache an, beende das Programm und führe docker compose restart vectorai, starte den Agenten erneut und erkundige dich danach.
Informationen dazu, wie Agenten Speicherplatz verwalten, priorisieren und freigeben, finden Sie in den Artikeln „Was ist Agentenspeicher? Architektur“ und „ Deployment smuster“.
Der Maßstab
Auf dem Test-Pi 5 lieferte VectorAI DB die Top-5-Ergebnisse aus 100.000 Vektoren in 4,17 ms bei p50 und 4,98 ms bei p99. So lässt sich das Ergebnis reproduzieren.
Verfahren
- Hardware: Raspberry Pi 5 Model B Rev 1.1, 8 GB; bootet von einer microSD-Karte; Kingston NV3 500 GB (SNV3SM3500G) NVMe auf einem Raspberry Pi M.2 HAT+ (SC1166) mit PCIe Gen 3 (8,0 GT/s), auf dem
data/undollama/; offizieller Active Cooler; Raspberry Pi OS 64-Bit (Trixie), Kernel 6.18.50+rpt-rpi-2712; VectorAI DB 1.0.2 auf 2 GB begrenzt; Ollama läuft mit beiden geladenen Modellen. - Korpusgrößen: 1.000, 10.000 und 100.000 Vektoren, jeweils in einer neuen Sammlung. Für die 10K- und 100K-Läufe wurde eine lizenzierte Instanz verwendet.
- Vektoren: 768 Dimensionen, einheitsnormalisiert, Kosinus-Abstand, Standard-HNSW-Parameter der VectorAI-Datenbank.
- Abfragen: 10 Aufwärmsuchen, anschließend 100 zeitlich begrenzte Top-5-Suchen pro Korpusgröße.
Bei den Vektoren handelt es sich um synthetische Zufalls-Einheitsvektoren und nicht um echte Text-Embeddings. Echte Embeddings werden nach Themen gruppiert ( Cluster ), was die Suche für HNSW vereinfacht; daher stellen diese Zahlen eine konservative Schätzung dessen dar, was Sie in der Produktion beobachten würden.
benchmark.py lädt jedes Korpus in Chargen zu je 500 Einträgen, führt die Suchvorgänge durch und erstellt eine CSV-Datei, in der auch die Platine, der Arbeitsspeicher, das Speichergerät, die Endtemperatur und der Drosselungsstatus erfasst werden:
"""Retrieval latency benchmark for VectorAI DB on Raspberry Pi 5.

Loads 1K / 10K / 100K vectors (768-dim, same size as nomic-embed-text), runs

100 timed top-k searches per corpus size, and writes p50/p95/p99 to CSV.

Vectors are synthetic (random, unit-normalized) so the 100K load finishes in

minutes instead of hours of on-device embedding. Random vectors are a harder

case for HNSW than real text embeddings, so treat these numbers as conservative.
The free Community edition caps the server at 5,000 vectors; without a licence

run it with --sizes 1000 2000 4000.


Usage: python benchmark.py [--sizes 1000 10000 100000] [--queries 100]

"""

import argparse

import csv

import platform

import statistics

import subprocess

import time

from pathlib import Path


import numpy as np

from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams


DIM = 768

TOP_K = 5

BATCH = 500

WARMUP = 10


def hardware() -> dict:

    def read(path: str) -> str:

        try:

            return Path(path).read_text().strip("\x00\n ")

        except OSError:

            return "unknown"


    def cmd(*args: str) -> str:

        try:

            return subprocess.run(args, capture_output=True, text=True, timeout=5).stdout.strip()

        except (OSError, subprocess.SubprocessError):

            return "unknown"


    mem_kb = next((line.split()[1] for line in read("/proc/meminfo").splitlines() if line.startswith("MemTotal")), "0")

    # ask Docker where the vectorai container keeps its data, so the CSV names the drive

    # the database actually writes to (the NVMe), wherever this script was cloned

    data_dir = cmd("docker", "inspect", "-f", '{{range .Mounts}}{{if eq .Destination "/var/lib/actian-vectorai"}}'

                   '{{.Source}}{{end}}{{end}}', "vectorai") or str(Path(__file__).resolve().parent / "data")

    return {

        "board": read("/proc/device-tree/model"),

        "arch": platform.machine(),

        "kernel": platform.release(),

        "ram_gb": round(int(mem_kb) / 1024 / 1024, 1),

        "storage": cmd("findmnt", "-no", "SOURCE", "-T", data_dir) or "unknown",

        # vcgencmd prints "temp=48.3'C" / "throttled=0x0"; keep only the value

        "temp": cmd("vcgencmd", "measure_temp").split("=")[-1],

        "throttled": cmd("vcgencmd", "get_throttled").split("=")[-1],  # 0x0 means no throttling since boot

    }


def unit_vectors(n: int, rng: np.random.Generator) -> np.ndarray:

    v = rng.standard_normal((n, DIM)).astype(np.float32)

    return v / np.linalg.norm(v, axis=1, keepdims=True)


def load(db: VectorAIClient, name: str, n: int, rng: np.random.Generator) -> float:

    if db.collections.exists(name):

        db.collections.delete(name)

    db.collections.create(name, vectors_config=VectorParams(size=DIM, distance=Distance.Cosine))

    t0 = time.perf_counter()

    for start in range(0, n, BATCH):

        vecs = unit_vectors(min(BATCH, n - start), rng)

        db.points.upsert(name, [

            PointStruct(id=start + i, vector=v.tolist(), payload={"i": start + i})

            for i, v in enumerate(vecs)

        ])

    return time.perf_counter() - t0


def measure(db: VectorAIClient, name: str, queries: int, rng: np.random.Generator) -> list[float]:

    qs = unit_vectors(queries + WARMUP, rng).tolist()

    for q in qs[:WARMUP]:  # first searches load the collection into memory

        db.points.search(name, vector=q, limit=TOP_K)

    lat = []

    for q in qs[WARMUP:]:

        t0 = time.perf_counter()

        db.points.search(name, vector=q, limit=TOP_K)

        lat.append((time.perf_counter() - t0) * 1000)

    return lat


def pct(values: list[float], p: float) -> float:

    return float(np.percentile(values, p))


def main() -> None:

    ap = argparse.ArgumentParser()

    # Community edition (no licence) is capped at 5K vectors: use --sizes 1000 2000 4000

    ap.add_argument("--sizes", type=int, nargs="+", default=[1_000, 10_000, 100_000])

    ap.add_argument("--queries", type=int, default=100)

    ap.add_argument("--host", default="localhost:6574")

    ap.add_argument("--out", default="results/benchmark.csv")

    ap.add_argument("--keep", action="store_true", help="keep benchmark collections afterwards")

    args = ap.parse_args()


    hw = hardware()

    print("Hardware:", ", ".join(f"{k}={v}" for k, v in hw.items()))

    rng = np.random.default_rng(42)

    rows = []


    with VectorAIClient(args.host) as db:

        for n in args.sizes:

            name = f"bench_{n}"

            print(f"\n== {n:,} vectors ==")

            load_s = load(db, name, n, rng)

            print(f"  loaded in {load_s:.1f} s ({n / load_s:,.0f} vectors/s)")

            lat = measure(db, name, args.queries, rng)

            row = {

                "vectors": n, "dim": DIM, "top_k": TOP_K, "queries": len(lat),

                "p50_ms": round(pct(lat, 50), 2), "p95_ms": round(pct(lat, 95), 2),

                "p99_ms": round(pct(lat, 99), 2), "mean_ms": round(statistics.mean(lat), 2),

                "max_ms": round(max(lat), 2), "load_s": round(load_s, 1),

            }

            rows.append(row)

            print(f"  p50 {row['p50_ms']} ms | p95 {row['p95_ms']} ms | p99 {row['p99_ms']} ms")

            if not args.keep:

                db.collections.delete(name)


    hw_after = hardware()

    out = Path(args.out)

    out.parent.mkdir(parents=True, exist_ok=True)

    with out.open("w", newline="") as f:

        w = csv.DictWriter(f, fieldnames=list(rows[0]) + ["board", "ram_gb", "storage", "temp_end", "throttled_end"])

        w.writeheader()

        for r in rows:

            w.writerow({**r, "board": hw["board"], "ram_gb": hw["ram_gb"], "storage": hw["storage"],

                        "temp_end": hw_after["temp"], "throttled_end": hw_after["throttled"]})

    print(f"\nWrote {out}. End state: temp={hw_after['temp']}, throttled={hw_after['throttled']}")


if name == "__main__":

    main()
Führen Sie den Befehl aus und zeichnen Sie anschließend das Diagramm:
uv run benchmark.py                          # licensed: 1K / 10K / 100K

uv run benchmark.py --sizes 1000 2000 4000   # Community edition

uv run plot_benchmark.py                     # writes results/benchmark.png
Ergebnisse
| Vektoren | S. 50 (ms) | S. 95 (Manuskript) | S. 99 (Manuskript) | Ladezeit |
| 1,000 | 2 | 1.97 | 2.01 | 0.4 s |
| 10,000 | 3 | 3.12 | 3.47 | 28.7 s |
| 100,000 | 4 | 4.75 | 4.98 | 526 s (8,8 Min.) |
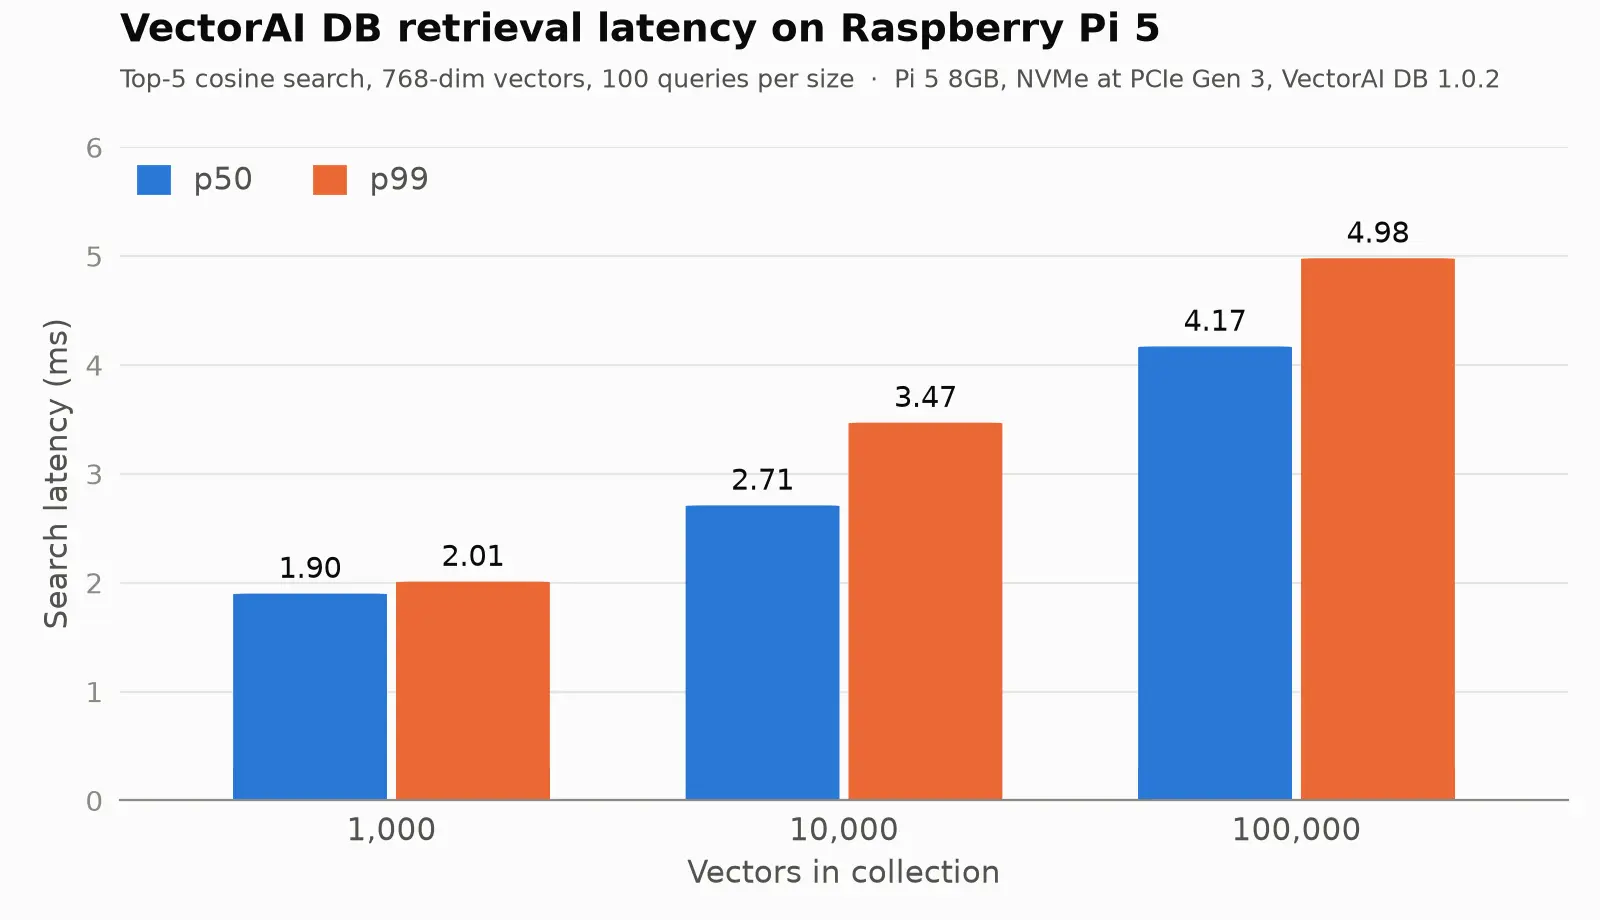
Latenz von p50 und p99 im Vergleich zur Korpusgröße (results/benchmark.png)
Holen Sie sich VectorAI DB Community Edition und führen Sie denselben Benchmark auf Ihrer eigenen Platine durch.
Ein 100-mal größerer Korpus erhöhte die p50-Latenz von 1,90 auf 4,17 ms, was einer Steigerung um das 2,2-Fache entspricht, während der p99-Wert unter 5 ms blieb. Diese Zahlen stammen von einem Board mit PCIe Gen 3 (aktiviert im Abschnitt „On NVMe“ oben). Der Benchmark wurde nicht mit Gen 2 durchgeführt, da dort insbesondere die Ladezeiten länger sein könnten. Das Laden von 100.000 Vektoren dauerte 526 Sekunden, was etwa 190 Vektoren pro Sekunde entspricht – ein einmaliger Aufwand; der Agent fügt jeweils einen Speicher in 6 ms hinzu. Die Temperatur des SoC stieg während des Durchlaufs von 46,6 °C auf 68,6 °C an, und vcgencmd get_throttled gemeldet 0x0 vorher und nachher.
Für Ihren Agenten stellt das Abrufen der Daten keinen Engpass dar. Im Einleitungsbeispiel Demo dauerte die Suche 1,8 ms, das Embedding 83 ms und die Inferenz 3,6 Sekunden. Der Großteil der Wartezeit entfällt auf das Sprachmodell.
Wenn du an die Grenzen des Pi stößt
Ein Pi 5 kann einen Agenten mit einem 1,5-Milliarden-Modell problemlos ausführen. Bei höheren Anforderungen sollte die Inferenz außerhalb des Boards erfolgen.
Was der Pi nicht gut bewältigt:
- Multi-Agent-Konfigurationen. Zwei Agenten, die sich eine Qwen-Instanz teilen, arbeiten abwechselnd, sodass sich die Antwortzeit in etwa verdoppelt.
- Größere Modelle. Ein 7B-Modell mit 4-Bit-Quantisierung benötigt allein für die Gewichte etwa 4,5 GB, was über der Obergrenze von 4 GB bei Ollama liegt.
- Bildverarbeitungsaufgaben. Multimodale Modelle sind umfangreicher und langsamer – auf einem Pi CPU sind sie für eine interaktive Schleife zu langsam.
Kompromisse, die Sie vor dem Bau kennen sollten:
- Das „ Python “-SDK nutzt gRPC. Der Agent-Code läuft über das offizielle „ Python “- oder JavaScript-SDK auf Port 6574. Die REST-API auf Port 6573 ist für die Einrichtung und Lizenzierung zuständig.
- Die Obergrenze von 2 GB liegt unter den allgemeinen Empfehlungen von Actian. In der Installationsanleitung werden für eine typische „ Deployment “ 8 GB RAM angegeben. Auf dem Test-Pi blieb der Container bei kleinen Korpusgrößen deutlich unter der Obergrenze; die Auslastung bei 100.000 Vektoren wurde nicht gemessen.
- Bei der Community-Edition ist die Anzahl der gesammelten Vektoren auf 5.000 begrenzt. Mit jeder gesendeten Nachricht erhöht sich diese Zahl um eins, sodass ein vielbeschäftigter Mitarbeiter diese Obergrenze innerhalb weniger Wochen erreicht. In der 30-tägigen Testversion entfällt diese Begrenzung.
- Auch Fragen werden gespeichert. Der Agent speichert jede Nachricht, einschließlich der Fragen. Im Laufe der Monate kann eine ältere Frage die Information, die Sie für einen der drei Abrufplätze benötigen, in der Rangfolge übertrumpfen. Bei einem langfristig eingesetzten Agenten sollten Sie daher nur Aussagen speichern oder Nachrichten mit Tags versehen und beim Abruf filtern.
Wann sollte man auf Jetson Orin umsteigen? Bei Produktionsumgebungen mit mehreren Kameras, 7B+-Modellen oder mehreren gleichzeitig laufenden Agenten bietet ein Jetson Orin eine zusätzliche GPU und mehr Arbeitsspeicher bei vergleichbarer Größe im Edge-Bereich. VectorAI DB läuft dort auf demselben arm64-Image und mit derselben API, sodass Ihr Agent-Code unverändert bleibt.
Verwenden Sie den Pi als Abrufknoten. Verwenden Sie den Pi als Abrufknoten. Behalten Sie die VectorAI-Datenbank auf dem Pi und leiten Sie die Modellaufrufe an einen leistungsstärkeren Rechner in Ihrem Netzwerk weiter, indem Sie eine Konstante in agent.py:
OLLAMA = "http://192.168.1.50:11434" # inference box on your LANDadurch werden sowohl die Einbettung als auch die Inferenz auf diesen Rechner verlagert. Starten Sie dort Ollama mit OLLAMA_HOST=0.0.0.0 So akzeptiert es Verbindungen vom Pi und ruft dort beide Modelle ab. Die Speicherung und der Abruf erfolgen auf dem Gerät in der Nähe Ihrer Sensoren, und es verlassen keine Daten Ihr Netzwerk.
Fazit
Der in diesem Tutorial erstellte Agent leistet etwas, was die meisten lokalen LLM-Konfigurationen nicht können. Als er die Frage zum Gewächshaus im Einführungs Demo beantwortete, stammten beide Fakten aus einer Sitzung, die bereits beendet worden war und deren Datenbank zwischen den beiden Durchläufen neu gestartet worden war. Der Abruf dauerte 1,8 Millisekunden.
Dieses Ergebnis ist auf das Zusammenspiel dreier Entscheidungen zurückzuführen: Die Modelle werden lokal ausgeführt, sodass keine Daten das Board verlassen; der Speicher wird als Vektoren gespeichert, sodass der Abruf semantisch und nicht auf exakte Übereinstimmung basiert; und als Speicherschicht wird VectorAI DB verwendet, sodass die gespeicherten Daten auch nach einem Neustart erhalten bleiben und die Kapazität ohne Codeänderung auf 100.000 Einträge skaliert werden kann.
Das gleiche arm64-Image und die gleiche API laufen auf einem Jetson Orin oder einem On-Premises -Server. Ihr agent.py ändert sich nicht, wenn man dorthin zieht. Die einzige Zeile, die sich ändert, ist OLLAMA, falls Sie die Inferenz vom Pi auf einen leistungsstärkeren Rechner in Ihrem LAN auslagern möchten. Registrieren Sie sich für die VectorAI DB Community Edition, lies den Anleitung zur Installation von Docker, und mach mit bei der Actian-Community auf Discord um zu sehen, was andere auf Edge-Hardware entwickeln.
FAQ
Kann ein Raspberry Pi 5 einen vollständigen KI-Agenten lokal ausführen?
Ja. Ein Raspberry Pi 5 mit 8 GB RAM kann einen vollständigen Agenten ohne Verbindung zu Cloud ausführen. Ollama stellt Qwen 2.5 1.5B unter CPU bereit, nomic-embed-text wandelt Nachrichten in Vektoren um, und die VectorAI-Datenbank speichert das Langzeitgedächtnis. Auf der Testplatine rief der Agent relevante Erinnerungen in 1,8 ms ab und gab die Antwort in 3,6 Sekunden; Qwen läuft auf dieser Platine mit 12,1 Tokens pro Sekunde. Verwenden Sie NVMe-Speicher, aktive Kühlung und das offizielle 27-W-Netzteil, um die Leistung unter Dauerbelastung stabil zu halten.
Welche Vektordatenbank eignet sich am besten für einen Raspberry Pi?
Für diese Konfiguration eignet sich Actian VectorAI DB hervorragend. Die Datenbank unterstützt arm64, speichert Daten dauerhaft auf der Festplatte und nutzt HNSW für die ungefähre Suche nach dem nächsten Nachbarn. Auf dem Raspberry Pi 5 lieferte sie bei einer Speicherbegrenzung von 2 GB die fünf besten Ergebnisse aus 100.000 Vektoren in 4,12 ms (p50). Dank der lokalen Speicherung bleiben die Daten des Agenten auch nach einem Neustart der Datenbank erhalten.
Wird VectorAI DB auf ARM-Hardware unterstützt?
Ja. Die offizielle actian/vectorai Das Docker-Image ist sowohl für amd64 als auch für arm64 verfügbar, daher docker pull actian/vectorai:1.0.2 Liefert eine native Ausführung auf einem Pi 5, einem NVIDIA Jetson oder einem Apple-Silicon-Mac – ganz ohne Emulation. Die gleichen „ Python “- und JavaScript-SDKs sowie APIs funktionieren auf jeder Plattform, sodass der Code, den Sie auf einem Laptop schreiben, unverändert auf Edge-Hardware läuft.
Bleiben Sie in Verbindung
Datenanalysen direkt bei Ihnen.
(z. B. sales@..., support@...)
