

Vertrauen Sie nicht mehr auf Ihre Cache-Trefferquote. 7 Tests zeigen, warum.


Wichtigste Erkenntnisse
- Eine hohe semantische Cache-Trefferquote bedeutet nicht automatisch, dass die Antworten korrekt sind. Messen Sie daher neben der Trefferquote, der Latenz und den Kosteneinsparungen auch die Falsch-Positiv-Rate.
- In den Tests von Banking77 führte ein Ähnlichkeitsschwellenwert von 0,83 bei den zurückbehaltenen Abfragen zu einer Falsch-Positiv-Rate von 4,8 % bei einer Trefferquote von 70,1 %; Schwellenwerte allein reichen jedoch nicht aus, um Negationen, geänderte Zahlen oder Datumsangaben, mandantenübergreifende Übereinstimmungen oder veraltete Antworten zu erkennen.
- Gezielte Sicherheitsmaßnahmen sind effektiver: genaue Überprüfungen auf Negation und Werte, obligatorische Filter für Mandanten und Absichten, Ungültigmachung veralteter Einträge sowie optionale lokale Überprüfung bei Absichten mit hohem Risiko.
- Legen Sie ein Korrektheitsziel fest, kalibrieren Sie die Schwellenwerte anhand Ihrer eigenen, beschrifteten Abfragen und überprüfen Sie jede Sicherheitsmaßnahme, bevor Sie sie in der Produktion einsetzen.
Semantisches Caching kann die Kosten für große Sprachmodelle (LLM) senken und die Latenz verringern, indem Antworten auf ähnliche Abfragen wiederverwendet werden, anstatt das Modell jedes Mal neu aufzurufen. Wenn Sie einen semantischen Cache betreiben, messen Sie dessen Erfolg wahrscheinlich anhand der Trefferquote und der Anzahl der vermiedenen Modellaufrufe. Ein Cache-Treffer garantiert jedoch keine korrekte Antwort. Ein Cache kann eine überzeugende, aber irrelevante Antwort zurückgeben und dennoch eine gute Trefferquote aufweisen.
Das Problem besteht darin, wie der Cache entscheidet, welche Abfragen ähnlich genug sind, um eine gemeinsame Antwort zu erhalten. Die meisten semantischen Caches verwenden einen Ähnlichkeitsschwellenwert, um diese Entscheidung zu treffen. Wird der Schwellenwert gesenkt, werden mehr Abfragen als übereinstimmend erkannt. Wird er angehoben, lehnt der Cache mehr Übereinstimmungen ab und sendet mehr Anfragen an das Modell.
Wir haben dieses Problem in sieben Tests untersucht, um herauszufinden, wie oft das semantische Caching falsche Ergebnisse liefert und was Sie tun können, um dies zu verhindern. Die Tests prüfen, ob ein Cache zwischen Abfragen unterscheiden kann, die zwar ähnlich aussehen, aber unterschiedliche Antworten erfordern. Wir messen sowohl die Falsch-Positiv-Rate als auch die Trefferquote, anstatt eine höhere Trefferquote automatisch als Verbesserung zu werten.
Wenn Sie LLM-Anwendungen entwickeln oder betreiben, erfahren Sie in diesem Artikel, wie Sie Ihren Cache bewerten können, bevor Sie ihn in der Produktion einsetzen.

TL;DR
- Eine hohe semantische Cache-Trefferquote garantiert keine korrekten Antworten. Messen Sie neben der Trefferquote, der Latenz und den Kosteneinsparungen auch die Falsch-Positiv-Rate (FPR).
- In Tests mit Banking77 ergab sich bei einem Ähnlichkeitsschwellenwert von 0,83 eine FPR von 4,8 % und eine Trefferquote von 70,1 % bei den ausgenommenen Abfragen.
- Ähnlichkeitsschwellenwerte allein können falsche Übereinstimmungen nicht verhindern, die durch Negationen, geänderte Zahlen und Datumsangaben, mandantenübergreifende Abfragen oder veraltete Antworten verursacht werden. Setzen Sie gezielte Prüfungen, Filter und die Cache-Entwertung ein.
- Legen Sie ein Korrektheitsziel fest, testen Sie anhand Ihrer eigenen Abfragen und überprüfen Sie die Sicherheitsvorkehrungen, bevor Sie Ihren semantischen Cache in der Produktion einsetzen.
Das Versprechen zur Trefferquote
Die Trefferquote gibt lediglich an, wie oft der Cache anhand des konfigurierten Schwellenwerts eine Übereinstimmung findet. Sie sagt jedoch nichts darüber aus, ob die gespeicherte Antwort die neue abfragen korrekt beantwortet. Wenn Sie den Schwellenwert lockern, können mehr Abfragen mit bestehenden Einträgen übereinstimmen. Ihr dashboard zeigt möglicherweise mehr Cache-Treffer und größere potenzielle Einsparungen an, selbst wenn bei einigen dieser Übereinstimmungen Fragen gepaart werden, die unterschiedliche Antworten erfordern.
Der Leitfaden von TrueFoundry zum semantischen Caching erläutert, wie Anwendungen durch ein auf Embeddings basierendes Ähnlichkeitsabgleichverfahren Antworten auf unterschiedlich formulierte Abfragen wiederverwenden können. Diese Einsparungen geben jedoch keinen Aufschluss darüber, ob der Cache die richtige Antwort zurückgegeben hat.
Nehmen wir als Beispiel einen Bankkundenbetreuer. Ein Nutzer fragt: „Wie kann ich meine Bankkarte kündigen?“ Ein anderer fragt: „Wie kann ich verhindern, dass meine Bankkarte gekündigt wird?“ Ihre Anfragen enthalten zwar mehrere gemeinsame Wörter und weisen möglicherweise ähnliche Einbettungen auf, doch ihre Absichten unterscheiden sich. Wenn der Cache dem zweiten Nutzer Anweisungen zur Kündigung zurückgibt, gilt die Anfrage dennoch als Treffer. Das System spart sich zwar einen Modellaufruf, doch der Nutzer erhält die falsche Antwort.
Das ist der Unterschied zwischen Cache-Leistung und Cache-Korrektheit. Sie sollten die Trefferquote, die Latenz und die Inferenzkosten weiterhin im Auge behalten, da diese Aufschluss darüber geben, ob das Caching die Effizienz verbessert. Sie müssen jedoch auch messen, wie oft ein Treffer eine Antwort liefert, die eigentlich nicht hätte wiederverwendet werden dürfen. Ohne diese Messung lässt sich nicht feststellen, ob eine höhere Trefferquote auf ein besseres Caching zurückzuführen ist oder ob der Cache bereit ist, fragwürdige Übereinstimmungen zu akzeptieren.
Um diesen Kompromiss zu verstehen, muss man sich die Ähnlichkeitsschwelle ansehen und untersuchen, wie sich sowohl die Trefferquote als auch die Falsch-Positiv-Rate verändern, wenn man diese Schwelle anpasst.
Der Schwellenwert ist ein Mittelweg zwischen zwei Fehlern
Ein höherer Ähnlichkeitsschwellenwert kann Fehltreffer reduzieren, führt jedoch auch dazu, dass mehr Suchanfragen abgelehnt werden, bei denen eine korrekte Antwort hätte wiederverwendet werden können. Der richtige Schwellenwert ist derjenige, der Ihr Ziel für die Falsch-Positiv-Rate erfüllt und gleichzeitig so viele sichere Treffer wie möglich beibehält.
Ein semantischer Cache wandelt in der Regel eine „ abfragen “ in eine Einbettung um, vergleicht diese mit gespeicherten „ abfragen “-Einbettungen und prüft, ob die am besten passende Übereinstimmung den Schwellenwert erfüllt. Ist dies der Fall, gibt der Cache die gespeicherte Antwort zurück. Andernfalls sendet die Anwendung die „ abfragen “ an das Modell. Der Schwellenwert bestimmt, wie schnell der Cache eine Übereinstimmung akzeptiert, stellt jedoch nicht fest, ob zwei Abfragen dieselbe Absicht haben.
Ein höherer Schwellenwert erfordert eine genauere Übereinstimmung, während ein niedrigerer Schwellenwert ein breiteres Spektrum an Abfragen zulässt. Diese einzige Einstellung beeinflusst, wie oft Ihr Cache eine vorhandene Antwort ausliefert und wie oft er eine „ abfragen “ zurückweist, die eine solche Antwort hätte nutzen können.
Ein zu strenger Schwellenwert kann die Einsparungen untergraben, die Sie durch den Einsatz von Caching erzielen wollten. Nutzer formulieren dieselbe Frage selten identisch, und kleine Unterschiede im Wortlaut deuten nicht immer auf eine Änderung der Absicht hin. Wenn Ihr Cache zu viele gültige Treffer zurückweist, führt Ihre Anwendung unnötige Modellaufrufe durch. Sie zahlen für Antworten, die Sie hätten wiederverwenden können, und die Latenz steigt.
Ein zu niedriger Schwellenwert führt zum gegenteiligen Problem. Der Cache akzeptiert zwar mehr Übereinstimmungen, doch die Ähnlichkeit der Einbettung garantiert nicht, dass zwei Abfragen dieselbe Antwort erfordern. Wie im Leitfaden von Portkey zu Schwellenwerten für semantisches Caching erläutert wird, bestimmt der Schwellenwert, wie bereitwillig das System eine Antwort wiederverwendet, und eine zu großzügige Einstellung kann zu Fehlalarmen führen.
Keines der beiden Extreme bietet eine verlässliche Grundlage für die Wahl eines Schwellenwerts. Sie müssen wissen, wie viel Wiederverwendung jede Einstellung ermöglicht und wie oft der Cache eine Antwort liefert, die nicht zum aktuellen „ abfragen “ gehört. Dazu müssen Sie die Trefferquote und die Falsch-Positiv-Rate gemeinsam bewerten, anstatt nur eine Kennzahl im „ isolation “ anzupassen.
In der Praxis empfiehlt es sich, zunächst ein Korrektheitsziel festzulegen und anschließend zu ermitteln, welcher Schwellenwert dieses Ziel erfüllt, ohne dabei die Cache-Effizienz mehr als nötig zu beeinträchtigen. Die richtige Einstellung hängt von Ihren Abfragen, den Folgen einer falschen Antwort und den Ergebnissen Ihrer eigenen Bewertung ab.
Was ein Fehlschuss tatsächlich kostet
Ein Cache-Miss kostet Sie einen weiteren Modellaufruf. Ein Fehlalarm kann dazu führen, dass Ihr „ Nutzer “ eine falsche Antwort liefert, während Ihre Anwendung einen erfolgreichen Cache-Treffer meldet.
Tian Pans Analyse des semantischen Cachings in der Produktion verdeutlicht die Gefahr, falsche Antworten mit hoher Konfidenz zurückzugeben. Ein semantischer Cache erkennt nicht unbedingt, wann eine enge Übereinstimmung die Bedeutung eines „ abfragen “ verändert. Er kann eine Antwort mit hoher Embedding-Ähnlichkeit finden, selbst wenn der „ Nutzer “ eine andere Antwort benötigt.
Durch Negation wird dieses Problem besonders deutlich. Vergleichen Sie „Meine Karte sperren“ mit „Meine Karte nicht sperren“. Die beiden Suchanfragen bestehen fast ausschließlich aus denselben Wörtern, drücken jedoch gegensätzliche Anweisungen aus. Die Wiederverwendung der falschen Antwort könnte dazu führen, dass eine Anwendung entgegen den Wünschen des „ Nutzer“ handelt. Man darf nicht davon ausgehen, dass ein hoher Ähnlichkeitswert bedeutet, dass die Suchanfragen austauschbar sind.
Zahlen und Datumsangaben bergen ein weiteres Risiko. Ein falscher Cache-Treffer kann eine Antwort liefern, die zwar plausibel erscheint, aber einen veralteten oder falschen Wert enthält. In Test 3 ergab die Abfrage „Set my daily card limit to 2500“ einen Treffer im Cache für abfragen , wobei der Wert „250“ verwendet wurde und der Ähnlichkeitswert bei 0,962 lag. Trotz des hohen Ähnlichkeitswerts legen die beiden Abfragen unterschiedliche Limits fest. Das Beispiel zeigt, warum Ähnlichkeit allein keinen Schutz für Werte bieten kann, die die Bedeutung einer Anfrage verändern.
Dies sind die Fehlerarten, die sich anhand der Trefferquote nicht erkennen lassen. Ihr Cache zählt möglicherweise jede Übereinstimmung als Erfolg, selbst wenn ein geändertes Wort, ein geänderter Betrag oder ein geändertes Datum die gespeicherte Antwort unbrauchbar macht. Die Kosten gehen über einen weiteren Modellaufruf hinaus. Je nach Ihrer Anwendung kann eine falsche Antwort einen Kunden in die Irre führen, eine falsche Aktion auslösen oder das Vertrauen in das System untergraben.
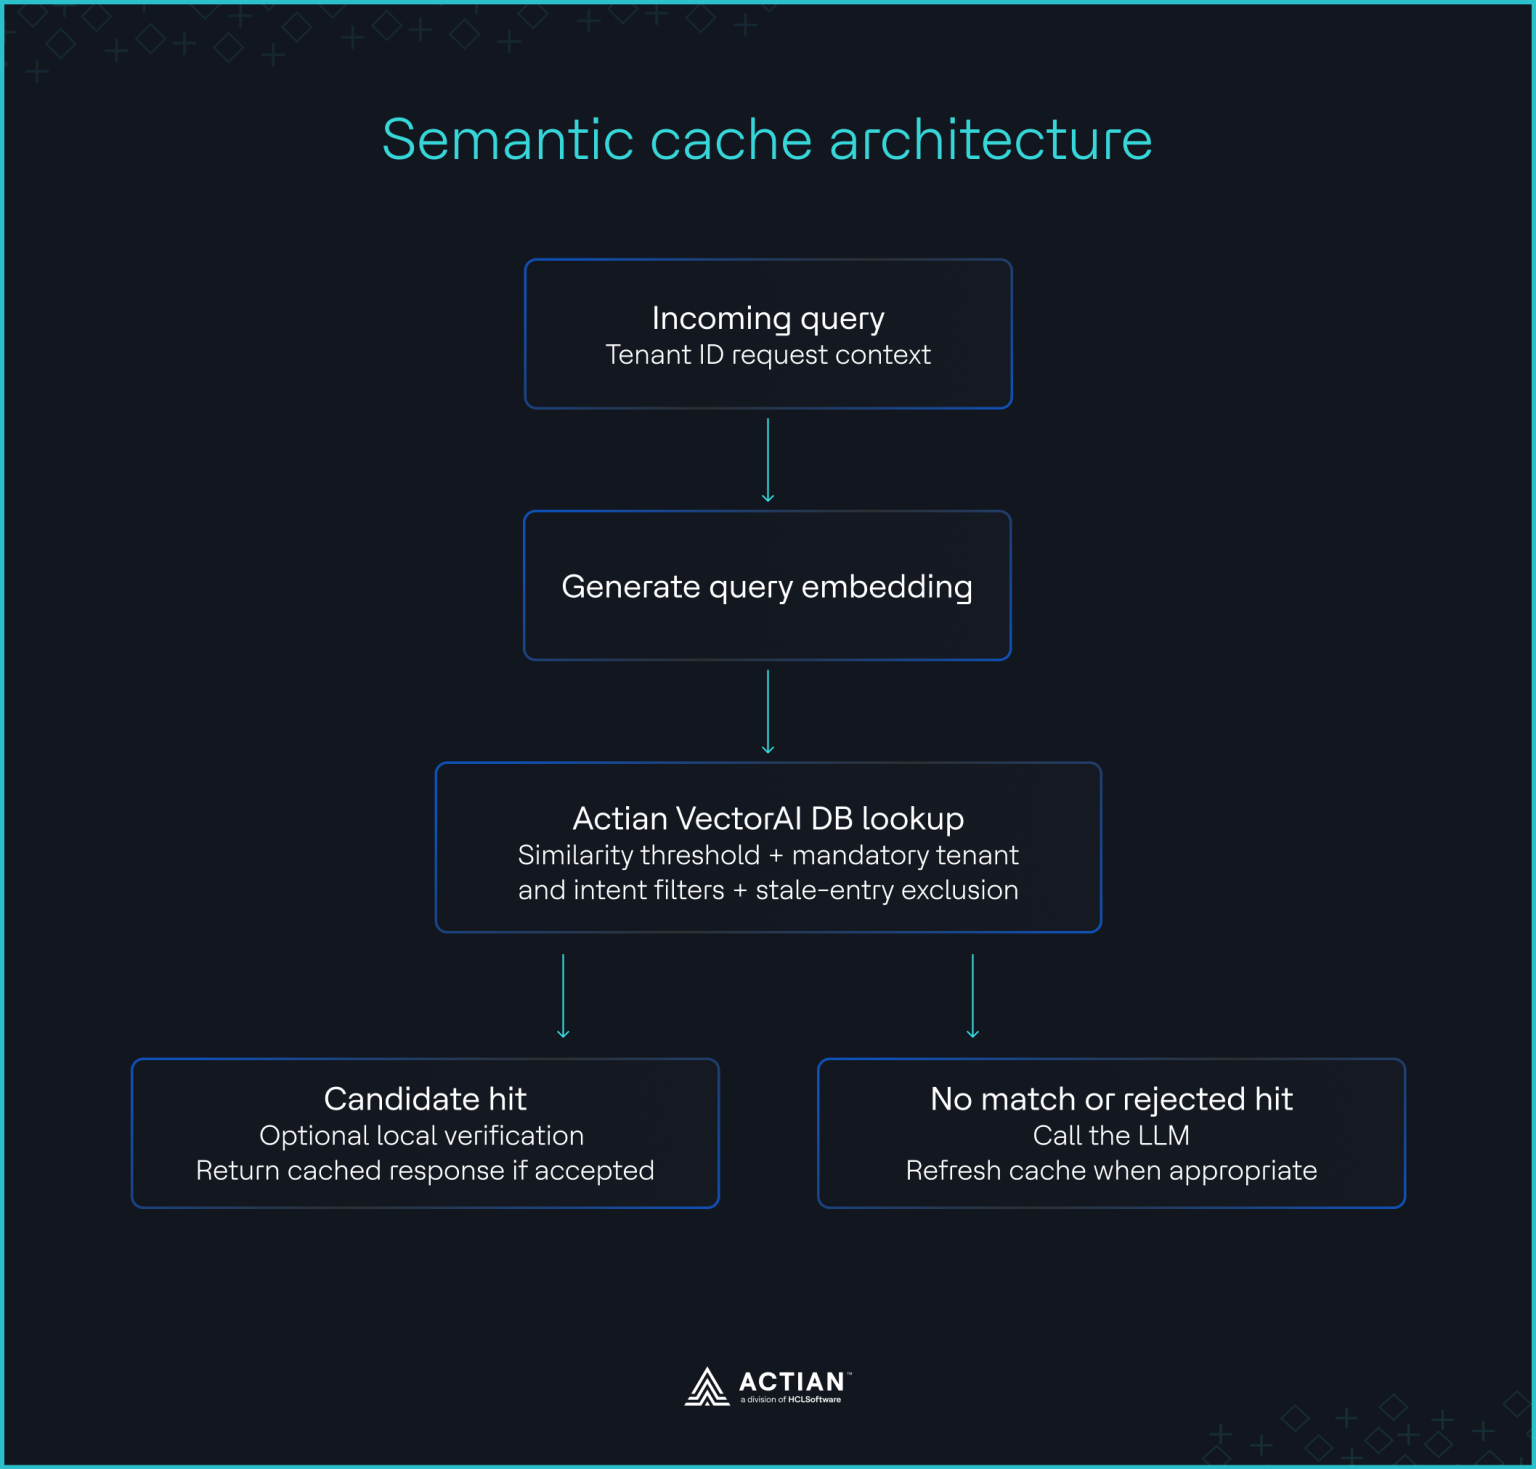
Semantische Cache-Architektur
Voraussetzungen und Einrichtung
Um die Experimente nachzuvollziehen, benötigen Sie Docker, um VectorAI DB lokal auszuführen, „ Python “, um die Testskripte auszuführen, sowie „uv“, um die Umgebung und die Abhängigkeiten von „ Python “ zu verwalten .
Bevor Sie beginnen, installieren Sie bitte Folgendes:
- Docker Desktop oder Docker Engine mit Docker Compose
- Python 3.11 oder 3.12
- uv, das vom Projekt verwendete Paket- und Umgebungsmanagement-Tool „ Python “
Klonen Sie den „ Lager “ und starten Sie VectorAI DB
Klonen Sie in Ihrem Terminal den Actian-Entwickler-Content Lager und wechseln Sie in das Verzeichnis des Semantic-Cache-Projekts.
git clone https://github.com/actian-devs/developer-content.git
cd developer-content/blog/semantic-cache-fp
Starten Sie VectorAI DB mit Docker Compose.
docker-compose up -dDas Ergebnis sollte wie folgt aussehen:
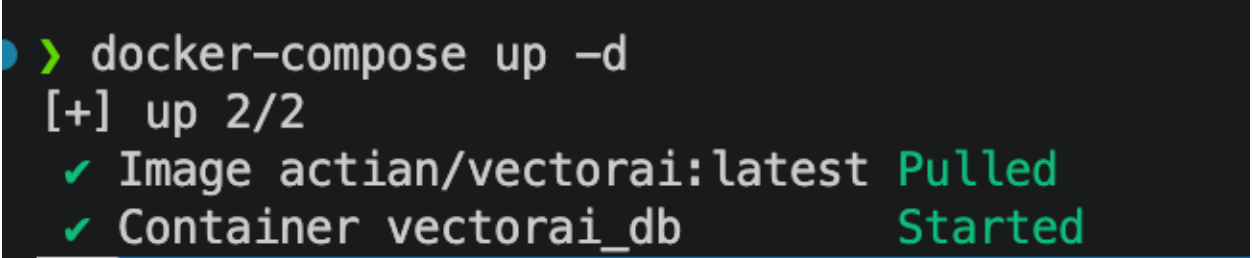
VectorAI DB starten
Installieren Sie die Abhängigkeiten von „ Python “ und erstellen Sie die virtuelle Umgebung.
uv syncWarten Sie, bis VectorAI DB vollständig gestartet ist, bevor Sie die Tests ausführen. Mit dem Befehl „docker ps“ können Sie den Status des Containers überprüfen .
Führen Sie die sieben Tests durch
Führen Sie zunächst den Schwellenwert-Durchlauf durch. Dabei werden Schwellenwerte von 0,50 bis 0,99 ausgewertet und ein Schwellenwert ermittelt, der das Ziel einer Falsch-Positiv-Rate von 5 % anhand der Kalibrierungsdaten erfüllt.
uv run python test1_threshold_sweep.py --threshold 0.80Verwenden Sie den Wert 0,80, um die in diesem Artikel beschriebenen Ergebnisse der sieben Tests zu reproduzieren. Der Schwellenwert-Durchlauf ermittelt zudem, welcher Schwellenwert das Ziel einer Falsch-Positiv-Rate von 5 % erfüllt. In unserer Auswertung wurde dieses Ziel bei der Testgruppe mit dem Wert 0,83 erreicht.
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
uv run python test4_partitions.py --threshold 0.80
uv run python test6_query_length.py --threshold 0.80
uv run python test7_stale_answers.py --threshold 0.80
Test 5 führt ein kleines Verifikationsmodell aus. Exportieren Sie zunächst die Cache-Abfragen und führen Sie das Modell anschließend darauf aus. „decider-0.8b“ läuft auf einem Laptop. Größere Modelle wie „decider-4b“ benötigen eine GPU.
uv run python test5_decider_verify.py \
  --threshold 0.80 \
  --export-hits data/test5_lookups.json
uv run --extra decider python test5_decider_verify.py \
  --threshold 0.80 \
  --model Mapika/decider-0.8b \
  --max-hits 100 \
  --hits-file data/test5_lookups.json
Sobald die Tests abgeschlossen sind, erstellen Sie die Ergebnistabelle.
uv run python make_table.pyDie Skripte schreiben ihre Ergebnisse in die Verzeichnis„results/“ Verzeichnis. Dazu gehören die Schwellenwert-Sweep-Daten, die zur Erstellung der Ergebnistabelle verwendeten Daten sowie einzelne JSON-Dateien, die die Messwerte der jeweiligen Tests enthalten. Beim ersten Durchlauf werden das „ Datensatz “ und das Einbettungsmodell heruntergeladen, weshalb dieser Durchlauf länger dauern kann als die folgenden.
Sieben Tests, ein Bild
Bei einem Ähnlichkeitsschwellenwert von 0,80 lieferte der Cache bei 770 Abfragen 610 Treffer, was einer Trefferquote von 79,2 % entspricht. Von diesen Treffern waren 39 falsch, was einer Falsch-Positiv-Rate von 6,4 % entspricht. Der Schwellenwert-Durchlauf ergab, dass der Wert 0,83 die Vorgabe von 5 % Falsch-Positiv-Rate im zurückgehaltenen Bewertungsteil erfüllte. In diesem Teil erzielte der Cache eine Trefferquote von 70,1 % und eine Falsch-Positiv-Rate von 4,8 %.
In den Experimenten wurde VectorAI DB verwendet, um Einbettungen für 3.075 Fragen aus Banking77, ein öffentliches „ Datensatz “ mit Supportanfragen zum Bankwesen, die mit 77 Intents gekennzeichnet sind. Dies liegt innerhalb der für die Community Edition geltenden Obergrenze von 5.000 Vektoren. Wir haben weitere 770 Fragen aus demselben „ Datensatz “ mithilfe des sentence-transformers/all-MiniLM-L6-v2 Einbettungsmodell. Für jeden „ abfragen “ gab VectorAI DB die am besten passende gespeicherte Frage zurück. Eine Übereinstimmung wurde als Treffer gewertet, wenn ihre Kosinusähnlichkeit den Schwellenwert von 0,80 erreichte.
Wir definierten einen Fehltreffer als einen Treffer, bei dem die zwischengespeicherte Frage eine andere Absicht hatte, zu einem anderen simulierten Mandanten gehörte oder sich auf eine Quelle bezog, die sich geändert hatte. Die Falsch-Positiv-Rate (FPR) ist die Anzahl der Fehltreffer geteilt durch die Gesamtzahl der Treffer. Unser Ziel war eine FPR von 5 % oder weniger. Wir haben die Schwellenwerte anhand der einen Hälfte des Suchdatensatzes kalibriert und sie anhand der anderen Hälfte bewertet.
Bei „ Datensatz “ handelt es sich eher um ein Beispiel als um die vollständige Banking77-Sammlung. Wir haben Mieter und Quelländerungen simuliert und die für die Negations- und Zahlentests verwendeten Paare anhand von Vorlagen generiert. Die Ergebnisse zeigen daher, wie sich diese Fehlermodi unter kontrollierten Bedingungen verhalten, und nicht, wie oft sie in jedem Produktionscache auftreten.
Test 1: Der Schwellenwertdurchlauf
Was getestet wird: Die meisten semantischen Caches basieren auf einer zentralen Einstellung: dem Ähnlichkeitsschwellenwert. Dieser Test untersucht, wie sich die Korrektheit verändert, wenn man diesen Wert anpasst. Dabei werden 770 Fragen bei jedem Schwellenwert zwischen 0,50 und 0,99 im Cache abgefragt, und bei jedem Schritt werden zwei Dinge gezählt: wie oft der Cache eine Antwort liefert (Trefferquote) und wie oft seine Antwort falsch ist (Falsch-Positiv-Rate).
Bei einem Wert von 0,80 lieferte der Cache bei 610 Treffern 39 falsche Antworten. Das entspricht einer FPR von 6,4 % oder etwa fünf falschen Antworten pro 100 eingehende Abfragen. Einige falsche Übereinstimmungen wiesen sehr hohe Ähnlichkeitswerte auf. So wurde beispielsweise „Warum konnte ich keine Überweisung vornehmen?“ mit einem Wert von 0,921 mit „Warum konnte ich meine Überweisung nicht abschließen?“ abgeglichen, obwohl die Fragen unterschiedliche Banking77-Intents hatten, nämlich „declined_transfer“ und „failed_transfer“.
Durch die Anhebung des Schwellenwerts auf 0,83 stieg die FPR im Held-out-Evaluierungsdatensatz auf 4,8 % und erreichte damit das Ziel von 5 %. Die Trefferquote sank auf 70,1 %. Das ist der Kompromiss, den ein ausschließlich auf die Trefferquote ausgerichteter „ dashboard “ verschleiert. Der höhere Schwellenwert reduzierte zwar die Anzahl der falschen Wiederverwendungen, führte aber auch dazu, dass mehr Abfragen an das Modell gesendet wurden.
Abbildung 2 zeigt die Trefferquote und die Falsch-Positiv-Quote für die getesteten Schwellenwerte. Wählen Sie anhand der Kurve einen Betriebspunkt in Abhängigkeit von einem Korrektheitsziel aus, anstatt die höchste Trefferquote als Ziel anzustreben.

Trefferquote und Falsch-Positiv-Quote bei verschiedenen Ähnlichkeitsschwellenwerten
Führen Sie Test 1 auf Ihrem Terminal aus:
uv run python test1_threshold_sweep.py --threshold 0.80Tests 2 und 3: Verneinung, Zahlen und Datumsangaben
Was getestet wird: Diese Tests prüfen, ob ein semantischer Cache zwischen ähnlichen Fragen mit unterschiedlicher Bedeutung unterscheiden kann, während er Antworten für Fragen mit derselben Bedeutung wiederverwendet. Beispielsweise unterscheiden sich „Meine Karte sperren“ und „Meine Karte nicht sperren“ durch ein einziges Wort, erfordern jedoch gegensätzliche Antworten. Ebenso unterscheiden sich „250 $ überweisen“ und „2.500 $ überweisen“ durch eine einzige Ziffer, bezeichnen jedoch unterschiedliche Beträge. Bei den Tests wird eine Frage aus jedem Paar zwischengespeichert, und die andere Frage wird gestellt, um zu überprüfen, ob der Cache die zwischengespeicherte Antwort nicht fälschlicherweise wiederverwendet. Außerdem werden umformulierte Fragen mit derselben Bedeutung einbezogen, um sicherzustellen, dass der Cache diese Antworten korrekt wiederverwendet.
Der semantische Cache hatte Schwierigkeiten, Fragen mit gegensätzlicher Bedeutung voneinander zu unterscheiden, selbst wenn sie sich nur durch ein einziges Wort unterschieden. Bei 74 der 75 verneinten Fragen (98,7 %) wurden die im Cache gespeicherten Antworten fälschlicherweise wiederverwendet. So wurde beispielsweise die Frage „Sollte ich meine Karte nicht sperren?“ trotz der gegensätzlichen Absicht mit einem Ähnlichkeitswert von 0,990 der Frage „Sollte ich meine Karte sperren?“ zugeordnet.
Die Schwellenwertanpassung allein konnte dieses Problem nicht lösen. Negierte Paare wiesen einen Medianwert der Ähnlichkeit von 0,946 auf, der höher war als der Wert von 0,936, der für Paraphrasen verzeichnet wurde, bei denen die ursprüngliche Absicht erhalten blieb. Kein Schwellenwert bis 0,99 verhinderte mindestens 95 % der Negationsfehler. Im Gegensatz dazu reduzierte eine einfache Überprüfung, bei der Übereinstimmungen abgelehnt wurden, wenn nur ein „ abfragen “ eine Negation enthielt, den Anteil der ausgegebenen negierten Fragen von 98,7 % auf 4,0 %, während die Paraphrasenquote bei 72,1 % blieb.
Geänderte Zahlen und Datumsangaben stellten eine ähnliche Herausforderung dar. Die 38 Paare mit geänderten Werten wiesen einen Medianwert der Ähnlichkeit von 0,906 auf, was nahe am Medianwert von 0,911 für die 44 Paraphrasenpaare lag. Der Cache bediente alle 38 Abfragen mit geänderten Werten. Beispielsweise stimmte „Setze mein tägliches Kartenlimit auf 2.500 $“ mit „Setze mein tägliches Kartenlimit auf 250 $“ mit einem Ähnlichkeitswert von 0,962 überein. Ebenso stimmte eine Frage zu einer Abbuchung am 21. Juni mit einer Frage zum 21. Juli mit einem Ähnlichkeitswert von 0,964 überein.
Um mindestens 95 % dieser Abfragen mit geänderten Werten zu blockieren, war ein Schwellenwert von 0,97 erforderlich, wodurch sich die Paraphrasierungsrate von 95,5 % auf 13,6 % verringerte. Eine Exaktübereinstimmungsprüfung für Zahlen und Datumsangaben blockierte in diesem Test alle geänderten Werte, während die Paraphrasierungsrate bei 95,5 % blieb.
Diese Prüfungen sind bewusst einfach gehalten und weisen Einschränkungen auf. Bei der Negationsprüfung können indirekte Bedeutungsänderungen übersehen werden, während die Wertprüfung äquivalente Darstellungsformen wie „fünfzig Dollar“ und „$50“ nicht erkennt.
Führen Sie die Tests 2 und 3 in Ihrem Terminal aus:
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
Test 4: Grenzen von Tenants und Intents
Was getestet wird: Dieser Test prüft, ob ein Cache verhindern kann, dass Antworten zwischen Kunden (Mandanten) oder nicht miteinander in Zusammenhang stehenden Themen weitergegeben werden. So sollte beispielsweise ein Kunde nicht die zwischengespeicherte Antwort eines anderen Kunden erhalten, und eine Frage zu Kartengebühren sollte keine Antwort zum Thema Überweisungen liefern. Der Test verwendet drei simulierte Mandanten, um fehlerhafte Cache-Treffer zu identifizieren, und wiederholt anschließend die Abfragen mit VectorAI-DB-Filtern, um zu prüfen, ob die Einschränkung der Suche nach Mandant und Thema diese Fehler verhindert.
Ohne Filter waren 425 von 610 Treffern falsch, was einer Falsch-Positiv-Rate von 69,7 % entspricht. Von diesen Treffern überschritten 409, also 67,1 % aller Treffer, die Mandantengrenzen. Zu den übrigen falschen Treffern gehörten Abfragen, die innerhalb eines Mandanten der falschen Absicht entsprachen.
Ein „MUST“-Filter auf Mandantenebene entfernte mandantenübergreifende Treffer und senkte die Gesamt-FPR auf 9,1 % bei einer Trefferquote von 61,4 %. Zu den verbleibenden Fehlern gehörten Übereinstimmungen mit benachbarten Intents. Da jede Mandantenpartition weniger Beispiele pro Intent enthielt, war es wahrscheinlicher, dass die nächstliegende verfügbare Übereinstimmung aus einem anderen Intent stammte.
Durch Hinzufügen eines zweiten MUST-Filters für die von einem Lightweight-Klassifikator vorhergesagte Absicht sank die FPR auf 4,7 % bei einer Trefferquote von 58,4 %. Der Klassifikator sagte in 88,4 % der Fälle die richtige Absicht voraus. Durch die Zulassung von Übereinstimmungen mit den beiden von dem Klassifikator als relevant eingestuften Absichten über einen SHOULD-Filter wurde eine höhere Trefferquote von 60,6 % erzielt, allerdings stieg die FPR dabei auf 7,9 %.
Schwellenwerte pro Intent haben das Ergebnis in diesem Experiment nicht verbessert. Da für die Kalibrierung nur etwa fünf Fragen pro Intent zur Verfügung standen, lag die FPR bei den nicht in die Kalibrierung einbezogenen Suchanfragen bei 9,6 %. Dies ist eine Einschränkung dieser Stichprobe und kein Hinweis darauf, dass Schwellenwerte pro Intent bei größeren Datenmengen nicht funktionieren können.
Die Ergebnisse zeigen, warum Ähnlichkeit allein kein Mechanismus zur Zugriffskontrolle ist. Bei einem Cache-Lookup sollten Mandantengrenzen eingehalten und, sofern angemessen, die Kandidaten vor der Auswahl einer Antwort entsprechend der beabsichtigten Verwendung eingeschränkt werden.
Führen Sie Test 4 auf Ihrem Terminal aus:
uv run python test4_partitions.py --threshold 0.80Test 5: Lokale Überprüfung
Was getestet wird: Schwellenwerte und Filter lassen immer noch einige falsche Antworten durch. Dieser Test fügt eine zweite Überprüfung hinzu: Bevor der Cache einen Treffer ausliefert, liest ein kleines lokales Modell beide Fragen und beurteilt, ob eine Antwort für beide passen könnte. Der Test misst, wie viele falsche Treffer das Modell abfängt, wie viele richtige Treffer es fälschlicherweise zurückweist und wie viel Zeit jede Überprüfung zusätzlich in Anspruch nimmt.
Um eine zusätzliche Sicherheitsmaßnahme zu testen, haben wir 100 zufällig ausgewählte Treffer an das „Decider-0.8b“-Modell von Mapika auf einem MacBook mit Apple Silicon M3 gesendet.
Bei einem Schwellenwert für die Ja-Wahrscheinlichkeit von 0,5 erkannte der Verifizierer vier der sechs falschen Treffer in der Stichprobe. Außerdem lehnte er 25 von 94 korrekten Treffern ab, was einem Anteil von 26,6 % entspricht. Die mediane Verifizierungslatenz betrug 106 Millisekunden pro Treffer, wobei auf dem Laptop bei einer Batchgröße von eins das 95. Perzentil bei 116 Millisekunden lag.
Bei einem niedrigeren Schwellenwert von 0,3 wurden nur zwei korrekte Treffer verworfen, aber nur ein falscher Treffer erkannt. Diese Ergebnisse veranschaulichen den Kompromiss zwischen der Erkennung falscher Übereinstimmungen und der Beibehaltung nützlicher Cache-Treffer. Da die Stichprobe nur sechs falsche Treffer enthielt, handelt es sich hierbei um ein vorläufiges Ergebnis und nicht um eine verlässliche Einschätzung der Wirksamkeit des Verifikators. Eine vollständige Auswertung aller 610 Treffer ist noch erforderlich. Die gemessene Latenz stellt keinen Produktions-Benchmark dar. Betrachten Sie die lokale Verifizierung als eine Sicherheitsmaßnahme, die es bei risikoreichen Absichten zu testen lohnt, nicht als bewährte Lösung.
Test 6: Kurze versus lange Abfragen
Was getestet wird: Kurze Fragen wie „Karte funktioniert nicht“ enthalten nur wenige Details, sodass sich kurze Fragen, die nichts miteinander zu tun haben, ähnlich anhören können. Bei diesem Test werden die 770 Fragen in kurze, mittellange und lange Fragen unterteilt, es wird verglichen, wie oft in jeder Gruppe eine falsche Antwort gegeben wird, und es wird geprüft, ob ein strengerer Schwellenwert für kurze Fragen hilfreich ist.
Auch die Länge der Suchanfragen wirkte sich auf die Zuverlässigkeit aus. Suchanfragen mit acht oder weniger Wörtern machten 43 % des Suchsatzes aus und waren für 27 der 39 falschen Treffer verantwortlich. Bei einem Schwellenwert von 0,80 lag ihre FPR bei 9,4 %, verglichen mit 2,9 % bei mittleren Suchanfragen mit neun bis elf Wörtern und 4,6 % bei Suchanfragen mit mehr als elf Wörtern.
Um das 5-Prozent-Ziel zu erreichen, wurden die kalibrierten Schwellenwerte auf 0,87 für kurze Abfragen, 0,80 für mittellange Abfragen und 0,83 für lange Abfragen festgelegt. Durch die Anwendung dieser längenspezifischen Schwellenwerte konnte die FPR bei den zurückbehaltenen Abfragen auf 2,0 % gesenkt werden, bei einer Trefferquote von 64,2 %. Im Vergleich dazu ergab der einheitliche Schwellenwert von 0,83 eine FPR von 4,8 % und eine Trefferquote von 70,1 %.
Längenabhängige Schwellenwerte verbesserten in dieser Stichprobe die Korrektheit, allerdings auf Kosten einer geringeren Trefferzahl. Sie sollten dasselbe Muster anhand Ihrer eigenen abfragen -Verteilung überprüfen, bevor Sie unterschiedliche, von der Länge abhängige Schwellenwerte festlegen.
Führen Sie Test 6 auf Ihrem Terminal aus:
uv run python test6_query_length.py --threshold 0.80Test 7: Veraltete Antworten nach Änderungen am Quellcode
Was getestet wird: Eine zwischengespeicherte Antwort kann perfekt zur Frage passen und dennoch falsch sein, da sich die zugrunde liegende Richtlinie seit der Zwischenspeicherung geändert hat. Bei diesem Test werden 20 % der zugrunde liegenden Richtlinien nach der Zwischenspeicherung geändert; anschließend wird überprüft, wie oft der Cache eine veraltete Antwort liefert. Die betroffenen Einträge werden daraufhin in der VectorAI-Datenbank als veraltet markiert und erneut überprüft.
Wir haben jede Banking77-Absicht als Quelle behandelt und 15 der 77 Quellen nach dem Zwischenspeichern geändert. Vor der Ungültigmachung stieg die FPR auf 24,9 %. Bei 113 Treffern fand der Cache zwar eine Frage mit der richtigen Absicht, gab jedoch eine veraltete Antwort zurück.
Wir haben einen gefilterten „set_payload“-Aufruf verwendet, um alle 600 Einträge aus den geänderten Quellen als veraltet zu kennzeichnen, und anschließend einen „MUST NOT“-Filter hinzugefügt, um veraltete Einträge bei Suchvorgängen auszuschließen. Die FPR sank von 24,9 % auf 11,4 %, und die Trefferquote betrug 67,4 %. Dadurch wurde das Problem zwar gemildert, aber nicht vollständig beseitigt. Einige Abfragen zu geänderten Richtlinien stimmten mit einer benachbarten Absicht überein, die den Ähnlichkeitsschwellenwert noch immer unterschritt. Die Ungültigkeitserklärung sollte daher mit einer Cache-Neufüllung oder einer geeigneten Absichtsfilterung kombiniert werden, gefolgt von einer weiteren Auswertung zur Überprüfung auf verbleibende Fehler.
Führen Sie Test 7 auf Ihrem Terminal aus:
uv run python test7_stale_answers.py --threshold 0.80Die Ergebnisse in einer Tabelle
| Test | Fehlermodus | Risikominderung | Ergebnis |
| 1. Schwellenwert-Durchlauf | Ein Schwellenwert lässt zu viele falsche Übereinstimmungen zu | Kalibrierung auf ein FPR-Ziel von 5 % | Bei einem Wert von 0,83 lag die FPR bei 4,8 % und die Trefferquote bei 70,1 % bei den zurückbehaltenen Abfragen. |
| 2. Verneinung | Negierte Fragen werden wie Umschreibungen gewertet | Auf Unterschiede bei der Negation prüfen | Der Anteil der abgelehnten Suchanfragen sank von 98,7 % auf 4,0 %; die Paraphrasierungsrate blieb bei 72,1 % |
| 3. Zahlen und Datumsangaben | Die geänderten Werte stimmen weiterhin überein | Genaue Übereinstimmungen bei Zahlen und Datumsangaben erfordern | Die Anzahl der abgearbeiteten Abfragen mit geänderten Werten sank von 100 % auf 0 %; die Paraphrasierungsrate blieb bei 95,5 % |
| 4. Grenzen der Mieterschaft und der Zweckbestimmung | Stimmt mit Partitionen oder Absichten überein | MUST filtert nach Mandant und vorhergesagter Absicht | Die FPR sank auf 4,7 % bei einer Trefferquote von 58,4 % |
| 5. Vor-Ort-Überprüfung | Falsche Treffer überschreiten den Schwellenwert und die Filter | Überprüfe die Stichproben-Treffer mit Decider-0.8b | Der FPR sank in einer Stichprobe mit 100 Treffern von 6,0 % auf 2,8 %; die Ergebnisse sind vorläufig. |
| 6. Abfragelänge | Kurze Suchanfragen führen zu mehr falschen Treffern | Schwellenwerte anhand der Länge von „ abfragen “ kalibrieren | Die FPR sank auf 2,0 %, bei einer Trefferquote von 64,2 % bei den ausgenommenen Abfragen |
| 7. Veraltete Antworten | Zwischengespeicherte Antworten sind länger gültig als ihre Quelldaten | Veraltete Einträge markieren und von der Suche ausschließen | Der FPR sank von 24,9 % auf 11,4 %; Filterung nach Nachfüll- oder Nachkaufabsicht |
Der Gesamt-FPR von 0,80 verdeckte Fehler, die sich auf bestimmte „ abfragen “-Typen und Cache-Zustände konzentrierten. Negationen und geänderte Werte umgingen die Ähnlichkeitsschwellenwerte, Mandantengrenzen erforderten Filter, und veraltete Antworten mussten ungültig gemacht werden. Kurze Abfragen profitierten von einem strengeren Schwellenwert, während die lokale Überprüfung vielversprechend war, jedoch einer umfassenderen Bewertung bedarf.
Diese Ergebnisse hängen vom gewählten Einbettungsmodell, dem „Banking77“-Datensatz und der im Experiment verwendeten Definition einer falschen Antwort ab. Intent-Labels sind ein unvollkommener Anhaltspunkt dafür, ob zwei Fragen sicher dieselbe Antwort teilen können, sodass einige Übereinstimmungen in beide Richtungen falsch klassifiziert werden können. Die Ergebnisse liefern nützliche Hinweise auf bestimmte Fehlerarten, stellen jedoch keine allgemeingültige Vorhersage der Produktionsleistung dar.
Einen Cache betreiben, dem man vertrauen kann
Gehen Sie von einem Korrektheitsziel aus, nicht von einem Ziel für die Trefferquote. Legen Sie fest, wie viele falsche Antworten Ihre Anwendung akzeptieren kann, und richten Sie den Cache dann so ein, dass diese Zahl eingehalten wird.
Legen Sie den Schwellenwert anhand eines Korrektheitsziels fest
Messen Sie die Falsch-Positiv-Rate anhand einer gekennzeichneten Stichprobe Ihres eigenen Datenverkehrs, variieren Sie den Schwellenwert und wählen Sie die niedrigste Einstellung, die Ihr Ziel erfüllt. Geben Sie die Falsch-Positiv-Rate neben der Trefferquote auf jeder Seite „ dashboard “ an. Verwenden Sie für kurze Suchanfragen einen strengeren Schwellenwert.
Teile den Bereich so auf, dass ein Treffer keine Grenze überschreiten kann
Speichern Sie den Mandanten, die Absicht und die Quelle bei jedem zwischengespeicherten Eintrag und lassen Sie VectorAI DB bei der Suche nach diesen Kriterien filtern. Ein „MUST“-Filter für den Mandanten sorgt dafür, dass jeder Kunde in seinen eigenen Daten bleibt. Ein Filter für die Absicht verhindert, dass eine Kartenfrage eine Antwort aus einem anderen Bereich erhält. Ein „MUST NOT“-Filter für ein Verfallsflag sorgt dafür, dass veraltete Antworten nach einer Änderung der Quelle ausgeschlossen werden.
Überprüfen Sie die Treffer, bei denen Sie sich keine Fehler leisten können
Bevor Sie einen Treffer ausgeben, vergleichen Sie die Details, bei denen keine Übereinstimmung vorliegt: Verneinungen, Beträge und Datumsangaben. Bei Vorgängen mit hohem Risiko, wie beispielsweise Rückerstattungen und Stornierungen, sollten Sie ein lokales Verifizierungsmodell hinzufügen. Verfolgen Sie die falschen Treffer, die es erfasst, die korrekten Treffer, die es ablehnt, sowie die dadurch verursachte Verzögerung.
Führen Sie diese Überprüfung regelmäßig durch. Eine Trefferquote ist nur dann aussagekräftig, wenn Sie daneben auch die Falsch-Positiv-Rate angeben.
Zum Abschluss
Eine hohe Trefferquote zeigt, dass Ihr semantischer Cache funktioniert, nicht aber, dass er korrekt ist. Die sieben Tests zeigen, dass sich falsche Antworten dort konzentrieren, wo sie den größten Schaden anrichten: bei negierten Anfragen, geänderten Beträgen und Datumsangaben, Daten anderer Mandanten sowie veralteten Richtlinien. Ein Schwellenwert allein reicht nicht aus, um diese Fehler zu erkennen. Legen Sie den Schwellenwert anhand eines Korrektheitsziels fest, unterteilen Sie den Cache mithilfe von VectorAI-DB-Filtern so, dass ein Treffer keine Mandanten- oder Absichtsgrenze überschreiten kann, und überprüfen Sie die Treffer, bei denen Sie sich keine Fehler leisten können.
Um zu sehen, wie Ihr eigener Cache funktioniert, beginnen Sie mit der Actian VectorAI DB Community Edition. Führen Sie dieselben Prüfungen anhand einer gekennzeichneten Stichprobe Ihrer eigenen Abfragen durch, messen Sie, wie oft Cache-Treffer falsche Antworten liefern, und nutzen Sie diese Ergebnisse, um Ihre Schwellenwerte und Sicherheits feinabstimmen n anzupassen.
Laden Sie das Docker-Image der Community Edition herunter, um loszulegen.
docker pull actian/vectorai:latestBefolgen Sie anschließend die Anweisungen in der VectorAI-DB-Dokumentation, um die Datenbank zu starten und Ihre Auswertung durchzuführen. Die Community Edition unterstützt bis zu 5.000 Vektoren und eignet sich daher zur Nachbildung dieser Experimente auf einem lokalen Entwicklungsrechner. Treten Sie der Actian-Discord-Community bei, um Hilfe zu erhalten und sich auszutauschen.
Discord beitreten
Bleiben Sie in Verbindung
Datenanalysen direkt bei Ihnen.
(z. B. sales@..., support@...)
