
Phi-4-Mini vs. Gemma 4 vs. Qwen3: Das beste LLM für den Raspberry Pi 5


Zusammenfassung
- Phi-4-Mini, Gemma 4 und Qwen3 eignen sich jeweils für unterschiedliche Edge-AI-Anwendungsfälle, je nach Hardware, Latenz und Anwendungsanforderungen.
- Gemma 4 eignet sich am besten für multimodale Anwendungen, während Phi-4-Mini den Schwerpunkt auf Schlussfolgerungen und Codegenerierung legt.
- Qwen3 eignet sich besonders für KI-Agenten in der Produktion, die auf einen zuverlässigen Aufruf von Tools und umfassende mehrsprachige Unterstützung angewiesen sind.
- Die Hardware hat einen erheblichen Einfluss auf die Leistung, wobei der Raspberry Pi eher kleinere Modelle bevorzugt und Jetson größere, GPU-beschleunigte Optionen ermöglicht.
- Die Modellauswahl ist nur ein Teil des Edge- Deployment s; auch die Quantisierung und die Abrufarchitektur bestimmen die Gesamtleistung.
Lokale KI ist mittlerweile so ausgereift, dass ein Raspberry Pi 5 leistungsfähige Sprachmodelle ausführen kann. Phi-4-Mini, Gemma 4 und Qwen3 unterscheiden sich hinsichtlich Schlussfolgerungsfähigkeit, Aufruf von Tools, multimodaler Unterstützung und Hardware-Effizienz. Ihre Wahl hängt von der Hardware ab, die Sie einsetzen möchten, von der Latenz, die Sie in Kauf nehmen können, sowie von den Arbeitslasten, die Ihr KI-Agent bewältigen soll.
Dieser Artikel richtet sich an Plattform- und KI-Entwickler, die lokale LLMs auf dem Raspberry Pi 5, dem Jetson Orin Nano und ähnlichen Geräten mit begrenztem Speicherplatz bereitstellen. Sie werden den nachgewiesenen Durchsatz, die Speicheranforderungen und die Hardwarekompatibilität vergleichen, anstatt sich allein auf Benchmark-Ergebnisse zu verlassen. Wenn Sie vorhaben, Modelle wie Gemma mit einer lokalen Vektordatenbank wie Actian VectorAI DB auf dem Raspberry Pi 5 auszuführen, hilft Ihnen das Verständnis der Kompromisse zwischen diesen Modellen dabei, eine Konfiguration zu wählen, die zu Ihrer Hardware passt und Workload.
In diesem Artikel werden Sie die verfügbaren Modelle hinsichtlich der für das Edge- Deployment relevanten Hardware-Stufen miteinander vergleichen.
Hardware-Stufen
Bevor Sie Modelle vergleichen, sollten Sie festlegen, welche Hardwareklasse Sie anstreben. Ein und dasselbe Modell kann je nach verfügbaren Ressourcen wie Arbeitsspeicher, Rechenleistung und Kühlung sehr unterschiedliche Leistungen erbringen. Alle in diesem Artikel genannten Durchsatzwerte basieren auf einer bestimmten „ Deployment “-Klasse. Ein Vergleich der Zahlen verschiedener Geräte ohne Berücksichtigung dieses Kontexts kann daher zu einer falschen Modellauswahl führen.
Der Raspberry Pi 5 mit 8 GB RAM stellt die Stufe mit den größten Einschränkungen dar. Die gesamte Inferenz läuft auf dem „ CPU “, wodurch der Speicherbedarf die Hauptbeschränkung darstellt. Untersuchungen von „Build Fast with AI“ zeigen, dass Gemma 4 E2B auf einem Raspberry Pi 5 etwa 7,6 tok/s liefert. Bei der Q4_K_M-Quantisierung läuft Gemma 4 E4B mit etwa 2 bis 5 tok/s, da es stark auf Auslagerungsspeicher angewiesen ist. Unter denselben Bedingungen erreicht Qwen2.5-3B etwa 8,2 Dekodierungs-tok/s und Qwen3-4B etwa 5 bis 7 tok/s.
Der Jetson Orin Nano spielt in einer ganz anderen Leistungsklasse. Er verfügt über 8 GB Arbeitsspeicher, einen KI-Beschleuniger mit 67 TOPS und GPU-beschleunigte Inferenz. Modelle, die auf reiner „ CPU “-Hardware nur schwer laufen, reagieren je nach Modell und Quantisierungsstufe deutlich schneller. Auf der höchsten Stufe bieten Edge-Server und Systeme wie der Mac Mini M4 mit 16 bis 32 GB einheitlichem Speicher genügend Spielraum für größere Kontextfenster, Quantisierung mit höherer Genauigkeit und mehrere gleichzeitige Inferenz-Workloads.
| Hardware-Ebene | Speicher | Ungefährer Durchsatz bei Q4_K_M |
| Raspberry Pi 5 | 8 GB | 2 bis 8,2 Tok/s (modellabhängig) |
| Jetson Orin Nano | 8 GB, 67 TOPS | Bis zu 25,5 Tok/s (modellabhängig) |
| Edge-Server / Mac Mini M4 | 16 bis 32 GB einheitlicher Arbeitsspeicher | Nicht verifiziert |
Hardware-Stufen für lokale LLM Deployment
Model-Profile
Gemma 4 E2B und E4B
Gemma 4 E2B und E4B nutzen eine kompakte Architektur mit Per-Layer-Embeddings (PLE). Anstatt dem Modell weitere Schichten hinzuzufügen, weist PLE jeder Decoder-Schicht für jedes Token ein eigenes kleines Embedding zu. Das „Mixture of Experts“-Modell (MoE) der Gemma-4-Familie ist die separate 26-Milliarden-Variante.
Gemma 4 E2B verfügt über 2,3 Milliarden effektive Parameter und insgesamt 5,1 Milliarden Parameter. Bei E4B steigen diese Werte auf 4,5 Milliarden effektive Parameter und insgesamt 8 Milliarden Parameter. Beide Modelle stehen unter der Apache-2.0-Lizenz und bieten ein Kontextfenster von 128K.
Auf dem Raspberry Pi 5 erreicht Gemma 4 E2B etwa 7,6 tok/s und eignet sich damit für interaktive „ CPU “-Inferenz auf einem System mit 8 GB Arbeitsspeicher. Gemma 4 E4B läuft ebenfalls mit etwa 2 bis 5 tok/s, da es stark auf den Auslagerungsspeicher angewiesen ist. Auf dem Jetson Orin Nano mit GPU-Beschleunigung erreicht Gemma 4 E2B mit einem Kontextfenster von 8k etwa 25,5 tok/s, wodurch sich das größere Modell auf Edge-Hardware mit GPU deutlich besser eignet. Gemma 4 E4B erreicht etwa 11 bis 14 tok/s.
Gemma 4 unterstützt zudem native multimodale Eingaben. Es akzeptiert Text-, Bild-, Audio- und Videoeingaben und ermöglicht den nativen Aufruf von Funktionen über spezielle Tokens. Diese Fähigkeiten reduzieren den Aufwand für die Orchestrierung , der beim Erstellen multimodaler Edge-KI-Anwendungen erforderlich ist.
Phi-4-Mini
Phi-4-Mini ist ein Modell mit 3,8 Milliarden Parametern, das unter der MIT-Lizenz veröffentlicht wurde. Es zeichnet sich eher durch seine Leistung beim logischen Schlussfolgern aus als durch multimodale Fähigkeiten oder den Einsatz von Werkzeugen. Bei Standard-Benchmarks zum logischen Schlussfolgern erreicht es 88,6 Prozent bei GSM8K und 83,7 Prozent bei ARC-C.
Kontrollierte Tests auf Mobilgeräten (iPhone 14 Pro, Pixel 8, Android-Geräte der Mittelklasse) zeigen, dass Phi-4-Mini einen um etwa 15 bis 20 Prozent höheren Durchsatz als Qwen3-4B liefert. Phi-4-Mini läuft außerdem mit etwa 5 bis 8 tok/s auf dem Raspberry Pi 5.
Ein weiterer Unterschied zeigt sich bei anhaltender Auslastung der Agenten. Phi-4-Mini erzeugt bei mehrstufigen Schlussfolgerungen klarere Gedankengänge und eignet sich daher gut für Planungs- und Schlussfolgerungsaufgaben. Allerdings bleibt seine Genauigkeit beim Aufruf von Tools im Standardzustand hinter der von Qwen3 zurück, sodass Workflows, die stark auf strukturierte Funktionsaufrufe angewiesen sind, möglicherweise eine zusätzliche Feinabstimmung der Prompts erfordern.
Qwen3 (4B-Varianten)
Die Qwen3-4B-Varianten richten sich an Entwickler, die KI-Agenten für den produktiven Einsatz erstellen und dabei auf eine zuverlässige Tool-Integration angewiesen sind. Die Modelle stehen unter der Apache-2.0-Lizenz und unterstützen laut der offiziellen Qwen3-4B-Modellkarte mehr als 100 Sprachen.
Laut dem verfügbaren Raspberry Pi 5-Benchmark liefert Qwen3-4B auf einem 8-GB-System mit Q4-Quantisierung etwa 5 bis 7 Tok/s. Qwen3 zeichnet sich durch seine sofort einsatzbereite Genauigkeit beim Aufruf von Tools aus. Es erfordert weniger Vorarbeit als Phi-4-Mini für Workflows, die APIs, Datenbanken oder lokale Dienste aufrufen, und ist damit eine gute Wahl für KI-Agenten, die auf strukturierte Funktionsaufrufe angewiesen sind.
| Modell | Aktive Parameter | Raspberry Pi 5 (tok/s) | Jetson Orin Nano (tok/s) | Lizenz | Genauigkeit bei der Werkzeugauswahl | Multimodale Unterstützung |
| Gemma 4 E2B | 2,3 Mrd. effektiv (insgesamt 5,1 Mrd.) | ~7.6 | 25,5 (mit 8.000 Token) | Apache 2.0 | Muttersprachler | Text, Bild, Audio, Video |
| Gemma 4 E4B | 4,5 Mrd. effektiv (insgesamt 8 Mrd.) | ~2 bis 5 | ~ 11 bis 14 | Apache 2.0 | Muttersprachler | Text, Bild, Audio, Video |
| Phi-4-Mini | 3.8B | ~ 5 bis 8 | Nicht verifiziert | MIT | Standard | Nur Text (Für „Multimodal“ ist die Basisversion Phi-4 erforderlich) |
| Qwen3-4B | 4B | ~5 bis 7 | Nicht verifiziert | Apache 2.0 | Höchste Genauigkeit | Text, Bild |
Modellspezifikationen, Durchsatz und Leistungsfähigkeit nach Plattform
Welches Modell für welche Situation?
Wenn Sie die Anwendung auf einem Raspberry Pi 5 mit 8 GB RAM bereitstellen, wählen Sie Ihr Modell konservativ aus. Der Arbeitsspeicher ist die begrenzende Ressource, und der Durchsatz bestimmt, ob sich Ihre Anwendung interaktiv anfühlt. Gemma 4 E2B ist mit etwa 7,6 tok/s eine praktische Wahl und bietet Ihnen gleichzeitig native multimodale Eingabe und Funktionsaufrufe. Qwen3-4B liefert etwa 5 bis 7 tok/s, bietet jedoch die höchste Genauigkeit beim Aufruf von Tools direkt nach der Installation und unterstützt mehr als 100 Sprachen. Gemma 4 E4B läuft technisch gesehen auf dieser Hardware, doch aufgrund der Abhängigkeit von Auslagerungsspeicher sinkt der Durchsatz auf etwa 2 bis 5 tok/s, weshalb es für interaktive Workloads nur schwer zu empfehlen ist.
Der Jetson Orin Nano verändert die Kompromisse. Durch die GPU-Beschleunigung entfallen viele der Speicher- und Rechenbeschränkungen, die beim Raspberry Pi 5 eine Rolle spielen. Gemma 4 E4B wird zu einer praktikablen Option, die etwa 11 bis 14 tok/s erreicht und dabei ihre native multimodale „ Fähigkeiten “, Funktionsaufrufe und das 128K-Kontextfenster beibehält. Wenn Ihre Anwendung auf den Einsatz von Tools angewiesen ist, bleibt auch Qwen3 eine gute Wahl, obwohl noch keine verifizierten Durchsatzwerte für Jetson vorliegen. Phi-4-Mini ist eine gute Option für Agenten mit hohem Rechenaufwand, Sie sollten jedoch die Leistung auf Ihrer Zielhardware überprüfen, bevor Sie in die Produktion gehen.
Bei Edge-Servern oder Systemen wie dem Mac Mini M4 mit 16 bis 32 GB einheitlichem Speicher richtet sich die Modellauswahl eher nach den Anforderungen der „ Workload “ als nach der Hardware. Wählen Sie Phi-4-Mini für Schlussfolgerungen und Codegenerierung, Gemma 4 E4B für multimodale KI-Anwendungen und Qwen3, wenn zuverlässiger Tool-Aufruf und mehrsprachige Unterstützung oberste Priorität haben. Auf dieser Hardware-Ebene gibt es keinen eindeutigen Sieger, da jedes Modell eine andere Fähigkeit optimiert.
Die Quantisierung hat ebenso große Auswirkungen auf „ Deployment “ wie die Modellauswahl. Für die meisten Edge-Hardware-Systeme bietet Q4_K_M das beste Gleichgewicht zwischen Speicherverbrauch, Durchsatz und Qualität. Dabei bleiben etwa 97 bis 99 Prozent der FP16-Qualität erhalten, während der Speicherbedarf reduziert und die Inferenzgeschwindigkeit verbessert wird. Wenn Ihr „ Workload “ präzisionsempfindliche Schlussfolgerungen oder Codegenerierung umfasst und Ihre Hardware über ausreichend Speicher verfügt, lohnt es sich in der Regel, mit Q5_K_M oder Q8_0 zu experimentieren.
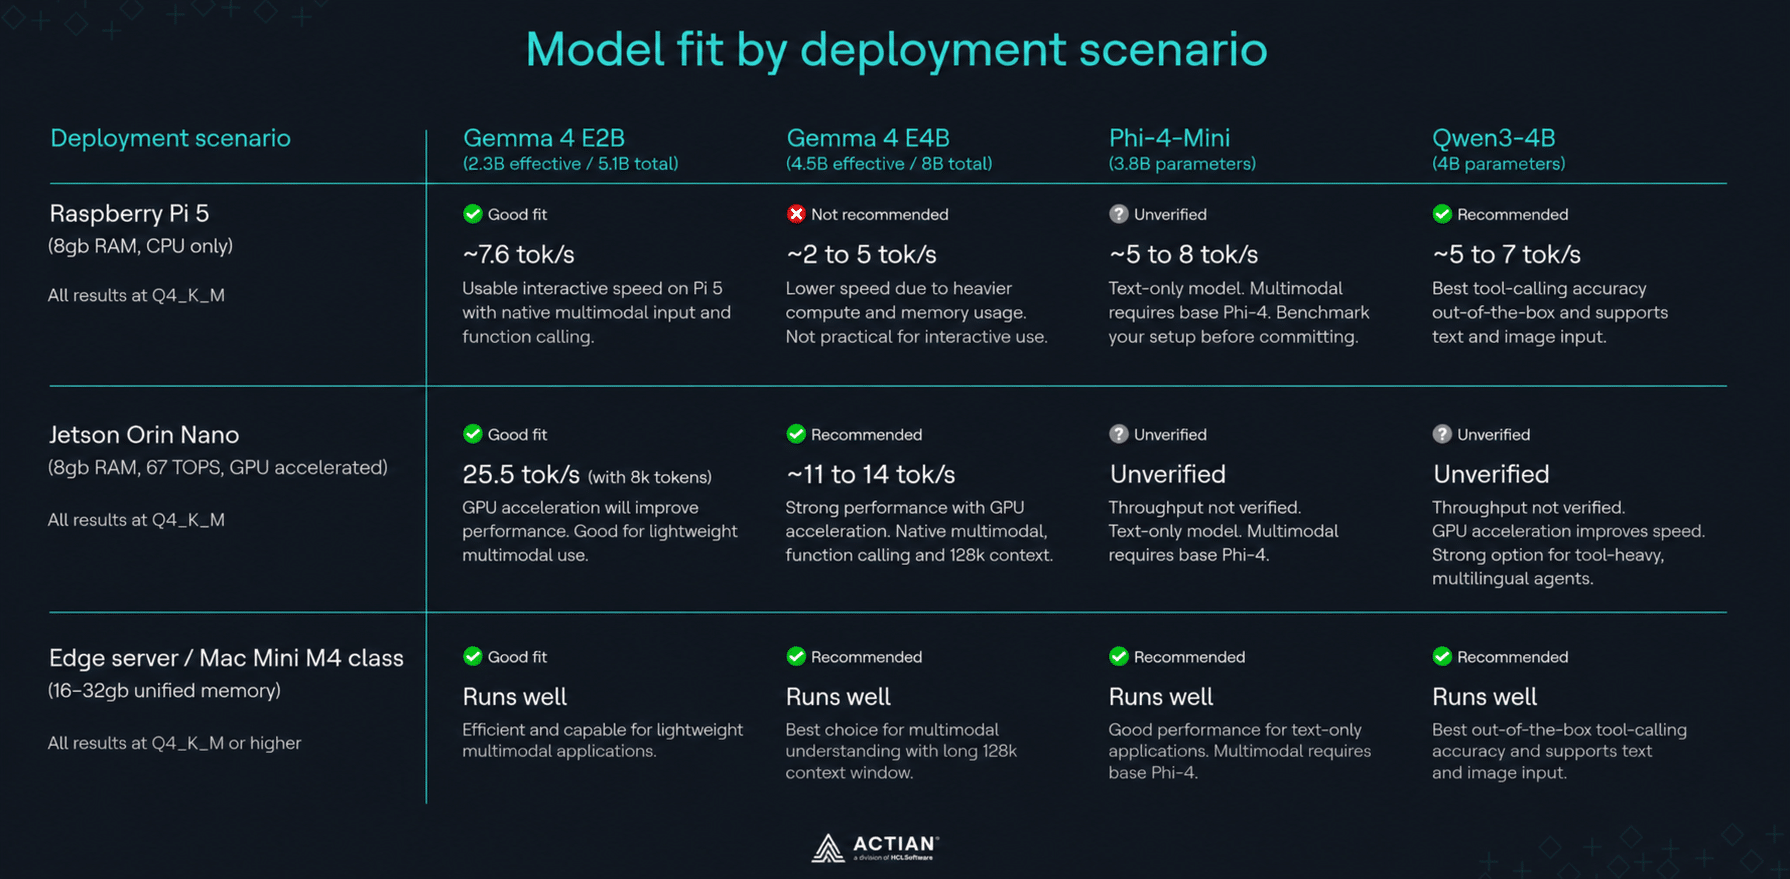
Modellanpassung nach dem „ Deployment “-Szenario
Was bei diesem Vergleich außer Acht gelassen wird
Die Auswahl des richtigen Modells ist nur der erste Schritt bei der Entwicklung eines gerätebasierten KI-Agenten. Sobald Sie ein Modell und eine Quantisierungsstufe ausgewählt haben, die zu Ihrer Hardware passen, müssen Sie als Nächstes entscheiden, wie Ihr Agent Informationen abrufen und speichern soll. An dieser Stelle gewinnt die Abrufschicht ebenso an Bedeutung wie die Inferenzschicht.
Retrieval-Augmented Generation (RAG) kombiniert ein Inferenzmodell mit einem Vektorspeicher, der vor der Generierung relevante Informationen abruft. Dabei handelt es sich um separate Komponenten mit unterschiedlichen Ressourcenanforderungen. Ein Modell, das problemlos in Ihr Hardware-Budget passt, kann dennoch eine schlechte Leistung erbringen, wenn die Abrufebene zu viel Arbeitsspeicher oder Speicherplatz beansprucht.
In dieser Phase stehen Ihnen drei Optionen für „ Deployment “ zur Verfügung:
- In-memory Abruf. Die Einbettungen verbleiben im Arbeitsspeicher (RAM), was die geringste Latenz beim Abruf gewährleistet. Allerdings gehen alle indizierten Daten verloren, wenn die Anwendung neu gestartet wird.
- Dateisystembasierte „ eingebettet “-Vektordatenbank. Die Einbettungen werden auf der Festplatte gespeichert, wodurch Persistenz gewährleistet ist, ohne dass ein separater Server erforderlich ist. Diese Option eignet sich besonders für Edge-Geräte mit begrenzten Ressourcen.
- Spezielle lokale Vektordatenbank. Eine lokale Datenbank verwaltet parallel zum Inferenzprozess die Indizierung, Filterung und Abfrage im Produktionsmaßstab. Dieser Ansatz unterstützt größere Datensätze und anspruchsvollere Abfrage-Workloads, erfordert jedoch zusätzliche Systemressourcen.
Die richtige Wahl hängt von der Größe Ihrer Wissensdatenbank, Ihren Latenzanforderungen und den nach der Modellinferenz verfügbaren Hardware-Ressourcen ab.
Zum Abschluss
Phi-4-Mini, Gemma 4 und Qwen3 haben jeweils eine eigene Rolle bei Edge-AI-Implementierungen eingenommen. Gemma 4 ist die beste Wahl, wenn Ihre Anwendung auf native multimodale Eingaben und lange Kontextfenster angewiesen ist. Phi-4-Mini legt den Schwerpunkt auf die Qualität der Schlussfolgerungen und den Durchsatz bei Arbeitslasten im Bereich Planung und Codegenerierung. Qwen3 zeichnet sich besonders für KI-Agenten im Produktionsbetrieb aus, die einen zuverlässigen Tool-Aufruf und umfassende mehrsprachige Unterstützung erfordern. Anstatt nach einem einzigen Sieger zu suchen, sollten Sie das Modell an Ihre Hardware, Ihre Latenzvorgabe und Ihre Workload anpassen.
Die Hardware ist genauso wichtig wie die Modellauswahl. Ein Raspberry Pi 5 mit 8 GB RAM eignet sich besonders für kleinere, effizient quantisierte Modelle, während der Jetson Orin Nano durch GPU-Beschleunigung auch größere Modelle wie Gemma 4 E4B praxistauglich macht. Auf Edge-Servern und Systemen mit 16 bis 32 GB einheitlichem Speicher wird Ihr „ Workload “ zum entscheidenden Faktor – anstelle von Hardware-Einschränkungen. In jedem Fall bestimmen der Quantisierungsgrad und die Abrufarchitektur die Leistung Ihrer Anwendung.
Starten Sie noch heute mit der Actian VectorAI DB Community Edition. Werfen Sie einen Blick in die Dokumentation und nehmen Sie an der Discord-Community teil, um Unterstützung zu erhalten und sich auszutauschen.
Häufig gestellte Fragen (FAQs)
Kann ich alle Modelle auf einem Raspberry Pi 5 mit 8 GB RAM ausführen?
Ja, aber die Leistung variiert erheblich. Gemma 4 E2B läuft mit etwa 7,6 tok/s und eignet sich für den interaktiven Einsatz. Gemma 4 E4B läuft ebenfalls, doch die intensive Nutzung des Auslagerungsspeichers reduziert den Durchsatz auf etwa 2 bis 5 tok/s, was es für dialogorientierte Arbeitslasten zu langsam macht. Qwen3-4B erreicht etwa 5 bis 7 Tok/s, was für den interaktiven Einsatz ausreichend ist, und bietet die höchste Genauigkeit bei der Tool-Aufrufauswahl unter den dreien. Phi-4-Mini erreicht etwa 5 bis 8 Tok/s.
Was ist, wenn ich sowohl mehrsprachige Unterstützung als auch Funktionsaufrufe benötige?
Entscheiden Sie sich für Qwen3. Es bietet die höchste Genauigkeit beim Aufruf von Tools direkt nach der Installation und unterstützt mehr als 100 Sprachen. Gemma 4 verfügt über native Funktionsaufrufe, erreicht jedoch nicht die mehrsprachige Fähigkeiten von Qwen3. Phi-4-Mini legt den Schwerpunkt eher auf das logische Schlussfolgern als auf den Einsatz von Tools.
Ist Q4_K_M gut genug für die Produktion?
Für die meisten Edge-Bereitstellungen gilt: Ja. Q4_K_M behält etwa 97 bis 99 Prozent der FP16-Qualität bei und reduziert gleichzeitig den Speicherbedarf, während der Durchsatz um das Zwei- bis Dreifache gesteigert wird. Wechseln Sie zu Q5_K_M oder Q8_0 für präzisionskritische Workloads wie Codegenerierung oder komplexe Schlussfolgerungen, wenn Ihre Hardware über ausreichend Speicher verfügt.
Häufige Probleme
Das Modell überschreitet im vierten Quartal den verfügbaren Arbeitsspeicher
Wählen Sie eine kleinere Modellvariante, wenn Qualität für Sie im Vordergrund steht. Wenn Sie dasselbe Modell beibehalten müssen, verwenden Sie eine aggressivere Quantisierungsstufe wie beispielsweise Q3_K_M – rechnen Sie jedoch mit einem stärkeren Rückgang der Schlussfolgerungsqualität.
Quantisierungsartefakte in den Ergebnissen der Schlussfolgerung
Verwenden Sie Q5_0 oder Q8_0 für die Inferenz und die Codegenerierung, sofern der Speicherplatz dies zulässt. Q4_K_M ist die bessere Wahl für allgemeine Inferenzanwendungen, bei denen Durchsatz und Speichereffizienz wichtiger sind als maximale Genauigkeit.
Tool-Aufrufe sind langsam oder fehlerhaft
Stellen Sie sicher, dass Ihre Eingabeaufforderung dem vom Modell erwarteten Format für den Tool-Aufruf entspricht. Wenn Zuverlässigkeit entscheidend ist, wählen Sie „Qwen3“, das unter den drei Modellen die beste Standardleistung beim Tool-Aufruf bietet.
Bleiben Sie in Verbindung
Datenanalysen direkt bei Ihnen.
(z. B. sales@..., support@...)
