

Erstellen Sie ein Offline-System zur visuellen Fehlersuche mit CLIP und der VectorAI-Datenbank


Wichtigste Erkenntnisse
- Mit CLIP und Actian VectorAI DB können Hersteller Fehlerbilder anhand von Text oder Fotos durchsuchen, wobei der gesamte Arbeitsablauf offline bleibt.
- CLIP wandelt Bilder und Text in einen gemeinsamen Vektorraum um, während VectorAI DB diese Vektoren zusammen mit durchsuchbaren Fehler Metadaten en speichert.
- Metadaten Durch die Filterung können Teams die Ergebnisse bereits während der Suche nach Teilkategorie oder Fehlerstatus eingrenzen, anstatt die Ergebnisse erst im Nachhinein zu filtern.
- FAISS ermöglicht eine schnellere Rohdatensuche in kleinem Maßstab, während VectorAI DB dauerhaften Speicher, Filterung nach „ Metadaten “ sowie den Zugriff von mehreren Rechnern aus bietet.
- Bei industriellen Anwendungen stellt der Kodierungsdurchsatz oft eine größere Einschränkung dar als der Vektorspeicher oder die Latenz bei der Datenbanksuche.
Produktionsstätten bewahren oft jahrelang Fotos von Fehlern auf, ohne dass eine Suchfunktion zur Verfügung steht. Wenn ein Teil mit einer unbekannten Markierung vom Band läuft, muss jemand Ordner öffnen und darin nachsehen. CLIP wandelt Bilder und Text in Vektoren um, die Sie vergleichen können. Die Actian VectorAI DB speichert diese Vektoren und durchsucht sie. Zusammen ersetzen sie die Suche in Ordnern und laufen offline auf Hardware innerhalb der Produktionsstätte.
Ein Qualitätsingenieur kann eine Beschreibung eingeben oder dem System ein Foto des neuen Fehlers übermitteln. Beide unten aufgeführten Beispiele werden anhand des MVTec AD-Fehler Datensatz s geprüft.
Suche nach Beschreibung:
$ uv run query.py --text "surface scratch on metal component" --part-category metal_nut

Text query: "surface scratch on metal component"  [part_category=metal_nut]
  score  category     defect           path
 0.2814  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/003.png
 0.2691  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/011.png
 0.2607  metal_nut    color            ./mvtec_ad/metal_nut/test/color/007.png
 0.2588  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/000.png
 0.2470  metal_nut    bent             ./mvtec_ad/metal_nut/test/bent/014.png

encode 18.4 ms | search 2.1 ms | total 20.5 ms
Suche anhand eines Fotos:
$ uv run query.py --image ./line_capture_0412.png --defect-only

Image query: ./line_capture_0412.png  [is_defect=true]
  score  category     defect           path
 0.8912  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/006.png
 0.8744  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/002.png
 0.8593  hazelnut     print            ./mvtec_ad/hazelnut/test/print/010.png
 0.8471  hazelnut     hole             ./mvtec_ad/hazelnut/test/hole/004.png
 0.8226  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/013.png

encode 41.7 ms | search 1.9 ms | total 43.6 ms
Die Textwerte Cluster liegen bei etwa 0,26. Die Bildwerte Cluster liegen bei etwa 0,89. Ein Satz und ein Foto liegen nie so nah beieinander wie zwei Fotos. Vergleichen Sie die Werte innerhalb eines abfragen Modus, niemals zwischen den Modi.
Beide Suchvorgänge wurden mit einem Filter durchgeführt,--part-category beschränkte die Textsuche auf Bilder von Metallmuttern, damit kein Fehler in Bezug auf Flaschen oder Haselnüsse auftauchen konnte, und--defect-only Jedes Bild, das als „gutes Teil“ gekennzeichnet war, wurde aus der Fotosuche ausgeschlossen. Beide Filter lesen während der Suche die neben jedem Vektor gespeicherten Werte „ Metadaten “, anstatt die fertige Ergebnisliste nachträglich zu filtern. Ein einfacher Vektorindex unterstützt keinen der beiden Filter, da er lediglich Vektoren und numerische IDs speichert und keine Möglichkeit bietet, zu „ Aufzeichnung “, dass ein Bild eine Metallmutter zeigt oder dass das Teil fehlerhaft war.
Die Zeitangaben stammen von einem Rechner, auf dem ausschließlich „ CPU “ läuft. Der Großteil der Zeit entfällt auf die CLIP-Kodierung. Die Datenbanksuche dauert etwa zwei Millisekunden. Im Abschnitt „Benchmark“ werden beide Werte für die angegebene Hardware separat aufgeführt.
Warum FAISS in der Produktion nicht funktioniert
FAISS ist ein Index. VectorAI DB ist eine Datenbank. FAISS speichert Vektoren und ganzzahlige IDs innerhalb eines Prozesses. VectorAI DB speichert jeden Vektor mit einer Nutzlast im Format „ Metadaten “, filtert bei der Suche nach diesen Feldern und läuft als Dienst, auf den andere Rechner zugreifen können.
Häufig wird behauptet, dass FAISS keinen Index speichern oder seine Ergebnisse filtern kann. FAISS kann beides, wie dieser Codeausschnitt zeigt.
import faiss, numpy as np, tempfile, os

d, n = 512, 1000
x = np.random.randn(n, d).astype('float32'); faiss.normalize_L2(x)
idx = faiss.IndexFlatIP(d); idx.add(x)

fd, path = tempfile.mkstemp(suffix='.faiss'); os.close(fd)
faiss.write_index(idx, path)                                  # persistence
reloaded = faiss.read_index(path)
print(np.array_equal(idx.search(x[:1], 5)[1],
                     reloaded.search(x[:1], 5)[1]))           # True

allowed = np.array([5, 10, 15, 20, 25, 30], dtype='int64')
sel = faiss.IDSelectorBatch(allowed)                          # filtering
_, ids = idx.search(x[:1], 3, params=faiss.SearchParameters(sel=sel))
print(set(ids[0]).issubset(set(allowed.tolist())))            # True
Bei der ersten Überprüfung wird der Index von der Festplatte neu geladen und es werden dieselben Nachbarn wie im Original zurückgegeben. Bei der zweiten Überprüfung wird die Suche auf sechs zulässige IDs beschränkt, und jedes Ergebnis liegt innerhalb dieser Liste. Ein FAISS-Betreuer bestätigte write_index seit 2017, und IDSelector Das Filtern ist im Wiki.
FAISS kostet Sie bei einem Anlagen Deployment us nach wie vor drei Dinge.
- Sie pflegen den „ Metadaten “-Speicher manuell: FAISS speichert Vektoren und ganzzahlige IDs. Es enthält keine Informationen wie „Dies ist eine metal_nut, der Defekt ist ein Kratzer, die Datei befindet sich unter diesem Pfad.“ Diese Informationen befinden sich in einer Pickle- oder SQLite-Datei neben dem Index, und es ist Ihre Aufgabe, beide Dateien synchron zu halten. Das Filtern nach Teilekategorien bedeutet, eine Zuordnung von Kategorie zu ID zu erstellen, diese zu laden und einen IDSelector pro „ abfragen “ zu konstruieren; anschließend muss die Zuordnung bei jeder Änderung des Korpus neu erstellt werden. Wenn ein Erfassungslauf vorzeitig abbricht, gleicht man den Index und die Sidecar-Datei manuell ab.
- Das Filtern anhand eines Graphindexes geht zu Lasten der Recall-Rate, der Latenz oder beidem: Der obige Codeausschnitt verwendet IndexFlatIP, das exakt arbeitet, sodass das Filtern dort kostenlos ist. In Produktionskorpora wird stattdessen HNSW verwendet. Ein selektiver Filter wirkt sich negativ auf die Graphdurchquerung aus. Die Durchquerung landet immer wieder bei Nachbarn, die der Filter ablehnt. Bei den Standardeinstellungen übersieht die Suche den Großteil dessen, was sie finden sollte, und kann manchmal nicht einmal die Ergebnismenge füllen. Um diesen Recall wiederherzustellen, muss „efSearch“ weit über den Standardwert hinaus erhöht werden, was zu Lasten der „ abfragen “-Zeit geht. Der Benchmark-Abschnitt misst diesen Kompromiss anhand konkreter Zahlen. VectorAI DB wendet den Filter direkt in der Suche an, anstatt es Ihnen zu überlassen, diesen Parameter selbst zu ermitteln.
- Es gibt keinen Server: FAISS läuft innerhalb eines einzigen „ Python “-Prozesses. Zwei Prüfstationen, die auf denselben Korpus zugreifen, bedeuten zwei Kopien des Indexes in zwei Prozessen – oder Sie schreiben die Service-Schicht selbst, einschließlich der „ Zustimmung “ und des Neustartverhaltens.
VectorAI DB stellt diese drei Komponenten direkt bereit. „ Metadaten “ ist in der Nutzlast enthalten, Filter werden während der Suche angewendet, und die Datenbank läuft in einem Container, auf den jeder Rechner zugreifen kann. Dank dieser Eigenschaften kann eine Edge-Retrieval-Pipeline auch ohne Internetverbindung ausgeführt werden, und dieses System wendet sie auf Bilder an. FAISS ist nach wie vor das richtige Werkzeug, um Abrufmethoden in einem Notebook zu vergleichen. Wenn Sie eine umfassendere Darstellung darüber wünschen, in welchen Fällen FAISS und ähnliche Bibliotheken im Vergleich zu einer Produktionsdatenbank geeignet sind, lesen Sie den Artikel „Best- Python -Vektordatenbank-Bibliotheken“.
Was du baust
Sie werden einen einzigen Index erstellen, der beide Arten von abfragen beantwortet und nach der Einrichtung keine Netzwerkaufrufe mehr durchführt.
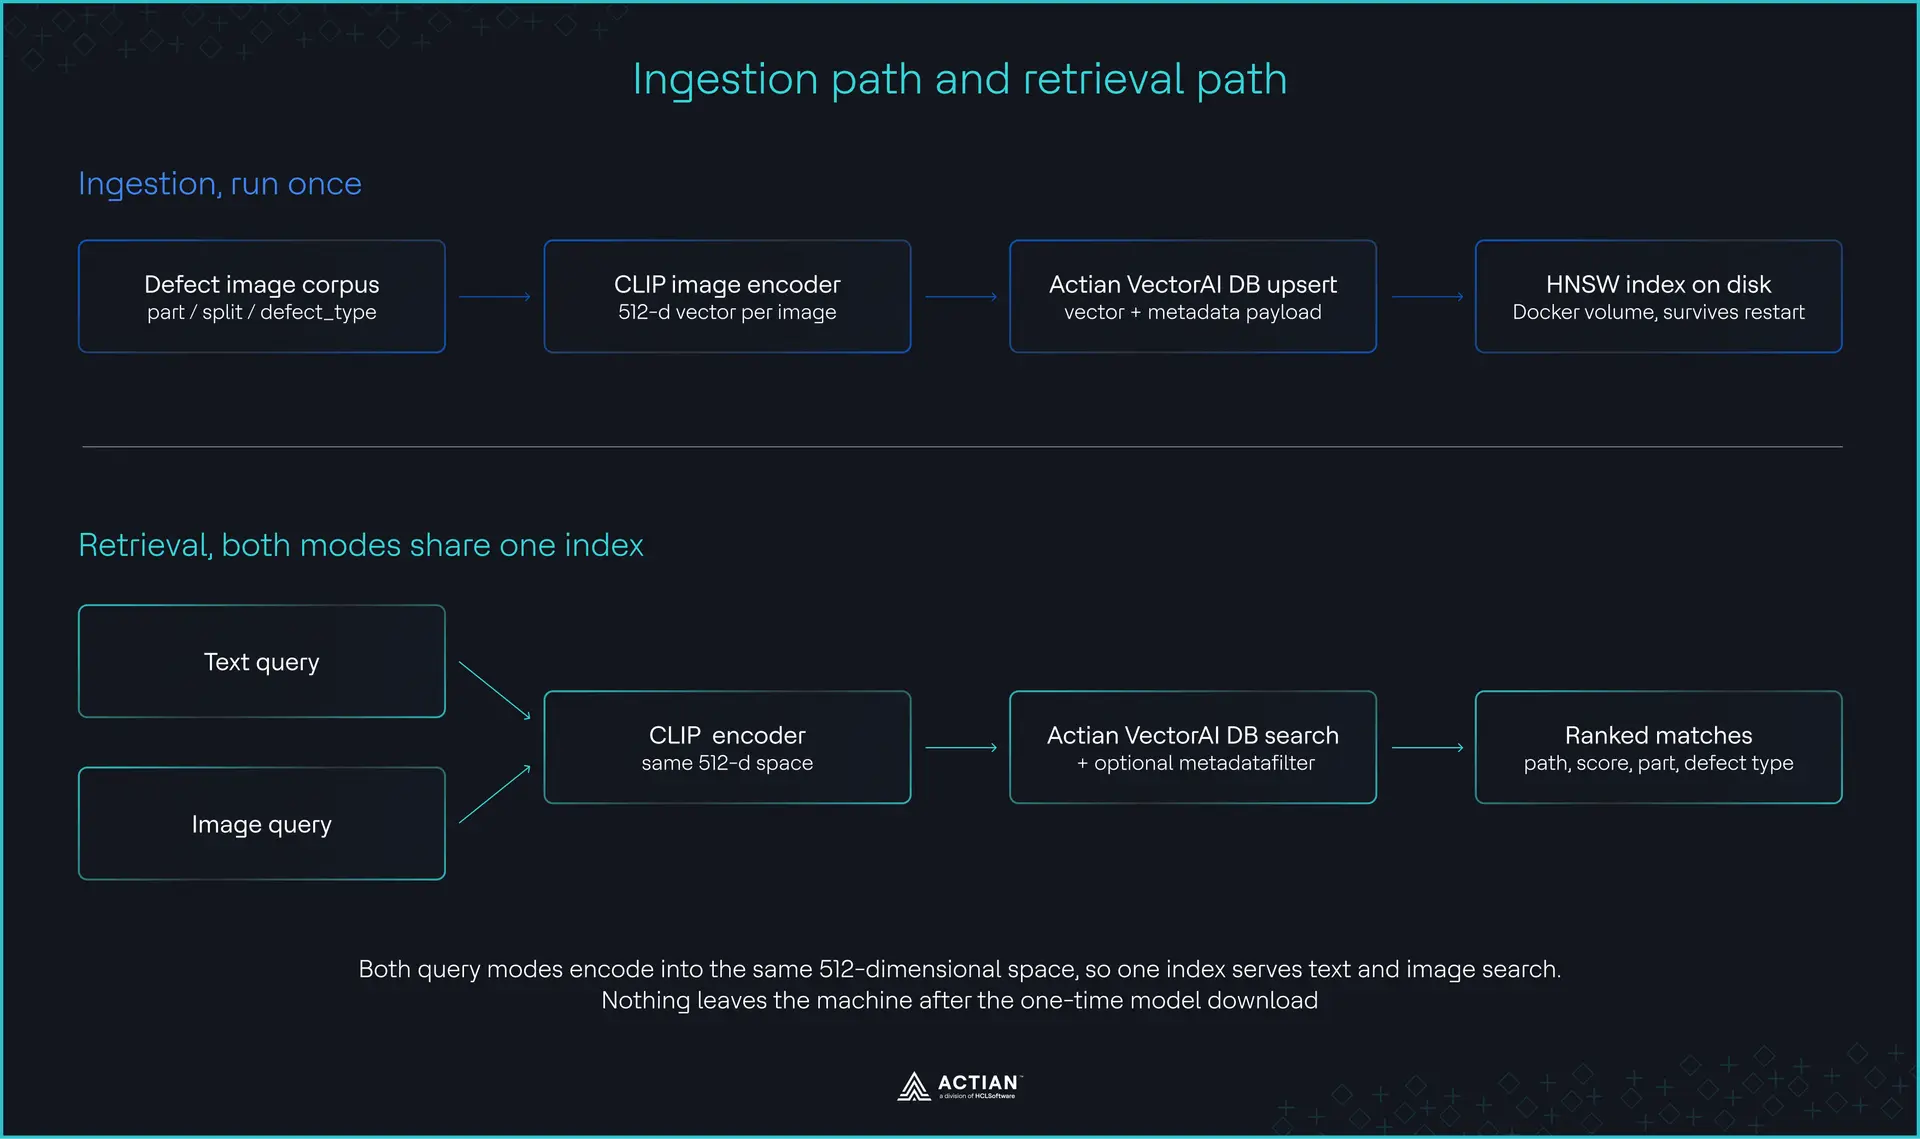
Aufnahmeweg und Entnahmeweg
CLIP ermöglicht beide Modi über einen einzigen Index. Das openai/clip-vit-base-patch32 Checkpoint nutzt einen ViT-B/32-Bild-Encoder und einen zwölfschichtigen Text-Transformer und projiziert beide anschließend in denselben Raum. Sein Modellkonfigurationssätze projection_dim bis 512, sodass sowohl ein Foto als auch ein Satz zu 512-dimensionalen Vektoren werden, die sich ein Koordinatensystem teilen. Allein diese Tatsache ist der Grund, warum eine Sammlung beide Fragen beantwortet.
VectorAI DB speichert jeden Vektor zusammen mit einer Nutzlast: part_category, defect_type, image_path, und ein is_defect Flag. Die Nutzlast ist das, was aus „ähnliche Bilder finden“ ein „ähnliche Fehler an Flaschen finden, wobei einwandfreie Exemplare ausgeschlossen werden“ macht.
Bevor Sie darauf aufbauen, sollten Sie einen wichtigen Vorbehalt beachten. In der Modellbeschreibung von OpenAI selbst heißt es, dass CLIP nicht für allgemeine Zwecke entwickelt wurde Deployment. Dort wird empfohlen, vor dem praktischen Einsatz gründliche Tests innerhalb des jeweiligen Anwendungsbereichs durchzuführen, und es wird darauf hingewiesen, dass die Leistung davon abhängt, wie die Klassen gestaltet sind. Die Qualität der Suchergebnisse müssen Sie selbst messen und dürfen sie nicht einfach voraussetzen. Im Abschnitt „Benchmark“ erfahren Sie, wie das geht.
Nach dem einmaligen Herunterladen des Modells wird hier keine Verbindung zum Netzwerk hergestellt.
Einrichten des Stacks
Bevor Sie etwas indizieren können, müssen die CLIP-Gewichtungen auf der Festplatte vorhanden sein, die Datenbank mit einem gemounteten Volume laufen und ein Korpus zur Suche bereitstehen.
Erstellen Sie das Projekt und fügen Sie die Abhängigkeiten hinzu
In diesem Tutorial wird „uv“ verwendet, das alles in einem Schritt auflöst und fixiert und so die Reproduzierbarkeit der Umgebung gewährleistet.
uv init defect-search
cd defect-search
uv add torch transformers pillow actian-vectorai-client matplotlib
Wenn Sie stattdessen pip verwenden, pip install torch transformers pillow actian-vectorai-client matplotlib installiert dieselben Pakete, und jedes uv run Das Folgende wird zu einer einfachen python Anruf.
Laden Sie die CLIP-Gewichte herunter, solange der Rechner noch über einen Netzwerkzugang verfügt, da der Werksrechner möglicherweise nie darüber verfügen wird:
uv run huggingface-cli download openai/clip-vit-base-patch32Der Checkpoint ist etwa 605 MB groß und wird im Cache gespeichert unter ~/.cache/huggingface, wobei from_pretrained findet es bei jedem späteren Durchlauf. Um es auf einen Rechner mit Luftspalt zu verschieben, kopieren Sie dieses Verzeichnis dorthin und legen Sie HF_HUB_OFFLINE=1 Die Bibliothek versucht also niemals, eine Verbindung zum Internet herzustellen.
VectorAI-Datenbank starten
Erstellen Sie eine docker-compose.yml Datei zur Installation von VectorAI DB:
services:
  vectorai:
    image: actian/vectorai:latest
    container_name: vectorai
    ports:
      - "6573:6573"   # REST API
      - "6574:6574"   # gRPC API, used by the Python SDK
      - "6575:6575"   # local web UI
    volumes:
      - ./vectorai_data:/var/lib/actian-vectorai
    environment:
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    restart: unless-stopped
Starten Sie den Container, indem Sie den folgenden Befehl ausführen:
docker-compose up -dDas Ergebnis sollte wie folgt aussehen:

VectorAI DB starten
Die Portzuweisungen und die Variable „EULA“ stammen aus der Anleitung zur Einrichtung von VectorAI DB mit Docker. Bevor Sie fortfahren, speichern Sie dies als smoke_test.py und führen Sie es aus, um zu überprüfen, ob die Datenbank antwortet:
# smoke_test.py
from actian_vectorai import VectorAIClient

with VectorAIClient("localhost:6574") as client:
    print(client.health_check())
Führen Sie den Test wie folgt durch:
uv run smoke_test.pyWenn dabei die Serverdaten angezeigt werden und kein Verbindungsfehler auftritt, ist die Datenbank einsatzbereit.
Ein Korpus beschaffen
In diesem Tutorial wird MVTec AD verwendet, das 5.354 hochauflösende Bilder aus 15 Objekt- und Texturkategorien umfasst – fünf Texturen und zehn Objekte – mit mehr als siebzig verschiedenen Fehlerarten.
Laden Sie es von der MVTec-Website herunter und entpacken Sie es in den Ordner ./mvtec_ad.
Datensatz Lizenz: ausschließlich zu Forschungs- und Evaluierungszwecken. MVTec AD wird unter folgender Lizenz veröffentlicht: CC BY-NC-SA 4.0. MVTec weist darauf hin, dass der „ Datensatz “ für nichtkommerzielle Forschungszwecke bestimmt ist und nicht kommerziell genutzt werden darf. Wenn Sie dieses Gerät also für ein Werk bauen, das seine Produkte verkauft, dürfen Sie keine MVTec-Images darauf ausliefern. Hinweis ingest.py stattdessen in Ihrem eigenen Prüfarchiv. Hier hängt nichts von MVTec ab: Das Skript liest jedes Verzeichnis aus, das wie folgt aufgebaut ist: <part_category>/<split>/<defect_type>/<image>, und scan_corpus ist die einzige Funktion, die Sie ändern müssen, falls Ihre davon abweicht.
Den gemeinsamen Encoder schreiben
Beide Skripte werden aus einem Modul importiert, sodass der Bildpfad und der Textpfad nicht voneinander abweichen können.
# clip_encoder.py
from __future__ import annotations

from pathlib import Path
from typing import Sequence

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

MODEL_ID = "openai/clip-vit-base-patch32"
EMBED_DIM = 512


def _features(out) -> torch.Tensor:
    """
    transformers 4.x returns a Tensor from get_image_features and
    get_text_features. transformers 5.x returns a
    BaseModelOutputWithPooling whose pooler_output holds the
    projected vector. Handle both so this does not break on upgrade.
    """
    return out if isinstance(out, torch.Tensor) else out.pooler_output


class ClipEncoder:
    def __init__(self, model_id: str = MODEL_ID, device: str | None = None) -> None:
        self.device = device or ("cuda" if torch.cuda.is_available() else "cpu")
        self.model = CLIPModel.from_pretrained(model_id).to(self.device).eval()
        self.processor = CLIPProcessor.from_pretrained(model_id)

    @torch.inference_mode()
    def encode_images(self, paths: Sequence[str | Path]) -> torch.Tensor:
        images = [Image.open(p).convert("RGB") for p in paths]
        inputs = self.processor(images=images, return_tensors="pt").to(self.device)
        vecs = _features(self.model.get_image_features(**inputs))
        return torch.nn.functional.normalize(vecs, dim=-1).cpu()

    @torch.inference_mode()
    def encode_text(self, texts: Sequence[str]) -> torch.Tensor:
        inputs = self.processor(
            text=list(texts), return_tensors="pt", padding=True, truncation=True
        ).to(self.device)
        vecs = _features(self.model.get_text_features(**inputs))
        return torch.nn.functional.normalize(vecs, dim=-1).cpu()
Das features Der Helper existiert, weil sich Transformers 5.x geändert hat get_image_features um ein BaseModelOutputWithPooling Objekt anstelle eines Tensors. Der einzeilige Aufruf, der in den meisten veröffentlichten CLIP-Tutorials vorkommt, schlägt nun bei einer Neuinstallation mitAttributeError: 'BaseModelOutputWithPooling' object has no attribute 'shape', und die Hilfsfunktion funktioniert bei beiden Versionen. Durch die Normierung jedes Vektors vor der Rückgabe wird aus der Kosinusähnlichkeit ein einfaches Skalarprodukt.
Indizierung des Fehlerkorpus
Die Ingestion erfolgt stapelweise und fügt jeden Vektor mit seiner „ Metadaten “ ein oder aktualisiert ihn. Die CLIP-Kodierung stellt den Engpass dar; die Schreibvorgänge in die Datenbank sind im Vergleich dazu vernachlässigbar.
MVTec speichert Dateien als <part_category>/<split>/<defect_type>/<file>.png, was bedeutet, dass die Verzeichnisstruktur bereits alle benötigten „ Metadaten “-Felder enthält:
# ingest.py
from __future__ import annotations

import argparse
import time
from pathlib import Path

from actian_vectorai import (
    VectorAIClient, PointStruct, VectorParams, Distance, CollectionExistsError,
)

from clip_encoder import ClipEncoder, EMBED_DIM

IMAGE_SUFFIXES = {".png", ".jpg", ".jpeg", ".bmp"}


def scan_corpus(root: Path) -> list[dict]:
    """Read metadata straight out of the directory layout."""
    records: list[dict] = []
    for path in sorted(root.rglob("*")):
        if path.suffix.lower() not in IMAGE_SUFFIXES:
            continue
        if "ground_truth" in path.parts:      # segmentation masks, not photos
            continue
        try:
            rel = path.relative_to(root)
            part_category, _split, defect_type = rel.parts[0], rel.parts[1], rel.parts[2]
        except (ValueError, IndexError):
            continue
        records.append(
            {
                "image_path": str(path),
                "part_category": part_category,
                "defect_type": defect_type,
                "is_defect": defect_type != "good",
            }
        )
    return records


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--data", default="./mvtec_ad")
    ap.add_argument("--collection", default="defect_search")
    ap.add_argument("--url", default="localhost:6574")
    ap.add_argument("--batch-size", type=int, default=32)
    args = ap.parse_args()

    records = scan_corpus(Path(args.data))
    if not records:
        raise SystemExit(f"No images found under {args.data}")
    print(f"Found {len(records)} images")

    encoder = ClipEncoder()
    print(f"CLIP running on {encoder.device}")

    with VectorAIClient(args.url) as client:
        try:
            client.collections.create(
                args.collection,
                vectors_config=VectorParams(size=EMBED_DIM, distance=Distance.Cosine),
            )
            print(f"Created collection '{args.collection}'")
        except CollectionExistsError:
            print(f"Collection '{args.collection}' already exists, appending")

        started = time.perf_counter()
        done = 0

        for start in range(0, len(records), args.batch_size):
            batch = records[start : start + args.batch_size]
            vectors = encoder.encode_images([r["image_path"] for r in batch])

            client.points.upsert(
                args.collection,
                points=[
                    PointStruct(id=start + offset, vector=vec.tolist(), payload=record)
                    for offset, (record, vec) in enumerate(zip(batch, vectors))
                ],
            )

            done += len(batch)
            elapsed = time.perf_counter() - started
            rate = done / elapsed if elapsed else 0.0
            remaining = (len(records) - done) / rate if rate else 0.0
            print(
                f"\r{done}/{len(records)} images "
                f"| {rate:.1f} img/s | ~{remaining/60:.1f} min left",
                end="", flush=True,
            )

        print(f"\nIndexed {done} images in {(time.perf_counter()-started)/60:.1f} min")
        print(f"Collection now holds {client.points.count(args.collection)} points")


if __name__ == "__main__":
    main()
Manche Zeilen in diesem Skript wirken wie willkürliche Entscheidungen, aber wenn man sie ändert, führt das zu Problemen. scan_corpus überspringt das ground_truth Ordner, da diese Pixelmasken enthalten, und das Indizieren von Masken führt dazu, dass Ihre Ergebnisse mit schwarz-weißen Formen gefüllt werden, die mit nichts übereinstimmen, was eine Kamera erzeugt. Die Sammlung wird mit einer Dimension von 512 und einem Kosinus-Abstand erstellt, um dem Encoder zu entsprechen, und eine Nichtübereinstimmung führt hier zu keinerlei Fehlermeldung, sondern lediglich zu Suchergebnissen, die nach und nach keinen Sinn mehr ergeben.
Das except Klausel-Fallen CollectionExistsError gerade weil ein bloßer except Exception würde zudem eine abgelehnte Verbindung oder einen Dimensionskonflikt verbergen, und Sie möchten, dass ein Dimensionskonflikt das Skript sofort stoppt, anstatt erst Wochen später in Form von fehlerhaften Ergebnissen zutage zu treten.
Führen Sie die Datenerfassung durch:
uv run ingest.py --data ./mvtec_ad
Found 5354 images
CLIP running on cpu
Created collection 'defect_search'
5354/5354 images | 2.1 img/s | ~0.0 min left
Indexed 5354 images in 42.5 min
Collection now holds 5354 points
Rechnen Sie mit 45 bis 90 Minuten für den gesamten Korpus auf einem Rechner, der ausschließlich mit der „ CPU “ arbeitet, und mit wenigen Minuten auf einer modernen GPU. Der oben beschriebene Lauf wurde auf einem Ryzen 7 5800X mit 32 GB RAM durchgeführt, ausschließlich mit der „ CPU “. Eine Batch-Größe von 32 ist ein sinnvoller Standardwert; erhöhen Sie diesen Wert, wenn Sie über freien VRAM verfügen.
Die Persistenzprüfung
Das ist der Unterschied zu FAISS, und es dauert zehn Sekunden, dies zu beweisen:
docker compose restart
uv run query.py --text "cracked surface"
Die Ergebnisse werden sofort für alle 5.354 Vektoren zurückgegeben. Es findet keine Neukodierung statt, da der Index während seiner Erstellung direkt auf das eingebundene Volume geschrieben wurde und nicht erst am Ende als Snapshot gesichert wurde.
Abfragen ausführen
Beide „ abfragen “-Modi bestehen aus denselben drei Schritten: Kodieren, Filtern, Suchen. Nur der Kodierer ändert sich.
# query.py
from __future__ import annotations

import argparse
import time

from actian_vectorai import VectorAIClient, FilterBuilder, Field

from clip_encoder import ClipEncoder

COLLECTION = "defect_search"   # must match the name ingest.py created


def build_filter(part_category: str | None = None, defect_only: bool = False):
    """Metadata filter, applied inside the search rather than after it."""
    builder = FilterBuilder()
    if part_category:
        builder = builder.must(Field("part_category").eq(part_category))
    if defect_only:
        builder = builder.must(Field("is_defect").eq(True))
    return None if builder.is_empty() else builder.build()


def search_by_text(client, encoder, text, part_category=None, defect_only=False, limit=5):
    vector = encoder.encode_text([text])[0].tolist()
    return client.points.search(
        COLLECTION, vector, limit=limit,
        filter=build_filter(part_category, defect_only), with_payload=True,
    )


def search_by_image(client, encoder, image_path, part_category=None, defect_only=False, limit=5):
    vector = encoder.encode_images([image_path])[0].tolist()
    return client.points.search(
        COLLECTION, vector, limit=limit,
        filter=build_filter(part_category, defect_only), with_payload=True,
    )


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--text")
    ap.add_argument("--image")
    ap.add_argument("--part-category")
    ap.add_argument("--defect-only", action="store_true")
    ap.add_argument("--limit", type=int, default=5)
    args = ap.parse_args()
    if not args.text and not args.image:
        raise SystemExit("Pass --text or --image")

    encoder = ClipEncoder()
    with VectorAIClient("localhost:6574") as client:
        t0 = time.perf_counter()
        if args.text:
            results = search_by_text(client, encoder, args.text,
                                     args.part_category, args.defect_only, args.limit)
        else:
            results = search_by_image(client, encoder, args.image,
                                      args.part_category, args.defect_only, args.limit)
        total = (time.perf_counter() - t0) * 1000

    print(f"  score  {'category':<12} {'defect':<16} path")
    for r in results:
        p = r.payload
        print(f"{r.score:7.4f}  {p['part_category']:<12} {p['defect_type']:<16} {p['image_path']}")
    print(f"\ntotal {total:.1f} ms")


if __name__ == "__main__":
    main()
Das COLLECTION Der Name muss mit dem übereinstimmen, was ingest.py angelegt werden, oder jede Suche schlägt mit der Fehlermeldung „Sammlung nicht gefunden“ fehl, während die Daten unberührt in der Datenbank verbleiben. Auch der Filter-Generator ist einen zweiten Blick wert: FilterBuilder.must() Nimmt pro Aufruf eine Bedingung entgegen und gibt den Builder zurück, sodass man Aufrufe verketten kann, um Bedingungen hinzuzufügen, anstatt mehrere auf einmal zu übergeben.
Führen Sie beide Sucharten über die Befehlszeile aus:
uv run query.py --text "surface scratch on metal component" --part-category metal_nut
uv run query.py --image ./line_capture_0412.png --defect-only
Sollten Prüfstationen über das Netzwerk auf das System zugreifen, anstatt „ Python “ lokal auszuführen, kann ein kleiner FastAPI-Dienst davor geschaltet werden. Dieser Teil ist optional:
# app.py  (optional)
from fastapi import FastAPI
from actian_vectorai import VectorAIClient
from clip_encoder import ClipEncoder
from query import search_by_text

app = FastAPI()
encoder = ClipEncoder()          # load once at startup, not on every request
client = VectorAIClient("localhost:6574")
client.connect()


@app.get("/search")
def search(q: str, part_category: str | None = None, limit: int = 5):
    hits = search_by_text(client, encoder, q, part_category=part_category, limit=limit)
    return [
        {"score": h.score, "path": h.payload["image_path"], "defect_type": h.payload["defect_type"]}
        for h in hits
    ]
Derzeit arbeiten beide Sucharten mit einem gefilterten Index, der völlig unabhängig vom Netzwerk ist. Sie können sie also mit der VectorAI DB Community Edition auf Ihre eigenen Inspektionsfotos anwenden, bevor Sie sich die Leistungsdaten ansehen.
Der Maßstab
Messen Sie zwei Dinge: wie sich die Suchlatenz mit zunehmender Korpusgröße verhält und ob die Ergebnisse korrekt sind.
benchmark.py führt 100 Abfragen pro Korpusgröße durch und gibt p50 und p99 an; anschließend wird der Recall@5 anhand der MVTec-Testaufteilung berechnet. Ein Ergebnis gilt als Treffer, wenn mindestens einer der fünf besten Nachbarn denselben Defekttyp aufweist wie das Bild „ abfragen “:
# benchmark.py
def measure_recall_at_k(client, encoder, collection, test_records, k=5) -> float:
    hits = 0
    for record in test_records:
        vec = encoder.encode_images([record["image_path"]])[0].tolist()
        results = client.points.search(
            collection, vector=vec, limit=k + 1, with_payload=True
        )
        neighbours = [
            r for r in results if r.payload["image_path"] != record["image_path"]
        ][:k]
        if any(r.payload["defect_type"] == record["defect_type"] for r in neighbours):
            hits += 1
    return hits / len(test_records) if test_records else 0.0
Das Bild „ abfragen “ darf nicht entfernt werden. Lässt man es drin, wird bei jedem „ abfragen “ das Bild selbst mit einer Ähnlichkeit von 1,0 abgerufen, und der Recall@5-Wert beträgt immer 100 %, unabhängig davon, wie schlecht das Modell tatsächlich abschneidet.
Es gibt zwei Regeln, die festlegen, wie die Zahlen anzugeben sind.
Trennen Sie die Suchlatenz von der Kodierungslatenz. Sie skalieren unterschiedlich, und ein Mittelwert aus beiden sagt nichts über die einzelnen Werte aus. Die Datenbanksuche wächst weitaus langsamer als der Korpus, da die HNSW-Durchsuchung sublinear verläuft. Die CLIP-Kodierung ist pro abfragen konstant und dominiert auf CPU den Gesamtwert. Geben Sie sie separat an, sonst misst Ihr Diagramm eher das Modell als die Datenbank.
Geben Sie die Hardware an und mischen Sie niemals „ CPU “- und „GPU“-Läufe in einer Tabelle. Ein Latenzwert ohne angeschlossenen Rechner ist keine Messung, und eine „ CPU “-Kodierungszeit, die in derselben Spalte wie ein GPU-Wert aufgeführt ist, ist schlimmer als gar kein Wert. make_chart.py nimmt die Hardware-Zeichenkette genau aus diesem Grund als obligatorisches Argument entgegen:
uv run benchmark.py --out benchmark.csv
uv run make_chart.py --csv benchmark.csv --hardware "Ryzen 7 5800X, 32GB RAM, CPU-only"
Hier ist der zu erwartende Verlauf, gemessen anhand von 100 Abfragen pro Korpusgröße im Vergleich zum FAISS-Flat-Index als Referenz:
| Korpus | VectorAI DB p50 | VectorAI DB, S. 99 | FAISS flach p50 | FAISS flach p99 | Rückruf@5 |
|---|---|---|---|---|---|
| 1,000 | 0,148 ms | 0,198 ms | 0,053 ms | 0,112 ms | 1.000 |
| 5,000 | 0,676 ms | 0,725 ms | 0,410 ms | 0,462 ms | 0.996 |
| 10,000 | 1,036 ms | 1,272 ms | 0,809 ms | 0,863 ms | 0.974 |
Hardware: Geben Sie Ihren „ CPU “, den Arbeitsspeicher (RAM) sowie an, ob CLIP auf „ CPU “ oder auf der GPU ausgeführt wurde. Nur Suchzeit; die CLIP-Kodierung wird nicht berücksichtigt.
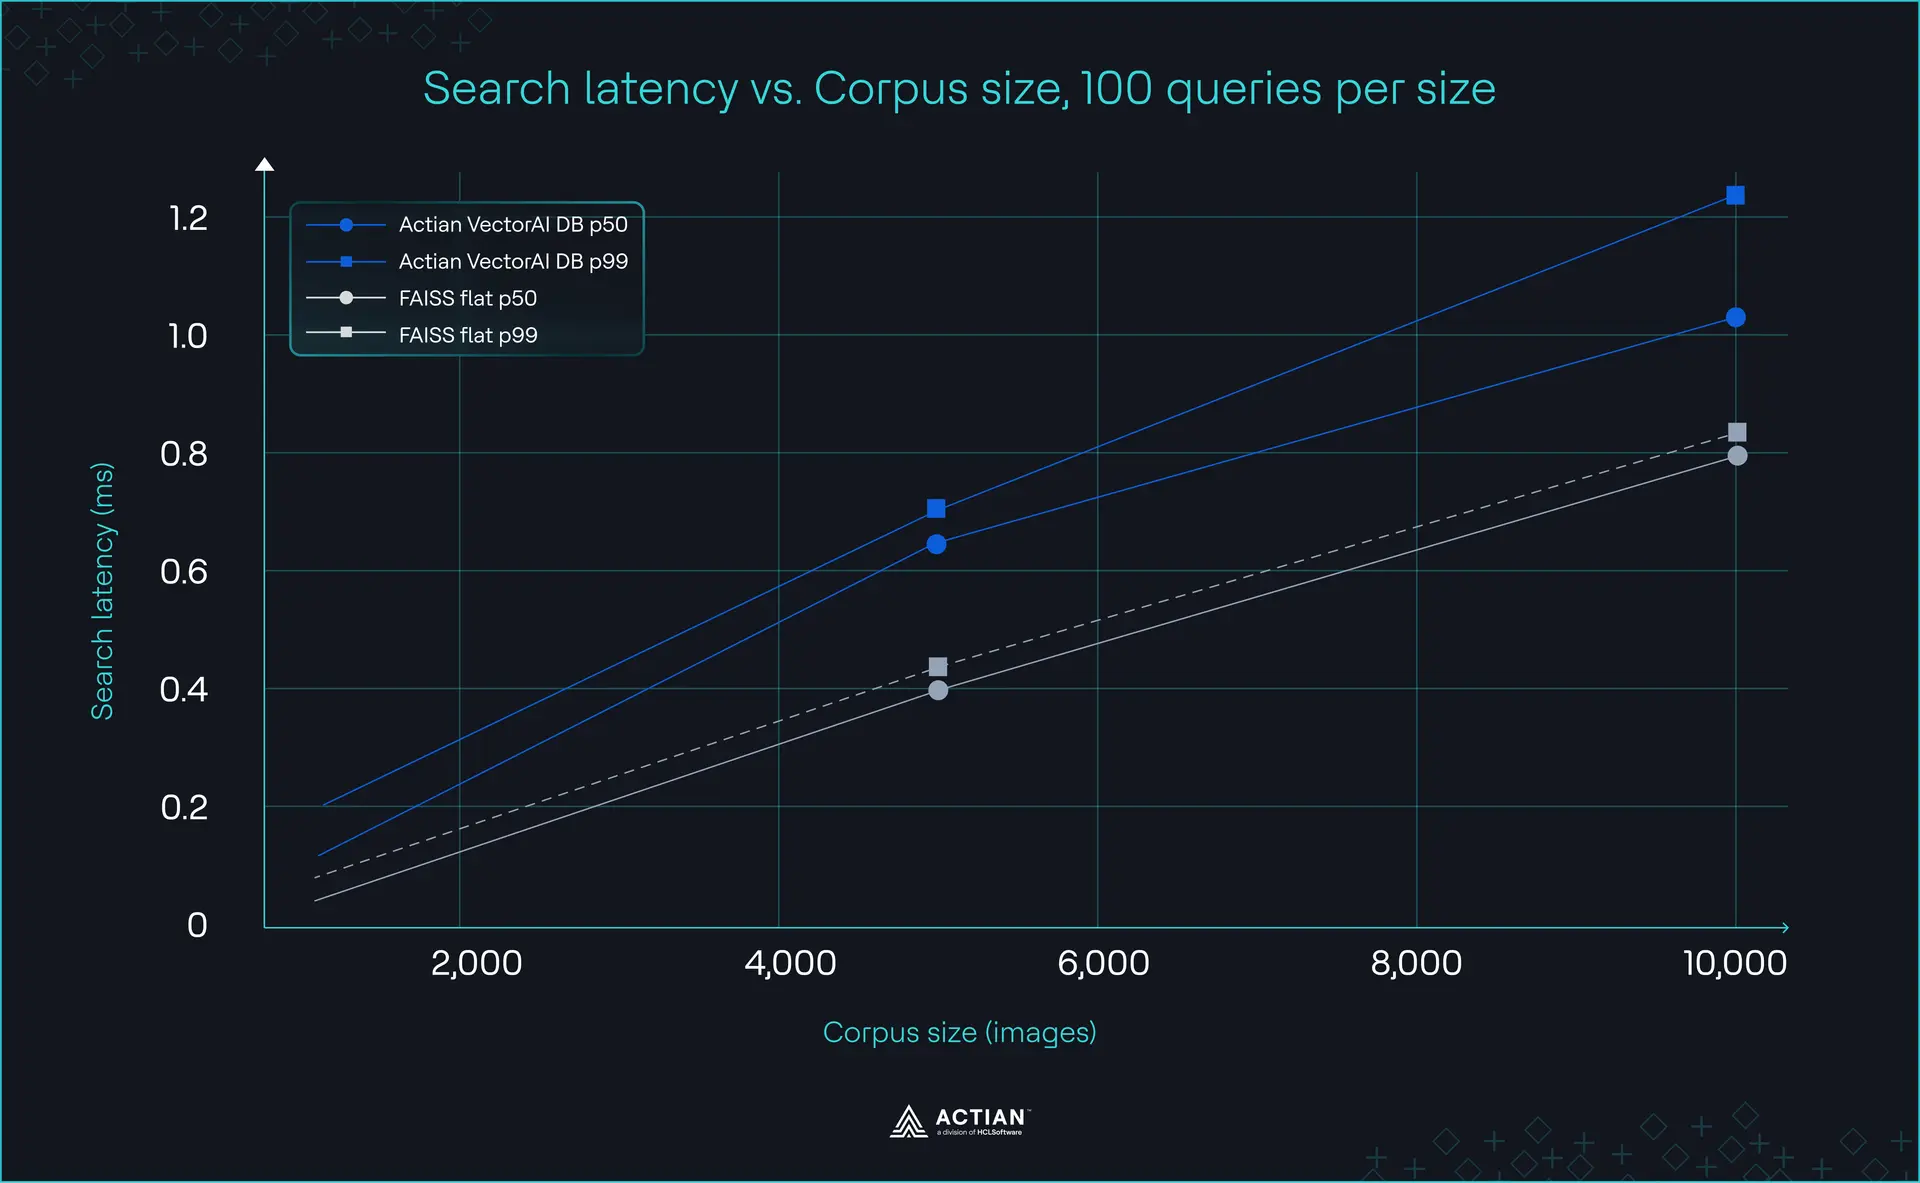
Latenzdiagramm: p50/p99 im Vergleich zur Korpusgröße, erstellt anhand der Benchmark-Ergebnisse
FAISS schneidet bei der reinen Suchzeit in dieser Größenordnung besser ab, und das ist die ehrliche Einschätzung. Ein flacher Index über zehntausend Vektoren entspricht im gleichen Prozess einem Brute-Force-Skalarprodukt, ohne dass ein Graph durchlaufen werden muss und ohne Transport zwischen dem „ abfragen “ und den Vektoren. VectorAI DB liefert die Ergebnisse über gRPC, sodass hinter jeder Zahl in den Spalten feste Kosten pro Aufruf stehen. Der Recall@5 liegt durchgehend bei oder über 0,974, sodass die Abfragequalität nicht das ist, was man einbüßt.
Was Sie für den Verlust von Bruchteilen einer Millisekunde eintauschen, sind „ Metadaten “-Filterung, dauerhafte Schreibvorgänge und einen Dienst, auf den mehrere Rechner gleichzeitig zugreifen können ( abfragen ). Bei einem Korpus dieser Größe ist dieser Kompromiss günstig. Er bleibt auch bei wachsendem Korpus günstig, da der Flat-Index linear mit der Anzahl der Vektoren skaliert, der Graph-Index hingegen nicht.
Der Handel mit gefilterten HNSW-Anleihen ist der Wert, der Sie am ehesten überraschen dürfte.
Dies sind die Kosten, auf die sich die FAISS-Abteilung bezogen hat. Die Auswertung von 20.000 Vektoren mit einem Filter, der ein Prozent des Korpus zulässt, wobei die exakte gefilterte Suche als Referenzwert herangezogen wurde:
| efSearch | Zurückgegebene Ergebnisse (von 10) | Rückruf@10 | ms/abfragen |
|---|---|---|---|
| 16 (Standard) | 9.0 | 0.17 | 0.12 |
| 64 | 10.0 | 0.39 | 0.35 |
| 256 | 10.0 | 0.77 | 1.11 |
| 1024 | 10.0 | 0.99 | 2.62 |
In der Standardeinstellung lässt die gefilterte Suche den Großteil der Ergebnisse, die sie eigentlich anzeigen sollte, außer Acht und kann die Ergebnismenge nicht immer vollständig ausfüllen. Um einen Recall-Wert von über 0,95 zu erreichen, war es erforderlich, efSearch Das 64-Fache des Standardwerts, wodurch sich die „ abfragen “-Zeit von 0,12 ms auf 2,62 ms erhöht hat. Der Filter funktioniert, man zahlt dafür und muss wissen, dass man ihn unter feinabstimmen abrufen kann.
Zwei Anmerkungen zu dieser Tabelle: Sie stammt aus einem Intel-Xeon-Container, auf dem faiss-cpu 1.15.0 läuft, und es werden zufällige Gauß-Vektoren verwendet, die einem Worst-Case-Szenario für die Graphdurchquerung nahekommen. Echte CLIP-Einbettungen Cluster, daher liegt Ihr Recall bei einem gegebenen efSearch wird besser sein. Stellen Sie es auf Ihren eigenen Vektoren nach mit filter_recall_test.py bevor Sie darauf etwas zuschneiden.
Zur Speicherung: Bei 512 Dimensionen in float32 umfasst eine Einbettung 2 KB, sodass der gesamte MVTec-Korpus etwa 11 MB an Vektoren umfasst, gegenüber rund 5 GB an Quellbildern. Die Speicherung der Merkmale stellt keine Einschränkung dar – ein Punkt, den industrielle Implementierungen häufig falsch einschätzen. Planen Sie stattdessen den Kodierungsdurchsatz ein. Bei zwei Bildern pro Sekunde auf CPU ist ein Archiv mit 50.000 Bildern eine Aufgabe für ein Wochenende. Die Kosten fallen nur einmal an, es sei denn, Sie wechseln das Einbettungsmodell, da Vektoren aus zwei verschiedenen Modellen selbst bei identischen Dimensionen nicht vergleichbar sind.
Häufig gestellte Fragen
Was ist CLIP und wie funktioniert es bei der Bildersuche?
CLIP ist ein von OpenAI entwickeltes Modell, das anhand von Bild-Beschriftungs-Paaren trainiert wurde und lernt, ein Bild und seine Beschreibung in einem gemeinsamen Vektorraum nahe beieinander zu platzieren. Für die Suche ist genau dieser gemeinsame Raum der entscheidende Punkt: Man kodiert den Bildkorpus einmal und kodiert dann zum Zeitpunkt der Abfrage entweder eine Textbeschriftung abfragen oder ein Bild abfragen und vergleicht die Ergebnisse anhand der Kosinusähnlichkeit. Die hier verwendete Variante,clip-vit-base-patch32, gibt 512-dimensionale Vektoren aus und läuft auf einem „ CPU “.
Wie kann ich Bilder von Fertigungsfehlern nach visueller Ähnlichkeit suchen?
Kodieren Sie jedes Bild in Ihrem Archiv mit dem Bildkodierer von CLIP und speichern Sie die Vektoren zusammen mit Informationen wie der Teilkategorie und der Fehlerart ( Metadaten ) in einer Datenbank. Wenn ein Bediener einen neuen Fehler erfasst, kodieren Sie dieses Foto auf dieselbe Weise und führen Sie eine „Nearest-Neighbor“-Suche durch. Die Ergebnisse sind frühere Bilder, die ähnlich aussehen und nach Kosinus-Ähnlichkeit geordnet sind, was in der Praxis ähnliche Fehler an ähnlichen Teilen bedeutet.
Kann ich die CLIP-Bildersuche offline nutzen, ohne den Dienst „ Cloud “ zu verwenden?
Ja, und genau diese Konfiguration wird hier beschrieben. Die CLIP-Gewichte werden einmalig heruntergeladen (ca. 605 MB) und anschließend lokal auf einem „ CPU “ oder einer GPU ausgeführt. VectorAI DB läuft als Docker-Container auf Ihrer eigenen Hardware. Nach dem ersten Download verlassen weder Images noch „ abfragen “ noch Einbettungen den Rechner – genau das macht diesen Ansatz in einer Air-Gapped-Anlage praktikabel.
Was ist der Unterschied zwischen FAISS und VectorAI DB bei der Bildersuche?
FAISS ist eine Bibliothek für die Ähnlichkeitssuche, die Vektoren und ganzzahlige IDs innerhalb eines Prozesses speichert. Die Daten werden überwrite_index, und es filtert tatsächlich nach ID über IDSelector, entgegen einer weit verbreiteten Behauptung. Es speichert keine „ Metadaten “ neben Vektoren, filtert nicht nach benannten Feldern und bedient keine mehreren Prozesse. VectorAI DB kann diese drei Dinge, und genau das bedeutet die Unterscheidung „Datenbank, kein Index“ in der Praxis.
Führen Sie es auf Ihrem eigenen Korpus aus:
docker pull actian/vectorai:latestDie Community Edition ist selbst gehostet und bis zu 5.000 Vektoren kostenlos, was fast genau dem MVTec-Korpus entspricht. Die Dokumentation behandelt die Feinabstimmung der Datensammlung und die Filtersyntax, und im Actian-Discord-Kanal tauschen sich Nutzer, die diesen Stack einsetzen, aus.
Bleiben Sie in Verbindung
Datenanalysen direkt bei Ihnen.
(z. B. sales@..., support@...)
