
Que sont les agents d'IA auto-évolutifs ?


Résumé
- Les agents auto-évolutifs s'améliorent au fil du temps en modifiant leurs consignes, leur mémoire, leurs outils ou leurs processus de travail en fonction d'expériences vérifiées.
- Contrairement aux agents statiques, les modifications réussies perdurent et influencent le comportement de l'agent lors des exécutions suivantes.
- Grâce à une mémoire sémantique persistante, les agents peuvent se remémorer des défaillances similaires et réutiliser des solutions qui ont fait leurs preuves, au lieu de repartir de zéro.
- Regenesis, Rewire et Gradient ont fait évoluer différentes parties de leurs piles tout en s'appuyant sur des signaux externes de validité.
- La base de données Actian VectorAI offre un stockage persistant, une recherche sémantique et une réécriture vérifiée, afin de permettre l’auto-amélioration durable et support e des agents.
Les agents auto-évolutifs modifient une partie de leur propre pile — qu’il s’agisse des invites, de la mémoire, des outils ou du graphe d’ workflow s lui-même — en fonction de leur expérience et des retours d’information, plutôt que de rester figés après leur mise en déploiement. L’agent que vous utilisez actuellement en production ne fonctionne très certainement pas de cette manière. Ses invites sont fixes, ses outils sont intégrés de manière permanente, et lorsqu’il rencontre un dysfonctionnement, vous consultez la trace, modifiez la configuration et déployez une nouvelle version.
Cela ne signifie pas pour autant que les agents auto-évolutifs réentraînent leur modèle après chaque tâche. Cela signifie simplement qu’un élément de la pile de l’agent peut évoluer en fonction de ce qui s’est passé lors des interactions précédentes. Si vous développez des agents qui restent déployés, la différence est d’ordre pratique : un agent statique traite chaque tâche comme une nouvelle interaction, tandis qu’un agent auto-évolutif capitalise sur son expérience vérifiée, réduit les corrections manuelles et améliore sa fiabilité au fil du temps. Ce capital d’expérience réside dans la couche de récupération sous-jacente à l’agent, ce qui explique en partie pourquoi les charges de travail des agents obligent à repenser l’architecture des bases de données vectorielles et la manière dont les équipes choisissent une bibliothèque sur laquelle s’appuyer.
Lors du hackathon « Self-Evolving Agents », organisé par tokens& à San Francisco en juillet 2026, trois équipes ont illustré ce modèle de différentes manières. Regenesis a fait évoluer la configuration de ses règles. Rewire a fait évoluer son graphe de conversation. Gradient a fait évoluer ses clusters taxonomiques. Les implémentations étaient différentes, mais elles partageaient une exigence commune : une mémoire persistante et interrogeable permettant à l’agent de tirer parti de son expérience lors de son action suivante.
Cet article présente les changements concrets intervenus au sein de l'architecture, ainsi que l'évolution de ces trois versions lorsqu'elles ont été soumises à un critère de correction réel.
La plupart des agents d'IA n'apprennent pas de leurs expériences
La plupart des agents d'IA déployés aujourd'hui disposent d'instructions fixes, d'outils intégrés et d'un comportement statique. Lorsqu'un agent commet une erreur, un humain examine la trace, modifie l'instruction et redéploie l'agent. L'agent lui-même ne tire aucun enseignement de cet échec.
Observez ce que fait votre agent aujourd’hui lorsqu’il traite une simple requête. Il analyse des données d’entrée, effectue un raisonnement, fait appel à un ou deux outils, génère une réponse, puis termine son exécution. Chacune de ces étapes s’appuie sur une configuration à laquelle l’agent n’a pas accès en écriture. L’invite est une chaîne de caractères constante dans votre dépôt. La liste des outils est un tableau figé. L’index de recherche correspond à ce que vous avez défini au moment de la compilation.
Cette conception est délibérée et, depuis longtemps, justifiée. Les constantes sont prévisibles, et c'est précisément cette prévisibilité qui permet de proposer un agent en toute sécurité aux clients.
Le coût se fait sentir dès le deuxième échec. Comme rien n’a changé dans la pile de l’agent après le premier échec, la même entrée produit le même résultat erroné. Un agent qui invente un prix le lundi le réinvente le mardi. Chaque échec remet le compteur à zéro, et les mêmes erreurs se répètent d’une session à l’autre. La seule voie vers l’amélioration passe par l’intervention d’un humain, une révision du code et un déploiement. Votre organisation apprend. Votre agent, lui, n’apprend pas.
Qu'est-ce qui permet à un agent d'évoluer de manière autonome ?
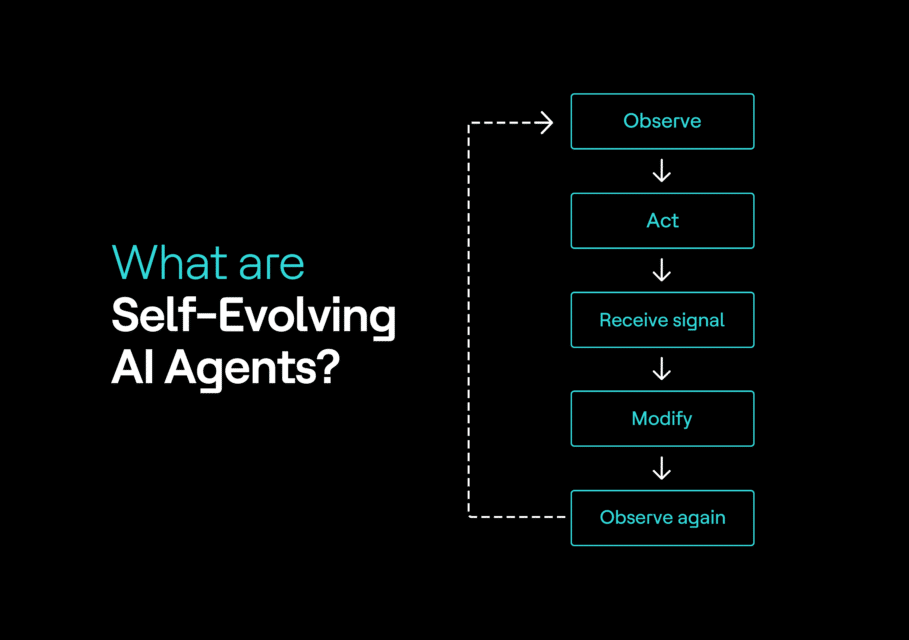
Un agent auto-évolutif fonctionne selon une boucle de rétroaction fermée : observer, agir, recevoir un signal, s'adapter. Cela en fait un système d'apprentissage continu plutôt qu'un système figé. Une partie de sa propre structure évolue en fonction de son expérience plutôt que par une intervention manuelle.
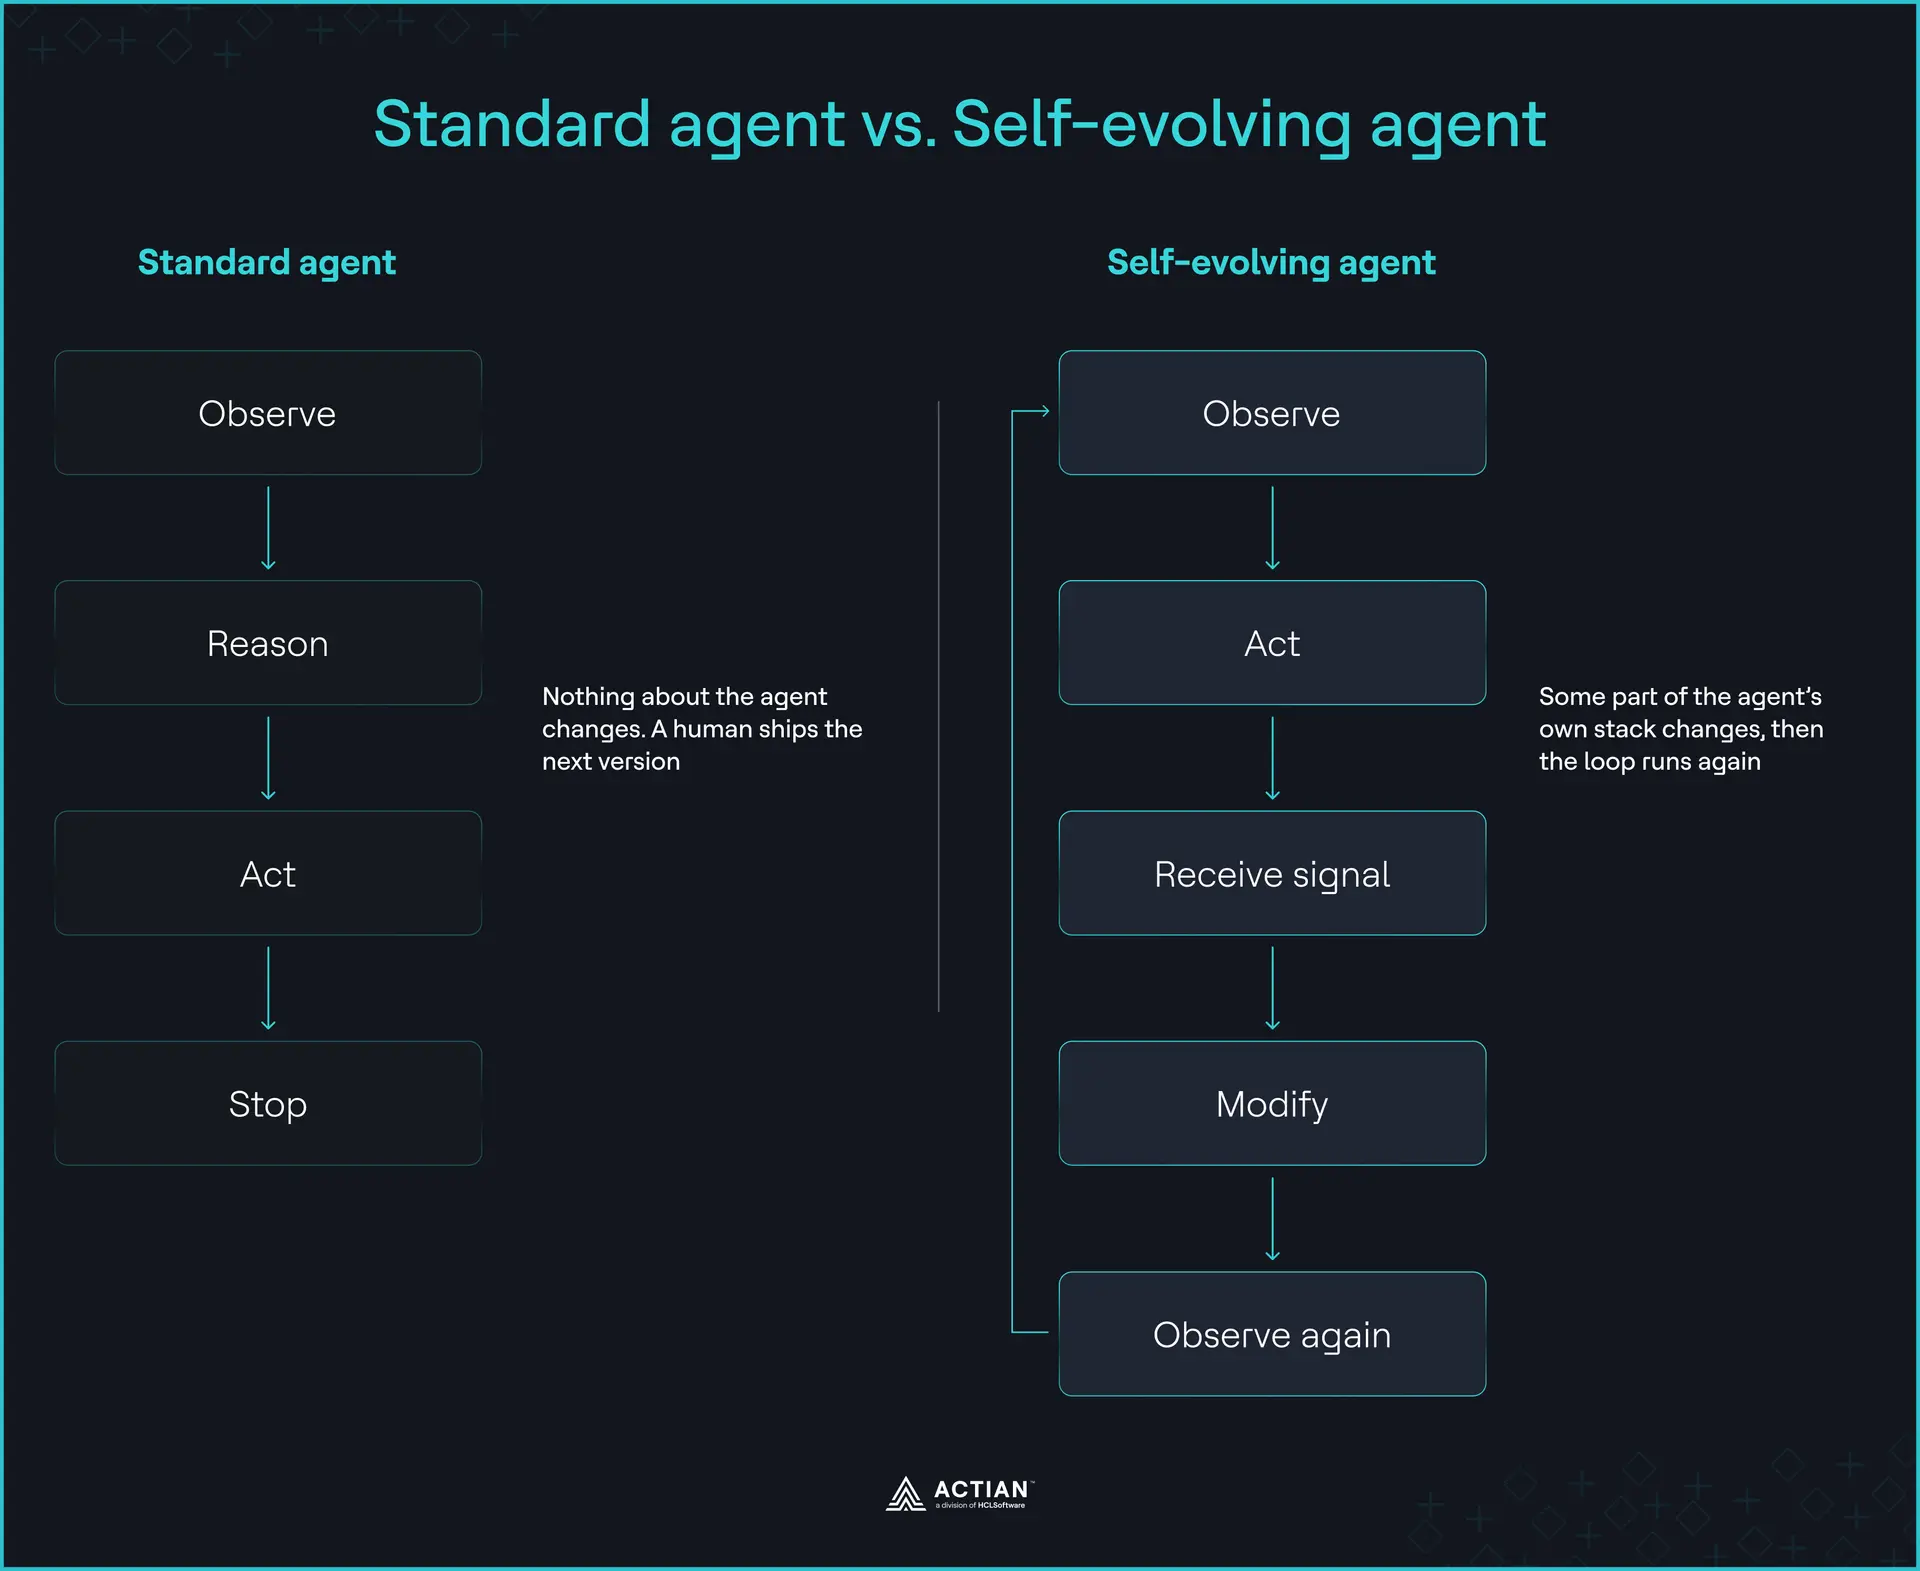
Un agent standard s'arrête après un seul passage. Un agent auto-évolutif boucle la boucle sur lui-même.
Le mot clé ici est « modifier ». Un agent classique modifie sa sortie, ce qui n'est rien d'autre qu'une inférence. Un agent auto-évolutif se modifie lui-même, ce qui signifie que l'artefact à l'origine de la sortie est différent lors de l'exécution suivante de ce qu'il était lors de celle-ci. C'est là toute la distinction, et elle est d'ordre structurel plutôt que philosophique.
D'un point de vue structurel, tout dépend des parties de votre pile qui sont modifiables au sein du cadre de l'agent. Dans un agent standard, les invites, les règles de décision et la mémoire de l'agent sont des constantes que seul un déploiement peut modifier. Dans un agent auto-évolutif, au moins l'une de ces parties est modifiable. Cette partie modifiable nécessite un chemin d'écriture défini, un signal autorisant la modification et un stockage durable pour le résultat.
C'est cette troisième condition que les équipes ont tendance à sous-estimer. Une modification dont l'agent ne se souvient pas lors de l'exécution suivante n'est pas une évolution ; il s'agit d'une nouvelle tentative. La boucle ne se referme que si le changement persiste à un endroit où l'agent effectue une requête avant d'agir à nouveau, ce qui lui permet de s'adapter aux signaux provenant de son environnement.
Le signal est tout aussi important. Un agent qui réécrit ses propres instructions en se basant uniquement sur sa propre confiance risque fort de finir par se tromper avec certitude. Chaque version évoquée ci-dessous est soumise à un oracle de correctitude externe dans le cadre de son évaluation. Cet oracle peut prendre la forme d’une spécification de sécurité validée, d’une base de connaissances vérifiée ou d’un être humain appuyant sur un bouton « accepter » ou « rejeter ».
Qu'est-ce qui peut évoluer, quand et comment ?
Les agents auto-évolutifs peuvent modifier différentes parties de la pile, à différents moments et selon différents mécanismes. Le tableau ci-dessous détaille ce qui change, quand cela change et comment le changement est appliqué. Commencez par déterminer ce qui doit être modifiable. Décidez ensuite à quel moment ce changement doit avoir lieu. Ce n’est qu’après cela que vous devrez choisir le mécanisme permettant de pérenniser le changement.
| Axis | Options | Exemple de compilation |
|---|---|---|
| Qu'est-ce qui évoluer | Paramètres du modèle, invites, mémoire, outils et compétences, graphiques d’ workflow | Regenesis a mis au point une configuration de règles ; Rewire a mis au point un graphe de conversation ; Gradient a mis au point des groupes taxonomiques. |
| Quand faut-il évoluer ? | Intra-tâche e (au sein d'une même série) ou inter-tâche e (entre les séries) | Regenesis effectue ses modifications au cours d'un seul cycle de guérison ; Gradient met à jour les grappes après chaque acceptation ou rejet. |
| Comment évoluer | Élimination basée sur la relecture, rappel de la mémoire avant l'action, réécriture du retour d'information | Rewire a éliminé 27 des 33 candidats en rejouant l'historique ; Regenesis interroge la mémoire avant d'appliquer les correctifs ; Gradient réenregistre les décisions d'acceptation ou de rejet dans ses clusters. |
Que faut-il faire évoluer ? Cinq options, classées approximativement par ordre de difficulté. Les paramètres du modèle sont les plus difficiles à modifier, car leur changement implique un réentraînement ou un réglage fin. Cela les rend lents, coûteux et globaux. Les prompts sont les plus accessibles, ce qui explique pourquoi l’ frameworks d’optimisation des prompts a été la première à voir le jour. Mais la réécriture d’un prompt reste un outil peu précis. La mémoire est la boucle la plus rapide et la plus ciblée, car l’écriture d’un fait vérifié modifie la récupération sans toucher à quoi que ce soit d’autre. Les outils et les compétences s’ajoutent les uns aux autres : l’agent acquiert une capacité qu’il ne possédait pas et peut générer ou intégrer de nouveaux outils au fil du temps. Les graphes de « Workflow » sont structurels ; ils modifient les nœuds et les arêtes plutôt que le texte. C’est pourquoi ils revêtent une importance particulière pour les flux de travail agentiques et opérationnels.
On peut citer par exemple EvoAgentX, qui génère des flux de travail multi-agents à partir d'instructions et les optimise grâce à des algorithmes auto-évolutifs.
Pour la plupart des équipes, la mémoire constitue le bon point de départ. C’est la seule des cinq où il est peu coûteux de corriger une écriture erronée.
Quand évoluer. L'« intra-tâche » signifie que l'agent modifie quelque chose au cours d'une même exécution, avant que celle-ci ne soit terminée. L'« inter-tâche » signifie que la modification est appliquée entre deux exécutions et apparaît lors de la suivante. L'« inter-tâche » est plus sûr et plus courant, car il permet de valider la modification avant que des éléments en aval n'en dépendent. L'« intra-tâche » réagit plus rapidement mais présente un risque d'erreur beaucoup plus élevé, car une modification en cours d'exécution ne dispose d'aucun point de restauration clair.
Comment évoluer. Trois mécanismes couvrent l’essentiel de ce qui fonctionne dans la pratique. L’élimination basée sur la relecture est une stratégie de recherche : elle génère plusieurs modifications candidates et teste chacune d’entre elles par rapport à des cas historiques, ne retenant que la candidate qui corrige la nouvelle défaillance sans en provoquer une ancienne. La consultation de la mémoire avant l’action consiste pour l’agent à « requête r » d’abord son propre historique, de sorte qu’une défaillance connue soit résolue à partir de la mémoire plutôt que d’être redécouverte. La réécriture de rétroaction prend un signal vérifié et le réécrit directement dans la couche de récupération, remodelant ainsi ce que l’agent fera remonter la prochaine fois.
Évolution de chaque version de SwarmHack
Ces trois implémentations ont été testées sur des données réelles à l’aide d’un oracle d’exactitude externe, et non en se basant sur leur propre niveau de confiance. Cela en fait des éléments de preuve utiles, car elles se situent à trois endroits différents dans le cadre présenté ci-dessus et répondent à la même contrainte sous trois angles différents.
| Construire | Comment cela a évolué | Comment VectorAI DB a rendu cela possible |
|---|---|---|
| Regenesis | La configuration des règles, considérée comme un génome modifiable | Historique des défaillances enregistré et fonction de rappel de la configuration activée avant l'application du correctif |
| Recâbler | Le graphe de conversation au sein d'un moteur vocal en temps réel | Répertorié les défaillances par type et reproduit les appels historiques par rapport aux solutions proposées par la concurrence |
| Gradient | Les groupes taxonomiques utilisés pour la recherche | A stocké les signaux d'acceptation/de rejet et s'en est servi pour réorienter les futures recherches |
Regenesis a développé une application de planification des gardes hospitalières fonctionnant selon une boucle fermée d’auto-correction. L’équipe a divisé l’application en deux parties : les règles sont modifiables et un agent peut les réécrire, tandis que les invariants constituent une spécification de sécurité immuable et validée. Un oracle vérifie le fonctionnement de l’application par rapport à cette spécification fixe ; ainsi, les violations qu’il signale sont calculées plutôt que prédéfinies. L’agent interroge ensuite sa propre mémoire avant d’appliquer un correctif, et seules les corrections réussies sont retenues comme solutions. Une classe de défauts déjà rencontrée est résolue directement à partir de la mémoire, sans faire l’objet d’un nouveau diagnostic.
Rewire a résolu un mode de défaillance que la recherche seule ne pouvait pas corriger. Son agent vocal a généré un prix contredit par la base de connaissances, mais la cause n’était pas une recherche défaillante : l’instruction du nœud autorisait de répondre sans faire appel à l’outil de recherche. Pour corriger cela, il faut modifier l’instruction, et non l’index. Le système modifie donc le graphe de conversation, rejoue les réponses candidates par rapport à l’historique des appels, et ne retient qu’une seule réponse qui corrige la nouvelle défaillance sans en provoquer une nouvelle. Comme chaque correction retenue est stockée en fonction de la structure de la défaillance plutôt que de son sujet, une correction apprise sur la tarification des freins a ensuite permis de résoudre un problème de ticket modérateur dans le domaine de la santé, un domaine ne partageant pratiquement aucun terme commun.
Gradient a transformé des données de publications sur les réseaux sociaux déjà classifiées en plans d'intérêt et a développé sa propre taxonomie à partir de signaux réels d'acceptation/de rejet et de retours d'utilisateur . Lorsqu'un « utilisateur » accepte ou rejette un élément, ce signal est répercuté dans le magasin de vecteurs et remodèle les clusters que l'agent récupère lors du passage suivant, avec des catégories créées automatiquement à mesure que la taxonomie évolue. L'ensemble de la pile s'exécute localement, avec des représentations vectorielles via nomic-embed-text-v1.5 et la génération par le biais d’un système quantifié Qwen3 modèle. Aucun réentraînement n'est effectué. Le changement de comportement résulte entièrement de la réorganisation de la couche de récupération autour de signaux vérifiés.
Prises dans leur ensemble, ces analyses révèlent une tendance qui se retrouve dans les domaines de la santé, des assistants vocaux et de la planification des publications sur les réseaux sociaux.
Pourquoi la mémoire est la couche fondamentale
Toutes les approches ayant donné lieu à une véritable évolution partageaient une caractéristique commune : l'agent analysait son propre historique avant d'agir, faisant ainsi de la mémoire le mécanisme permettant une véritable auto-amélioration, plutôt qu'une simple boucle de réessais. C'est ce qui impose des exigences spécifiques à votre couche mémoire.
Trois critères sont indispensables pour le magasin que vous choisirez. La mémoire doit persister d’une session à l’autre, sinon l’agent redémarre à zéro et réapprend ce qu’il savait déjà. Elle doit pouvoir faire l’objet de requêtes par similarité sémantique, car la défaillance suivante n’est jamais identique, octet par octet, à la précédente. Et elle doit être inscriptible sur des signaux vérifiés, afin que la réécriture s’inscrive dans le cadre d’une auto-évolution continue plutôt que d’une mise à jour ponctuelle basée sur ce que l’agent croyait à ce moment-là.
Une base de données classique répond à la première exigence mais ne satisfait pas à la seconde. La recherche par correspondance exacte ne se déclenche que lorsque le nouveau cas est identique à celui stocké, ce qui est rarement le cas pour les défaillances des agents dans des conditions d’apprentissage ouvertes. La recherche sémantique permet la généralisation, et Rewire en est la démonstration la plus claire : un correctif appris sur la tarification des freins a été récupéré pour une défaillance liée à la participation aux frais de santé, car les deux défaillances étaient structurellement similaires, et non textuellement similaires. Aucun index par mots-clés ne permet de trouver cela.
Le réentraînement n'est pas la solution de rechange que la plupart des équipes imaginent. Le réglage fin est un processus lent, coûteux et global, tandis que les approches plus lourdes, telles que l'apprentissage par renforcement ou les mises à jour de paramètres à grande échelle, sont encore plus difficiles à isoler et pénibles à inverser. L'évolution de la mémoire est ciblée, rapide et réversible : on définit un point, on cible un comportement, et on le supprime s'il s'avère erroné.
C’est sur cette infrastructure que les trois itérations ont été exécutées, et c’est pourquoi chacune d’entre elles ne cesse de s’améliorer au fil des itérations. Les trois ont utilisé la base de données Actian VectorAI hébergée en local pour le stockage persistant, la recherche sémantique dans leur propre historique et la réécriture déclenchée par un signal vérifié. Les trois l’ont exécutée localement, ce qui, pour un agent capable de s’auto-modifier, présente un intérêt en soi : l’ enregistrement s sur ce que votre agent a appris et pourquoi restent sur une infrastructure que vous contrôlez.
Commencez par la couche mémoire, réglez correctement la porte d’écriture, puis déterminez quelle partie de la pile l’agent peut modifier. C’est ce qui garantit que l’auto-évolution soit durable et non pas le fruit du hasard. Cet ordre constitue le chemin le plus court pour obtenir un agent qui, lors de sa centième exécution, soit sensiblement différent de ce qu’il était lors de la première.
Pour tester la configuration, essayez VectorAI DB Community Edition via Docker.
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
