
Remplacer la mémoire CrewAI en production par la base de données VectorAI


Résumé
- Ce tutoriel remplace le backend de mémoire par défaut de CrewAI par VectorAI DB afin de rendre la mémoire des agents plus prêt pour la production.
- Il aborde trois problèmes majeurs : le verrouillage concurrent, la perte de mémoire après les redémarrages et les fuites de mémoire entre utilisateurs.
- Un fournisseur VectorAIStorage personnalisé ajoute une mémoire vectorielle persistante tout en laissant inchangés les agents, les tâches et la logique d'équipage existants.
- Les périmètres parutilisateur isolent les mémoires dans les déploiements multi-locataires, de sorte que les agents ne récupèrent que le contexte appartenant à l'utilisateur correspondante.
- Ce modèle améliore la mémoire persistante de l'agent tout en conservant inchangés le stockage à long terme dans SQLite et le comportement d'extraction de la mémoire.
Si vous avez déployé une application CrewAI avec memory=True et tu vois "database is locked" Les erreurs survenant en cas de charge simultanée, les pertes de mémoire après le redémarrage d’un conteneur ou les fuites de mémoire entre les utilisateurs dans une déploiement multi-locataires : ces trois problèmes ont tous la même cause : le backend mémoire par défaut de CrewAI ne résiste pas aux conditions de production.
Ce tutoriel vous explique comment le remplacer par VectorAI DB. Cette modification nécessite un nouveau fichier et deux lignes dans votre instanciation Crew. Vos agents, vos tâches et la logique Crew restent exactement tels quels.
Conditions préalables
Avant de commencer, vous devez vous munir de :
- CrewAI 1.14.6 installé
- Docker est installé et fonctionne
- VectorAI DB Community Edition exécutée localement
- Python .10 ou version ultérieure
- Une clé API OpenAI
Pourquoi le backend de mémoire par défaut ne fonctionne pas en production
Le backend de mémoire par défaut de CrewAI fonctionne bien en phase de développement. En conditions de production, il présente trois types de dysfonctionnements spécifiques.
Verrouillage concurrentiel
Les versions actuelles de CrewAI utilisent LanceDB avec un mécanisme de réessai. Cela atténue le problème, mais ne le résout pas complètement. Le guide de configuration de la mémoire de production mem0 indique que l’exécution en parallèle de plusieurs équipes sur un stockage partagé peut encore générer des erreurs du type « base de données verrouillée ». Un nombre trop élevé d’écritures simultanées peut également épuiser la limite de réessais de LanceDB et entraîner des échecs d’écriture. Les versions antérieures de CrewAI utilisaient ChromaDB comme backend vectoriel par défaut, qui présente ses propres contraintes de monothreading en cas de charge simultanée. Pour mieux comprendre comment ces limites d’ simultanéité s affectent les déploiements d’agents en production, consultez notre comparaison des bases de données vectorielles « Embarqué ».
Stockage temporaire dans des conteneurs
L'emplacement de stockage par défaut est lié à la machine. Sans montage explicite d'un volume, le répertoire LanceDB local disparaît au redémarrage du conteneur, et toute la mémoire enregistrée est perdue. Comme le souligne TechJack Solutions dans son guide de production CrewAI, « le stockage local par défaut est éphémère dans les conteneurs ». Nous l'avons vérifié nous-mêmes, et le script de test est disponible sur GitHub. L'effacement du répertoire de stockage a entraîné la perte définitive de toute la mémoire enregistrée, sans possibilité de récupération.
Pas par-utilisateur isolement
Comme l'équipe mem0 précise qu’« il n’existe pas deutilisateur isolement pour les types de mémoire CrewAI ». Lors de notre test, une variable sans portée recall() Une requête portant sur deux utilisateurs de la même collection a renvoyé les fiches personnelles des deux utilisateurs dans le même ensemble de résultats.
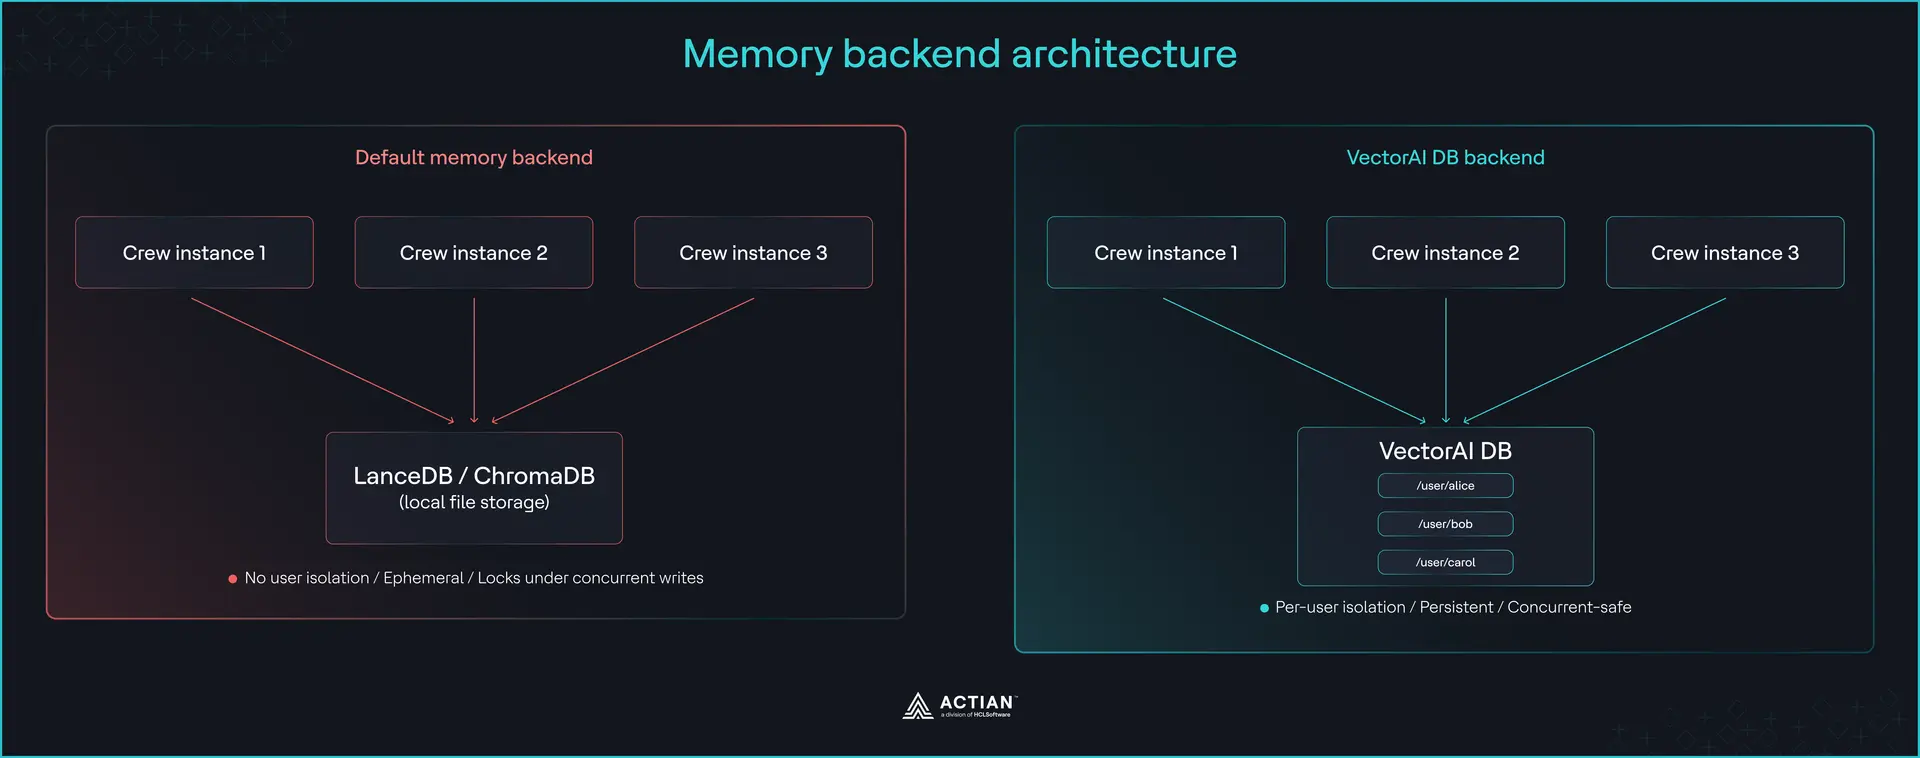
Ces trois problèmes ont tous la même cause : le backend de stockage par défaut. Voici comment le remplacer.
Fonctionnement de la configuration de la mémoire externe de CrewAI
Deux éléments permettent de bien comprendre ce remplacement : la manière dont CrewAI initialise la mémoire et l'endroit où le remplacement a lieu.
Lorsque vous configurez memory=True Sur un Crew, CrewAI initialise automatiquement un Memory instance s'appuyant sur LanceDB. Elle enregistre les enregistrements après l'exécution d'tâche , récupère le contexte pertinent avant chaque tour d'agent et utilise une file d'attente d'écriture en arrière-plan afin que les enregistrements ne bloquent pas l'exécution de l'agent.
La classe `Memory` accepte un paramètre de stockage qui peut être n'importe quel objet implémentant le protocole `StorageBackend`. Ce protocole définit l'interface que CrewAI appelle lors de la lecture et de l'écriture en mémoire. L'extrait ci-dessous implémente save() et search(). Vous trouverez les autres méthodes du protocole dans le dépôt GitHub. Lorsque vous transmettez un objet de stockage personnalisé, CrewAI achemine toutes les opérations en mémoire via celui-ci, au lieu d'utiliser le backend LanceDB par défaut.
Selonutilisateur ,isolement fonctionne via le scope paramètre. Chaque « enregistrement » de mémoire est associée à un chemin de portée, et chaque opération de récupération effectue un filtrage en fonction de celui-ci. Le passage d’un chemin de portée tel que /user/alice, où alice est l'identifiant unique de l'utilisateur; à chaque opération d'écriture et de lecture, cela garantit que les souvenirs d'Alice n'apparaissent jamais dans les résultats de Bob, et inversement.
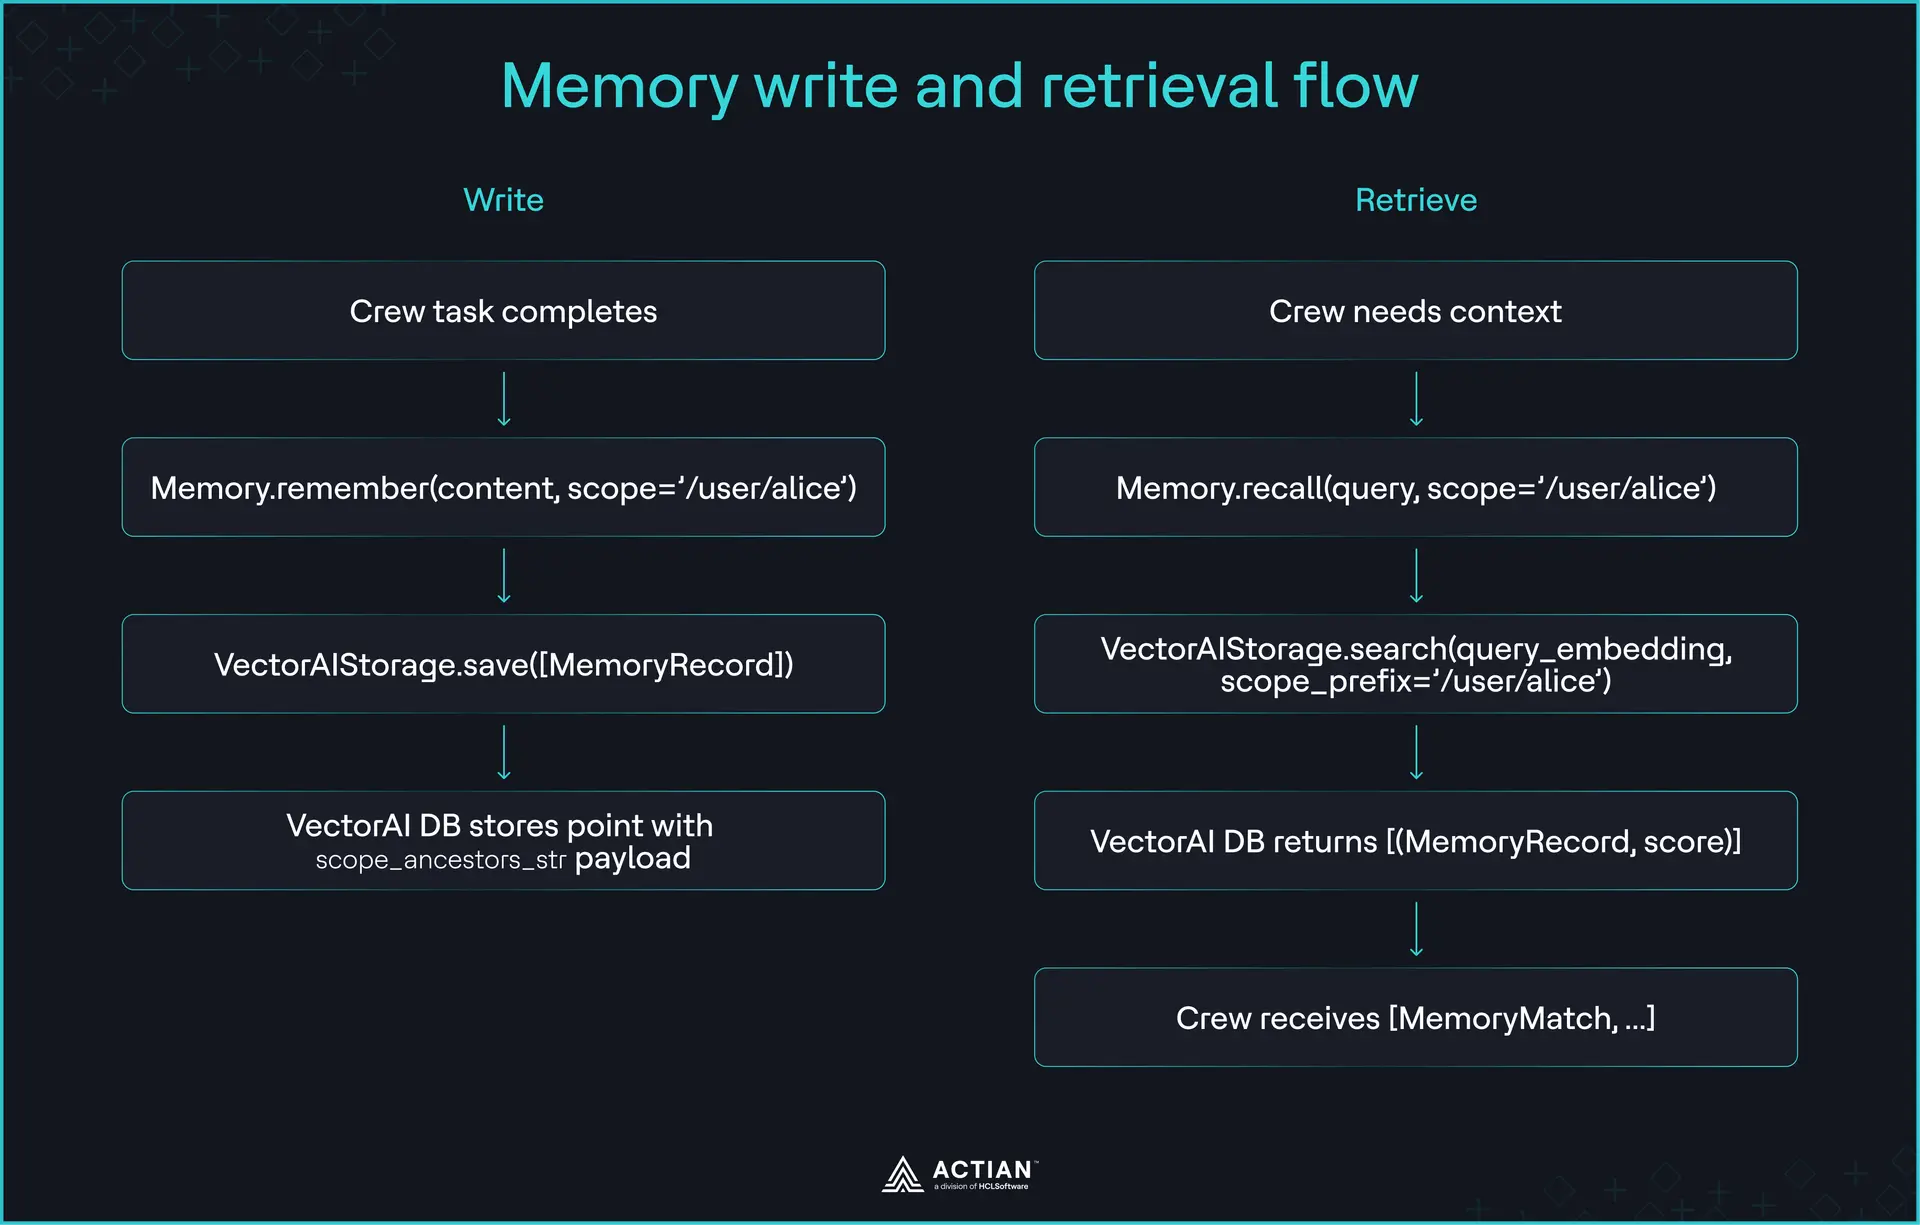
Les étapes ci-dessous ne concernent que le remplacement du backend de mémoire vectorielle.
Étape 1 : Installer les dépendances
Installez les deux paquets ensemble :
pip install "crewai==1.14.6" actian-vectorai-clientDans notre environnement de test, ces deux paquets ont signalé des conflits au niveau des dépendances Protobuf. La chaîne de dépendances de CrewAI fixe protobuf<6.0 via opentelemetry-proto==1.34.1, tandis que actian-vectorai-client nécessite le runtime Gencode 6.33. Le système de gestion des versions de Protobuf implique qu’un 7.x Python Le runtime répond à une exigence de gencode 6.33, car les versions plus récentes sont rétrocompatibles avec les anciennes versions de gencode. Fixez Protobuf à la version que nous avons validée :
pip install "protobuf==7.35.1"Vous verrez un pip check avertissement concernant opentelemetry-proto par la suite. Il s'agit uniquement d'un avertissement lié à une contrainte d'métadonnées . Nous avons vérifié que CrewAI et les exportateurs OpenTelemetry s'importent et s'exécutent correctement sous protobuf 7.35.1.
Étape 2 : Démarrer VectorAI DB
Téléchargez l'image et lancez le conteneur avec un volume monté afin que la mémoire soit conservée d'un redémarrage à l'autre :
docker pull actian/vectorai:latest
docker run -d --name vectorai \
  -v ./local_data:/var/lib/actian-vectorai \
  -p 6573-6575:6573-6575 \
  -e ACTIAN_VECTORAI_ACCEPT_EULA=YES \
  actian/vectorai:latest
Le montage du volume (-v ./local_data:/var/lib/actian-vectorai) permet à la mémoire de persister d’un redémarrage à l’autre du conteneur. Sans cela, VectorAI DB perdrait toutes les données stockées à l’arrêt du conteneur, ce qui réintroduirait le même problème de stockage éphémère que vous cherchez justement à résoudre.
Une fois que le conteneur est lancé, le port gRPC sur 6574 c'est ce que VectorAIStorage à laquelle elle se connecte. L'interface utilisateur locale est disponible à l'adresse http://localhost:6575.
Étape 3 : Créer le fournisseur de mémoire personnalisé
VectorAIStorage met en œuvre la StorageBackend protocole que CrewAI’s Memory comme prévu par la classe. Le fichier ci-dessous présente les méthodes appelées par CrewAI lors de l'enregistrement et de la récupération des enregistrements en mémoire. Créez un fichier nommé vectorai_storage.py dans le répertoire racine de votre projet. Le fichier complet est disponible sur GitHub, et les méthodes présentées ci-dessous couvrent les principaux choix de conception.
Les chemins de portée contiennent des identifiants de type « utilisateur » pouvant provenir d'une entrée de type « utilisateur ». Supprimez les caractères « pipe » de tout identifiant de type « utilisateur » avant de le transmettre à VectorAIStorage pour empêcher le contournement du filtre de portée.
import threading
import uuid
from actian_vectorai import VectorAIClient, VectorParams, Distance, PointStruct, Filter, Field
from actian_vectorai.exceptions import CollectionExistsError
from crewai.memory.types import MemoryRecord, ScopeInfo
# json, datetime, and Any are used in _record_to_payload and _payload_to_record
# in the full file on GitHub

VECTOR_DIM = 1536  # matches OpenAI text-embedding-3-small, CrewAI's default embedder
COLLECTION_NAME = "crewai_memories"
_collection_lock = threading.Lock()

# _record_to_payload and _payload_to_record are defined in the full file on GitHub
# https://github.com/Tiioluwani/crewai-vectorai-memory

def _build_scope_ancestors(scope: str) -> list[str]:
    parts = scope.strip("/").split("/")
    ancestors: list[str] = ["/"]
    current = ""
    for part in parts:
        if part:
            current = f"{current}/{part}"
            ancestors.append(current)
    return ancestors

class VectorAIStorage:
    def __init__(self, host: str = "localhost:6574", collection: str = COLLECTION_NAME) -> None:
        self._host = host
        self._collection = collection
        self._client = VectorAIClient(host)
        self._client.connect()
        self._ensure_collection()

    def close(self) -> None:
        self._client.shutdown()

    def _ensure_collection(self) -> None:
        with _collection_lock:
            try:
                self._client.collections.create(
                    self._collection,
                    vectors_config=VectorParams(size=VECTOR_DIM, distance=Distance.Cosine),
                )
            except CollectionExistsError:
                pass

    def _scope_filter(self, scope_prefix: str | None) -> Filter | None:
        if not scope_prefix or not scope_prefix.strip("/"):
            return None
        prefix = scope_prefix.rstrip("/")
        if not prefix.startswith("/"):
            prefix = "/" + prefix
        return Filter(must=[Field("scope_ancestors_str").text(f"|{prefix}|")])

    def save(self, records: list[MemoryRecord]) -> None:
        if not records:
            return
        points = []
        for record in records:
            vector = record.embedding if record.embedding else [0.0] * VECTOR_DIM
            points.append(
                PointStruct(
                    id=str(uuid.uuid4()),
                    vector=vector,
                    payload=self._record_to_payload(record),
                )
            )
        self._client.points.upsert(self._collection, points)

    def search(
        self,
        query_embedding: list[float],
        scope_prefix: str | None = None,
        categories: list[str] | None = None,
        metadata_filter: dict[str, Any] | None = None,
        limit: int = 10,
        min_score: float = 0.0,
    ) -> list[tuple[MemoryRecord, float]]:
        fetch_limit = max(limit * 20, 200) if (scope_prefix or categories or metadata_filter) else limit
        results = self._client.points.search(
            self._collection,
            vector=query_embedding,
            limit=fetch_limit,
            filter=self._scope_filter(scope_prefix),
        )
        out: list[tuple[MemoryRecord, float]] = []
        for hit in results:
            score = float(hit.score)
            if score < min_score:
                continue
            record = self._payload_to_record(hit.payload)
            if categories and not any(c in record.categories for c in categories):
                continue
            if metadata_filter and not all(
                record.metadata.get(k) == v for k, v in metadata_filter.items()
            ):
                continue
            out.append((record, score))
            if len(out) >= limit:
                break
        return out
Les scope_ancestors_str Le champ stocke chaque chemin d'ancêtre sous la forme d'une chaîne délimitée par des barres verticales, ce qui permet à VectorAI DB d'effectuer un filtrage par portée côté serveur sans avoir recours à un opérateur de préfixe natif. search() le nombre de résultats récupérés est multiplié par 20 lorsqu’un filtre est appliqué, car VectorAI DB effectue le filtrage après avoir classé une fenêtre de candidats interne, et non avant. Une recherche filtrée par plage peut renvoyer moins de résultats qu’il n’en existe lorsque les enregistrements de l’ utilisateurse situent en dehors de cette fenêtre, mais elle ne renvoie jamais d’enregistrements provenant d’une utilisateur erronée. Appelez close() lorsque votre application se ferme pour libérer la connexion gRPC.
Étape 4 : Configurer Crew pour qu’il utilise le fournisseur personnalisé
Avec VectorAIStorage Une fois cela fait, créez un fichier nommé main.py dans le répertoire racine de votre projet et ajoutez ce qui suit :
from crewai import Crew, Agent, Task, Process
from crewai.memory import Memory
from vectorai_storage import VectorAIStorage

# Replace with your actual user identifier
user_id = "alice"

storage = VectorAIStorage(host="localhost:6574")

crew = Crew(
    agents=[
        Agent(
            role="Research Analyst",
            goal="Research and summarize topics accurately",
            backstory="You are an experienced research analyst.",
            llm="gpt-4o-mini",
        )
    ],
    tasks=[
        Task(
            description="Summarize the latest developments in vector databases.",
            expected_output="A concise summary of key developments.",
        )
    ],
    memory=Memory(
        storage=storage,
        root_scope=f"/user/{user_id}",
    ),
    process=Process.sequential,
    verbose=True,
)

result = crew.kickoff()
print(result)
storage.close()
Les root_scope Le paramètre limite chaque opération mémoire à /user/alice. Dans une déploiement multi-locataires, créez un VectorAIStorage instance par requête et transmettre l'identifiant de l'utilisateure actuelle en tant que root_scope. Deux instances de Crew s'exécutant simultanément avec différentes root_scope Les valeurs sont stockées et récupérées dans des espaces de noms totalement distincts.
Étape 5 : Vérifier que les trois modes de défaillance ont été résolus
Avant de changer de backend, voici les résultats obtenus en exécutant le harnais de test sur le stockage LanceDB par défaut de CrewAI :

En utilisant VectorAI DB comme backend, créez un fichier nommé test_failure_modes.py dans le répertoire racine de votre projet. Ajoutez ensuite ce qui suit :
import threading
from vectorai_storage import VectorAIStorage
from crewai.memory.types import MemoryRecord

def make_record(content, scope, n):
    return MemoryRecord(
        content=content,
        scope=scope,
        categories=["test"],
        importance=0.5,
        # Embeddings are synthetic. Isolation in Test 3 depends on the
        # scope filter, not vector similarity.
        embedding=[float(n % 10) / 10.0] * 1536,
    )

# Test 1: Concurrent writes
print("=== Test 1: Concurrent writes ===")
errors = []

def write_memories(user_id, n):
    try:
        storage = VectorAIStorage()
        for i in range(5):
            storage.save([make_record(f"Memory {i} for user {user_id}", f"/user/{user_id}", i)])
        storage.close()
    except Exception as e:
        errors.append(str(e))

threads = [threading.Thread(target=write_memories, args=(f"user{i}", i)) for i in range(5)]
for t in threads:
    t.start()
for t in threads:
    t.join()

if errors:
    print(f"FAIL: {len(errors)} concurrent write error(s): {errors[0]}")
else:
    print("PASS: 5 concurrent writers completed without errors")

# Test 2: Persistence across reconnect
print("\n=== Test 2: Persistence across reconnect ===")
storage1 = VectorAIStorage()
storage1.save([make_record("Persistent memory test", "/user/persist_test", 1)])
storage1.close()

storage2 = VectorAIStorage()
results = storage2.search(query_embedding=[0.1] * 1536, scope_prefix="/user/persist_test", limit=5)
if results:
    print(f"PASS: Memory persisted across reconnect: {results[0][0].content[:50]}")
else:
    print("FAIL: Memory not found after reconnect")
storage2.delete(scope_prefix="/user/persist_test")
storage2.close()

# Test 3 verifies scope-filter isolation at the storage level.
# Application-level enforcement is handled by root_scope on the Memory class in main.py,
# which automatically prepends the user scope to every save and recall operation.
print("\n=== Test 3: Per-user isolation ===")
storage3 = VectorAIStorage()
storage3.save([make_record("Alice preference: prefers dark mode", "/user/alice", 1)])
storage3.save([make_record("Bob preference: speaks Spanish", "/user/bob", 2)])

alice_results = storage3.search(query_embedding=[0.1] * 1536, scope_prefix="/user/alice", limit=5)
bob_results = storage3.search(query_embedding=[0.2] * 1536, scope_prefix="/user/bob", limit=5)

alice_contents = [r.content for r, _ in alice_results]
bob_contents = [r.content for r, _ in bob_results]

alice_leaked = any("Bob" in c for c in alice_contents)
bob_leaked = any("Alice" in c for c in bob_contents)

if not alice_leaked and not bob_leaked:
    print(f"PASS: Per-user isolation confirmed: Alice sees {len(alice_results)} record(s), Bob sees {len(bob_results)} record(s), no cross-contamination")
else:
    print(f"FAIL: Memory leaked — Alice results: {alice_contents}, Bob results: {bob_contents}")

storage3.delete(scope_prefix="/user/alice")
storage3.delete(scope_prefix="/user/bob")
storage3.close()

print("\nAll failure mode tests complete.")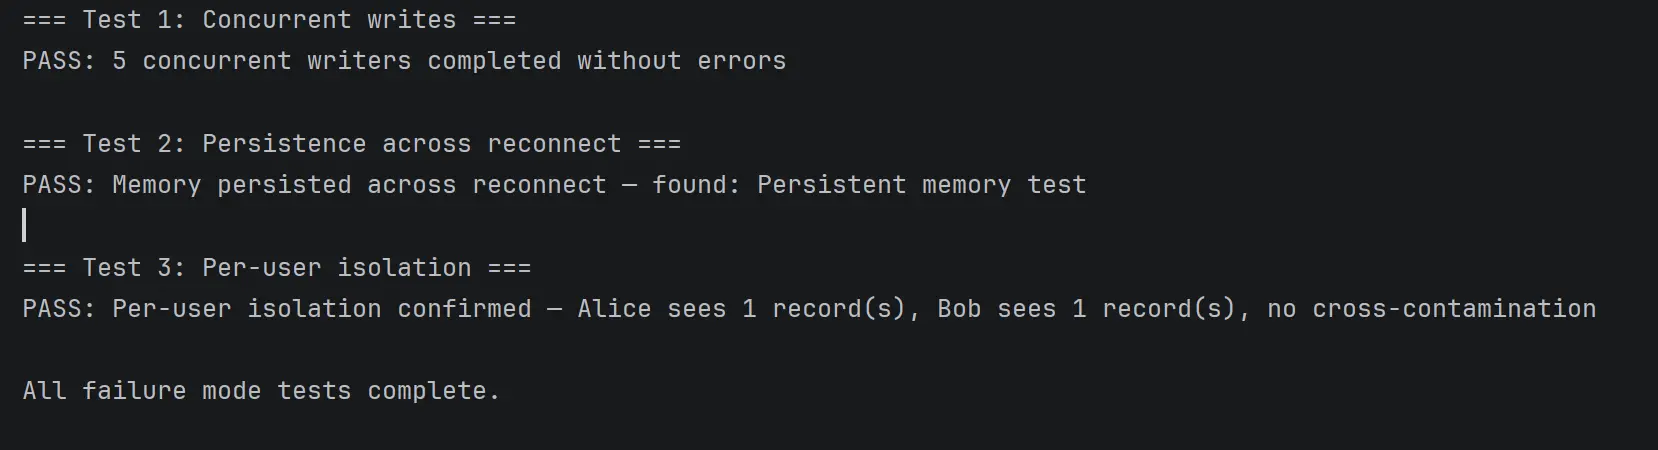
Ces trois tests confirment que VectorAI DB résout les trois modes de défaillance en production. VectorAI DB gère les écritures simultanées sans verrouillage sous la charge de test, assure la persistance de la mémoire lors des reconnexions des clients et limite chaque opération de récupération à l’ utilisateur e qui en est propriétaire.
Ce que ce modèle permet de gérer et comment procéder pour le reste
Trois domaines ne sont pas couverts par cet accord d'échange.
Mémoire à long terme : Cela utilise toujours SQLite via KickoffTaskOutputsSQLiteStorage. Cette couche stocke les résultats d'exécution d'tâche s sur plusieurs exécutions et se situe en dehors de ce que VectorAIStorage modifications. Si votre déploiement a besoin d’une mémoire persistante pour conserver ses données après le redémarrage des conteneurs, montez un volume pour le fichier SQLite ou remplacez cette couche séparément.
Qualité de l’extraction des souvenirs : Celle-ci dépend du pipeline d’analyse LLM intégré à CrewAI, que ce tutoriel laisse inchangé. Le LLM détermine la portée, les catégories et l’importance à chaque sauvegarde. Si vos agents stockent des souvenirs de mauvaise qualité ou non pertinents, il s’agit d’un problème d’extraction, et non d’un problème de stockage.
Latence de récupération et budgets de jetons : Leur taille augmente en fonction de celle de la mémoire. VectorAIStorage ne configure pas les limites de récupération des feuilles. Comme indiqué à l'étape 3, search() effectue une lecture excédentaire d'un facteur 20 lorsqu'un filtre est présent. Réglage limit Une estimation à la hausse sans tenir compte de ce multiplicateur conduit à des résultats incohérents à grande échelle. Les déploiements à grande échelle devraient optimiser le limit paramètre lors des opérations de rappel et surveiller la quantité de contexte récupéré attribuée à chaque tour d'agent.
Pour conclure
Le remplacement du backend de mémoire par défaut de CrewAI par VectorAI DB résout les trois modes de défaillance qui entraînent memory=True peu fiable en production : verrouillage concurrent, stockage éphémère et absence de per-utilisateur isolement . La modification principale se résume à un nouveau fichier et à un argument de configuration sur votre Crew. Vos agents, vos tâches et la logique de votre Crew restent exactement les mêmes.
Vous pouvez ajouter une couche d'extraction de mémoire sémantique avec mem0 par-dessus le backend persistant et isolé que vous venez de créer. L'édition Community est gratuite pour commencer.
Questions fréquemment posées
Ce tutoriel fonctionne-t-il avec CrewAI 1.14.7 ?
Ce tutoriel concerne la version 1.14.6 de CrewAI et n'a pas été testé sur la version 1.14.7. Avant de poursuivre sur la version 1.14.7, vérifiez que le storage paramètre activé Memory existe toujours et que les signatures de méthode dans crewai/memory/storage/backend.py correspondre à quoi VectorAIStorage outils.
Qu'advient-il de la mémoire à long terme (SQLite) ?
Ce tutoriel ne remplace que le backend de mémoire vectorielle. La mémoire à long terme via KickoffTaskOutputsSQLiteStorage reste inchangé. Montez un volume pour le fichier SQLite si vous souhaitez que son contenu soit conservé après les redémarrages du conteneur.
Puis-je utiliser ce modèle avec mem0 au lieu d'une connexion brute à la base de données VectorAI ?
Oui, mais il s'agit d'un parcours d'intégration différent. mem0 s'intègre via le external_memory paramètre, et non pas le StorageBackend swap abordé dans ce tutoriel. Ajout d'une couche d'extraction de mémoire sémantique avec mem0 couvre ce parcours.
Le recours à un prestataire de services de mémoire externe a-t-il une incidence sur les performances de l'équipe ?
Oui. Chaque sauvegarde de mémoire implique désormais un appel gRPC vers la base de données VectorAI, en plus du pipeline d’analyse LLM de CrewAI. La surcharge réseau liée à un appel gRPC est faible sur une instance locale déploiement, mais veillez à mesurer la latence de sauvegarde et de récupération dans votre propre environnement avant le déploiement en production. optimiser le limit paramètre utilisé lors des opérations de récupération si le contexte récupéré devient trop volumineux.
Problèmes courants
Les erreurs « La base de données est verrouillée » persistent après le passage à VectorAI DB
Il semble que The Crew utilise toujours le backend par défaut. Confirmer Memory(storage=VectorAIStorage(...)) est correctement transmis au sein de l'équipage et que VectorAIStorage s'importe sans erreur.
Échec de l'instanciation du fournisseur de mémoire
Il est probable que VectorAI DB soit inaccessible. Vérifiez que le conteneur est bien en cours d'exécution à l'aide de docker ps et que le port 6574 est accessible. Si vous vous trouvez sur un hôte distant, indiquez l'adresse correcte à VectorAIStorage(host="your-host:6574").
Fuites de mémoire entre les utilisateurs après la configuration par-utilisateur isolement
Vérifiez que root_scope est défini par utilisateur lors de l'instanciation de Crew et n'est pas partagé entre les instances. Deux instances de Crew partageant le même root_scope stocker les valeurs et les mémoires dans le même espace de noms.
VectorAIStorage ne respecte pas le protocole StorageBackend
Exécutez cette commande pour vérifier VectorAIStorage est conforme au protocole :
python -c "from crewai.memory.storage.backend import StorageBackend; from vectorai_storage import VectorAIStorage; print(issubclass(VectorAIStorage, StorageBackend))"Si le résultat est False, comparez les signatures des méthodes dans vectorai_storage.py contre crewai/memory/storage/backend.py dans le package que vous avez installé.
Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
