
Ne transférez plus vos archives vers votre système de secours : diffusez les journaux en continu dans Actian NoSQL 11.1


Points clés à retenir
- Actian NoSQL 11.1 introduit la fonctionnalité « logstream », qui permet de répliquer en continu les modifications validées d'une base de données principale vers une base de données de secours via TCP, au lieu de transférer et de restaurer manuellement des fichiers d'archive.
- Le serveur de secours reste connecté en mode lecture seule pendant la réception des mises à jour, ce qui permet aux applications de reporting et autres charges de travail en lecture de l'utiliser en fonctionnement normal.
- Le suivi des séquences persistantes permet de reprendre la réplication après de brèves interruptions réseau sans avoir à restaurer manuellement les fichiers d'archive.
Avant la version 11.1 d'Actian NoSQL, il n'était pas possible d'avoir une base de données de secours en cours d'exécution. La base de données de secours était maintenue en mode SUSPENDED (= impossible à démarrer) et il fallait appliquer manuellement les fichiers d'archive à cette base de données.
De plus, les transactions validées ont été enregistrées dans des fichiers d'archive, et l'administrateur de base de données doit appliquer chaque fichier d'archive à la base de données de secours et ne peut la restaurer qu'à l'aide de vbackup -resume, si la base de données principale était endommagée.
En cas de basculement, une personne devait exécuter, sous pression, une procédure de restauration en plusieurs étapes. Une erreur dans cette procédure entraînait l'échec de la restauration.
Actian NoSQL 11.1 supprime cette étape manuelle. La nouvelle logstream L'utilitaire transfère les objets modifiés par la transaction validée de la base de données principale vers la base de données de secours via une connexion TCP, en les appliquant en continu, tout en maintenant la base de données de secours en mode lecture seule pendant toute la durée de l'opération.
Le tableau ci-dessous présente certaines différences clés entre la procédure « Rollforward » et la nouvelle procédure « logstream » :
Quels sont les changements ?
| ROLL FORWARD : Archives en attente | Actian NoSQL 11.1 Logstream | |
|---|---|---|
| Transports | Fichiers d'archives distincts enregistrés sur disque ou sur bande, puis copiés | Flux TCP en direct et continu |
| Effort de l'opérateur | vbackup -restore à chaque étape de mise à jour | Les commandes « logstream -in » et « logstream -out » s'exécutent en continu |
| État de veille | Suspendu (= impossible à démarrer) jusqu'à la fin de la restauration | En ligne et en mode « lecture seule » |
| Période de perte de données | En fonction de la fréquence à laquelle vous créez et envoyez des archives | Limité par la cadence de l'streaming ; dépend du réseau, de la charge du système et des paramètres TCP du système d'exploitation |
Ces deux succès opérationnels sont les suivants :
- La restauration ne dépend plus d'une restauration manuelle des fichiers d'archive.
- La base de données de secours peut désormais être utilisée pour lire des objets, tout en recevant les modifications de rollforward.
Architecture
Il existe deux processus « logstream » qui maintiennent une connexion ouverte entre eux.
logstream -outfonctionne sur le serveur principal. Il lit les enregistrements du journal de roll-forward au fur et à mesure que la base de données les génère, les regroupe en lots réseau et les envoie au serveur de secours.logstream -infonctionne sur la base de données de secours. Il écoute sur un port de votre choix, reçoit les lots et applique les enregistrements à la base de données de secours au fur et à mesure de leur arrivée.
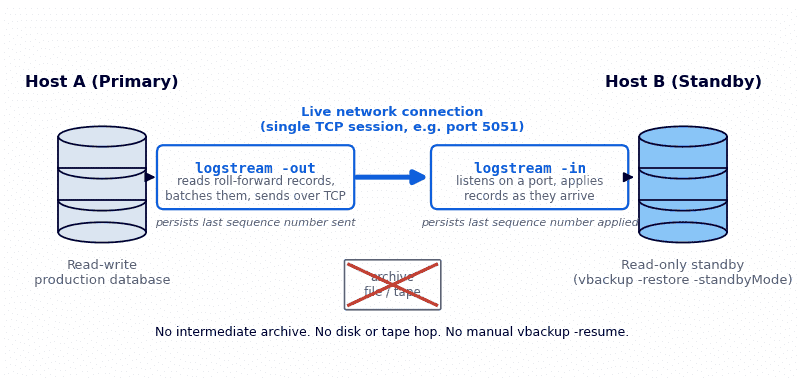
Utilitaire Logstream Workflow
Les objets sont transférés en continu directement de la base de données principale vers la base de données de secours, sans aucune intervention manuelle intermédiaire.
Le port est n'importe quel port inoccupé sur l'hôte de secours. Il n'y a pas de valeur par défaut fixe ; les exemples présentés dans cet article utilisent le port 5051. Assurez-vous que le port choisi est libre avant de pouvoir y lier \logstream -in\ à cela.
L'état est conservé des deux côtés
Ces deux processus logstream sont indépendants du numéro de séquence atteint par l'enregistrement . Le \-out\ côté connaît la dernière enregistrement qu’il a transmise ; le \-in\ côté connaît la dernière enregistrement qu’il a appliquée.
Cette architecture obéit à une seule règle de fonctionnement : démarrer \logstream -in\ sur l'hôte de la base de données de secours avant de démarrer \logstream -out\ sur le serveur principal. L'expéditeur a besoin d'un récepteur sur le serveur de secours auquel se connecter.
Le mode veille effectue des lectures pendant la synchronisation
Créer la base de référence de secours en mode veille :
vbackup -restore -standbyMode\Une base de données restaurée à l'aide de \-standbyMode\ reçoit les blocs d'écriture entrants provenant de \logstream -in\ tout en restant accessible pour la lecture des applications. Les applications clientes peuvent s'y connecter et y exécuter des requêtes. Toute tentative de modification ou d'écriture de données dans un objet stocké dans la base de données de secours échoue avec \SM_DB_IS_READONLY\, car la base de données est en mode veille (= LECTURE SEULE).
Concrètement, cela signifie que vous pouvez orienter les charges de travail liées au reporting, les services nécessitant de nombreuses lectures ou les environnements de test vers le serveur de secours pendant le fonctionnement normal, au lieu de payer pour un deuxième serveur qui reste inactif jusqu'au basculement.
Faire face à une coupure de réseau
Comme les deux extrémités conservent leur position dans la séquence, une connexion interrompue met simplement le flux en pause, sans autre conséquence.
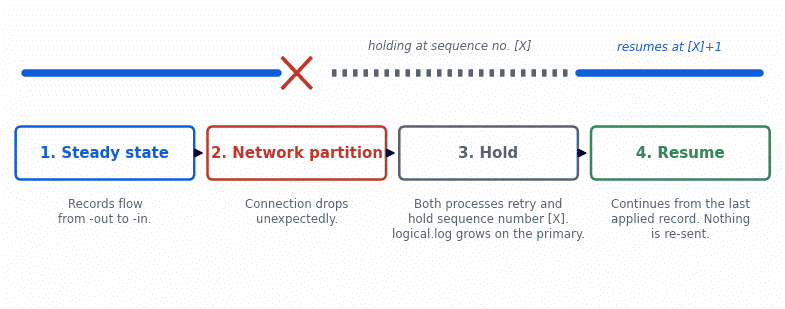
Résilience des services Logstream
Une partition du réseau interrompt le flux et le flux de journalisation actif conserve sa position de séquence actuelle. Si la connexion est rétablie peu de temps après, les deux processus de flux de journalisation seront alors actifs. Pendant ce laps de temps, le journal logique du serveur principal s'allonge, tout en enregistrant toutes les transactions validées.
Lorsque la connexion est rétablie, les processus de flux de journaux reprennent à partir du dernier numéro de séquence appliqué. Aucune intervention de l'opérateur n'est nécessaire pour redémarrer les processus de flux de journaux, même en cas de problème réseau temporaire.
Ce qui relève toujours de la responsabilité de l'administrateur de base de données
Logstream évite d'avoir à effectuer une restauration manuelle, mais l'administrateur de base de données doit tout de même surveiller les processus. L'administrateur de base de données doit :
- Les deux processus doivent être en cours d'exécution. Le flux ne s'écoule que tant que les deux
logstream -outest en tête dans les primaires etlogstream -inest en mode veille. Intégrez les deux processus logstream aux procédures de surveillance définies par l'entreprise. - Surveillez le fichier « logical.log » sur le serveur principal. Tant que la connexion TCP entre les deux processus est interrompue, le maître ne peut pas transférer les objets modifiés par les transactions validées ; par conséquent, son
logical.logla taille du fichier augmente.
La vitesse à laquelle elle augmente dépend du nombre d'applications clientes qui écrivent sur le disque principal ; sur un système très sollicité, elle peut croître très rapidement. Si la partition de disque contenant logical.log se remplit entièrement, la base de données principale s'arrête. Une interruption prolongée du réseau peut donc entraîner une indisponibilité de la base de données principale, et les deux processus LogStream peuvent s'arrêter après un délai d'expiration TCP prolongé s'ils ne font pas l'objet d'une surveillance régulière.
Une bonne pratique consiste à configurer une « alerte » à la fois sur l'état « actif » des deux processus logstream et sur l'espace libre de cette partition.
Réglage du flux
Deux paramètres sur logstream -out contrôler le moment où un lot est envoyé.
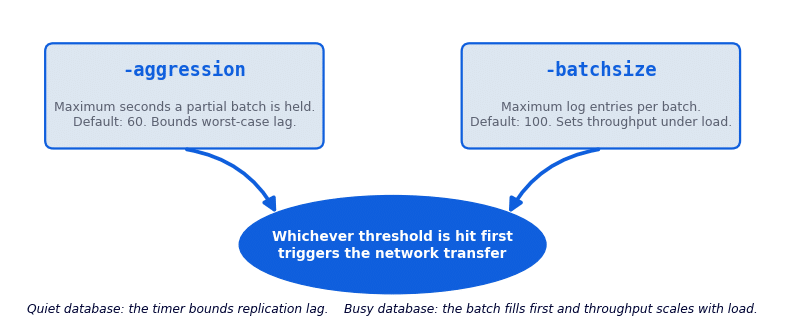
Le premier seuil atteint, qu'il s'agisse du temps écoulé ou du remplissage du lot, déclenche le transfert.
Les -aggression Ce paramètre définit le nombre maximal de secondes pendant lesquelles un lot partiel est conservé avant d'être envoyé (valeur par défaut : 60). -batchsize définit le nombre maximal d'entrées de journal par lot (valeur par défaut : 100). Une base de données peu sollicitée envoie un petit lot à l'expiration du délai ; une base de données très sollicitée remplit d'abord le lot et envoie des lots plus fréquemment.
Les valeurs par défaut conviennent aux environnements de test et constituent un bon point de départ en production. Le comportement réel de la réplication ne dépend pas uniquement de ces deux valeurs : les paramètres TCP du système d’exploitation, la charge système sur les deux hôtes et l’utilisation du réseau jouent tous un rôle ; il n’existe donc pas de paramètre unique à citer. Si vous constatez un problème de performances en production, ouvrez un ticket auprès de l’équipe d’ Support d’Actian avant de modifier l’une de ces valeurs. Support vous demandera un petit ensemble de fichiers afin d’identifier la cause du problème. Si l’analyse met en évidence un problème lié au traitement par lots, l’équipe vous recommandera des valeurs spécifiques et vérifiera avec vous que les performances se sont améliorées.
Vérification de l'état de la synchronisation
vbackup -info indique la position de chaque partie du couple. Concernant le scrutin principal :
> vbackup -info primarydb
Currently transferring logs, next sequential number: #427...
En veille :
> vbackup -info standbydb
Currently injecting logs...
Records applied up to sequential number #10532...
Lorsque les deux processus logstream s'exécutent simultanément, un numéro de séquence s'affiche dans les résultats de surveillance et les journaux de chacun d'entre eux. Il n'est pas nécessaire qu'ils correspondent pour que le système soit considéré comme fonctionnant correctement.
Lorsque les deux processus logstream s'exécutent simultanément, un numéro de séquence s'affiche dans les résultats de surveillance et les journaux de chacun d'entre eux. Il n'est pas nécessaire qu'ils correspondent pour que le système soit considéré comme fonctionnant correctement.
Promotion du mode veille : logstream -finish
La promotion transforme le serveur de secours en une base de données standard normale, accessible en lecture-écriture. Elle est utilisée dans deux cas de figure : un basculement suite à la perte du serveur principal, et une mise hors service planifiée du serveur principal, par exemple lors d'un changement de matériel. Dans les deux cas, les deux logstream Il faut d'abord arrêter ces processus. La promotion ne peut et ne doit pas s'exécuter tant que l'un ou l'autre de ces processus est actif, et la commande de promotion refuse de s'exécuter si elle détecte un processus logstream actif. Vous trouverez ci-dessous les étapes à suivre pour promouvoir le serveur de secours.
- Arrêtez la diffusion. Arrêt
logstream -outsur le serveur principal, si celui-ci est toujours accessible, alors s'arrêterlogstream -inen veille. - Lancer la promotion :
logstream -finish standbydb. Cette opération FAIT PASSER LA BASE DE DONNÉES EN VEILLE du mode « lecture seule » au mode multi-utilisateur, puis arrête la base de données de manière ordonnée. - Démarrer la base de données :
startdb standbydb. Démarrez la base de données en mode multi-utilisateurs. C'est à vous de décider si vous souhaitez l'utiliser comme nouvelle base de données principale ; dans ce cas, vous devrez exécuter «vbackup -rollforward -backup«
La promotion est un processus à sens unique. Une fois la promotion effectuée, la base de données ne reçoit plus les mises à jour provenant de la source d'origine. Si vous avez besoin d'un nouveau serveur de secours, créez-en un à partir du nouveau serveur principal à l'aide de la commande `vbackup -restore -standbyMode`, puis lancez un nouveau flux.
Migrations prévues
Ce même mécanisme permet de gérer les renouvellements de matériel et les déménagements de centres de données sans nécessiter de fenêtre d'indisponibilité pour le transfert des archives.
- Vérifier. Une fois les deux bases de données actives, exécutez la commande suivante :
vbackup -infode chaque côté pour vérifier que les deux processus logstream sont actifs et que le processus de secours a rattrapé tout son retard. - Arrêtez le flux dans l'ordre. Arrêt
logstream -outlors des primaires, puislogstream -inen mode veille, tant que le réseau fonctionne correctement. - Faire la promotion de. Exécuter
logstream -finishetstartdbsur le matériel cible, comme décrit ci-dessus. - Mise hors service. Désactivez l'archivage sur l'ancien serveur principal à l'aide de la commande suivante :
vbackup -off primarydbet le retirer de la circulation.
La bascule ne nécessite que quelques commandes, et le nouveau serveur principal traite déjà le trafic de lecture depuis le moment où vous avez souhaité le tester au préalable.
Licence et disponibilité
Logstream est fourni avec Actian NoSQL 11.1. Il ne nécessite aucun composant sous licence supplémentaire : la licence que vous utilisez pour Actian NoSQL 11.0 est valable pour la version 11.1.
Démarrage
- Activez le « rollforward » sur la base de données principale, ce qui s'effectue via
vbackup -rollforward -backupafin de pouvoir restaurer ultérieurement cette sauvegarde sur la base de données de secours. - Mettez à niveau les deux hôtes vers Actian NoSQL 11.1 et créez la configuration de référence de secours à l'aide de
vbackup -restore -standbyMode. - Choisissez un port libre en attente. Démarrer
logstream -inbon, alorslogstream -outlors des primaires. - Ajoutez les deux processus ainsi que celui du serveur principal
logical.logpartition à votre surveillance. - Regarder
vbackup -infodes deux côtés. Laisser-aggressionet-batchsizeselon leurs paramètres par défaut, sauf recommandation contraire d’ Support .
Les commandes présentées dans cet article ne montrent que les principales options, y compris la nouvelle -standbyMode indicateur. Syntaxe complète pour vbackup, logstream, et startdb, y compris les paramètres relatifs à l'hôte et au port ainsi que les remarques concernant la plate-forme, figure dans la documentation d'Actian NoSQL 11.1.
Vous avez des questions ou des commentaires concernant Logstream ? Contactez l'équipe Actian NoSQL via la communauté Actian ou votre chargé de compte.

Restez connecté
Des informations tirées des données, à votre service.
(par exemple : sales@..., support)
