
Was sind sich selbst weiterentwickelnde KI-Agenten?


Zusammenfassung
- Sich selbst weiterentwickelnde Agenten verbessern sich im Laufe der Zeit, indem sie auf der Grundlage gesicherter Erfahrungen Eingabeaufforderungen, Speicherinhalte, Werkzeuge oder Arbeitsabläufe anpassen.
- Im Gegensatz zu statischen Agenten bleiben erfolgreiche Änderungen bestehen und beeinflussen das Verhalten des Agenten bei zukünftigen Durchläufen.
- Dank des persistenten semantischen Gedächtnisses können Agenten sich an ähnliche Fehler erinnern und bewährte Lösungen wiederverwenden, anstatt jedes Mal von vorne anzufangen.
- Regenesis, Rewire und Gradient haben verschiedene Teile ihrer Stacks weiterentwickelt und dabei auf externe Korrektheitssignale zurückgegriffen.
- Actian VectorAI DB bietet persistenten Speicher, semantische Abfrage und verifiziertes Write-Back, um eine dauerhafte Selbstverbesserung der Agenten zu unterstützen.
Selbstentwickelnde Agenten passen einen Teil ihres eigenen Stacks an – seien es Prompts, Speicher, Tools oder der Workflow-Graph selbst –, und zwar auf der Grundlage von Erfahrungen und Feedback, anstatt nach der Bereitstellung ( Deployment) unverändert zu bleiben. Der Agent, den Sie derzeit in der Produktion einsetzen, funktioniert mit ziemlicher Sicherheit nicht auf diese Weise. Seine Prompts sind fest vorgegeben, seine Tools fest verdrahtet, und wenn er ausfällt, lesen Sie den Trace, bearbeiten die Konfiguration und stellen eine neue Version bereit.
Das bedeutet nicht, dass sich selbst weiterentwickelnde Agenten ihr Modell nach jeder Aufgabe neu trainieren. Es bedeutet vielmehr, dass sich etwas im Stack des Agenten ändern kann, je nachdem, was während früherer Interaktionen geschehen ist. Wenn Sie Agenten entwickeln, die dauerhaft im Einsatz bleiben, hat dies praktische Auswirkungen: Ein statischer Agent behandelt jede Aufgabe als neu, während ein sich selbst weiterentwickelnder Agent verifizierte Erfahrungen weiterverwendet, manuelle Korrekturen reduziert und die Zuverlässigkeit im Laufe der Zeit verbessert. Diese Weitergabe findet in der Abrufschicht unterhalb des Agenten statt, was ein Grund dafür ist, dass die Arbeitslasten von Agenten ein Umdenken hinsichtlich der Architektur von Vektordatenbanken und der Auswahl der zu verwendenden Bibliotheken durch die Teams erzwingen.
Beim „Self-Evolving Agents Hackathon“, der im Juli 2026 von tokens& in San Francisco veranstaltet wurde, demonstrierten drei Teams dieses Muster auf unterschiedliche Weise. Regenesis entwickelte seine Regelkonfiguration weiter. Rewire entwickelte seinen Konversationsgraphen weiter. Gradient entwickelte seine Taxonomie-Cluster weiter. Die Implementierungen waren unterschiedlich, hatten jedoch eine gemeinsame Anforderung: einen persistenten, abfragbaren Speicher, der es dem Agenten ermöglicht, seine Erfahrungen bei seiner nächsten Handlung zu nutzen.
Dieser Artikel zeigt, was sich innerhalb der Architektur tatsächlich ändert und wie sich diese drei Builds entwickelt haben, als sie an ein echtes Korrektheitssignal gebunden waren.
Die meisten KI-Agenten lernen nicht aus Erfahrungen
Die meisten heute eingesetzten KI-Agenten verfügen über feste Eingabeaufforderungen, fest programmierte Werkzeuge und statisches Verhalten. Wenn ein Agent einen Fehler macht, liest ein Mensch den Ablaufverlauf, bearbeitet die Eingabeaufforderung und setzt den Agenten erneut ein. Der Agent selbst lernt aus diesem Fehler nicht.
Schauen Sie sich einmal an, was Ihr Agent heute bei einer einzelnen Anfrage tut: Er nimmt eine Eingabe entgegen, wertet sie aus, ruft ein oder zwei Tools auf, liefert eine Antwort und beendet den Vorgang. Jeder dieser Schritte greift auf Konfigurationsdaten zurück, in die der Agent nicht schreiben kann. Die Eingabeaufforderung ist eine String-Konstante in Ihrem Repository. Die Tool-Liste ist ein festes Array. Der Abrufindex entspricht dem, was Sie bei der Erstellung festgelegt haben.
Dieses Design ist bewusst gewählt und war lange Zeit richtig. Konstanten sind vorhersehbar, und gerade diese Vorhersehbarkeit macht einen Agenten sicher genug, um ihn mit Kunden in Kontakt zu bringen.
Die Kosten zeigen sich beim zweiten Fehler. Da sich nach dem ersten Fehler nichts im eigenen Stack des Agenten geändert hat, führt dieselbe Eingabe wieder zu derselben falschen Ausgabe. Ein Agent, der am Montag einen Preis erfindet, erfindet ihn am Dienstag erneut. Bei jedem Fehler wird der Zähler auf Null zurückgesetzt, und dieselben Fehler wiederholen sich über mehrere Sitzungen hinweg. Der einzige Weg zur Verbesserung führt über einen Menschen, eine Code-Review und ein Deployment. Ihr Unternehmen lernt dazu. Ihr Agent nicht.
Was macht einen Agenten selbstentwickelnd?
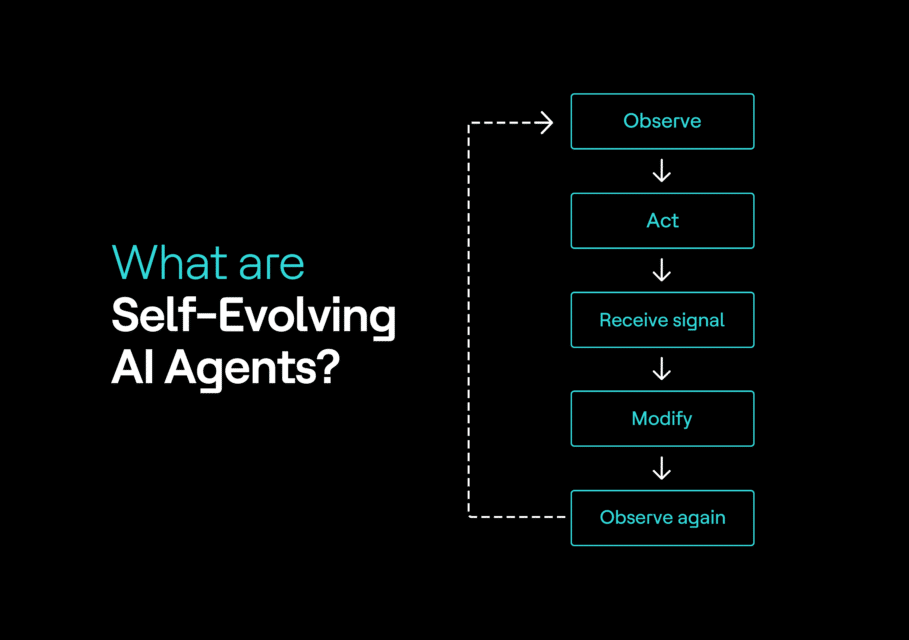
Ein sich selbst weiterentwickelnder Agent durchläuft einen geschlossenen Regelkreis: beobachten, handeln, ein Signal empfangen, anpassen. Dadurch handelt es sich um ein kontinuierlich lernendes System und nicht um ein statisches. Ein Teil seines eigenen Stacks verändert sich auf der Grundlage von Erfahrungen und nicht durch manuelle Eingriffe.
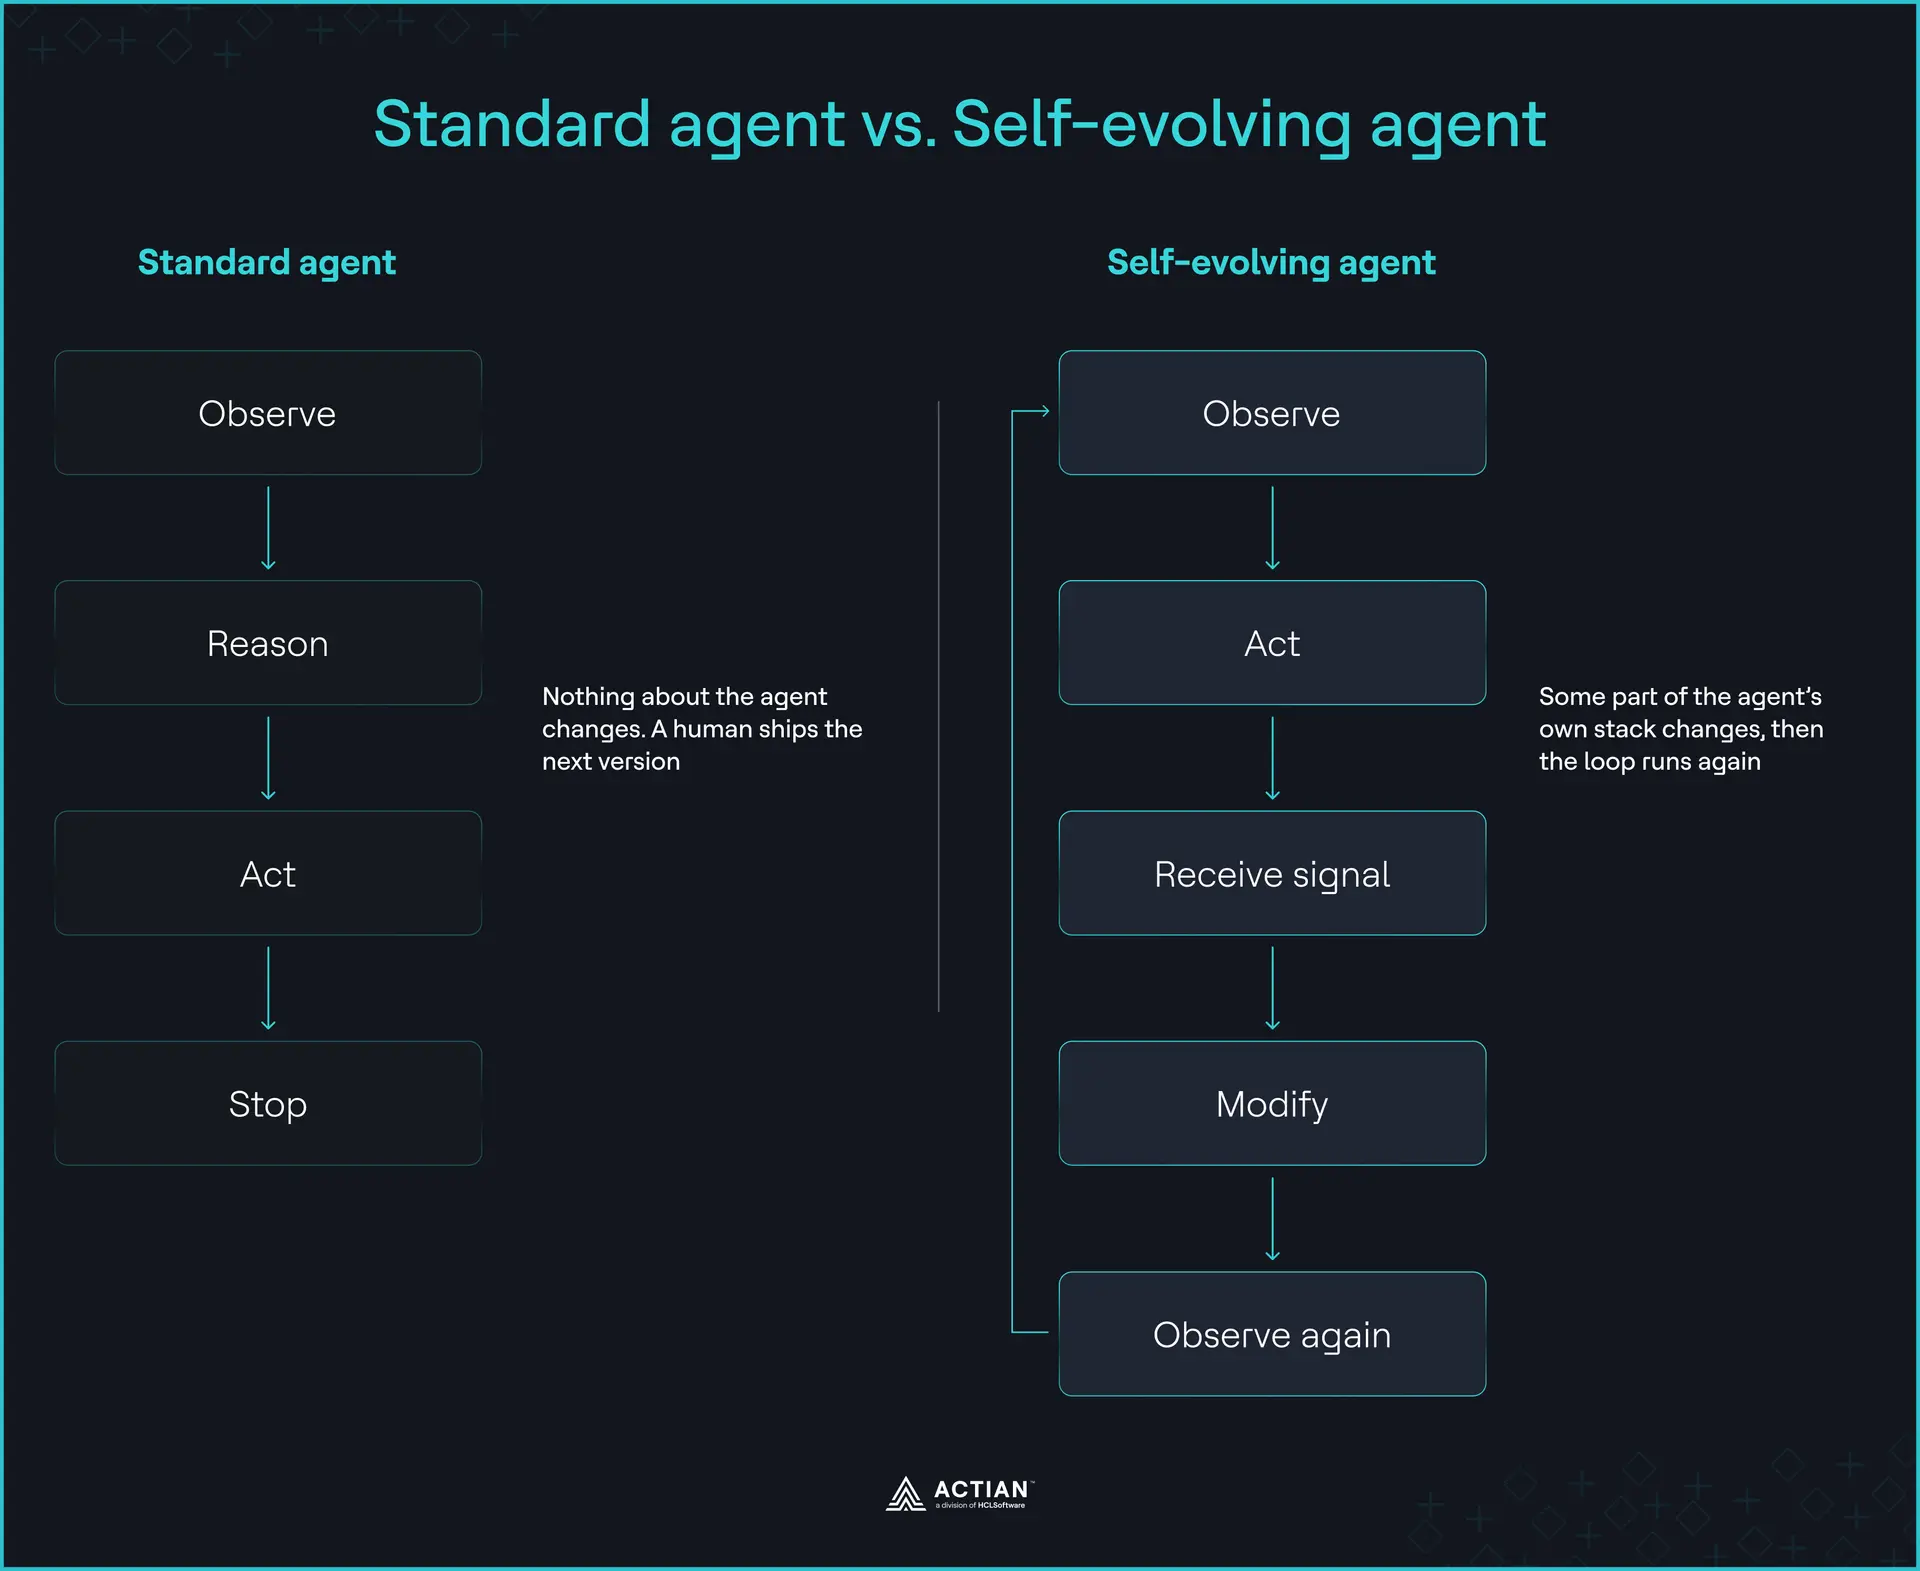
Ein Standardagent beendet seinen Lauf nach einem Durchlauf. Ein sich selbst weiterentwickelnder Agent schließt den Kreislauf in sich selbst.
Das entscheidende Wort hierbei ist „modifizieren“. Ein herkömmlicher Agent modifiziert seine Ausgabe, was lediglich eine Schlussfolgerung darstellt. Ein sich selbst weiterentwickelnder Agent modifiziert sich selbst, was bedeutet, dass das Artefakt, das die Ausgabe erzeugt hat, beim nächsten Durchlauf anders ist als beim aktuellen. Das ist der gesamte Unterschied, und er ist eher struktureller als philosophischer Natur.
Strukturell gesehen kommt es darauf an, welche Teile Ihres Stacks innerhalb des Agenten Framework beschreibbar sind. Bei einem Standardagenten sind Prompts, Entscheidungsregeln und der Agentenspeicher Konstanten, die nur durch eine Bereitstellung geändert werden können. Bei einem sich selbst weiterentwickelnden Agenten ist mindestens einer dieser Teile beschreibbar. Dieser beschreibbare Teil benötigt einen definierten Schreibpfad, ein Signal, das die Änderung autorisiert, und einen dauerhaften Speicher für das Ergebnis.
Diese dritte Anforderung wird von den Teams oft unterschätzt. Eine Änderung, an die sich der Agent beim nächsten Durchlauf nicht mehr erinnern kann, ist keine Evolution, sondern ein erneuter Versuch. Der Kreislauf schließt sich nur, wenn die Änderung an einer Stelle bestehen bleibt, die der Agent abfragt, bevor er erneut handelt, sodass er sich an Signale aus seiner Umgebung anpassen kann.
Das Signal ist ebenso wichtig. Ein Agent, der seine eigenen Anweisungen allein auf der Grundlage seines eigenen Selbstvertrauens umschreibt, wird ohne Weiteres zu der Überzeugung gelangen, dass er im Recht ist – auch wenn er sich irrt. Jede der im Folgenden besprochenen Implementierungen wird im Rahmen ihrer Bewertung durch ein externes Korrektheitsorakel geprüft. Dieses Orakel kann eine freigegebene Sicherheitsspezifikation, eine verifizierte Wissensbasis oder ein Mensch sein, der auf „Akzeptieren“ oder „Ablehnen“ klickt.
Was kann sich entwickeln, wann und wie?
Selbstentwickelnde Agenten können verschiedene Teile des Stacks zu unterschiedlichen Zeitpunkten und über unterschiedliche Mechanismen verändern. Die folgende Tabelle schlüsselt auf, was sich ändert, wann es sich ändert und wie die Änderung umgesetzt wird. Entscheiden Sie zunächst, was beschreibbar sein soll. Legen Sie dann fest, wann diese Änderung erfolgen soll. Erst danach sollten Sie den Mechanismus auswählen, der die Änderung dauerhaft festschreibt.
| Achse | Optionen | Beispiel für eine Erstellung |
|---|---|---|
| Was sich weiterentwickeln | Modellparameter, Eingabeaufforderungen, Speicher, Werkzeuge und Fähigkeiten, Workflow-Diagramme | Regenesis hat eine Regelkonfiguration entwickelt; Rewire hat einen Konversationsgraphen entwickelt; Gradient hat Taxonomie-Cluster entwickelt |
| Wenn man sich weiterentwickeln sollte | Intra-Aufgabe (innerhalb eines einzelnen Durchgangs) oder Inter-Aufgabe (zwischen den Durchgängen) | Regenesis wird innerhalb eines Heilungszyklus angepasst; Gradient aktualisiert die Cluster nach jeder Annahme oder Ablehnung |
| Wie man sich weiterentwickelt | Ausscheidung auf Basis von Wiederholungen, Abruf aus dem Speicher vor der Aktion, Rückmeldung durch Zurückschreiben | Rewire hat 27 von 33 Kandidaten durch das Wiederholen der Historie eliminiert; Regenesis fragt den Speicher ab, bevor es Patches anwendet; Gradient schreibt die Akzeptanz- bzw. Ablehnungsentscheidung zurück in seine Cluster. |
Was lässt sich weiterentwickeln? Fünf Optionen, grob geordnet nach dem Schwierigkeitsgrad ihrer Umsetzung. Modellparameter sind am schwierigsten, da ihre Änderung ein erneutes Training oder eine Feinabstimmung erfordert. Das macht sie langsam, kostspielig und global. Prompts sind am leichtesten zugänglich, weshalb Frameworks zur Prompt-Optimierung als Erste auf den Markt kamen. Aber eine Prompt-Neufassung ist immer noch ein stumpfes Instrument. Der Speicher ist der schnellste Zyklus und der zielgerichteteste, da das Schreiben einer verifizierten Tatsache das Abrufen verändert, ohne irgendetwas anderes zu berühren. Werkzeuge und Fähigkeiten sind additiv: Der Agent erlangt eine Fähigkeit, die er zuvor nicht hatte, und kann im Laufe der Zeit neue Werkzeuge generieren oder integrieren. Workflow-Graphen sind struktureller Natur und verändern Knoten und Kanten statt Text. Deshalb sind sie für agentische und operative Arbeitsabläufe von Bedeutung.
Ein Beispiel hierfür ist EvoAgentX, das anhand von Eingabeaufforderungen Multi-Agenten-Workflows generiert und diese mit selbstentwickelnden Algorithmen optimiert.
Für die meisten Teams ist der Speicher der richtige Ausgangspunkt. Er ist der einzige der fünf Bereiche, in dem sich ein fehlerhafter Schreibvorgang kostengünstig rückgängig machen lässt.
Wann eine Weiterentwicklung stattfinden sollte. Intra-Aufgabe bedeutet, dass der Agent etwas innerhalb eines einzelnen Durchlaufs ändert, bevor dieser abgeschlossen ist. Inter-Aufgabe bedeutet, dass die Änderung zwischen zwei Durchläufen erfolgt und im nächsten Durchlauf sichtbar wird. Inter-Aufgabe ist sicherer und üblicher, da man die Änderung validieren kann, bevor nachgelagerte Prozesse davon abhängig werden. Intra-Aufgabe reagiert schneller, birgt jedoch ein viel höheres Risiko für Fehler, da eine Änderung während des Durchlaufs keinen eindeutigen Rollback-Punkt hat.
Wie man sich weiterentwickelt. Drei Mechanismen decken den Großteil dessen ab, was in der Praxis funktioniert. Die auf Wiederholung basierende Eliminierung ist eine Suchstrategie: Sie generiert mehrere Änderungsvorschläge und testet jeden einzelnen anhand historischer Fälle, wobei nur ein Vorschlag bevorzugt wird, der den neuen Fehler behebt, ohne einen alten zu verursachen. Beim Abrufen von Erinnerungen vor einer Aktion lässt der Agent zunächst seine eigene Historie „ abfragen “, sodass ein bekannter Fehler aus dem Gedächtnis gelöst wird, anstatt neu entdeckt zu werden. Beim „Feedback-Write-Back“ wird ein verifiziertes Signal direkt in die Abrufebene zurückgeschrieben, wodurch die Inhalte, die der Agent beim nächsten Mal anzeigt, neu gestaltet werden.
Wie sich die einzelnen SwarmHack-Builds weiterentwickelt haben
Alle drei Builds wurden mit realen Daten anhand eines externen Korrektheitsorakels ausgeführt, nicht anhand ihrer eigenen Konfidenzwerte. Das macht sie zu aussagekräftigen Belegen, da sie an drei verschiedenen Punkten des oben dargestellten „ Framework “ landeten und dieselbe Einschränkung aus drei verschiedenen Richtungen trafen.
| Erstellen | Wie es sich entwickelt hat | Wie VectorAI DB dies ermöglicht hat |
|---|---|---|
| Regenesis | Die Regelkonfiguration, die als veränderbares Genom betrachtet wird | Gespeicherte Fehlerhistorie und aktivierte Speicherwiederherstellung vor dem Patchen |
| Neu verkabeln | Der Konversationsgraph innerhalb einer Live-Sprach-Laufzeitumgebung | Erfasste Fehler nach Form sortiert und historische Aufrufe im Vergleich zu konkurrierenden Korrekturen nachgestellt |
| Gradient | Die für die Suche verwendeten Taxonomie-Cluster | Die Akzeptanz-/Ablehnungssignale wurden gespeichert und dazu verwendet, zukünftige Abrufe neu zu gestalten |
Regenesis betreibt eine App zur Dienstplanerstellung für Krankenhäuser in einem geschlossenen, selbstheilenden Regelkreis. Das Team hat die App in zwei Teile aufgeteilt: Regeln sind veränderbar und können von einem Agenten neu geschrieben werden, während Invarianten eine unveränderliche, freigegebene Sicherheitsspezifikation darstellen. Ein Orakel überprüft die laufende App anhand dieser festen Spezifikation, sodass die gemeldeten Verstöße berechnet und nicht vordefiniert sind. Der Agent fragt dann vor dem Patchen seinen eigenen Speicher ab, und nur erfolgreiche Korrekturen werden als Lösungen abgerufen. Eine bereits bekannte Fehlerklasse wird direkt aus dem Speicher behoben, anstatt erneut diagnostiziert zu werden.
Rewire behebt einen Fehlermodus, der durch eine reine Abfrage allein nicht behoben werden kann. Der Sprachagent generierte einen Preis, der im Widerspruch zur Wissensdatenbank stand, doch die Ursache lag nicht in einer fehlerhaften Abfrage: Die Anweisung des Knotens erlaubte es, die Frage zu beantworten, ohne das Nachschlagewerk überhaupt aufzurufen. Um dies zu beheben, muss die Anweisung bearbeitet werden, nicht der Index. Daher verändert das System den Konversationsgraphen, spielt Antwortkandidaten anhand historischer Anrufe durch und wählt nur einen aus, der den neuen Fehler behebt, ohne einen alten zu verursachen. Da jeder verbleibende Patch anhand der Struktur des Fehlers und nicht anhand seines Themas gespeichert wird, konnte eine Lösung, die ursprünglich für die Preisgestaltung bei Bremsen gelernt wurde, später auch ein Problem mit Zuzahlungen im Gesundheitswesen lösen – in einem Bereich, der fast kein gemeinsames Vokabular mit dem vorherigen hatte.
Gradient wandelte bereits klassifizierte Social-Media-Daten in Interessensprofile um und entwickelte eine eigene Taxonomie auf der Grundlage von echten Akzeptanz-/Ablehnungssignalen und Rückmeldungen von „ Nutzer “. Wenn ein „ Nutzer “ einen Artikel akzeptiert oder ablehnt, wird dieses Signal an den Vektorspeicher zurückgeschrieben und formt die Cluster neu, die der Agent beim nächsten Durchlauf abruft, wobei Kategorien automatisch neu erstellt werden, sobald sich die Taxonomie verändert. Der gesamte Stack läuft lokal, mit Einbettungen über nomic-embed-text-v1.5 und Erzeugung durch eine quantisierte Qwen3 Modell. Es findet kein erneutes Training statt. Die Verhaltensänderung ergibt sich ausschließlich daraus, dass sich die Abrufschicht anhand verifizierter Signale neu organisiert.
Zusammengenommen deuten diese Analysen auf ein Muster hin, das sich in den Bereichen Gesundheitswesen, Sprachassistenten und der Planung von Social-Media-Beiträgen zeigt.
Warum Speicher die grundlegende Ebene ist
Jeder Entwicklungsansatz, der zu einer echten Weiterentwicklung führte, hatte eine gemeinsame Eigenschaft: Der Akteur griff vor dem Handeln auf seine eigene Historie zurück, wodurch das Gedächtnis zum Mechanismus für echte Selbstverbesserung wurde und nicht eine Wiederholungsschleife. Genau das stellt besondere Anforderungen an Ihre Speicherschicht.
Drei Eigenschaften sind für den von Ihnen gewählten Store unverzichtbar. Der Speicher muss über Sitzungen hinweg bestehen bleiben, sonst startet der Agent mit leerem Speicher neu und lernt erneut, was er bereits wusste. Er muss nach semantischer Ähnlichkeit abfragbar sein, da der nächste Fehler niemals byteweise mit dem letzten identisch ist. Und er muss bei verifizierten Signalen beschreibbar sein, damit das Zurückschreiben Teil einer fortlaufenden Selbstevolution wird und nicht nur eine einmalige Aktualisierung auf der Grundlage dessen, was der Agent zu diesem Zeitpunkt glaubte.
Eine herkömmliche Datenbank erfüllt die erste Anforderung, die zweite jedoch nicht. Eine exakte Suche wird nur ausgelöst, wenn der neue Fall mit dem gespeicherten identisch ist, was bei Fehlerfällen von Agenten unter offenen Lernbedingungen selten der Fall ist. Die semantische Suche ermöglicht Generalisierungen, und „Rewire“ ist das deutlichste Beispiel dafür: Ein Patch, der im Zusammenhang mit der Preisgestaltung von Bremsen gelernt wurde, wurde für einen Fehler bei der Zuzahlung im Gesundheitswesen abgerufen, da die beiden Fehler strukturell ähnlich waren, nicht jedoch textuell. Kein Stichwortindex findet so etwas.
Das Umtrainieren ist nicht die Alternative, für die es die meisten Teams halten. Die Feinabstimmung ist langsam, kostspielig und global, und umfangreichere Ansätze wie „ bestärkendes Lernen “ oder umfassende Parameteraktualisierungen lassen sich noch schwerer isolieren und nur mühsam rückgängig machen. Die Speicherentwicklung ist zielgerichtet, schnell und reversibel: Man schreibt einen Punkt, legt ein Verhalten fest und löscht es, wenn es sich als falsch herausstellt.
Das ist die Basis, auf der die drei Builds liefen, und genau deshalb verbessert sich jeder einzelne von ihnen von Lauf zu Lauf. Alle drei nutzten die selbst gehostete Actian VectorAI-Datenbank für persistenten Speicher, semantische Abfragen im eigenen Verlauf und Write-Back, das auf ein verifiziertes Signal gestützt war. Alle drei führten sie lokal aus, was für einen Agenten, der sich selbst modifiziert, an sich schon von Wert ist: Die „ Aufzeichnung “ – also die Informationen darüber, was Ihr Agent gelernt hat und warum – verbleibt auf einer Infrastruktur, die Sie kontrollieren.
Beginnen Sie mit der Speicherschicht, stellen Sie das Schreibgatter richtig ein und legen Sie fest, welchen Teil des Stacks der Agent bearbeiten darf. Genau das macht die Selbstevolution beständig und verhindert, dass sie zufällig verläuft. Diese Reihenfolge ist der kürzeste Weg zu einem Agenten, der sich bei seinem hundertsten Durchlauf deutlich von dem unterscheidet, was er beim ersten Mal war.
Um die Konfiguration zu testen, probieren Sie die VectorAI DB Community Edition über Docker aus.
Bleiben Sie in Verbindung
Datenanalysen direkt bei Ihnen.
(z. B. sales@..., support@...)
