

Cómo llevamos a cabo la resolución de entidades con una base de datos vectorial y Argon


Principales conclusiones
- VectorAI DB limita cada registro a sus 10 vecinos más cercanos, lo que reduce el número de pares posibles de Abt-Buy de 1 180 452 a 10 810, conservando al mismo tiempo el 99 % de las coincidencias correctas.
- Un umbral de similitud determina los pares inequívocos, y Gemini 4 Argon revisa únicamente el 13,2 % de los casos dudosos, emitiendo una decisión sobre la coincidencia acompañada de una justificación de una sola frase.
- El proceso aumenta el F1 de 0,813 a 0,915 y la precisión a 0,998 en Abt-Buy, a un coste aproximado de 0,76 dólares por cada 1.000 registros.
- El paso de Argon resulta rentable cuando la banda recoge la mayor parte de los errores del umbral y Argon es, como mínimo, unos 10 puntos más preciso en esos pares.
- VectorAI DB y el modelo de incrustación se ejecutan en tu propia infraestructura, por lo que solo la banda de incertidumbre sale de tu red.
En algún lugar de tu tabla de clientes, proveedores o productos, hay un mismo elemento que aparece dos veces. En el caso de referencia de Abt-Buy, un catálogo denomina a un televisor «Sharp AQUOS 37′ Black LCD HDTV – LC37D64U» y el otro lo llama «Sharp AQUOS LC-37D64U 37′ LCD TV». Encontrar pares como estos es lo que se conoce como «resolución de entidades», y la tarea se complica rápidamente. Comprobar cada registro con todos los demás supone unos 500.000 millones de comparaciones para un millón de filas. Las puntuaciones de similitud también fallan en los casos dudosos. El mismo catálogo vende un LC37D44U, que difiere en un solo carácter y es un televisor distinto, y nuestro modelo de incrustación le otorgó una puntuación más alta que al correcto.

Así que nos repartimos el trabajo. VectorAI DB reduce cada registro a sus 10 vecinos más cercanos, lo que redujo Abt-Buy de 1.180.452 pares posibles a 10.810 y conservó el 99 % de las coincidencias reales. Un umbral de similitud resuelve los casos claros. El 13,2 % de los casos inciertos se remite a Gemini 4 Argon, un modelo de Google Gemini que lee ambos registros y devuelve una coincidencia o una no coincidencia con una justificación de una sola frase. Lo elegimos para este experimento porque devuelve JSON que se ajusta a un esquema, permite limitar su capacidad de razonamiento y puede leer el número de pieza que la incrustación difumina.
El umbral por sí solo alcanzó una puntuación F1 de 0,813 (el F1 equilibra la precisión y la recuperación). Con Argon aplicado a los pares inciertos, el F1 aumentó hasta 0,915 y la precisión hasta 0,998, con un coste de 0,76 $ por cada 1.000 registros en la división de prueba. En este artículo, construirás ese proceso paso a paso. Aprenderás a bloquear registros mediante una búsqueda filtrada del vecino más cercano en VectorAI DB y a seleccionar K a partir de la tasa de reducción y la completitud de los pares. También establecerás el rango de umbral a partir de tus propios datos y comprobarás si el uso de Argon resulta rentable antes de invertir dinero en él.
TL;DR
- Filtrado: La base de datos de VectorAI conservó 10.810 de los 1.180.452 pares Abt-Buy posibles, descartando el 99,08 %, y conservó el 99,0 % de las coincidencias reales.
- Solo umbral: F1 0,813.
- Con el argón en la banda de incertidumbre: F1 0,915, precisión 0,998.
- Enviado a Argon: el 13,2 % de los pares de candidatos, 1.001 de 7.570 en la división de prueba.
- Coste: 1,41 dólares según las tarifas de OpenRouter, o 0,76 dólares por cada 1.000 registros en la muestra de prueba (757 registros «Abt» más los 1.092 registros «Buy»).
- Cuándo sale a cuenta: Cuando la banda contiene la mayor parte de los errores del umbral y Argon decide los pares de bandas claramente mejor que el umbral. En nuestras pruebas de ancho de banda, el segmento en el que Argon superaba al umbral en 12 puntos aportó 1,5 puntos F1; los segmentos en los que lo superaba en aproximadamente 1 punto no aportaron prácticamente nada.
Requisitos previos
- Docker con el complemento Compose.
- uv, el gestor de paquetes de Python, que instala una versión compatible de Python por ti. El comando de instalación aparece debajo de esta lista.
- Ollama, para ejecutar el modelo de incrustación de forma local.
- Una clave de Argon para Gemini 4: una clave de OpenRouter con unos pocos dólares de saldo, o una clave de Google AI Studio o Google Cloud con la facturación activada. Argon no ofrece un plan gratuito; la ejecución de Abt-Buy costó 1,41 dólares.
- VectorAI DB, sin necesidad de instalación independiente: el paso 1 ejecuta la Community Edition en Docker. Cada prueba de rendimiento se ajusta al límite de 5.000 vectores, una por una.
- Unos 3 GB de espacio libre en disco para la imagen de la base de datos y el modelo de incrustación. Todo se ejecuta en una CPU; no se necesita ninguna GPU.
Instala uv si aún no lo tienes.
# macOS or Linux
curl -LsSf https://astral.sh/uv/install.sh | sh

# Windows (PowerShell)
irm https://astral.sh/uv/install.ps1 | iex
Todo el código se encuentra en el repositorio asociado, y en el paso 1 se clona. ¿Tienes prisa? Sigue los pasos del 1 al 3 y, a continuación, pasa directamente al paso 8.
Lo que estás construyendo
La resolución de entidades, también denominada «vinculación de registros» o «emparejamiento de entidades», se lleva a cabo en tres pasos. La fase de filtrado reduce el número de pares a los candidatos. La fase de comparación asigna una puntuación a cada candidato, a menudo mediante un emparejamiento aproximado de nombres y campos. La fase de emparejamiento toma la decisión final. Esta versión proporciona a cada paso su propia herramienta:
- VectorAI DB se encarga del bloqueo. Para cada registro, devuelve los vecinos más cercanos de la otra tabla —los registros cuyas representaciones están más próximas— de modo que el proceso evalúa a 10 candidatos por registro en lugar de todos los pares posibles.
- EmbeddingGemma, que se ejecuta localmente a través de Ollama, convierte cada registro en un vector de 768 dimensiones.
- Un umbral de similitud empareja automáticamente los pares con alta confianza y rechaza los casos en los que claramente no hay coincidencia.
- Gemini 4 Argon determina el margen de incertidumbre que hay entre ambos y da una razón en una sola frase.
resolve.pylos relaciona y compara los resultados con las coincidencias conocidas del índice de referencia.
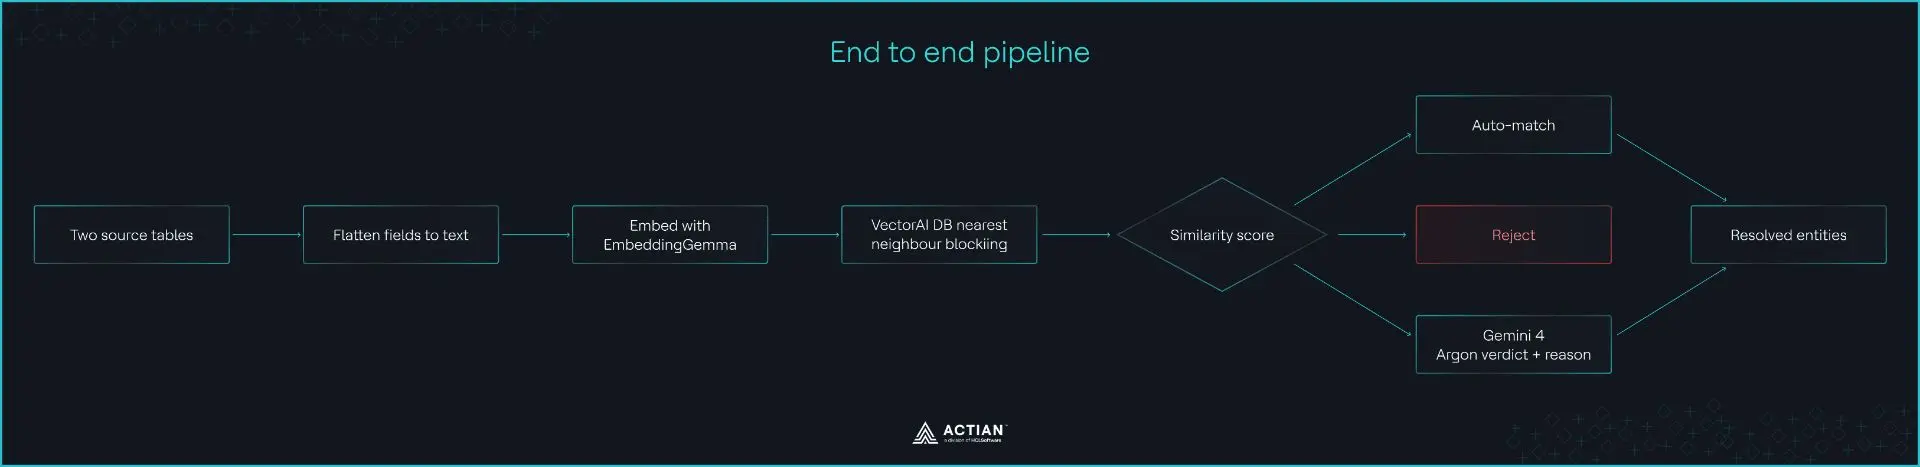
El proceso. Los registros se almacenan y se bloquean en la base de datos de VectorAI, y la puntuación de similitud deriva cada par de candidatos a una coincidencia automática, un rechazo o a Argon.
Los ejemplos utilizan Abt-Buy, un conjunto de datos de referencia estándar para la comparación de datos de la colección de Leipzig: 1.081 productos «Abt» y 1.092 productos «Buy», con un archivo de referencia que recoge las 1.097 coincidencias reales. Comparar cada registro de «Abt» con cada registro de «Buy» supondría 1.081 × 1.092 = 1.180.452 pares.
Paso 1: Iniciar VectorAI DB
Clona el repositorio complementario y accede a la carpeta del proyecto. A partir de ahora, todos los comandos se ejecutarán en esta carpeta:
git clone https://github.com/actian-devs/developer-content.git
cd developer-content/blog/entity-resolution-vectorai
El archivo `docker-compose.yml` del repositorio inicia VectorAI DB. La línea `ACTIAN_VECTORAI_ACCEPT_EULA=YES` acepta en tu nombre la licencia de Actian, así que léela antes de iniciar el contenedor:
services:
  vectorai:
    image: actian/vectorai:1.0.2
    container_name: vectorai
    ports:
      - "6573:6573" # REST
      - "6574:6574" # gRPC (Python SDK)
      - "6575:6575" # Local UI
    volumes:
      - ./vectorai_data:/var/lib/actian-vectorai
    environment:
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    restart: unless-stopped
Empieza:
docker compose up -d
docker ps
El contenedor debería aparecer. El SDK de Python se comunica con él a través de gRPC en port 6574.
El límite de5.000 vectores de la Community Editionabarca todo el servidor, y los vectores eliminados seguían contabilizándose hasta que reiniciamos el contenedor. El entorno de pruebas elimina sus propias colecciones antiguas; si sigue indicando que se ha alcanzado el límite, ejecuta «docker compose restart vectorai».
Paso 2: Obtener el modelo de incrustación
Instala Ollama y, a continuación, descarga EmbeddingGemma, que ocupa unos 620 MB:
ollama pull embeddinggemmaOllama lo sirve en localhost:11434, y el harness lo llama desde allí. En esta fase, no sale nada de tu ordenador.
Paso 3: Instalar las dependencias de Python
El repositorio ya incluye el archivo pyproject.toml, que se muestra a continuación a modo de referencia. Su archivo uv.lock fija las versiones exactas que hemos utilizado, como actian-vectorai-client 1.0.3 y google-genai 2.31.0:
[project]
name = "entity-resolution-vectorai"
version = "0.1.0"
description = "Entity resolution with VectorAI DB blocking and Gemini 4 Argon on the ambiguous band"
requires-python = ">=3.11,<3.14"
# uv run resolve.py reads this, creates .venv and installs these on first run
dependencies = [
    "actian-vectorai-client",  # VectorAI DB client (gRPC)
    "google-genai",            # Gemini API, for the Argon pass
    "pandas",
    "numpy",
    "pydantic",                # Argon's structured-output schema
    "requests",                # benchmark download
    "matplotlib",              # score-distribution chart
]

[project.optional-dependencies]
st = ["sentence-transformers"]   # in-process embedding models: uv sync --extra st, then --embed-backend sentence-transformers
Crea el entorno:
uv syncA partir de ahora, empieza cada comando con «uv run»; no es necesario activar ningún entorno.
Paso 4: Cargar e integrar los registros
La tabla de origen se incluye en la carga útil de cada punto porque el paso 5 filtra en función de ella, por lo que un registro «Abt» solo se compara con registros «Buy». La incrustación es el paso más lento en una CPU; el harness almacena los vectores en caché y las ejecuciones posteriores se saltan este paso. El código que aparece a continuación constituye el núcleo de tres funciones del repositorio. load() en er/data.py crea registros, una lista de tuplas (fuente, id_registro, texto) en la que los registros de Abt aparecen en primer lugar embed() está en er/embed.pyy la operación «upsert» es load_records() en er/block.py.
import numpy as np
import requests
from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams

def to_text(row, fields):
    # "name: Sony Bravia 40in LCD TV | price: $899.99" (empty fields are skipped)
    return " | ".join(f"{f}: {row[f].strip()}" for f in fields if row[f].strip())

def embed(texts, model="embeddinggemma", url="http://localhost:11434", batch=64):
    out = []
    for i in range(0, len(texts), batch):
        r = requests.post(f"{url}/api/embed", json={"model": model, "input": texts[i:i + batch]}, timeout=600)
        r.raise_for_status()
        out.extend(r.json()["embeddings"])
    v = np.asarray(out, dtype=np.float32)
    return v / np.linalg.norm(v, axis=1, keepdims=True)   # unit length, so cosine score = dot product

vectors = embed([text for , , text in records])          # records: (source, record_id, text)

with VectorAIClient("localhost:6574") as db:
    if db.collections.exists("er_abt_buy"):   # start clean, so the step can be rerun
        db.collections.delete("er_abt_buy")
    db.collections.create("er_abt_buy", vectors_config=VectorParams(
        size=vectors.shape[1], distance=Distance.Cosine))
    points = [PointStruct(id=i, vector=v.tolist(), payload={"source": src, "record_id": rid, "text": t})
              for i, ((src, rid, t), v) in enumerate(zip(records, vectors))]
    for start in range(0, len(points), 500):   # upsert in batches
        db.points.upsert("er_abt_buy", points[start:start + 500])
Paso 5: Bloque con VectorAI DB
La consulta de bloqueo se ejecuta una vez por cada registro Abt y solicita sus K registros Buy más cercanos, con un filtro obligatorio sobre el campo «source» en la carga útil de cada punto. En este caso, la regla es que una coincidencia siempre vincula un registro Abt con un registro Buy, por lo que la búsqueda solo debería devolver registros de la otra fuente. El bloqueo en incrustaciones preentrenadas como esta se ha estudiado a gran escala: Zeakis y otros. Se evaluaron 12 modelos de lenguaje en 17 pruebas de referencia de resolución de entidades, incluyendo el rendimiento de sus representaciones en bloques. El código continúa a partir del paso 4 y constituye el núcleo de neighbours() en er/block.py.
from actian_vectorai import Field, FilterBuilder, VectorAIClient

K = 10
TOTAL_RECORDS = len(records)   # Abt + Buy: a limit this high returns every Buy record
abt_ids = [rid for src, rid,  in records if src == "abt"]
abtvectors = vectors[:len(abt_ids)]   # records lists every Abt record first
other_source = FilterBuilder().must(Field("source").eq("buy")).build()

def search(db, vectors, limit):
    out = []
    for i in range(0, len(vectors), 100):   # search_batch takes up to 100 queries per call
        out += db.points.search_batch("er_abt_buy", [
            {"vector": v.tolist(), "limit": limit, "filter": other_source, "with_payload": True}
            for v in vectors[i:i + 100]])
    return out

ranked, todo, limit = {}, list(range(len(abt_ids))), K  10   # over-fetch, then keep the top K
with VectorAIClient("localhost:6574") as db:
    while todo:
        short = []
        for i, hits in zip(todo, search(db, abt_vectors[todo], limit)):
            ranked[abt_ids[i]] = sorted(((h.payload["record_id"], h.score) for h in hits),
                                        key=lambda x: -x[1])[:K]
            if len(hits) < K and limit < TOTAL_RECORDS:   # stop once the limit covers the table
                short.append(i)
        todo, limit = short, min(limit  4, TOTAL_RECORDS)   # retry any record still short
Recuperación excesiva al filtrar. Hemos medido esto en VectorAI DB 1.0.2 con el cliente de Python 1.0.3 y los 2.173 registros «Abt-Buy» en una única colección. Una llamada a search_batch con limit=10 y el filtro source = buy devolvió resultados insuficientes para 1.075 de los 1.081 registros «Abt», con una media de 3,9 resultados. Una búsqueda sin filtrar de los 10 registros más cercanos devolvió registros «Abt» en el 75,5 % de los casos. Por lo tanto, los resultados filtrados parecían corresponder a los registros «Buy» entre, aproximadamente, el límite de registros más cercanos en general, y no a los 10 registros «Buy» más cercanos. La guía de filtros de predicados de VectorAI DB indica que los filtros se aplican durante la búsqueda, por lo que hay que considerar esto como lo que hizo la versión 1.0.2 en nuestra colección, y no como un comportamiento documentado.
Criar hnsw_ef, cambiar la amplitud de búsqueda del índice HNSW a 256 no supuso ningún cambio. No era posible crear un índice de carga útil en la fuente: la versión 1.0.2 rechaza añadir uno a una colección existente («la creación dinámica de índices aún no se ha implementado»), y el cliente de Python 1.0.3 no dispone de ningún ajuste para declarar uno al crear la colección. Solicitar 10 × K y mantener fijo el K superior solucionó el problema: cada registro obtuvo sus 10 candidatos, y el 99,95 % de ellos coinciden con una búsqueda exacta por fuerza bruta.
En los datos de clientes o proveedores, la cláusula «same» puede incluir reglas que descarten por completo una combinación, como un país diferente o una persona frente a una empresa. Las cláusulas «should» pueden favorecer a los candidatos que compartan un campo, como un código postal, sin excluir al resto. Presupuesto para la misma recuperación excesiva: en la versión 1.0.2, cuantos más registros excluye un filtro, menos registros cercanos lo superan, por lo que hay que aumentar el límite hasta que cada registro obtenga su K.
Lee la relación de reducción y la completitud de los pares conjuntamente
Hay dos cifras que describen el bloqueo, y cualquiera de ellas por sí sola puede llevar a conclusiones erróneas:
- Relación de reducción es la proporción de todos los pares que se han eliminado mediante el bloqueo: 1 − candidatos / todos los pares.
- Completitud de pares es la proporción de coincidencias verdaderas que han superado el filtrado: coincidencias verdaderas entre los candidatos / todas las coincidencias verdaderas.
import pandas as pd

candidates = {(abt_id, buy_id): score for abt_id, hits in ranked.items() for buy_id, score in hits}
n_buy = len(records) - len(abt_ids)
gold = set(map(tuple, pd.read_csv("data/abt-buy/abt_buy_perfectMapping.csv").astype(str).values))
rr = 1 - len(candidates) / (len(abt_ids) * n_buy)
pc = len(gold & candidates.keys()) / len(gold)
El arnés realiza cálculos tanto en blocking_quality() en er/block.py. Cada coincidencia verdadera que se pierde por un bloqueo se pierde para siempre, por lo que la completitud de pares limita la recuperación en toda la cadena de procesamiento. Hemos barrido K:
| K | Parejas de candidatos | Relación de reducción | Exhaustividad de los pares |
|---|---|---|---|
| 1 | 1,081 | 99.91% | 81.9% |
| 3 | 3,243 | 99.73% | 94.5% |
| 5 | 5,405 | 99.54% | 97.0% |
| 10 | 10,810 | 99.08% | 99.0% |
| 20 | 21,620 | 98.17% | 99.7% |
Mantuvimos K = 10. Esto eliminó el 99,08 % del espacio de comparación y conservó el 99,0 % de las coincidencias reales. Al pasar a K = 20, se añaden 0,7 puntos de completitud de pares para el doble de candidatos. Considera estas dos cifras como una disyuntiva antes de fiarte de ninguna de ellas: cada caída en el bloqueo de pares supone una comparación ahorrada y, posiblemente, una coincidencia perdida para siempre. Elige el valor K más pequeño cuya completitud de pares te resulte aceptable, ya que ese número es el límite máximo de recuperación para cada paso posterior.
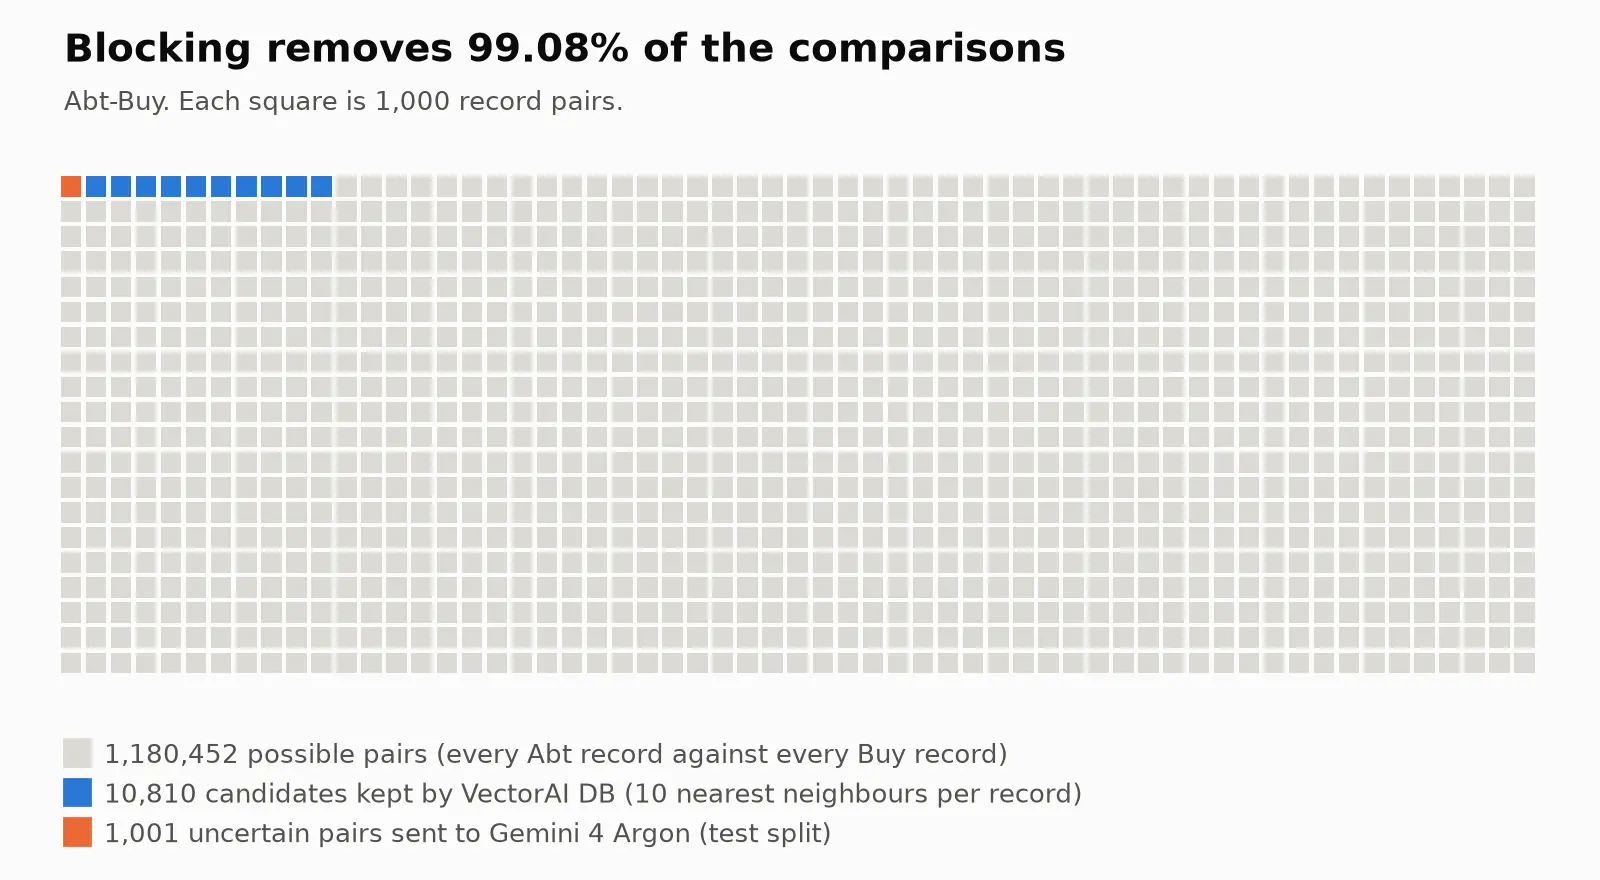
El espacio de comparación en Abt-Buy: un cuadrado por cada 1.000 pares. La base de datos de VectorAI conservó 10.810 de los 1.180.452 pares posibles, y Argon leyó 1.001 de ellos.
Paso 6: Puntuar a los candidatos y establecer el rango
Un único umbral da lugar a errores en los pares cercanos en ambas direcciones, por lo que el proceso divide los candidatos en tres bandas y solo envía la del medio a Argon. La línea de base es un umbral de mejor coincidencia: el candidato más cercano de cada registro de Abt se considera una coincidencia si su similitud supera un umbral. La precisión es la proporción de coincidencias predichas que son reales; el recuerdo es la proporción de coincidencias reales encontradas; y el F1 equilibra ambos valores. En la división de prueba Abt-Buy, el mejor umbral fue de 0,562: precisión 0,820, recuerdo 0,806 y F1 0,813. Un umbral global aplicado a los 10 candidatos por registro solo obtuvo una puntuación de 0,522.

Similitud del candidato de compra más cercano de cada registro Abt en la división de prueba. Las 136 coincidencias falsas se encuentran todas dentro del intervalo, entre 0,56 y 0,84, mezcladas con las coincidencias verdaderas, por lo que no existe un umbral único que permita separarlas.
Selecciona los límites de banda a partir de los datos
Hemos reservado el 30 % de los registros de Abt como muestra de desarrollo, hemos establecido el umbral y los límites superior e inferior a partir de la distribución de puntuaciones, y presentamos todos los resultados obtenidos con el 70 % restante. El código que aparece a continuación procede de er/bands.py, que también contiene las funciones auxiliares que utiliza: «info» asigna a cada candidato su rango y su diferencia (rank_and_gap()), «dev_best» guarda el candidato más cercano de cada registro de desarrollo (best_match()), y best_cutoff es el umbral de la línea de base (best_threshold()). Los bordes funcionan así:
- Límite superior: La puntuación mínima por encima de la cual las coincidencias óptimas alcanzan una precisión del 95 % en la división de desarrollo. Las coincidencias óptimas por encima de ese valor se emparejan automáticamente.
- Límite inferior: La puntuación más alta por debajo de la cual se sitúan, como máximo, el 5 % de las coincidencias verdaderas, con un límite máximo igual al umbral de la línea de base, de modo que el proceso nunca rechace un par que la línea de base aceptaría. Los pares que se sitúen por debajo de este valor son rechazados.
- Empates muy ajustados: Un candidato clasificado en segundo o tercer lugar que obtenga una puntuación de hasta 0,03 por debajo de la mejor de su registro también entra en la banda. Los candidatos más cercanos por sí solos limitan la recuperación al 82 %, ya que el 18 % de las coincidencias reales no son el candidato principal de su registro.
import numpy as np

def band_edges(cand, gold, target_precision, max_miss):
    pairs = sorted(cand.items(), key=lambda kv: kv[1], reverse=True)
    s = np.array([score for , score in pairs])
    y = np.array([p in gold for p,  in pairs], dtype=float)
    precision_above = np.cumsum(y) / np.arange(1, len(y) + 1)
    ok = np.where(precision_above >= target_precision)[0]
    upper = s[ok.max()] if len(ok) else s[0] + 1e-9   # nothing reaches the target: auto-match nothing
    missed_below = (y.sum() - np.cumsum(y)) / y.sum()   # share of matches scoring below each position
    lower = s[np.where(missed_below <= max_miss)[0].min()]
    return float(min(lower, upper)), float(upper)

def near_tie_band(cand, info, lower, upper, max_rank=3, max_gap=0.03):
    band = []
    for pair, score in cand.items():
        rank, gap = info[pair]   # rank among the record's candidates, distance below its best
        if score < lower:
            continue
        if (rank == 1 and score < upper) or (2 <= rank <= max_rank and gap <= max_gap):
            band.append(pair)
    return band

lower, upper = band_edges(dev_best, dev_gold, target_precision=0.95, max_miss=0.05)
lower = min(lower, best_cutoff)   # never reject a pair the baseline accepts
band = near_tie_band(test_candidates, info, lower, upper)
Los límites se situaron en 0,562 y 0,841. La banda abarcaba 1.001 de los 7.570 candidatos de la prueba, el 13,2 %, y 206 de los 279 errores de la línea de referencia se encontraban dentro de ella. Si Argon decidiera correctamente cada par de bandas, la tasa de recuperación podría aumentar de 0,806 a 0,897. Mide esa proporción en tus propios datos antes de nada: un único umbral obliga a todos los pares cercanos a situarse en un lado, y solo los errores que caen dentro de la banda pueden pasar a una segunda ronda. Si la mayoría de ellos caen en otro lugar, ninguna segunda ronda los corregirá.
En qué se equivoca el umbral
Estos pares proceden de la banda. Sus vectores están muy próximos, y la respuesta correcta depende de un detalle que la incrustación no deja claro. La tabla muestra únicamente los nombres de los productos. El arnés incrusta y, posteriormente, envía a Argon todos los campos de cada registro: nombre, descripción y precio en el caso de Abt, y nombre, descripción, fabricante y precio en el caso de Buy.
| Registro A (Abt) | Ficha B (Comprar) | Puntuación | Verdad | Baseline afirma que |
|---|---|---|---|---|
| Televisor LCD HD Sharp AQUOS de 37′ en negro – LC37D64U | Televisor LCD Sharp AQUOS LC37D44U de 37′ – LC37D44U | 0.832 | No hay resultados | Partido |
| Televisor LCD HD Sharp AQUOS de 37′ en negro – LC37D64U | Televisor LCD Sharp AQUOS LC-37D64U de 37′ | 0.814 | Partido | No hay coincidencias (2.º candidato) |
| Soporte de pared para altavoces Omnimount – 20WLBK | Soporte para altavoces OmniMount de acero inoxidable – 20.0 WALL-W | 0.830 | No hay resultados | Partido |
| Soporte de pared para altavoces Omnimount – 20WLBK | Kit de montaje universal para altavoces en pared OmniMount – 20.0 WALL-B | 0.829 | Partido | No hay coincidencias (2.º candidato) |
| Soporte de ventosa ajustable para vehículo de Garmin – 0101082303 | Soporte con ventosa para vehículo de Garmin | 0.832 | No hay resultados | Partido |
El registro de compra correcto suele ser el segundo candidato, justo debajo de uno erróneo casi idéntico: el Sharp LC-37D64U correcto obtiene una puntuación 0,018 inferior a la del LC-37D44U. Ambos superan cualquier umbral de corte. El número de modelo es la diferencia más evidente, y las descripciones aportan otras, como una relación de contraste de 10 000:1 frente a 7 500:1. Aquí está el primer par tal y como lo ven el modelo de incrustación y Argon:
Record A (Abt): name: Sharp AQUOS 37' Black LCD HDTV - LC37D64U | description: Sharp AQUOS 37' Black LCD HDTV - LC37D64U/ 1920 x 1080p Pixel Resolution/ Up To 60,000 Hours Lamp Life/ Built-In ATSC/QAM/NTSC Tuner/ 10,000:1 Dynamic Contrast Ratio/ 4ms Response Time/ 4-Wavelength Backlight System/ Black Finish

Record B (Buy): name: Sharp AQUOS LC37D44U 37' LCD TV - LC37D44U | description: Sharp AQUOS LC-37D44U - 37' Widescreen LCD HDTV - 7500:1 Dynamic Contrast Ratio - 6ms Response Time | manufacturer: Sharp
Paso 7: Enviar la banda a Argon
Cada par de bandas se envía a Argon y se devuelve con el resultado de «coincide» o «no coincide», acompañado de una frase explicativa. La respuesta es un formato estructurado, JSON que se ajusta a un esquema, por lo que no es necesario analizar nada manualmente. Un modelo general puede realizar este paso sin necesidad de datos de entrenamiento: Peeters, Steiner y Bizer Se ha comprobado que los mejores modelos de lenguaje grande (LLM), sin ejemplos o con muy pocos, alcanzan el mismo nivel que los modelos de lenguaje preentrenados y ajustados con miles de pares etiquetados. La indicación y el esquema que se muestran a continuación son los que figuran en el repositorio, ajustados a la partición de desarrollo, y el código corresponde al núcleo de la clase `Adjudicator` en `er/adjudicate.py`. Este fragmento de código llama directamente a la API de Gemini con GEMINI_API_KEY; el arnés también puede conectarse al mismo modelo a través de OpenRouter.
import json
from google import genai
from google.genai import types
from pydantic import BaseModel

class Verdict(BaseModel):
    match: bool
    reason: str   # one sentence, logged for audit

PROMPT = """You are resolving product records from two catalogues.
Decide whether Record A and Record B describe the same product: same model, size, and variant.
Answer from the records only. Give a one-sentence reason.

Record A: {a}
Record B: {b}"""

client = genai.Client()   # reads GEMINI_API_KEY from the environment

def adjudicate(a_text: str, b_text: str) -> tuple[Verdict, int, int]:
    resp = client.models.generate_content(
        model="gemini-4-argon",
        contents=PROMPT.format(a=a_text, b=b_text),
        config=types.GenerateContentConfig(
            response_mime_type="application/json",
            response_schema=Verdict,
            temperature=0,
            thinking_config=types.ThinkingConfig(thinking_level="LOW"),
        ),
    )
    usage = resp.usage_metadata
    # thinking tokens are billed at the output rate, so count them with the visible answer
    out_tokens = (usage.candidates_token_count or 0) + (usage.thoughts_token_count or 0)
    return Verdict.model_validate_json(resp.text), usage.prompt_token_count or 0, out_tokens
Cada veredicto se registra en un registro junto con su motivo, de modo que, si más adelante se cuestiona una fusión, se pueda demostrar por qué Argon la llevó a cabo. El bucle omite los pares que ya figuran en el registro, por lo que al volver a ejecutar el proceso nunca se paga dos veces; además, el sistema de pruebas añade reintentos para los límites de frecuencia:
import os

text_of = {(src, rid): text for src, rid, text in records}

os.makedirs("results", exist_ok=True)
log_path = "results/argon_verdicts.jsonl"
done = set()
if os.path.exists(log_path):   # pairs already paid for on an earlier run
    with open(log_path) as f:
        done = {(r["abt"], r["buy"]) for r in map(json.loads, f)}

tokens_in = tokens_out = 0
with open(log_path, "a") as log:
    for abt_id, buy_id in band:
        if (abt_id, buy_id) in done:
            continue
        verdict, t_in, t_out = adjudicate(text_of["abt", abt_id], text_of["buy", buy_id])
        tokens_in += t_in
        tokens_out += t_out
        log.write(json.dumps({"abt": abt_id, "buy": buy_id, **verdict.model_dump()}) + "\n")
        log.flush()   # a crash mid-run keeps every verdict written so far
Las ejecuciones mencionadas en este artículo llegaron a Argon a través de OpenRouter, que las redirige a los puntos finales de Google e informa del coste exacto por llamada. La opción «Thinking» se configuró en «LOW», ya que los tokens de «Thinking» se facturan y una decisión de coincidencia no requiere un razonamiento profundo.
Define tu clave antes de ejecutar el harness, en el entorno y nunca en el código. El fragmento de código anterior dice: GEMINI_API_KEY El backend OpenRouter del harness (–argon-backend openrouter) lee OPENROUTER_API_KEY:
# macOS or Linux
export OPENROUTER_API_KEY="<YOUR_OPENROUTER_API_KEY>"

# Windows (PowerShell)
$env:OPENROUTER_API_KEY="<YOUR_OPENROUTER_API_KEY>"
El arnés también impone un límite de gasto: –budget-usd suma el coste exacto de cada llamada en todas las ejecuciones y se detiene antes de alcanzar el límite.
Lo que decidió Argon
Al igual que en el caso anterior, la tabla solo muestra los nombres; Argon leyó los registros completos. La descripción de «Compra» de la fila de Garmin, por ejemplo, incluye el número de referencia 010-10723-03 que cita Argon.
| Registro A (Abt) | Ficha B (Comprar) | Verdad | Argón | La razón de Argon |
|---|---|---|---|---|
| Televisor LCD HD Sharp AQUOS de 37′ en negro – LC37D64U | Televisor LCD Sharp AQUOS LC37D44U de 37′ – LC37D44U | No hay resultados | No hay resultados | Diferentes modelos de Sharp AQUOS de 37 pulgadas, el LC37D64U y el LC37D44U, que además presentan diferentes relaciones de contraste. |
| Televisor LCD HD Sharp AQUOS de 37′ en negro – LC37D64U | Televisor LCD Sharp AQUOS LC-37D64U de 37′ | Partido | Partido | El mismo televisor LCD HDTV Sharp AQUOS de 37 pulgadas, con el mismo número de modelo (LC37D64U / LC-37D64U) y una resolución de 1920 x 1080. |
| Soporte de pared para altavoces Omnimount – 20WLBK | Soporte para altavoces OmniMount de acero inoxidable – 20.0 WALL-W | No hay resultados | No hay resultados | El modelo A es la variante negra (20WLBK, acabado negro); el modelo B es una variante diferente (20.0 WALL-W). |
| Soporte de pared para altavoces Omnimount – 20WLBK | Kit de montaje universal para altavoces en pared OmniMount – 20.0 WALL-B | Partido | Partido | El mismo soporte de acero inoxidable negro con una capacidad nominal de 20 libras; los modelos 20WLBK y 20.0 WALL-B son el mismo modelo. |
| Soporte de ventosa ajustable para vehículo de Garmin – 0101082303 | Soporte con ventosa para vehículo de Garmin | No hay resultados | No hay resultados | Números de referencia diferentes: 0101082303 frente a 010-10723-03. |
Argon acertó 960 de los 1.001 pares de bandas, lo que supone un 95,9 %, incluyendo todos los pares por encima del umbral que el sistema había clasificado erróneamente. Cuarenta de sus 41 errores fueron coincidencias reales que rechazó, y nuestro análisis de los motivos registrados nos permite clasificarlos en tres grupos:
- Un registro demasiado impreciso para confirmarlo (19). Buy incluye en su catálogo el «Horno microondas de sobremesa LG de 2,0 pies cúbicos», sin indicar el número de modelo ni el color, por lo que Argon no lo consideraría el mismo producto que un modelo concreto.
- Una diferencia de variante, color o paquete (7). Una Canon PowerShot negra frente a una plateada, o una tarjeta SD vendida con un lector de tarjetas frente a la tarjeta sola. El benchmark las considera coincidencias; Argon no.
- Diferentes números de modelo (14). Varios parecen errores de etiquetado en la propia comparativa, como el Weber Summit S-650 frente al S-450 y el Time Capsule de 500 GB de Apple frente al modelo de 1 TB.
El error número 41 fue al revés: Argon comparó un frigorífico LG con puertas francesas de 25,0 pies cúbicos con otro de 24,7 pies cúbicos, argumentando que 24,7 es la capacidad exacta del mismo modelo, mientras que el punto de referencia indica que difieren.
Las razones ponen de manifiesto que el modelo aplica un concepto más estricto de «el mismo producto» que las etiquetas del índice de referencia. También indican cuál es la solución. Una indicación mejor no puede proporcionar un número de modelo que no figure en el registro, y ampliar el rango no sirve de nada para los pares que Argon ya detecta. Para los 19 pares ambiguos, la solución consiste en que los registros contengan información suficiente; y para los 14 pares de números de modelo, consiste en comprobar las etiquetas.
Paso 8: Ejecutar el proceso completo
El código completo, con bloqueo, selección de bandas, el «Argon pass» y la puntuación frente a las etiquetas doradas, se encuentra en el repositorio asociado. Las versiones están fijadas:
| Componente | Versión |
|---|---|
| VectorAI DB | actian/vectorai:1.0.2 |
| Modelo de integración | Incrustación de Gemma (embeddinggemma) a través de Ollama |
| Árbitro | gemini-4-argon, ejecutado el 23 de octubre de 2026 a través de OpenRouter, nivel de reflexión BAJO |
| Conjuntos de datos | Abt-Buy y Amazon-Google, colección de referencia de Leipzig, descargada el 19 de octubre de 2026 |
Ejecuta todo el proceso en Abt-Buy:
uv run resolve.py --dataset abt-buy --argon-backend openrouter --workers 2 --budget-usd 10Utiliza –dataset amazon-google para la segunda prueba de rendimiento, o añade –no-argon para ejecutar el bloqueo y el umbral sin realizar ninguna llamada a la API.
El script muestra todas las métricas de este artículo para ambos enfoques, además del porcentaje de pares enviados a Argon y el coste. Resultado resumido de la ejecución de Abt-Buy:
abt-buy: 1081 abt + 1092 buy records, 1097 true matches

Blocking (all records, hnsw_ef=256):
  K=1   candidates=  1,081  reduction ratio=0.9991  pair completeness=0.8186  returned/record: mean 1.0, min 1, short 0
  K=3   candidates=  3,243  reduction ratio=0.9973  pair completeness=0.9453  returned/record: mean 3.0, min 3, short 0
  K=5   candidates=  5,405  reduction ratio=0.9954  pair completeness=0.9699  returned/record: mean 5.0, min 5, short 0
  K=10  candidates= 10,810  reduction ratio=0.9908  pair completeness=0.9900  returned/record: mean 10.0, min 10, short 0
  K=20  candidates= 21,620  reduction ratio=0.9817  pair completeness=0.9973  returned/record: mean 20.0, min 20, short 0

Test split: 7,570 candidates, 767 true matches
  Global cutoff, all candidates (reference, 0.7672): P=0.5734 R=0.4785 F1=0.5217
  Best-match threshold (baseline, 0.5618): P=0.8196 R=0.8057 F1=0.8126
  Band [0.5618, 0.8405) + near-ties (rank <= 3, gap <= 0.03): 1,001 pairs (13.2% of candidates), holding 206/279 of the baseline's errors; recall ceiling 0.8970
  With Argon: P=0.9985 R=0.8449 F1=0.9153  (960/1001 band verdicts correct, $1.4081)
Los resultados, medidos
La pasada de Argon aumentó el F1 en unos 10 puntos en ambas pruebas de referencia, pasando de 0,813 a 0,915 en Abt-Buy y de 0,597 a 0,691 en Amazon-Google, al tiempo que detectó entre el 13 % y el 14 % de los pares candidatos. No se trata de un error de redondeo: en Abt-Buy eliminó 135 de las 136 coincidencias falsas que el umbral aceptaba. Que una mejora merezca la pena en tus datos depende de lo que te cueste una fusión errónea o una coincidencia omitida. Una mejora de uno o dos puntos sería difícil de distinguir de un simple cambio del umbral y no justificaría el coste de la API.
| Conjunto de datos | Relación de reducción | Exhaustividad de los pares | F1, umbral de mejor coincidencia | F1, con argón | Compartir enviado a Argon | Coste por cada 1.000 registros |
|---|---|---|---|---|---|---|
| Abt-Comprar | 99.08% | 99.0% | 0.813 | 0.915 | 13.2% | $0.76 |
| Amazon-Google | 99.69% | 94.1% | 0.597 | 0.691 | 14.0% | $0.58 |
La precisión y la recuperación muestran de dónde proviene la mejora. En Abt-Buy, la precisión aumentó de 0,820 a 0,998 y la recuperación de 0,806 a 0,845. Dentro de la banda, Argon rechazó 135 de las 136 coincidencias falsas que el umbral había aceptado, y aceptó 59 coincidencias verdaderas que eran la segunda o tercera mejor opción de un registro, algo que un umbral de mejor coincidencia nunca puede detectar. La recuperación no alcanzó el límite máximo de 0,897 de la banda porque Argon rechazó pares en los que uno de los registros era demasiado impreciso, o en los que los productos diferían en variante, color o paquete.
El caso de Amazon-Google es más complicado: sus títulos de software varían en edición, versión y presentación, y el filtrado retuvo el 94,1 % de las coincidencias reales. La precisión aumentó de 0,581 a 0,684 y la recuperación de 0,614 a 0,698, y Argon acertó en el 76,4 % de los casos. La mayoría de sus 316 errores (290) correspondían a coincidencias rechazadas por el archivo de referencia. En una muestra aleatoria de 12, siete comparten un número de modelo, un número de pieza o una versión explícitos con el anuncio coincidente, como el VPN01L de Netgear, lo que apunta a lagunas en las etiquetas de referencia. Todas las puntuaciones aquí siguen utilizando el archivo de referencia tal y como se publicó.
Coste. Según las tarifas exactas por llamada de OpenRouter, incluidos los tokens de reflexión, las 1.001 llamadas de Abt-Buy costaron 1,41 dólares, y las 1.338 llamadas de Amazon-Google costaron 2,42 dólares. Por cada 1.000 registros en cada división de prueba, contando los registros de la división de prueba de la primera tabla más toda la segunda tabla (1.849 registros para Abt-Buy, 4.181 para Amazon-Google), eso supone 0,76 dólares y 0,58 dólares. El precio de catálogo de Argon se duplica el 1 de diciembre de 2026, según la página de precios de la API Gemini de Google, lo que duplicaría aproximadamente estas cifras. A modo de punto de referencia, AWS Entity Resolution cobra 0,25 dólares por cada 1.000 registros procesados para la coincidencia basada en reglas o en aprendizaje automático, por cada registro en lugar de por tramos.
Latencia. En un portátil con solo CPU y 8 GB de RAM, la integración de los 2.173 registros de Abt-Buy tardó 771 segundos, y el bloqueo, 35 segundos. Las llamadas a Argon tardaron 54 minutos para Abt-Buy y 88 minutos para Amazon-Google, con 2 solicitudes en paralelo; con 8 solicitudes en paralelo, nuestras llamadas devolvieron 429 errores de límite de tasa. La integración es un coste único: el harness almacena los vectores en caché, por lo que las repeticiones comienzan en el bloqueo.
En comparación con lo publicado en la literatura.Li et al. informan de que Ditto, un sistema de emparejamiento ajustado sobre pares etiquetados, alcanza un F1 de 89,33 en Abt-Buy y de 75,58 en Amazon-Google (0,893 y 0,756 en la escala utilizada aquí) en las versiones ER-Magellan de estos bancos de pruebas. Ditto se evaluó con un conjunto preseleccionado de pares etiquetados, mientras que nuestras cifras proceden de la resolución de las tablas completas tras el bloqueo, por lo que sus puntuaciones deben considerarse un punto de referencia. Nuestro proceso no necesita datos de entrenamiento, y su recuperación está limitada por lo que se mantiene tras el bloqueo y por los candidatos que alcanzan el rango.
Por qué se ejecuta en tu propia infraestructura
Los datos de resolución son registros de clientes, pacientes y contrapartes que, a menudo, no pueden salir de un ámbito regulado. En este caso, VectorAI DB y el modelo de incrustación se ejecutan en tus propios equipos, por lo que las incrustaciones, el bloqueo y las entidades resueltas permanecen dentro de tu red. Solo la llamada de Argon envía datos al exterior: el «band», el 13,2 % de los pares candidatos, dos registros cada vez. Para los datos regulados, elige una de estas dos opciones:
- Anonimiza los datos de la banda. Elimina o enmascara los nombres, las direcciones de correo electrónico y los números de cuenta, y envía únicamente los campos que determinan la coincidencia, si tu política permite la salida de datos.
- Mantén la segunda pasada a nivel local. Si ningún campo puede salir, sustituye adjudicate() por una llamada a un modelo que alojes tú mismo. La estructura del código sigue siendo la misma. En esta ejecución no hemos evaluado un modelo local, por lo que cabe esperar cifras diferentes en cuanto a precisión y coste.
Cuándo merece la pena colaborar y cuándo no
Esta división se posiciona en un debate actual sobre los modelos de lenguaje grande (LLM) en la resolución de entidades. Jeff Jonas, fundador de Senzing, escribe que a menudo le preguntan por qué no se utiliza simplemente un LLM para la resolución de entidades, y responde que «no es una buena idea». Se refiere a la comparación realizada por Clair Sullivan entre Claude Opus 4.8 y el motor de Senzing, en la que el LLM resultó mucho más lento y costoso, y destaca la importancia de los resultados determinísticos y la explicabilidad. El proceso aquí se centra en la escala y mantiene el LLM al margen de casi todos los pares; VectorAI DB y el umbral deciden el 87 % de los candidatos, y Argon solo analiza el rango en el que el umbral no es fiable. Esto también responde en parte a la cuestión de la explicabilidad, ya que cada veredicto se registra junto con su justificación. Esto no convierte a Argon en un sistema determinista, pero al volver a ejecutar el proceso se reproducen los veredictos registrados en lugar de volver a realizar la consulta.
Ejecuta la pasada de Argon cuando se den dos condiciones en tus datos: que la banda contenga la mayor parte de los errores del umbral y que Argon determine los pares de bandas con una precisión al menos 10 puntos superior a la del umbral. Ambas condiciones se cumplieron en las dos pruebas de rendimiento, y en cada ocasión la pasada aportó unos 10 puntos F1 por menos de 1 dólar por cada 1.000 registros.
| Conjunto de datos | Los errores de Threshold dentro de la banda | Umbral justo en los pares de bandas | Argon justo en los pares de bandas | Ganancia F1 | Coste por cada 1.000 registros |
|---|---|---|---|---|---|
| Abt-Comprar | 206 de 279 (74 %) | 79.4% | 95.9% | +10.3 | $0.76 |
| Amazon-Google | 500 de 697 (72 %) | 62.6% | 76.4% | +9.4 | $0.58 |
La ventaja de Argon en los pares de bandas fue de 16,5 puntos en Abt-Buy y de 13,8 en Amazon-Google. Para determinar en qué punto esa ventaja deja de generar beneficios en la F1, volvimos a aplicar la banda con la mitad y el doble de su anchura en ambos conjuntos de datos. Todos los resultados procedían del mismo registro, por lo que cada fila muestra lo que aportó la porción adicional de la banda:
| Conjunto de datos | Ancho de banda | Pares enviados a Argon | F1 con argón | Precio del argón | Se ha añadido la ventaja de Argon en la prueba por parejas |
|---|---|---|---|---|---|
| Abt-Comprar | 0.5× | 803 | 0.901 | $1.13 | (base) |
| Abt-Comprar | 1× | 1,001 | 0.915 | $1.41 | +12,1 puntos en 198 pares |
| Abt-Comprar | 2× | 1,079 | 0.916 | $1.53 | +1,3 puntos en 78 pares |
| Amazon-Google | 0.5× | 1,269 | 0.6905 | $2.32 | (base) |
| Amazon-Google | 1× | 1,338 | 0.6909 | $2.42 | +1,4 puntos en 69 pares |
| Amazon-Google | 2× | 1,348 | 0.6924 | $2.44 | +20 puntos por 10 pares |
Las fracciones en las que Argon superó el umbral dieron claramente sus frutos. En Abt-Buy, la fracción de «media a completa», con una ventaja de 12,1 puntos, sumó 1,5 puntos F1 por 0,28 $. En Amazon-Google, los últimos 10 pares, con una ventaja de 20 puntos, sumaron 0,15 puntos por 0,02 $. Los segmentos en los que la ventaja era de aproximadamente un punto aportaron menos de una décima de punto cada uno: los siguientes 78 pares de Abt-Buy aportaron 0,07 por 0,12 dólares, y el segmento de «medio a completo» en Amazon-Google aportó 0,04 por 0,09 dólares. Así pues, el gasto adicional dejó de generar F1 en algún punto entre una ventaja de 1 punto y una de 12 puntos. Dos conjuntos de datos no permiten situar esa línea con mayor precisión, así que considera la barra de 10 puntos como una regla general que se sitúa dentro de ese margen.
El abono deja de ser válido en tres casos:
- El umbral ya está justo en la banda. Si tu banda basada en el umbral se adapta casi tan bien como lo hace Argon, la pasada gasta recursos en confirmar lo que el umbral ya sabía.
- Los errores quedan fuera del intervalo. Si el filtrado descarta coincidencias reales, o si estas se sitúan en una posición demasiado baja en la clasificación como para considerarse casi empates, no pasan a la segunda fase. En el caso de Amazon-Google, esto limitó la recuperación a 0,727 antes de que Argon leyera un solo par.
- La banda es demasiado ancha. Al duplicar el ancho de la banda en Abt-Buy se enviaron 78 pares más a Argon (1.079 en lugar de 1.001) y supuso un coste adicional de 0,12 dólares según las tarifas calculadas por OpenRouter, pero solo un error más del umbral quedó dentro de ella. El F1 pasó de 0,9153 a 0,9160, menos de una décima de punto. Establece los límites a partir de tus datos y luego déjalos así.
Para comprobar tus propios datos, etiqueta a mano unos 200 pares de bandas y, a continuación, compara la frecuencia con la que el umbral y Argon los identifican correctamente. Esa muestra cuesta unos 30 céntimos en llamadas a Argon según las tarifas indicadas aquí, y te permite saber si la pasada completa será rentable antes de ejecutarla.
Conclusión
El proceso descrito en este artículo identificó correctamente los televisores Sharp desde el principio. El umbral seleccionó el modelo LC37D44U porque su vector obtuvo una puntuación más alta; Argon leyó ambos registros, identificó el modelo LC37D64U por su número de modelo y registró el motivo. En la división de la prueba Abt-Buy, esa segunda pasada elevó el F1 de 0,813 a 0,915 por 0,76 dólares por cada 1.000 registros.
Ese resultado se debe a la combinación de tres decisiones:
- Filtra mediante una búsqueda del vecino más cercano en la base de datos de VectorAI, de modo que desaparezca el 99 % del espacio de comparación, mientras que se mantenga el 99 % de las coincidencias reales.
- Establece los límites del intervalo a partir de los datos etiquetados, de modo que solo el 13,2 % de los candidatos, aquellos sobre los que existe incertidumbre, supongan un gasto.
- Envía solo esa banda a un modelo capaz de leer un número de pieza.
VectorAI DB y el modelo de incrustación se ejecutan en tu propio hardware, por lo que todo, excepto el ancho de banda, permanece dentro de tu red.
El mismo arnés se ejecuta en tus propias tablas. Dirige el cargador hacia tus registros de clientes, proveedores o productos, introduce tus reglas de exclusión en la cláusula «must» del filtro de bloqueo y ejecútalo en VectorAI DB Community Edition. Descarga la imagen para empezar:
docker pull actian/vectorai:latest
Mantente conectado
Te ofrecemos información detallada sobre los datos.
(por ejemplo, sales@..., support@...)
