
Crea un agente de IA local en una Raspberry Pi 5 con VectorAI DB


Principales conclusiones
- Una Raspberry Pi 5 puede ejecutar un agente de IA totalmente local con Ollama y la base de datos Actian VectorAI, manteniendo la memoria persistente tras cada reinicio.
- El agente utiliza Qwen 2.5 1.5B para las respuestas, nomic-embed-text para las representaciones y VectorAI DB para la recuperación de la memoria semántica.
- En el Pi de prueba, las memorias relevantes se recuperaron en 1,8 ms, mientras que la inferencia del modelo local tardó 3,6 segundos.
- VectorAI DB devolvió los cinco primeros resultados de entre 100 000 vectores con una latencia de recuperación p99 inferior a 5 ms en el hardware probado.
- El almacenamiento NVMe, la refrigeración activa y una potencia suficiente ayudan a la Pi a soportar cargas de trabajo de IA locales, mientras que los modelos más grandes y los sistemas multiagente pueden requerir un hardware más potente.
Si estás creando un agente en una Raspberry Pi, este debe recordar las sesiones anteriores tras un reinicio del proceso, un reinicio del sistema, un apagado y encendido o un fallo del sistema. En el caso del monitor de invernadero de este tutorial, eso significa recuperar la lectura de un sensor de la semana pasada cuando la consultes hoy.
La capa de memoria también debe funcionar dentro de los límites del hardware de la Pi. Algunas bases de datos se ralentizan a medida que crece la colección. Otras requieren un proceso de servidor independiente que utilice la RAM junto con Ollama. También necesitamos saber cómo varía la latencia de recuperación a medida que la memoria del agente pasa de 10 000 a 100 000 vectores. Hemos probado esto en una Raspberry Pi 5.
$ uv run agent.py
Agent ready on Raspberry Pi 5 Model B Rev 1.1, 8 GB RAM | LLM: qwen2.5:1.5b | 2 memories in VectorAI DB. Ctrl+C to quit.

you> Which greenhouse sensor was reading high, and what was going on in zone B?

agent> The greenhouse sensor 3 was reading 41 degrees, indicating a high temperature. In zone B, the irrigation pump was switched off for maintenance.
Ambos datos procedían de una sesión anterior, y entre medias reiniciamos la base de datos. La base de datos VectorAI de Actian los encontró en 1,8 ms, mientras que Qwen 2.5 1.5B respondió en 3,6 segundos en la CPU de la Pi, sin utilizar ninguna API en la nube.
El hardware es una Raspberry Pi 5 de 8 GB con un SSD NVMe y el Active Cooler oficial. Ollama ejecuta el modelo, y la base de datos Actian VectorAI DB almacena la memoria del agente en el disco. El agente almacena lo que le indicas en forma de vectores, los busca cuando le haces una pregunta y envía los relevantes al modelo.
Al finalizar este tutorial, tendrás este agente en funcionamiento en tu propia Pi 5, con una memoria que se conserva tras los reinicios. También dispondrás de una prueba de rendimiento que muestra cómo varía la latencia de recuperación a medida que la colección crece de 1.000 a 100.000 vectores.
Requisitos previos
- Raspberry Pi 5 de 8 GB con un HAT PCIe NVMe, un SSD NVMe, un disipador térmico oficial «Active Cooler» y el alimentador oficial USB-C de 27 W.
- Raspberry Pi OS de 64 bits (Trixie).
- Docker con el complemento Compose (
curl -fsSL https://get.docker.com | sh), y que tu usuario pertenezca al grupo «docker» (sudo usermod -aG docker “$USER”, y luego cierra la sesión y vuelve a iniciarla). - uv, el gestor de paquetes de Python (se instala en el paso 3). Si tu sistema no dispone de una versión compatible con Python 3.11 o superior, este lo instalará por ti.
- Una licencia de VectorAI DB o una versión de prueba de 30 días. La edición gratuita «Community» limita las colecciones a menos de 5.000 vectores. Eso es más que suficiente para este tutorial, pero para las pruebas de rendimiento de 10.000 y 100.000 se necesita la licencia.
- Todo el código se encuentra en el Repositorio de GitHub. Clónalo y ejecútalo
./setup.sh, que abarca los pasos del 1 al 5, excepto el reinicio para ajustar el límite de memoria; a continuación, pasa al paso 6.
Lo que estás construyendo
La configuración se ejecuta en la Pi: dos contenedores de Docker y un script de Python.
Ollama ejecuta dos modelos en un contenedor de Docker con un límite de 4 GB. qwen2.5:1.5b genera respuestas. nomic-embed-text convierte el texto en vectores de 768 dimensiones. Con ambos cargados, Ollama consumió 1,58 GiB en la placa de pruebas.
Actian VectorAI DB se ejecuta en un segundo contenedor con un límite de 2 GB. Almacena cada mensaje de usuario como un vector en un índice HNSW (Hierarchical Navigable Small World) y lo escribe en un volumen SSD local, por lo que la memoria se conserva tras los reinicios. Consumió 125 MiB con colecciones pequeñas.
agent.py las conecta en menos de 100 líneas sin necesidad de un marco de trabajo de agentes. Llama a Ollama a través de HTTP con requests y se comunica con la base de datos de VectorAI a través del SDK oficial de Python.
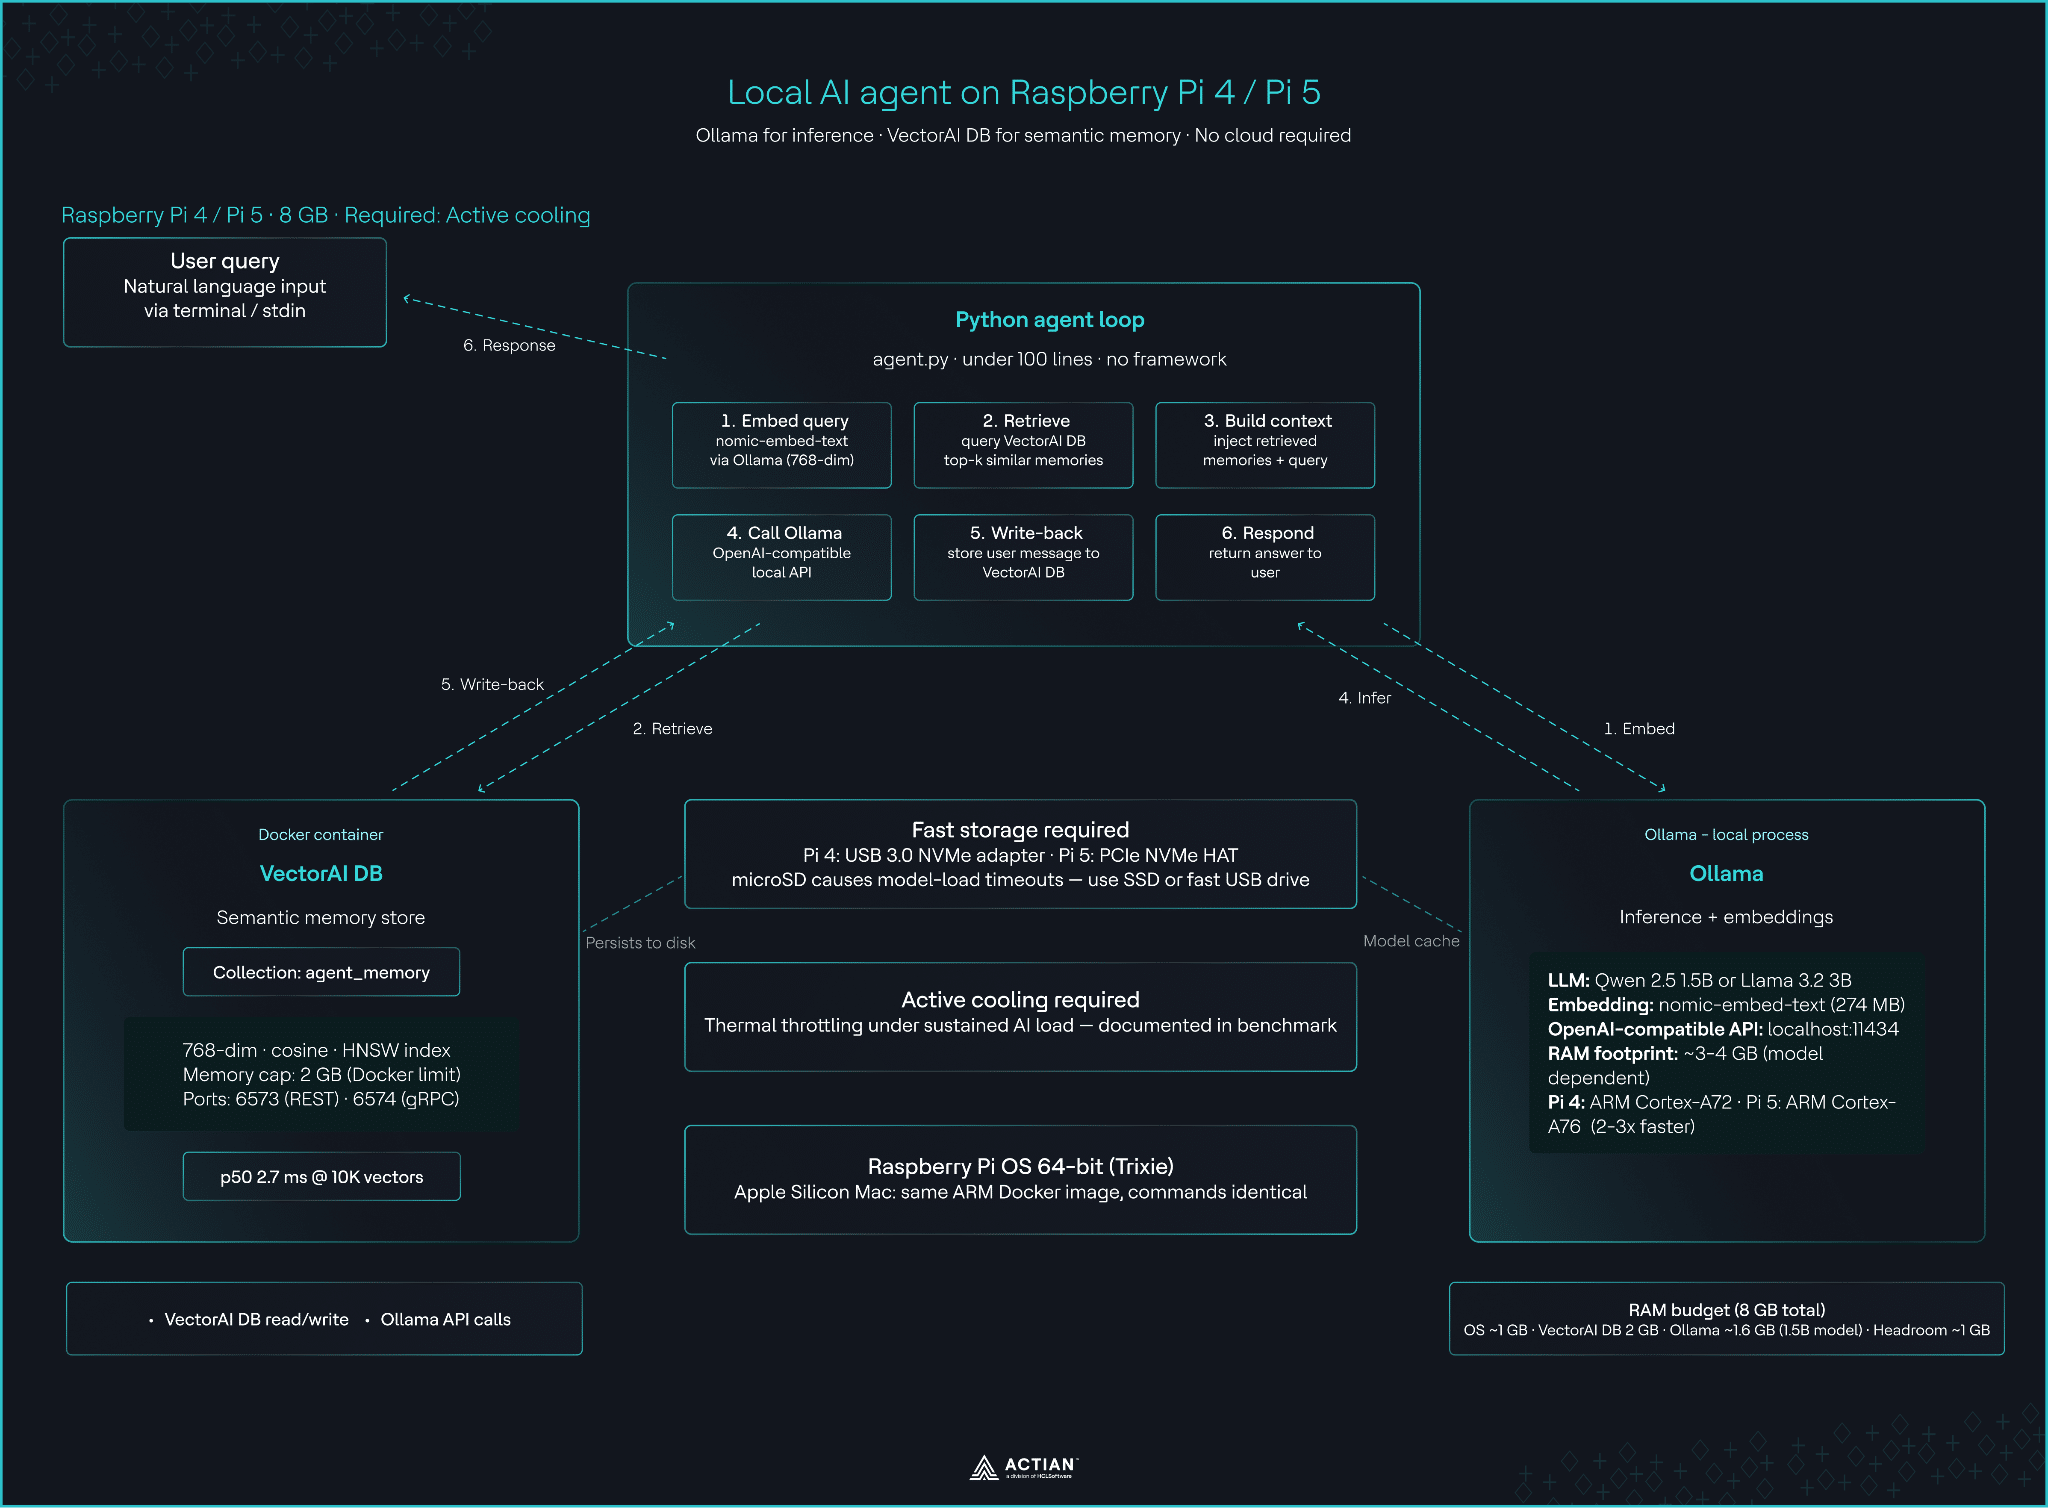
Diagrama de arquitectura. Haces una pregunta. El agente la integra, recupera recuerdos relacionados de la base de datos de VectorAI, los incorpora a la solicitud, invoca a Qwen 2.5 1.5B a través de Ollama y vuelve a almacenar tu mensaje en la base de datos de VectorAI. Toda la pila se ejecuta en la placa.
Material necesario
Utiliza un Pi 5 de 8 GB con almacenamiento NVMe y refrigeración activa. Cada uno de los elementos que se indican a continuación soluciona un fallo con el que, de otro modo, te encontrarías.
| Parte | Lo que necesitas |
| Junta directiva | Raspberry Pi 5, 8 GB |
| Almacenamiento | SSD NVMe en una tarjeta HAT PCIe |
| Refrigeración | Enfriador «Official Active Cooler» o equivalente |
| Potencia | Fuente de alimentación USB-C oficial de 27 W |
| SO | Raspberry Pi OS de 64 bits (Trixie) |
RAM. Con ambos modelos cargados, la pila utilizaba un total de 2,38 GiB: unos 630 MB para el sistema operativo, 1,58 GiB para Ollama, 125 MiB para VectorAI DB (179 MiB justo después de un reinicio) y el resto para el proceso del agente. Una placa de 4 GB podría ejecutar esta configuración exacta, pero no la hemos probado.
NVMe. El Pi de prueba se inicia desde la tarjeta microSD y solo guarda los datos del modelo y del vector en el NVMe. A partir de una caché activa, qwen2.5:1.5b se recargó en 3,1 segundos y nomic-embed-text en 0,26 segundos. Justo después de reiniciar, Qwen tardó 4,4 segundos en cargarse. La Pi 5 funciona con PCIe de 2.ª generación por defecto. La prueba de rendimiento se realizó con la 3.ª generación, que se activa con una sola línea de código.
echo "dtparam=pciex1_gen=3" | sudo tee -a /boot/firmware/config.txt
sudo reboot
Refrigeración. Durante la prueba de rendimiento de 100K, el SoC pasó de 46,6 °C a 68,6 °C y vcgencmd get_throttled informado 0x0 antes y después, por lo que la CPU nunca se ralentizó. En una prueba anterior de 100 000, el SoC alcanzó un máximo de 77,4 °C con el ventilador a 8 731 rpm. La Pi 5 empieza a ralentizar su CPU a 80 °C, por lo que un disipador pasivo probablemente superaría ese umbral. Una prueba inicial con una fuente de alimentación menos potente mostró 0x50000 (subtensión); la fuente de alimentación oficial de 27 W lo solucionó.
Sin Pi: Un Mac con Apple Silicon ejecuta las mismas imágenes arm64 y todos los comandos que aparecen aquí. Tus valores de latencia serán más bajos, así que no los compares directamente con los resultados del Pi.
Paso 1: Inicia VectorAI DB y Ollama
Activa primero los límites de memoria. El sistema operativo de la Raspberry Pi se inicia con el cgroup de memoria desactivado, por lo que Docker lo ignora sin avisar. mem_limit hasta que lo enciendas:
sudo sed -i '1 s/$/ cgroup_enable=memory/' /boot/firmware/cmdline.txt
sudo reboot
Tras el reinicio, docker info ya no debería mostrar el aviso No memory limit support.
Crea el directorio del proyecto:
mkdir -p pi5-vectorai-agent && cd pi5-vectorai-agent
mkdir -p data ollama results
sudo chown 999:999 data     # VectorAI DB runs as UID 999 and crash-loops on a root-owned mount
Guárdalo como:docker-compose.yml
services:
  vectorai:
    image: actian/vectorai:latest
    container_name: vectorai
    # the licence is tied to the host identity; a fixed hostname keeps it valid when the container is recreated
    hostname: vectorai
    ports:
      - "6573:6573" # REST
      - "6574:6574" # gRPC
    volumes:
      # vector data persists across restarts
      - ./data:/var/lib/actian-vectorai
    environment:
      - VECTORAI_LOG_LEVEL=info
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    mem_limit: 2g
    restart: unless-stopped

  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    ports:
      - "11434:11434"
    volumes:
      - ./ollama:/root/.ollama
    mem_limit: 4g
    restart: unless-stopped
Inicia ambos servicios:
docker compose up -d
docker ps
Ambos contenedores deberían mostrar Up. VectorAI DB tarda unos 15 segundos en iniciarse por completo. Si quieres añadir una licencia, hazlo ahora. Si más adelante tienes que volver a crear el contenedor (por ejemplo, con --force-recreate) la invalida.
Paso 2: Extraer los modelos
qwen2.5:1.5b ocupa unos 1,1 GB y nomic-embed-text unos 274 MB:
docker exec ollama ollama pull qwen2.5:1.5b
docker exec ollama ollama pull nomic-embed-text
Al hacer clic en «Pulling» solo se descargan los modelos. Ollama carga cada uno de ellos en la memoria RAM la primera vez que se utiliza y lo mantiene cargado durante cinco minutos tras la última solicitud (configuración predeterminada de Ollama), por lo que el primer mensaje tras una pausa tarda más en enviarse.
Paso 3: Instalar las dependencias de Python
Este proyecto utiliza uv, que gestiona el entorno virtual e instala una versión compatible de Python automáticamente. Instálalo:
curl -LsSf https://astral.sh/uv/install.sh | sh
source $HOME/.local/bin/env
Guárdalo como pyproject.toml en el directorio del proyecto:
[project]

name = "pi5-vectorai-agent"
version = "0.1.0"
description = "Offline AI agent with semantic memory on a Raspberry Pi 5: Ollama + Actian VectorAI DB"
requires-python = ">=3.11"
# uv run agent.py reads this, creates .venv and installs these on first run
dependencies = [
    "requests",                # Ollama's HTTP API
    "actian-vectorai-client",  # VectorAI DB client (gRPC); brings numpy, protobuf, grpcio
    "numpy",                   # benchmark vectors
    "matplotlib",              # benchmark chart only
]
A continuación, crea el entorno:
uv syncuv sync dice pyproject.toml, crea .venv, e instala los cuatro paquetes. A partir de aquí, empieza cada comando de Python con uv run; no hay que configurar ningún entorno. NumPy y Matplotlib solo se utilizan para la prueba de rendimiento y el gráfico.
Paso 4: Prueba de funcionamiento de ambos servicios
Comprueba que ambos servicios respondan antes de escribir el código del agente:
uv run python -c 'from actian_vectorai import VectorAIClient

with VectorAIClient("localhost:6574") as c: print(c.health_check())'


curl -s http://localhost:11434/api/embed \
  -d '{"model":"nomic-embed-text","input":"hello"}' | head -c 120

curl -s http://localhost:11434/api/generate \
  -d '{"model":"qwen2.5:1.5b","prompt":"Say hi in five words.","stream":false}'
{'title': 'Actian VectorAI DB', 'version': 'Actian VectorAI DB 1.0.2 / VDE 1.0.2'}

{"model":"nomic-embed-text","embeddings":[[0.017874617,-0.0058246492,-0.17537898,...

{"model":"qwen2.5:1.5b",...,"response":"Hello there!","done":true,...}
Comprueba la memoria RAM con ambos modelos instalados:
docker stats --no-stream --format "{{.Name}}: {{.MemUsage}}"En la placa de pruebas:
ollama: 1.58GiB / 4GiB
vectorai: 125MiB / 2GiB
Si la columna «Límite» muestra la memoria RAM total en lugar de 4GiB y 2GiB, el cambio en el cgroup del paso 1 no se aplicó.
Paso 5: Crear la colección de recuerdos
Crea una colección con el tamaño adecuado para nomic-embed-textvectores de 768 dimensiones:
uv run python - <<'EOF'

from actian_vectorai import VectorAIClient, VectorParams, Distance
with VectorAIClient("localhost:6574") as client:

    client.collections.create(

        "agent_memory",

        vectors_config=VectorParams(size=768, distance=Distance.Cosine),

    )

EOF
Este paso es opcional; el agente crea la colección la primera vez que se ejecuta. Al ejecutarlo ahora, se comprueba que la base de datos admite operaciones de escritura. (setup.sh hace lo mismo a través de la API REST en el puerto 6573.)
Paso 6: Crear el agente
Guárdalo como agent.py:
Guárdalo con el nombre agent.py:
"""Local AI agent with semantic memory: Ollama (Qwen 2.5 1.5B) + Actian VectorAI DB."""

import os

import sys

import time

import requests

from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams

OLLAMA = "http://localhost:11434"

VECTORAI = "localhost:6574"

CHAT_MODEL = "qwen2.5:1.5b"

EMBED_MODEL = "nomic-embed-text"

EMBED_DIM = 768            # nomic-embed-text output size

COLLECTION = "agent_memory"

TOP_K = 3

MIN_SCORE = 0.6            # unrelated memories score ~0.3-0.55 with nomic-embed-text, related ones 0.7+


def embed(text: str) -> list[float]:

    r = requests.post(f"{OLLAMA}/api/embed", json={"model": EMBED_MODEL, "input": text}, timeout=60)

    r.raise_for_status()

    return r.json()["embeddings"][0]


def chat(messages: list[dict]) -> str:

    # Ollama exposes an OpenAI-compatible endpoint, so any OpenAI client works here too

    r = requests.post(f"{OLLAMA}/v1/chat/completions", timeout=300,

                      json={"model": CHAT_MODEL, "messages": messages, "temperature": 0.3})

    r.raise_for_status()

    return r.json()["choices"][0]["message"]["content"]


# Tell the model what it runs on, so "what hardware is this?" gets a real answer

MODEL_FILE = "/proc/device-tree/model"

BOARD = open(MODEL_FILE).read().strip("\x00\n ") if os.path.exists(MODEL_FILE) else "unknown board"

HARDWARE = f"{BOARD}, {os.sysconf('SC_PAGE_SIZE')  os.sysconf('SC_PHYS_PAGES') / 1024*3:.0f} GB RAM"


def step(db: VectorAIClient, user_msg: str) -> str:

    # 1. Embed the incoming query on the Pi CPU

    t0 = time.perf_counter()

    qvec = embed(user_msg)

    t1 = time.perf_counter()

    # 2. Retrieve the closest past exchanges from VectorAI DB (HNSW index)

    hits = db.points.search(COLLECTION, vector=qvec, limit=TOP_K, with_payload=True)

    t2 = time.perf_counter()

    memories = [h.payload["text"] for h in hits if h.score >= MIN_SCORE]

    # 3. Inject retrieved memories into the system prompt, labelled as past notes

    #    so a small model doesn't mistake them for the current message

    context = "\n".join(f"- {m}" for m in memories) or "- (none)"

    messages = [

        {"role": "system", "content": f"You are a helpful assistant running fully offline on {HARDWARE} "

         f"with {CHAT_MODEL} via Ollama and Actian VectorAI DB for memory.\n"

         "Every message the user sends is saved to your memory automatically. If the user tells you "

         "a fact, confirm in one sentence that you will remember it.\n"

         "Answer in 1-3 sentences. Only use the notes below if they help answer the current message.\n\n"

         "Notes from earlier conversations:\n" + context},

        {"role": "user", "content": user_msg},

    ]


    # 4. Local inference through Ollama

    answer = chat(messages)

    t3 = time.perf_counter()


    # 5. Write the user's message back so future sessions can recall it. Only the user's

    #    side is stored: the facts come from the user, and storing the model's own replies

    #    would feed any wrong answer back into later prompts. The query vector is reused.

    db.points.upsert(COLLECTION, [PointStruct(

        id=time.time_ns() // 1000,  # microsecond timestamp as a unique integer ID

        vector=qvec,

        payload={"text": f"User said: {user_msg}", "ts": time.time()},

    )])

    t4 = time.perf_counter()


    print(f"
")

    return answer


def main() -> None:

    with VectorAIClient(VECTORAI) as db:

        if db.collections.exists(COLLECTION):

            # VectorAI DB keeps collections on disk but only loads them when opened;

            # without this, search and count fail after every DB restart

            db.vde.open_collection(COLLECTION)

        else:

            db.collections.create(COLLECTION, vectors_config=VectorParams(size=EMBED_DIM, distance=Distance.Cosine))

        print(f"Agent ready on {HARDWARE} | LLM: {CHAT_MODEL} | "

              f"{db.points.count(COLLECTION)} memories in VectorAI DB. Ctrl+C to quit.")

        if len(sys.argv) > 1:  # one-shot mode: python agent.py "your question"

            print(step(db, " ".join(sys.argv[1:])))

            return

        try:  # Ctrl+C quits cleanly, even mid-answer

            while True:

                user_msg = input("\nyou> ").strip()

                if user_msg:

                    print(f"agent> {step(db, user_msg)}")

        except (EOFError, KeyboardInterrupt):

            print()


if name == "__main__":

    main()
Cada turno consta de cinco fases:
Incrustar. nomic-embed-text convierte tu mensaje en un vector de 768 dimensiones en la CPU del Pi, en unos 80 ms una vez que el modelo se ha calentado. El mismo vector se reutiliza para la reescritura, por lo que cada mensaje supone una sola incrustación.
Recuperar. VectorAI DB devuelve los tres mensajes almacenados más cercanos a tu pregunta; cuanto mayor sea la puntuación de similitud, más cercano será el mensaje. El agente solo conserva aquellos con una puntuación de 0,6 o superior. En la prueba Pi, los mensajes sobre el mismo tema que la pregunta obtuvieron una puntuación de 0,7 o superior, y los que no guardaban relación obtuvieron puntuaciones entre 0,3 y 0,55, por lo que 0,6 se sitúa en el intervalo entre ambos. Cuando se formula una pregunta de cultura general con la que no hay ninguna relación en la memoria, el agente no transmite ningún recuerdo al modelo.
Inyectar. Los recuerdos se introducen en el sistema bajo la etiqueta «Notas de conversaciones anteriores». Un modelo de 1.5B necesita esa etiqueta. Sin ella, los modelos pequeños confunden las notas antiguas con el mensaje actual.
Generar. La instrucción se envía al modelo de Ollama compatible con OpenAI /v1/chat/completions punto final. Limitar las respuestas a entre una y tres frases permite que el tiempo de inferencia de la CPU sea predecible. Qwen 2.5 1.5B funcionó a una velocidad de 12,1 tokens por segundo, idéntica en las tres ejecuciones.
Almacenar. Solo se guarda tu mensaje, nunca la respuesta del modelo, por lo que una respuesta errónea no puede influir en las solicitudes posteriores. El ID es una marca de tiempo en microsegundos, lo que garantiza la unicidad de las entradas sin necesidad de un generador de ID.
Ejecútalo:
uv run agent.pyPerseverancia. La memoria se conserva tras los reinicios porque VectorAI DB escribe en ./data en el SSD. Tras reiniciar la base de datos, una colección permanece en el disco, pero no se carga hasta que la aplicación la abre, por lo que main() llamadas db.vde.open_collection(). Sin esa llamada, las operaciones de búsqueda y recuento fallan tras cada reinicio. Para comprobarlo, indica un dato al agente, sal del programa y ejecuta docker compose restart vectorai, vuelve a iniciar el agente y pregunta al respecto.
Para saber cómo los agentes almacenan, clasifican y liberan la memoria, consulta «¿Qué es la memoria de los agentes? Arquitectura y patrones de implementación».
El punto de referencia
En el Pi 5 de prueba, VectorAI DB devolvió los cinco primeros resultados de entre 100 000 vectores en 4,17 ms en el p50 y en 4,98 ms en el p99. A continuación se explica cómo reproducir este resultado.
Método
- Hardware: Raspberry Pi 5 Modelo B Rev. 1.1, 8 GB; arranca desde una tarjeta microSD; Kingston NV3 de 500 GB (SNV3SM3500G) NVMe en un Raspberry Pi M.2 HAT+ (SC1166) a PCIe Gen 3 (8,0 GT/s) con
data/yollama/; Active Cooler oficial; Raspberry Pi OS de 64 bits (Trixie), kernel 6.18.50+rpt-rpi-2712; VectorAI DB 1.0.2 con un límite de 2 GB; Ollama ejecutándose con ambos modelos cargados. - Tamaños de los corpus: 1.000, 10.000 y 100.000 vectores, cada uno en una colección nueva. En las ejecuciones de 10K y 100K se utilizó una instancia con licencia.
- Vectores: 768 dimensiones, normalizados a la unidad, distancia coseno, parámetros HNSW predeterminados de VectorAI DB.
- Consultas: 10 búsquedas de calentamiento y, a continuación, 100 búsquedas cronometradas de los 5 primeros resultados por tamaño de corpus.
Los vectores son vectores unitarios aleatorios sintéticos, no incrustaciones de texto reales. Las incrustaciones reales se agrupan por temas, lo que facilita la búsqueda a HNSW, por lo que estas cifras representan un límite conservador de lo que se observaría en un entorno de producción.
benchmark.py carga cada corpus en lotes de 500, multiplica el número de búsquedas y genera un archivo CSV en el que también se registran la placa base, la RAM, el dispositivo de almacenamiento, la temperatura final y el estado de la limitación de rendimiento:
"""Retrieval latency benchmark for VectorAI DB on Raspberry Pi 5.

Loads 1K / 10K / 100K vectors (768-dim, same size as nomic-embed-text), runs

100 timed top-k searches per corpus size, and writes p50/p95/p99 to CSV.

Vectors are synthetic (random, unit-normalized) so the 100K load finishes in

minutes instead of hours of on-device embedding. Random vectors are a harder

case for HNSW than real text embeddings, so treat these numbers as conservative.
The free Community edition caps the server at 5,000 vectors; without a licence

run it with --sizes 1000 2000 4000.


Usage: python benchmark.py [--sizes 1000 10000 100000] [--queries 100]

"""

import argparse

import csv

import platform

import statistics

import subprocess

import time

from pathlib import Path


import numpy as np

from actian_vectorai import Distance, PointStruct, VectorAIClient, VectorParams


DIM = 768

TOP_K = 5

BATCH = 500

WARMUP = 10


def hardware() -> dict:

    def read(path: str) -> str:

        try:

            return Path(path).read_text().strip("\x00\n ")

        except OSError:

            return "unknown"


    def cmd(*args: str) -> str:

        try:

            return subprocess.run(args, capture_output=True, text=True, timeout=5).stdout.strip()

        except (OSError, subprocess.SubprocessError):

            return "unknown"


    mem_kb = next((line.split()[1] for line in read("/proc/meminfo").splitlines() if line.startswith("MemTotal")), "0")

    # ask Docker where the vectorai container keeps its data, so the CSV names the drive

    # the database actually writes to (the NVMe), wherever this script was cloned

    data_dir = cmd("docker", "inspect", "-f", '{{range .Mounts}}{{if eq .Destination "/var/lib/actian-vectorai"}}'

                   '{{.Source}}{{end}}{{end}}', "vectorai") or str(Path(__file__).resolve().parent / "data")

    return {

        "board": read("/proc/device-tree/model"),

        "arch": platform.machine(),

        "kernel": platform.release(),

        "ram_gb": round(int(mem_kb) / 1024 / 1024, 1),

        "storage": cmd("findmnt", "-no", "SOURCE", "-T", data_dir) or "unknown",

        # vcgencmd prints "temp=48.3'C" / "throttled=0x0"; keep only the value

        "temp": cmd("vcgencmd", "measure_temp").split("=")[-1],

        "throttled": cmd("vcgencmd", "get_throttled").split("=")[-1],  # 0x0 means no throttling since boot

    }


def unit_vectors(n: int, rng: np.random.Generator) -> np.ndarray:

    v = rng.standard_normal((n, DIM)).astype(np.float32)

    return v / np.linalg.norm(v, axis=1, keepdims=True)


def load(db: VectorAIClient, name: str, n: int, rng: np.random.Generator) -> float:

    if db.collections.exists(name):

        db.collections.delete(name)

    db.collections.create(name, vectors_config=VectorParams(size=DIM, distance=Distance.Cosine))

    t0 = time.perf_counter()

    for start in range(0, n, BATCH):

        vecs = unit_vectors(min(BATCH, n - start), rng)

        db.points.upsert(name, [

            PointStruct(id=start + i, vector=v.tolist(), payload={"i": start + i})

            for i, v in enumerate(vecs)

        ])

    return time.perf_counter() - t0


def measure(db: VectorAIClient, name: str, queries: int, rng: np.random.Generator) -> list[float]:

    qs = unit_vectors(queries + WARMUP, rng).tolist()

    for q in qs[:WARMUP]:  # first searches load the collection into memory

        db.points.search(name, vector=q, limit=TOP_K)

    lat = []

    for q in qs[WARMUP:]:

        t0 = time.perf_counter()

        db.points.search(name, vector=q, limit=TOP_K)

        lat.append((time.perf_counter() - t0) * 1000)

    return lat


def pct(values: list[float], p: float) -> float:

    return float(np.percentile(values, p))


def main() -> None:

    ap = argparse.ArgumentParser()

    # Community edition (no licence) is capped at 5K vectors: use --sizes 1000 2000 4000

    ap.add_argument("--sizes", type=int, nargs="+", default=[1_000, 10_000, 100_000])

    ap.add_argument("--queries", type=int, default=100)

    ap.add_argument("--host", default="localhost:6574")

    ap.add_argument("--out", default="results/benchmark.csv")

    ap.add_argument("--keep", action="store_true", help="keep benchmark collections afterwards")

    args = ap.parse_args()


    hw = hardware()

    print("Hardware:", ", ".join(f"{k}={v}" for k, v in hw.items()))

    rng = np.random.default_rng(42)

    rows = []


    with VectorAIClient(args.host) as db:

        for n in args.sizes:

            name = f"bench_{n}"

            print(f"\n== {n:,} vectors ==")

            load_s = load(db, name, n, rng)

            print(f"  loaded in {load_s:.1f} s ({n / load_s:,.0f} vectors/s)")

            lat = measure(db, name, args.queries, rng)

            row = {

                "vectors": n, "dim": DIM, "top_k": TOP_K, "queries": len(lat),

                "p50_ms": round(pct(lat, 50), 2), "p95_ms": round(pct(lat, 95), 2),

                "p99_ms": round(pct(lat, 99), 2), "mean_ms": round(statistics.mean(lat), 2),

                "max_ms": round(max(lat), 2), "load_s": round(load_s, 1),

            }

            rows.append(row)

            print(f"  p50 {row['p50_ms']} ms | p95 {row['p95_ms']} ms | p99 {row['p99_ms']} ms")

            if not args.keep:

                db.collections.delete(name)


    hw_after = hardware()

    out = Path(args.out)

    out.parent.mkdir(parents=True, exist_ok=True)

    with out.open("w", newline="") as f:

        w = csv.DictWriter(f, fieldnames=list(rows[0]) + ["board", "ram_gb", "storage", "temp_end", "throttled_end"])

        w.writeheader()

        for r in rows:

            w.writerow({**r, "board": hw["board"], "ram_gb": hw["ram_gb"], "storage": hw["storage"],

                        "temp_end": hw_after["temp"], "throttled_end": hw_after["throttled"]})

    print(f"\nWrote {out}. End state: temp={hw_after['temp']}, throttled={hw_after['throttled']}")


if name == "__main__":

    main()
Ejecútalo y, a continuación, dibuja el gráfico:
uv run benchmark.py                          # licensed: 1K / 10K / 100K

uv run benchmark.py --sizes 1000 2000 4000   # Community edition

uv run plot_benchmark.py                     # writes results/benchmark.png
Resultados
| Vectores | p50 (ms) | pág. 95 (ms) | pág. 99 (manuscrito) | Tiempo de carga |
| 1,000 | 2 | 1.97 | 2.01 | 0.4 s |
| 10,000 | 3 | 3.12 | 3.47 | 28.7 s |
| 100,000 | 4 | 4.75 | 4.98 | 526 s (8,8 min) |
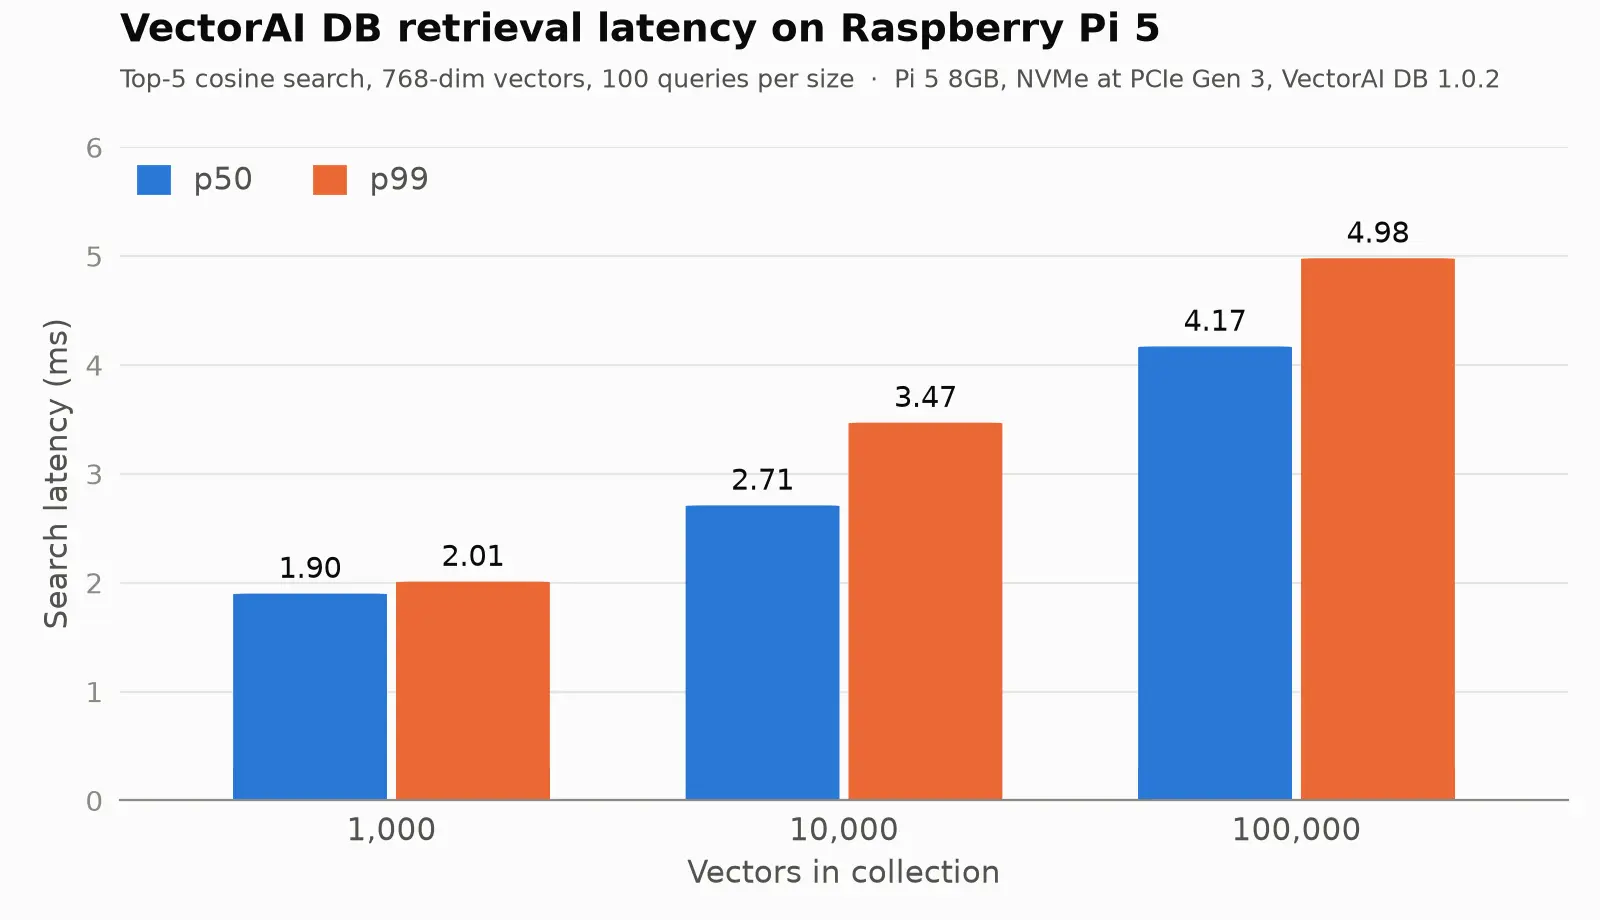
Latencia de p50 y p99 en función del tamaño del corpus (results/benchmark.png)
Descarga VectorAI DB Community Edition y ejecuta la misma prueba de rendimiento en tu propia placa.
Un corpus 100 veces mayor aumentó la latencia p50 de 1,90 a 4,17 ms, lo que supone un incremento de 2,2 veces, mientras que el p99 se mantuvo por debajo de los 5 ms. Estas cifras corresponden a una placa con PCIe Gen 3 (activado en la sección «En NVMe» anterior). La prueba de rendimiento no se realizó con Gen 2, donde los tiempos de carga, en particular, podrían ser más largos. La carga de 100 000 vectores tardó 526 segundos, a razón de unos 190 vectores por segundo, lo cual supone un coste único; el agente añade una memoria cada vez en 6 ms. El SoC pasó de 46,6 °C a 68,6 °C durante la ejecución, y vcgencmd get_throttled informado 0x0 antes y después.
Para tu agente, la recuperación no es el cuello de botella. En la demostración inicial, la búsqueda tardó 1,8 ms, la incorporación 83 ms y la inferencia 3,6 segundos. Casi todo el tiempo de espera se debe al modelo de lenguaje.
Cuando llegas al límite de Pi
Un Pi 5 ejecuta sin problemas un agente con un modelo de 1.5B. Más allá de eso, es mejor realizar la inferencia fuera de la placa.
Lo que al Pi no se le da bien:
- Configuraciones con varios agentes. Dos agentes que comparten una instancia de Qwen se turnan, por lo que el tiempo de respuesta se duplica aproximadamente.
- Modelos más grandes. Un modelo 7B con cuantificación de 4 bits necesita unos 4,5 GB solo para los pesos, lo que supera el límite de 4 GB de Ollama.
- Tareas de visión. Los modelos multimodales son más grandes y más lentos; demasiado lentos para la CPU de una Raspberry Pi como para permitir un bucle interactivo.
Aspectos que hay que tener en cuenta antes de empezar a desarrollar:
- El SDK de Python utiliza gRPC. El código del agente se comunica a través del SDK oficial de Python o JavaScript en el puerto 6574. La API REST del puerto 6573 se encarga de la configuración y la gestión de licencias.
- El límite de 2 GB está por debajo de las recomendaciones generales de Actian. La guía de instalación indica 8 GB de RAM para una implementación típica. En la Raspberry Pi de prueba, el contenedor se mantuvo muy por debajo del límite con corpus de tamaño reducido; no se midió el consumo con 100 000 vectores.
- La edición Community limita las colecciones a menos de 5.000 vectores. Cada mensaje que envías suma uno, por lo que un agente con mucho trabajo alcanza el límite en cuestión de semanas. La versión de prueba de 30 días elimina esta limitación.
- Las preguntas también se almacenan. El agente guarda todos los mensajes, incluidas las preguntas. Con el paso de los meses, una pregunta anterior puede tener prioridad sobre el dato que necesitas para una de las tres ranuras de recuperación. En el caso de un agente de larga duración, almacena solo afirmaciones, o bien etiqueta los mensajes y filtra al recuperarlos.
Cuándo pasar a Jetson Orin. Para implementaciones en producción con varias cámaras, más de 7 mil millones de modelos o varios agentes simultáneos, un Jetson Orin aporta una GPU y más memoria en un espacio similar en el borde. VectorAI DB se ejecuta allí con la misma imagen y API arm64, por lo que el código de tu agente no cambia.
Utiliza la Pi como nodo de recuperación. Utiliza la Pi como nodo de recuperación. Mantén la base de datos de VectorAI en la Pi y envía las llamadas al modelo a un equipo más potente de tu red cambiando una constante en agent.py:
OLLAMA = "http://192.168.1.50:11434" # inference box on your LANDe este modo, tanto la incrustación como la inferencia se trasladan a esa máquina. En ella, inicia Ollama con OLLAMA_HOST=0.0.0.0 De este modo, acepta conexiones desde la Pi y descarga ambos modelos allí. El almacenamiento y la recuperación se realizan en el dispositivo cercano a tus sensores, y nada sale de tu red.
Conclusión
El agente creado en este tutorial hace algo que la mayoría de las configuraciones locales de LLM no hacen. Cuando respondió a la pregunta sobre el invernadero en la demostración inicial, ambos datos procedían de una sesión que había finalizado y cuya base de datos se había reiniciado entre ambas ejecuciones. La recuperación tardó 1,8 milisegundos.
Ese resultado se debe a la combinación de tres decisiones: ejecutar los modelos de forma local para que nada salga del entorno, almacenar la memoria en forma de vectores para que la recuperación sea semántica en lugar de por coincidencia exacta, y utilizar VectorAI DB como capa de memoria para que el almacenamiento se mantenga tras los reinicios y se pueda ampliar hasta 100 000 entradas sin necesidad de modificar el código.
La misma imagen arm64 y la misma API se ejecutan tanto en un Jetson Orin como en un servidor local. Tu agent.py no cambia cuando te mudas allí. La única línea que cambia es OLLAMA, si quieres trasladar la inferencia del Pi a un equipo más potente de tu red local. Regístrate en VectorAI DB Community Edition, lee el Guía de instalación de Docker, y únete a la Comunidad de Actian en Discord para ver qué están creando otros usuarios con el hardware Edge.
Preguntas frecuentes
¿Puede una Raspberry Pi 5 ejecutar un agente de IA completo de forma local?
Sí. Una Raspberry Pi 5 con 8 GB de RAM ejecuta un agente completo sin conexión a la nube. Ollama ejecuta Qwen 2.5 1.5B en la CPU, nomic-embed-text convierte los mensajes en vectores, y VectorAI DB almacena la memoria a largo plazo. En la placa de pruebas, el agente recuperó los recuerdos relevantes en 1,8 ms y respondió en 3,6 segundos; Qwen funciona a una velocidad de 12,1 tokens por segundo en esta placa. Utiliza almacenamiento NVMe, refrigeración activa y la fuente de alimentación oficial de 27 W para mantener un rendimiento estable bajo una carga sostenida.
¿Qué base de datos vectorial funciona mejor en una Raspberry Pi?
Para esta implementación, la base de datos Actian VectorAI es una opción muy adecuada. Es compatible con arm64, almacena los datos en disco y utiliza HNSW para la búsqueda aproximada del vecino más cercano. En la Raspberry Pi 5, devolvió los cinco primeros resultados de entre 100 000 vectores en 4,12 ms (p50) con un límite de memoria de 2 GB. Su almacenamiento local también permite que la memoria del agente se mantenga tras los reinicios de la base de datos.
¿Es compatible VectorAI DB con el hardware ARM?
Sí. El sitio web oficial actian/vectorai La imagen de Docker está disponible tanto para amd64 como para arm64, así que docker pull actian/vectorai:1.0.2 ofrece una compilación nativa en una Pi 5, un NVIDIA Jetson o un Mac con Apple Silicon, sin necesidad de emulación. Los mismos SDK y API de Python y JavaScript funcionan en todas las plataformas, por lo que el código que escribas en un portátil se ejecuta sin modificaciones en el hardware periférico.
Mantente conectado
Te ofrecemos información detallada sobre los datos.
(por ejemplo, sales@..., support@...)
