
Phi-4-Mini, Gemma 4 y Qwen3: el mejor modelo de lenguaje grande (LLM) para la Raspberry Pi 5


Resumen
- Phi-4-Mini, Gemma 4 y Qwen3 se adaptan cada uno a diferentes cargas de trabajo de IA en el borde en función del hardware, la latencia y las necesidades de la aplicación.
- Gemma 4 destaca especialmente en aplicaciones multimodales, mientras que Phi-4-Mini se centra en el razonamiento y la generación de código.
- Qwen3 destaca por sus agentes de IA de producción que requieren una ejecución fiable de herramientas y una amplia compatibilidad multilingüe.
- El hardware influye considerablemente en el rendimiento: Raspberry Pi se decanta por los modelos más pequeños, mientras que Jetson ofrece opciones más potentes aceleradas por GPU.
- La selección del modelo es solo una parte de la implementación en el borde; la cuantificación y la arquitectura de recuperación también determinan el rendimiento general.
La IA local ha madurado hasta tal punto que una Raspberry Pi 5 puede ejecutar modelos de lenguaje potentes. Phi-4-Mini, Gemma 4 y Qwen3 presentan diferencias en cuanto a razonamiento, ejecución de herramientas, compatibilidad multimodal y eficiencia del hardware. Tu elección dependerá del hardware que tengas previsto implementar, la latencia que puedas tolerar y las cargas de trabajo que vaya a gestionar tu agente de IA.
Este artículo está dirigido a ingenieros de plataformas e ingenieros de IA que implementan modelos de lenguaje grandes (LLM) locales en Raspberry Pi 5, Jetson Orin Nano y dispositivos similares con limitaciones de memoria. En él podrás comparar el rendimiento confirmado, los requisitos de memoria y la compatibilidad de hardware, en lugar de basarte únicamente en los resultados de las pruebas de rendimiento. Si tiene previsto ejecutar modelos como Gemma con una base de datos vectorial local, como Actian VectorAI DB, en una Raspberry Pi 5, comprender las ventajas e inconvenientes de estos modelos le ayudará a elegir una configuración que se adapte a su hardware y a su carga de trabajo.
En este artículo, compararás estos modelos disponibles en los distintos niveles de hardware que resultan relevantes para la implementación en el borde.
Niveles de hardware
Antes de comparar modelos, determina a qué nivel de hardware te diriges. Un mismo modelo puede ofrecer un rendimiento muy diferente en función de los recursos disponibles, como la memoria, la potencia de cálculo y la refrigeración. Todas las cifras de rendimiento que aparecen en este artículo se basan en una clase de implementación específica, por lo que comparar cifras entre distintos dispositivos sin tener en cuenta ese contexto puede llevar a elegir un modelo inadecuado.
La Raspberry Pi 5 con 8 GB de RAM representa el nivel con mayores limitaciones. Toda la inferencia se ejecuta en la CPU, lo que hace que la presión sobre la memoria sea la principal limitación. Una investigación realizada por Build Fast with AI muestra que, en una Raspberry Pi 5, Gemma 4 E2B ofrece aproximadamente 7,6 tok/s. Con cuantificación Q4_K_M, Gemma 4 E4B funciona a una velocidad de entre 2 y 5 tok/s aproximadamente, ya que depende en gran medida de la memoria de intercambio. En las mismas condiciones, Qwen2.5-3B alcanza aproximadamente 8,2 tok/s de decodificación y Qwen3-4B alcanza entre 5 y 7 tok/s aproximadamente.
El Jetson Orin Nano se sitúa en una categoría de rendimiento diferente. Viene equipado con 8 GB de memoria, un acelerador de IA de 67 TOPS e inferencia acelerada por GPU. Los modelos que presentan dificultades en hardware que solo cuenta con CPU ofrecen una respuesta mucho mejor, dependiendo del modelo y del nivel de cuantificación. En el nivel más alto, los servidores y sistemas periféricos, como el Mac Mini M4 con entre 16 y 32 GB de memoria unificada, ofrecen margen suficiente para ventanas de contexto más amplias, una cuantificación de mayor precisión y múltiples cargas de trabajo de inferencia simultáneas.
| Nivel de hardware | Memoria | Rendimiento aproximado en Q4_K_M |
| Raspberry Pi 5 | 8 GB | De 2 a 8,2 tok/s (dependiendo del modelo) |
| Jetson Orin Nano | 8 GB, 67 TOPS | Hasta 25,5 tok/s (dependiendo del modelo) |
| Servidor periférico / Mac Mini M4 | De 16 a 32 GB de memoria unificada | Sin verificar |
Niveles de hardware para la implementación local de modelos de lenguaje grandes (LLM)
Perfiles de modelos
Gemma 4 E2B y E4B
Gemma 4 E2B y E4B utilizan una arquitectura densa con incrustaciones por capa (PLE). En lugar de añadir más capas al modelo, la PLE proporciona a cada capa del decodificador su propia incrustación pequeña para cada token. El modelo «Mixture of Experts» (MoE) de la familia Gemma 4 es la variante independiente de 26 mil millones.
Gemma 4 E2B tiene 2.300 millones de parámetros efectivos y 5.100 millones de parámetros totales. E4B aumenta estas cifras a 4.500 millones de parámetros efectivos y 8.000 millones de parámetros totales. Ambos modelos utilizan la licencia Apache 2.0 y ofrecen una ventana de contexto de 128K.
En la Raspberry Pi 5, Gemma 4 E2B alcanza aproximadamente 7,6 tok/s, lo que lo hace adecuado para la inferencia interactiva en CPU en un sistema de 8 GB. Gemma 4 E4B también funciona a una velocidad de entre 2 y 5 tok/s aproximadamente, ya que depende en gran medida de la memoria de intercambio. En Jetson Orin Nano con aceleración por GPU, Gemma 4 E2B alcanza aproximadamente 25,5 tok/s, con una ventana de contexto de 8k, lo que hace que el modelo más grande resulte mucho más práctico en hardware periférico equipado con GPU. Gemma 4 E4B alcanza aproximadamente entre 11 y 14 tok/s.
Gemma 4 también admite la entrada multimodal nativa. Acepta entradas de texto, imagen, audio y vídeo, y admite la llamada a funciones nativas mediante tokens especiales específicos. Estas capacidades reducen la cantidad de coordinación necesaria a la hora de desarrollar aplicaciones de IA multimodal en el borde.
Phi-4-Mini
Phi-4-Mini es un modelo de 3.8 mil millones de parámetros publicado bajo la licencia MIT. Se distingue por su rendimiento en el razonamiento, más que por su capacidad multimodal o el uso de herramientas. En las pruebas de referencia estándar de razonamiento, obtiene una puntuación del 88,6 % en GSM8K y del 83,7 % en ARC-C.
Las pruebas controladas realizadas en dispositivos móviles (iPhone 14 Pro, Pixel 8 y dispositivos Android de gama media) muestran que Phi-4-Mini ofrece un rendimiento aproximadamente entre un 15 % y un 20 % superior al de Qwen3-4B. Además, Phi-4-Mini funciona a una velocidad de entre 5 y 8 tok/s aproximadamente en una Raspberry Pi 5.
Otra diferencia se aprecia cuando los agentes se someten a cargas de trabajo prolongadas. Phi-4-Mini genera trazas de la cadena de pensamiento más claras durante el razonamiento de varios pasos, lo que lo hace muy adecuado para tareas de planificación y razonamiento. Sin embargo, su precisión a la hora de invocar herramientas es inferior a la de Qwen3 tal y como viene de fábrica, por lo que los flujos de trabajo que dependen en gran medida de llamadas a funciones estructuradas pueden requerir un ajuste adicional de las instrucciones.
Qwen3 (variantes 4B)
Las variantes de Qwen3-4B están dirigidas a desarrolladores que crean agentes de IA para producción y que necesitan una integración fiable de herramientas. Los modelos utilizan la licencia Apache 2.0 y admiten más de 100 idiomas, según la ficha oficial del modelo Qwen3-4B.
Según las pruebas de rendimiento disponibles para la Raspberry Pi 5, Qwen3-4B ofrece entre 5 y 7 tok/s aproximadamente en un sistema de 8 GB con cuantificación Q4. Qwen3 destaca por la precisión de sus llamadas a herramientas desde el primer momento. Requiere menos trabajo de ingeniería inicial que Phi-4-Mini para flujos de trabajo que invocan API, bases de datos o servicios locales, lo que lo convierte en una opción muy recomendable para agentes de IA que dependen de llamadas a funciones estructuradas.
| Modelo | Parámetros activos | Raspberry Pi 5 (tok/s) | Jetson Orin Nano (tok/s) | Licencia | Precisión en la selección de herramientas | Apoyo multimodal |
| Gemma 4 E2B | 2.3B efectivos (5.1B en total) | ~7.6 | 25,5 (con 8 000 fichas) | Apache 2.0 | Nativo | Texto, imagen, audio, vídeo |
| Gemma 4 E4B | 4.5B efectivos (8B en total) | ~de 2 a 5 | ~ de 11 a 14 | Apache 2.0 | Nativo | Texto, imagen, audio, vídeo |
| Phi-4-Mini | 3.8B | ~ de 5 a 8 | Sin verificar | MIT | Estándar | Solo texto (la opción multimodal requiere Phi-4 como base) |
| Qwen3-4B | 4B | ~5 a 7 | Sin verificar | Apache 2.0 | Máxima precisión | Texto, imagen |
Especificaciones de los modelos, rendimiento y capacidades por plataforma
¿Qué modelo para cada situación?
Si vas a realizar la implementación en una Raspberry Pi 5 con 8 GB de RAM, elige tu modelo con prudencia. La memoria es el recurso limitante, y el rendimiento determina si tu aplicación resulta interactiva. Gemma 4 E2B es una opción práctica, con aproximadamente 7,6 tok/s, a la vez que te ofrece entrada multimodal nativa y llamada a funciones. Qwen3-4B ofrece entre 5 y 7 tok/s aproximadamente, pero destaca por su gran precisión en la llamada a herramientas desde el primer momento y es compatible con más de 100 idiomas. Gemma 4 E4B funciona técnicamente en este hardware, pero su dependencia de la memoria de intercambio reduce el rendimiento a entre 2 y 5 tok/s aproximadamente, por lo que resulta difícil recomendarlo para cargas de trabajo interactivas.
Jetson Orin Nano cambia las relaciones de compensación. La aceleración por GPU elimina muchas de las limitaciones de memoria y computación que afectan a la Raspberry Pi 5. Gemma 4 E4B se convierte en una opción viable, alcanzando aproximadamente entre 11 y 14 tok/s al tiempo que conserva sus capacidades multimodales nativas, la llamada a funciones y la ventana de contexto de 128K. Si tu aplicación depende del uso de herramientas, Qwen3 también sigue siendo una opción sólida, aunque aún no se dispone de cifras verificadas sobre el rendimiento de Jetson. Phi-4-Mini es una opción sólida para agentes que requieren un razonamiento intensivo, pero debes verificar el rendimiento en tu hardware de destino antes de dar el paso a la producción.
En servidores periféricos o sistemas como el Mac Mini M4, con entre 16 y 32 GB de memoria unificada, la elección del modelo viene determinada por la carga de trabajo, más que por el hardware. Elige Phi-4-Mini para el razonamiento y la generación de código, Gemma 4 E4B para aplicaciones de IA multimodal y Qwen3 cuando la fiabilidad en la ejecución de herramientas y la compatibilidad multilingüe sean las principales prioridades. En este nivel de hardware, no hay un único ganador, ya que cada modelo optimiza una capacidad diferente.
La cuantificación tiene tanto impacto en la implementación como la selección del modelo. Para la mayoría de los dispositivos periféricos, Q4_K_M ofrece el mejor equilibrio entre uso de memoria, rendimiento y calidad. Conserva aproximadamente entre el 97 % y el 99 % de la calidad de FP16, al tiempo que reduce los requisitos de memoria y mejora la velocidad de inferencia. Si tu carga de trabajo implica razonamientos sensibles a la precisión o la generación de código, y tu hardware dispone de memoria suficiente, suele merecer la pena probar Q5_K_M o Q8_0.
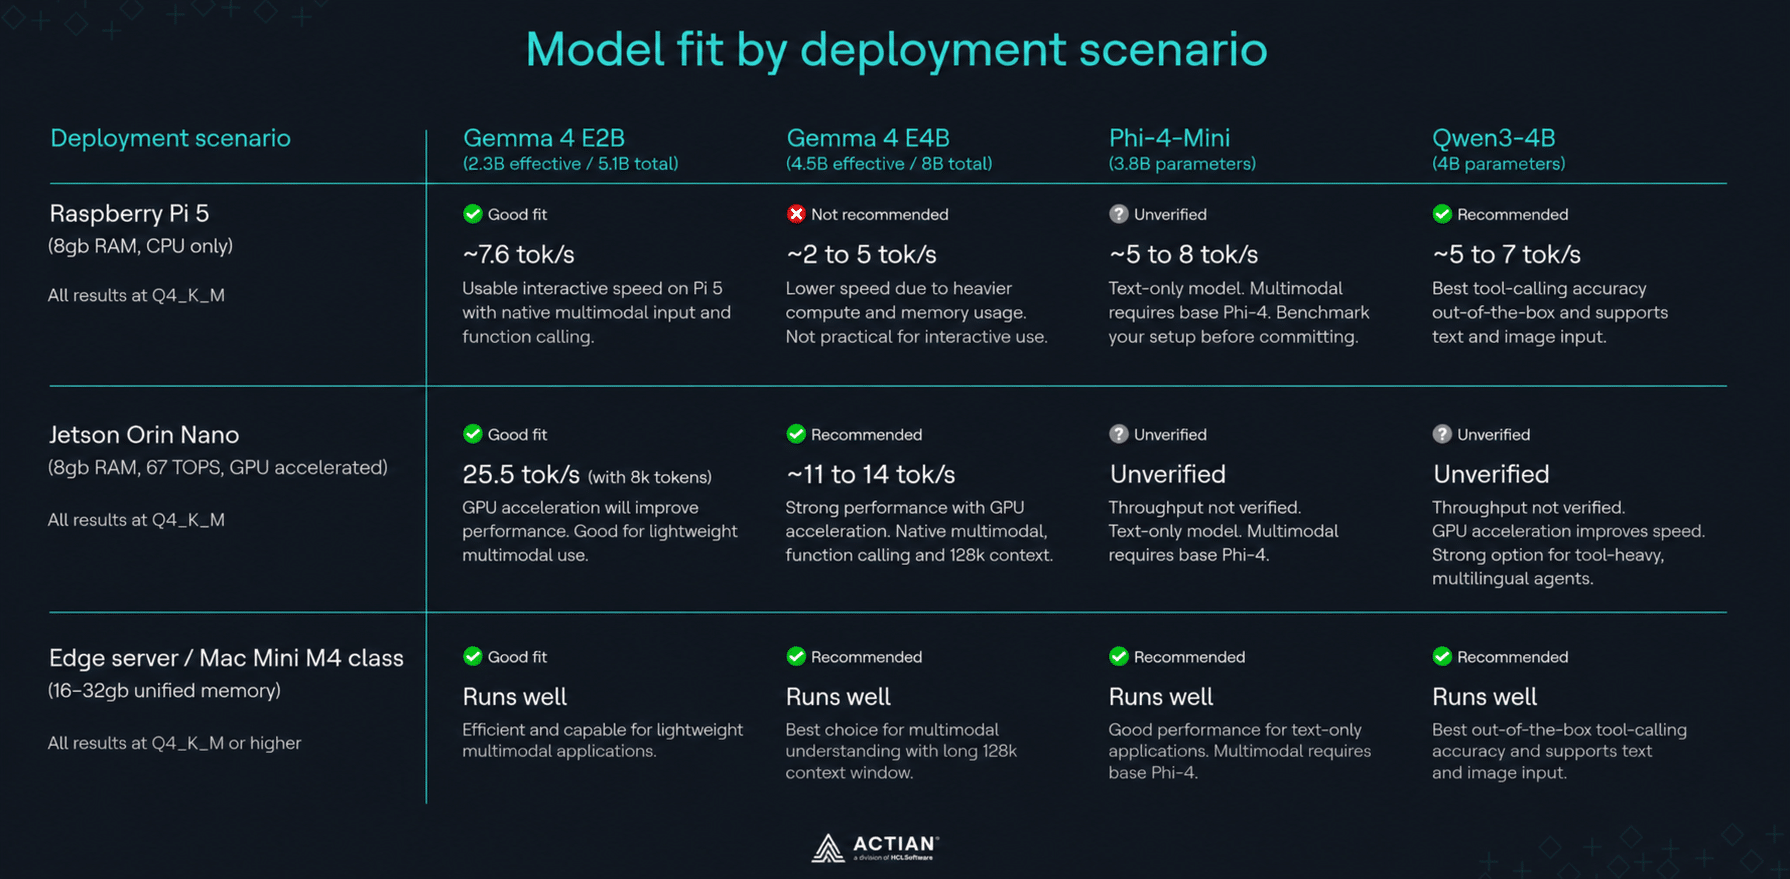
Ajuste del modelo según el escenario de implementación
Lo que omite la comparación
Elegir el modelo adecuado es solo el primer paso para crear un agente de IA en el dispositivo. Una vez seleccionados el modelo y el nivel de cuantificación que se adapten a tu hardware, la siguiente decisión es cómo recuperará y memorizará la información tu agente. Aquí es donde la capa de recuperación cobra tanta importancia como la capa de inferencia.
La generación aumentada por recuperación (RAG) combina un modelo de inferencia con un almacén de vectores que recupera información relevante antes de la generación. Se trata de componentes independientes con distintos requisitos de recursos. Un modelo que se ajuste perfectamente a tu presupuesto de hardware puede seguir ofreciendo un rendimiento deficiente si la capa de recuperación consume demasiada memoria o almacenamiento.
En esta fase, dispones de tres opciones de implementación:
- Recuperación en memoria. Las representaciones permanecen en la RAM, lo que garantiza la menor latencia de recuperación. Sin embargo, todos los datos indexados se pierden al reiniciar la aplicación.
- Base de datos vectorial integrada basada en el sistema de archivos. Las representaciones se almacenan en disco, lo que garantiza la persistencia sin necesidad de un servidor independiente. Esta opción resulta muy adecuada para dispositivos periféricos con recursos limitados.
- Base de datos vectorial local dedicada. Una base de datos local gestiona la indexación, el filtrado y la recuperación a escala de producción, junto con el proceso de inferencia. Este enfoque admite conjuntos de datos más grandes y cargas de trabajo de recuperación más avanzadas, pero requiere recursos del sistema adicionales.
La elección adecuada depende del tamaño de tu base de conocimientos, de tus requisitos de latencia y de los recursos de hardware disponibles tras la inferencia del modelo.
Conclusión
Phi-4-Mini, Gemma 4 y Qwen3 han establecido cada uno un papel específico en las implementaciones de IA en el borde. Gemma 4 es la mejor opción cuando tu aplicación depende de entradas multimodales nativas y ventanas de contexto largas. Phi-4-Mini da prioridad a la calidad del razonamiento y al rendimiento para cargas de trabajo de planificación y generación de código. Qwen3 destaca para agentes de IA en producción que requieren una invocación fiable de herramientas y una amplia compatibilidad multilingüe. En lugar de buscar un único ganador, adapta el modelo a tu hardware, al objetivo de latencia y a la carga de trabajo.
El hardware es tan importante como la selección del modelo. Una Raspberry Pi 5 con 8 GB de RAM se adapta mejor a modelos más pequeños y cuantificados de forma eficiente, mientras que la Jetson Orin Nano permite utilizar modelos más grandes, como el Gemma 4 E4B, gracias a la aceleración por GPU. En servidores y sistemas periféricos con entre 16 y 32 GB de memoria unificada, el factor decisivo es la carga de trabajo, y no las limitaciones del hardware. En todos los casos, el nivel de cuantificación y la arquitectura de recuperación determinan el rendimiento de la aplicación.
Empieza hoy mismo a utilizar Actian VectorAI DB Community Edition. Consulta la documentación y únete a la comunidad de Discord para obtener ayuda y participar en los debates.
Preguntas frecuentes (FAQ)
¿Puedo ejecutar todos los modelos en una Raspberry Pi 5 con 8 GB de RAM?
Sí, pero la experiencia varía considerablemente. Gemma 4 E2B funciona a aproximadamente 7,6 tok/s y es adecuado para un uso interactivo. Gemma 4 E4B también funciona, pero el uso intensivo de la memoria de intercambio reduce el rendimiento a entre 2 y 5 tok/s aproximadamente, lo que lo hace lento para cargas de trabajo conversacionales. Qwen3-4B alcanza entre 5 y 7 tok/s aproximadamente, lo que resulta viable para un uso interactivo y ofrece la mayor precisión en la selección de herramientas de los tres. Phi-4-Mini alcanza entre 5 y 8 tok/s aproximadamente.
¿Y si necesito tanto soporte multilingüe como la posibilidad de llamar a funciones?
Elige Qwen3. Ofrece la mayor precisión en la llamada a herramientas desde el primer momento y es compatible con más de 100 idiomas. Gemma 4 incluye la llamada a funciones nativas, pero no alcanza las capacidades multilingües de Qwen3. Phi-4-Mini da prioridad al razonamiento frente al uso de herramientas.
¿Es Q4_K_M lo suficientemente bueno para la producción?
En la mayoría de las implementaciones en el borde, sí. Q4_K_M conserva aproximadamente entre el 97 % y el 99 % de la calidad de FP16, al tiempo que reduce el uso de memoria y multiplica por dos o por tres el rendimiento. Cambia a Q5_K_M o Q8_0 para cargas de trabajo en las que la precisión es fundamental, como la generación de código o el razonamiento complejo, siempre que tu hardware disponga de memoria suficiente.
Problemas habituales
El modelo supera la memoria RAM disponible en el cuarto trimestre
Elige una variante del modelo más pequeña si tu prioridad es la calidad. Si tienes que mantener el mismo modelo, utiliza un nivel de cuantificación más agresivo, como Q3_K_M, pero ten en cuenta que la calidad del razonamiento se verá más afectada.
Artefactos de cuantificación en los resultados del razonamiento
Utiliza Q5_0 o Q8_0 para el razonamiento y la generación de código si la memoria lo permite. Q4_K_M es la mejor opción para la inferencia de uso general, en la que el rendimiento y la eficiencia de la memoria son más importantes que la máxima precisión.
Las llamadas a las herramientas son lentas o están mal formadas
Comprueba que tu solicitud siga el formato de invocación de herramientas previsto por el modelo. Si la fiabilidad es fundamental, elige Qwen3, que ofrece el mejor rendimiento de invocación de herramientas «listo para usar» de los tres modelos.
Mantente conectado
Te ofrecemos información detallada sobre los datos.
(por ejemplo, sales@..., support@...)
