Implemente agentes de IA con memoria persistente. Envíelos donde sea.

Qué crean los desarrolladores con VectorAI DB
Trace
Búsqueda semántica para casos de desaparecidos. Salva la brecha léxica entre las familias y los registros forenses, íntegramente en el dispositivo.

Revvec
Canalización RAG con aislamiento físico para sectores de defensa, aeroespacial y farmacéutico. Funciona en un único Mac y no exige Internet.
FixFirst
Copiloto de mantenimiento offline para técnicos industriales. Busque manuales e historial de incidencias por código de error, foto o nota de voz.


La mayoría de las bases de datos vectoriales se crearon para patrones humanos de consulta. Los agentes de IA son diferentes.
/

Unas cifras que aguantan la presión
QPS
745,2 QPS en 10 millones de vectores con 768 dimensiones. 22 veces más rápido que Milvus y Qdrant.
de precisión de recuperación
de latencia p99
13 ms en p99 con 99 % de recuperación en el hardware autohospedado donde se ejecutan sus agentes.
Qué obtendrá

Una memoria preservada tras cada sesión
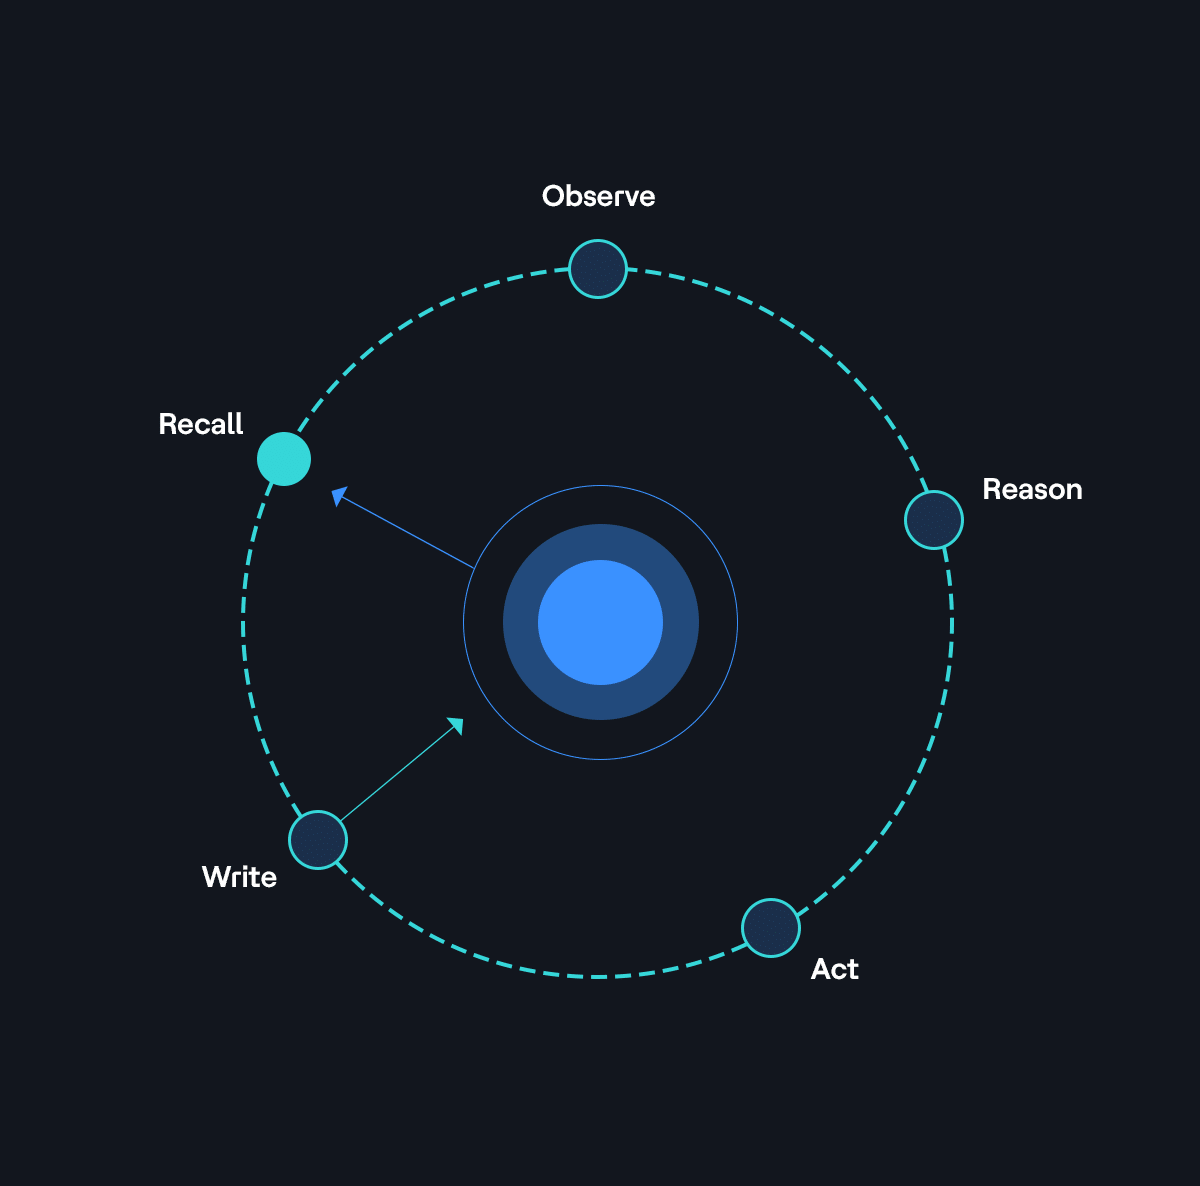
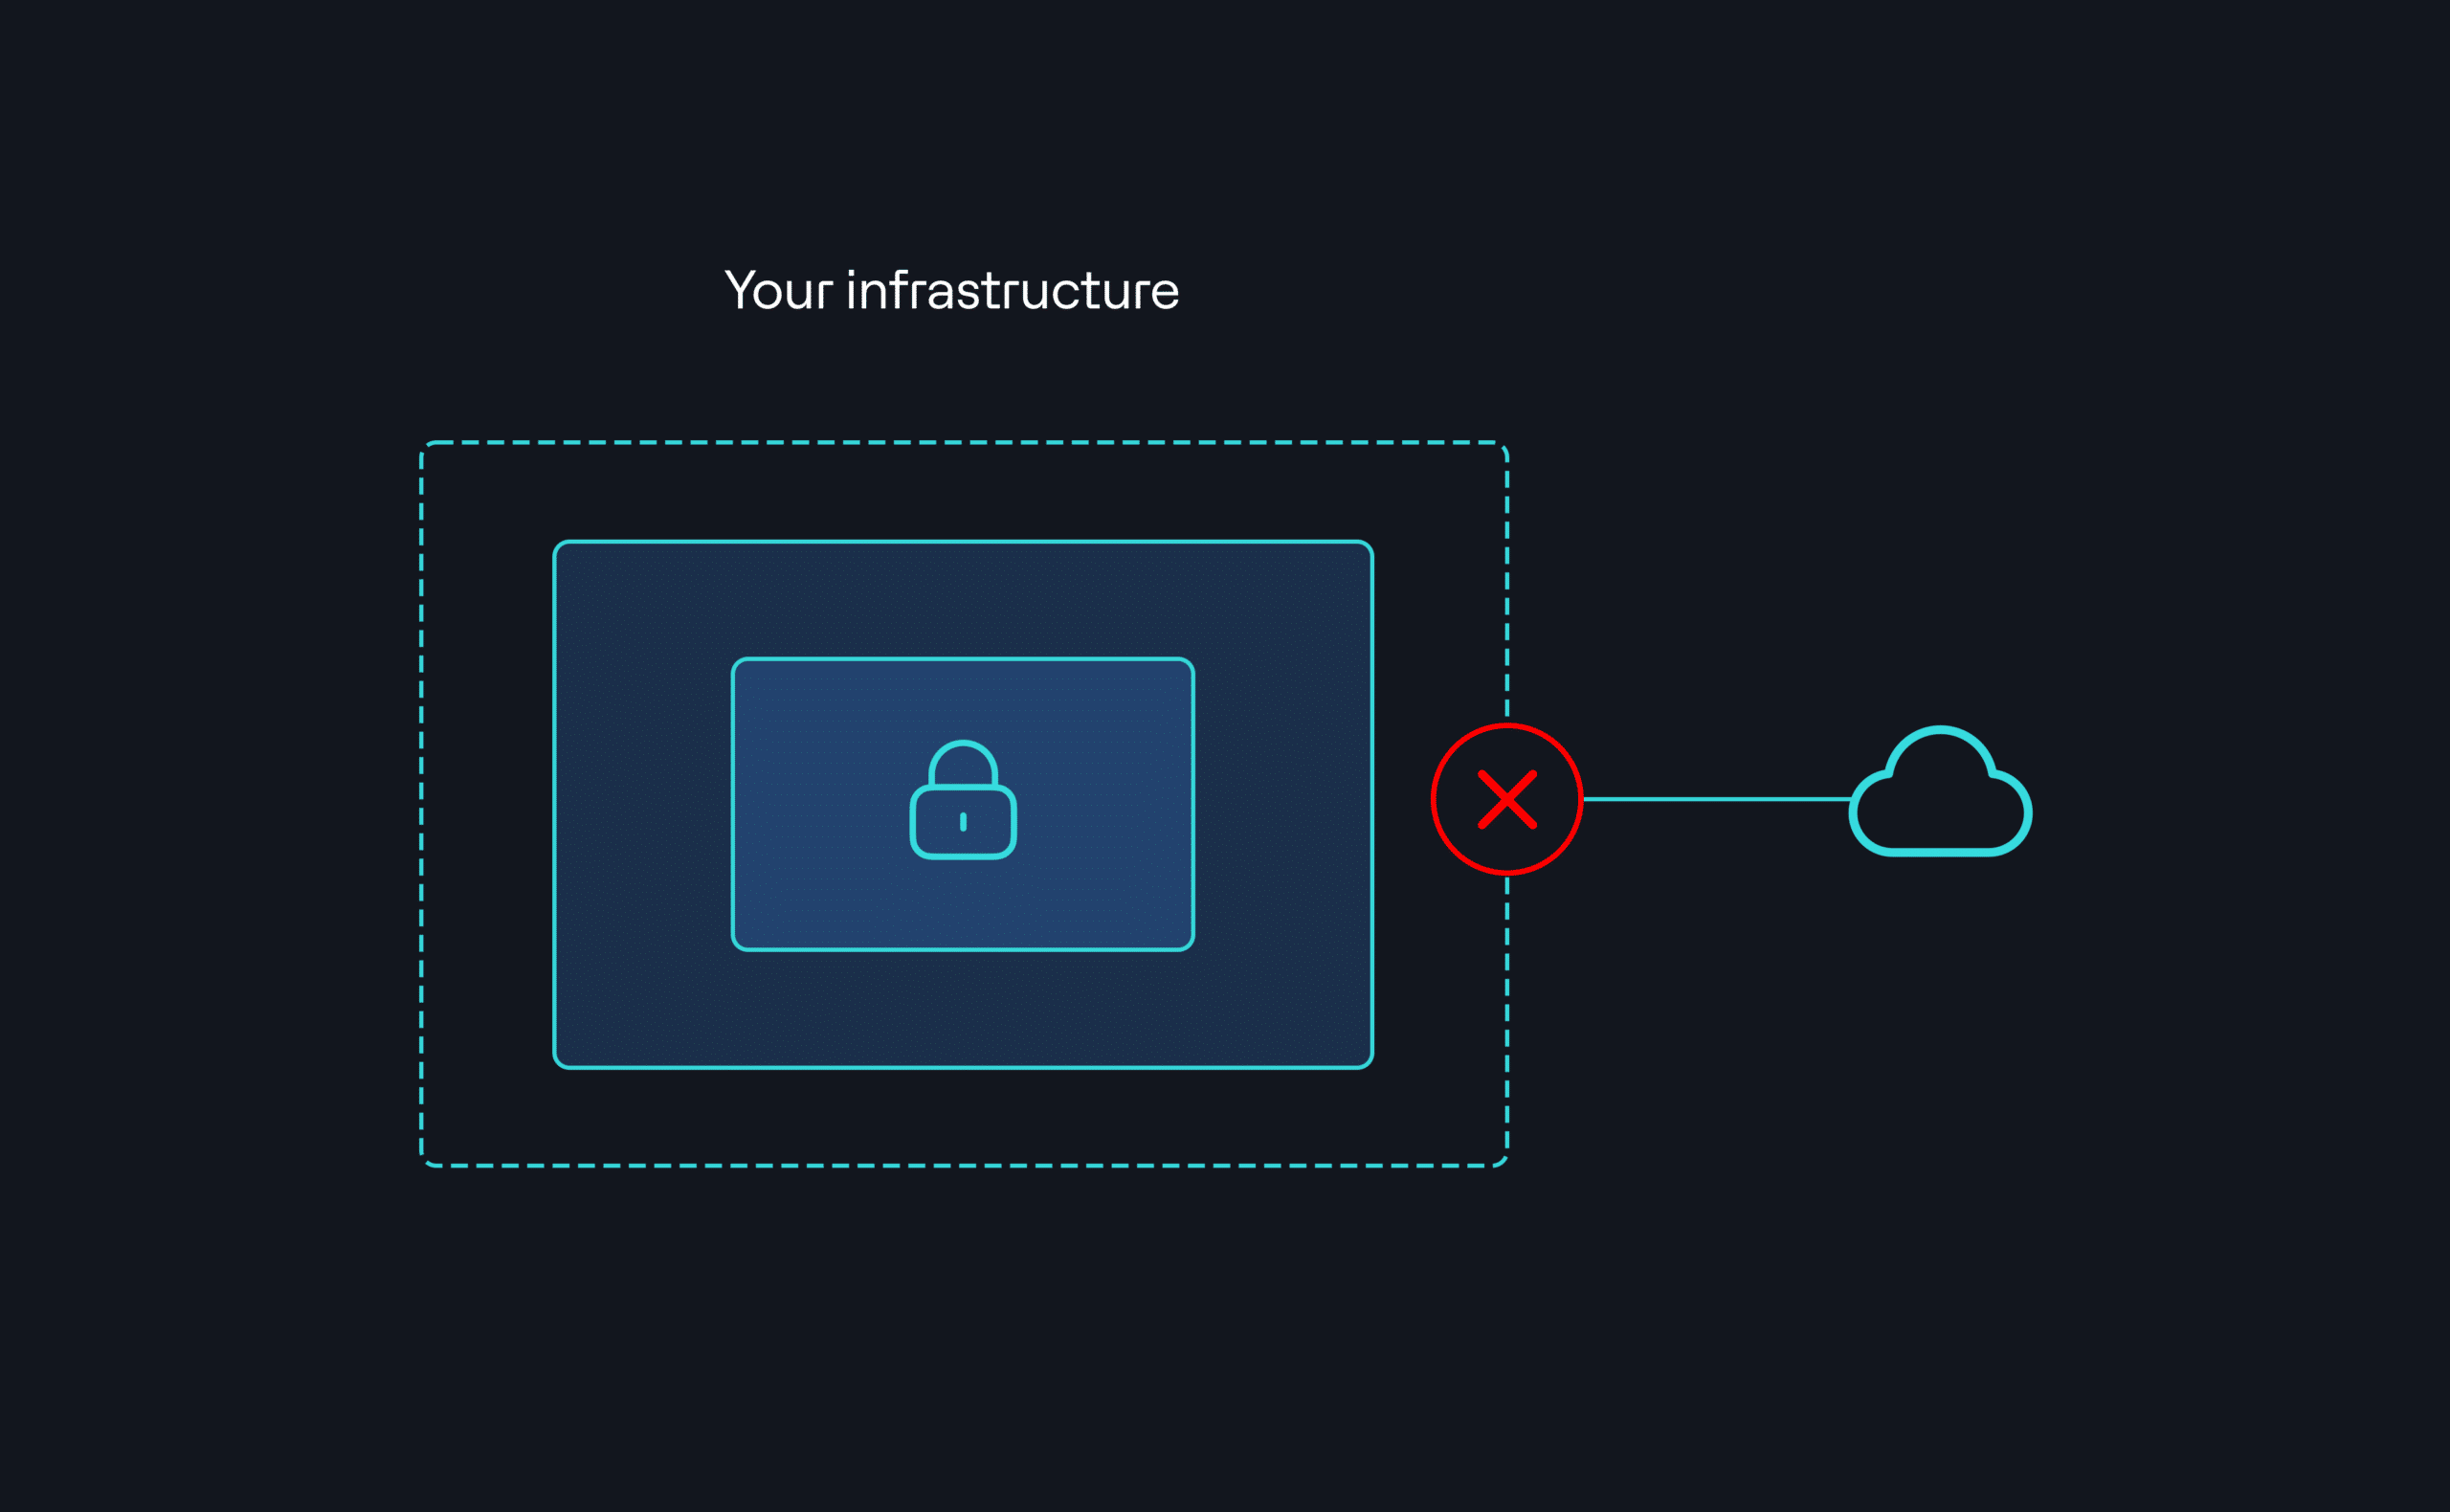
Los agentes recuerdan el contexto de una sesión a otra, a cualquier escala, dentro de su perímetro.

Supervíselo desde las herramientas que ya usa
Métricas nativas de Prometheus en sus paneles de control Grafana actuales.

Consultas paralelas sin ralentización
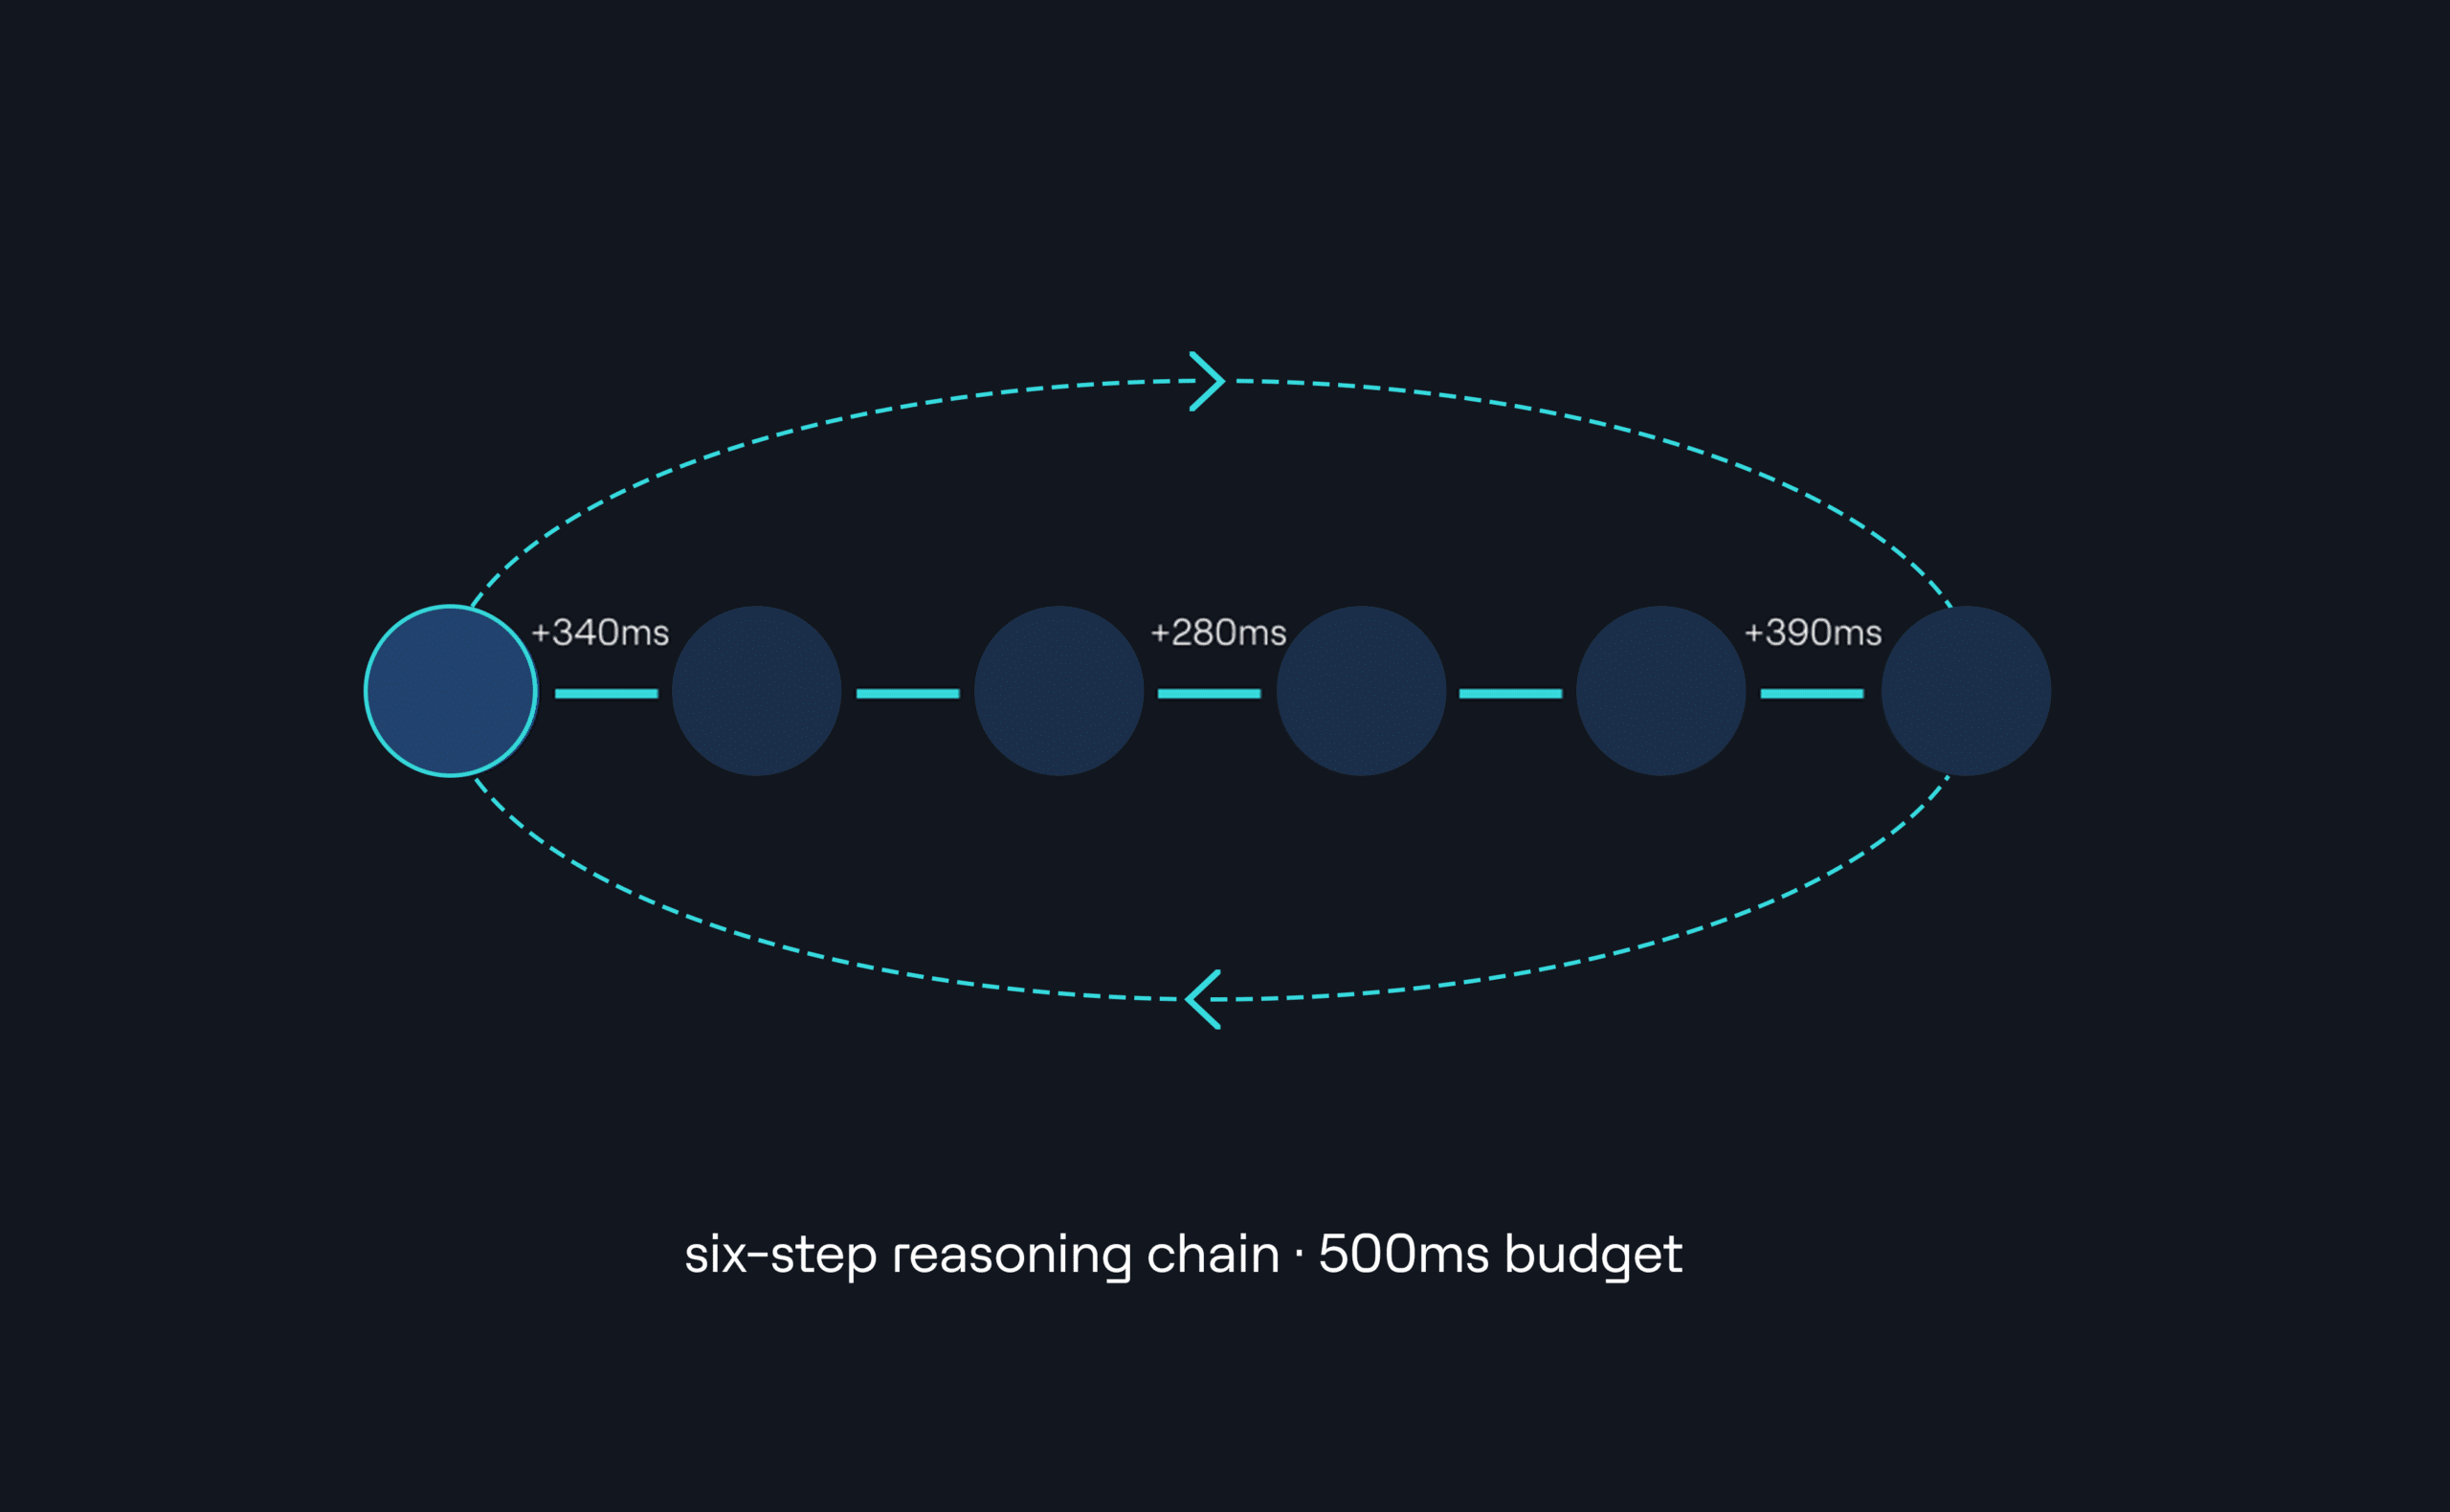
Pasos de razonamiento y consultas de memoria en paralelo, con una recuperación intacta.

Envíe el mismo build a todas partes
Desde un laptop a un centro de datos sin reescribir nada, en cualquier hardware.

Supere la revisión sin rediseñar la arquitectura
Se cumplen RGPD, HIPAA y requisitos de residencia por el lugar donde se alojan los datos.

Adapte el índice al hardware que tiene
Elija HNSW o IVF, agregue la cuantización y ajuste el tamaño del índice a la memoria disponible.
Vea cómo funciona VectorAI DB
Observe una implementación entera de agente, del inicio a la primera consulta.
Empiece a usar su framework
Añádalo a la pila en la que ya trabaja.
Use directamente el SDK de Python de VectorAI DB en cualquier pila personalizada de agentes. Usted aporta el modelo de incrustación; VectorAI DB se ocupa del almacenamiento y búsqueda.
# Install
pip install actian-vectorai

from actian_vectorai import VectorAIClient

client = VectorAIClient(host="localhost:8080")
client.create_collection("agent-memory", dim=768)

results = client.query(
  collection="agent-memory",
  vector=embeddings,
  top_k=10
)
Ejecútelo sin importar cómo lo envíe
SDK de Python y JavaScript, una API REST y un único contenedor Docker que se ejecuta igual en un laptop, un box de borde o un clúster de Kubernetes.



Comparativa de VectorAI DB
Un análisis sincero del entorno de ejecución y rendimiento de cada base de datos vectorial. El rendimiento se ha medido con 10 millones de vectores en 768 dimensiones, usando un hardware idéntico.
VectorAI DB |
Pinecone |
Qdrant |
Weaviate |
|
|---|---|---|---|---|
Rendimiento con 10 millones de vectores |
745 QPS |
~33 QPS |
~34 QPS |
Varía con alojamiento propio |
Funciona en hardware de borde con recursos limitados (Jetson, Pi) |
Sí |
No |
Limitado |
Limitado |
La misma API del prototipo a la producción |
Sí |
Solo en la nube |
Sí |
Sí |
Implementación local y con aislamiento físico |
Sí |
No |
Sí |
Sí |
Opción de nube totalmente gestionada |
Autogestionado |
Sí |
Nube |
Nube |
¿Quién desarrolla con VectorAI DB?
Equipos que implementan aplicaciones donde residen los datos y no siempre hay red disponible.
Los datos de los pacientes siguen en su perímetro en todas las consultas.
Implementación en: centros de datos de hospitales, servidores de clínicas, investigación
Consistente en infraestructuras híbridas, de borde y con múltiples sedes, sin importar las limitaciones de conectividad, cumplimiento o hardware.
Implementación en: entorno híbrido, borde + nube, múltiples sedes
Preguntas frecuentes
VectorAI DB de Actian es una base de datos vectorial creada para agentes de IA, que les da memoria persistente y una recuperación de baja latencia en su propia infraestructura.
La mayoría de las bases de datos vectoriales se crearon para implementaciones nativas en la nube y patrones de consulta a escala humana. VectorAI DB se ha concebido para el comportamiento simultáneo y de alta frecuencia de las flotas de agentes y funciona de forma consistente en entornos de borde, locales, con aislamiento físico y en la nube, sin cambios en la arquitectura. Pinecone es solo para la nube. Qdrant y Weaviate admiten la implementación autohospedada, pero están pensadas sobre todo para cargas de trabajo a escala de nube, no para entornos de borde o desconectados.
VectorAI DB se integra de forma nativa con LangChain, LlamaIndex y Hugging Face. Hay SDK para Python y JavaScript. Los plugins de la comunidad amplían la compatibilidad a CrewAI, LangGraph y Mastra. Se puede consultar la documentación completa sobre integración en docs.vectoraidb.actian.com.
VectorAI DB llega a 745,2 QPS con 10 millones de vectores de 768 dimensiones, más de 22 veces más rápido que Milvus y Qdrant con un hardware idéntico. Está diseñado para el comportamiento de consultas paralelas y de alta frecuencia que generan las flotas de agentes, no para patrones secuenciales de aplicaciones para usuarios humanos.
El plan gratuito es la VectorAI DB Community Edition. Es gratis para siempre y no hay que configurar la facturación. Incluye una capacidad de 5000 vectores, se implementa en máquinas locales de desarrollo y viene con asistencia de la comunidad.
VectorAI DB admite dos tipos de índice: HNSW (Hierarchical Navigable Small World) e IVF (Inverted File). Ambos se pueden combinar con la cuantización vectorial, que comprime cada vector en una representación más pequeña para reducir aún más el tamaño del índice.
IVF no reemplaza a HNSW. Es una segunda opción; la elección correcta depende de qué limita su implementación. Use HNSW si la prioridad es la recuperación con baja latencia y la memoria no es un factor limitante. Es la opción por defecto para casi todas las cargas de trabajo del lado del servidor.
Use IVF cuando el índice deba ocupar menos espacio o los datos cambien sin cesar. El gráfico en capas de HNSW consume más memoria por vector y su reparación en cada inserción y eliminación es costosa. El almacenamiento plano en clúster de IVF usa menos memoria por vector y sus asignaciones de clúster son más económicas de reconstruir o actualizar parcialmente.
VectorAI DB es independiente del modelo y funciona con incrustaciones de cualquier proveedor: OpenAI, Anthropic, Cohere, Hugging Face o cualquier modelo personalizado que usted aporte.
Sí. VectorAI DB almacena incrustaciones vectoriales de texto, imágenes, audio y vídeo.
Sí. Haga las operaciones con su contrato AWS actual y use el gasto comprometido, incluidos los compromisos de EDP, sin iniciar una nueva revisión de proveedores.
Empiece gratis, sin configurar la facturación
Todo lo necesario para un prototipo de memoria de agente en su propia máquina, hoy mismo.

Acceso sin facturación
Descargue VectorAI DB y empiece ya a usarlo. No hay que configurar la facturación.
Indexación y búsqueda vectorial
Indexación por vecino más cercano aproximado (HNSW e IVF), cuantización vectorial, API de búsqueda vectorial y supervisión para admitir prototipos con hasta 5000 incrustaciones vectoriales.
Configuración local rápida
Instale, indexe datos y ejecute consultas en minutos, con documentación clara, guías de inicio rápido y muestras de código.