

Deja de fiarte de tu índice de aciertos de caché. Siete pruebas demuestran por qué.


Principales conclusiones
- Una tasa elevada de aciertos en la caché semántica no garantiza que las respuestas sean correctas, por lo que conviene evaluar la tasa de falsos positivos junto con la tasa de aciertos, la latencia y el ahorro de costes.
- En las pruebas de Banking77, un umbral de similitud de 0,83 situó la tasa de falsos positivos en el 4,8 % con una tasa de aciertos del 70,1 % en las consultas de validación, pero los umbrales por sí solos no permiten detectar negaciones, cambios en números o fechas, coincidencias entre distintos usuarios ni respuestas obsoletas.
- Las medidas de seguridad específicas funcionan mejor: comprobaciones exactas de negación y valores, filtros OBLIGATORIOS basados en el inquilino y la intención, invalidación de entradas obsoletas y verificación local opcional para intenciones de alto riesgo.
- Establece un objetivo de precisión, calibra los umbrales basándote en tus propias consultas etiquetadas y valida todas las medidas de seguridad antes de implementarlas en producción.
El almacenamiento en caché semántico puede reducir los costes de los modelos de lenguaje a gran escala (LLM) y disminuir la latencia al reutilizar respuestas a consultas similares, en lugar de recurrir al modelo cada vez. Si utilizas una caché semántica, probablemente midas su éxito en función de la tasa de aciertos y del número de llamadas al modelo que evita. Sin embargo, un acierto en la caché no garantiza una respuesta correcta. Una caché puede devolver una respuesta con un alto nivel de confianza, pero irrelevante, y aun así registrar una tasa de aciertos satisfactoria.
El problema radica en cómo decide la caché qué consultas son lo suficientemente similares como para compartir una respuesta. La mayoría de las cachés semánticas utilizan un umbral de similitud para tomar esa decisión. Si se reduce el umbral, más consultas obtienen una coincidencia. Si se aumenta, la caché rechaza más coincidencias y envía más solicitudes al modelo.
Hemos analizado este problema mediante siete pruebas para averiguar con qué frecuencia el almacenamiento en caché semántico devuelve una respuesta errónea y qué se puede hacer para evitarlo. Las pruebas examinan si una caché es capaz de distinguir entre consultas que parecen similares pero que requieren respuestas diferentes. Medimos la tasa de falsos positivos junto con la tasa de aciertos, en lugar de considerar que un mayor número de aciertos supone automáticamente una mejora.
Si desarrollas o gestionas aplicaciones de modelos de lenguaje a gran escala (LLM), este artículo te explica cómo evaluar tu caché antes de utilizarla en entorno de producción.

TL;DR
- Una tasa elevada de aciertos en la caché semántica no garantiza que las respuestas sean correctas. Mide la tasa de falsos positivos (FPR) junto con la tasa de aciertos, la latencia y el ahorro de costes.
- En las pruebas realizadas con Banking77, un umbral de similitud de 0,83 alcanzó una tasa de falsos positivos (FPR) del 4,8 % y una tasa de aciertos del 70,1 % en las consultas de validación.
- Los umbrales de similitud por sí solos no pueden evitar coincidencias erróneas provocadas por la negación, cambios en números y fechas, consultas entre distintos inquilinos o respuestas obsoletas. Utiliza comprobaciones específicas, filtros y la invalidación de la caché.
- Establece un objetivo de precisión, comprueba el funcionamiento con tus propias consultas y valida las medidas de seguridad antes de implementar tu caché semántica en el entorno de producción.
La promesa de la tasa de acierto
La tasa de aciertos solo indica la frecuencia con la que la caché encuentra una coincidencia según el umbral configurado. No indica si la respuesta almacenada responde correctamente a la nueva consulta. Si se relaja el umbral, más consultas podrán coincidir con entradas existentes. Es posible que tu panel de control muestre más aciertos en la caché y un mayor ahorro potencial, incluso cuando algunas de esas coincidencias se refieran a preguntas que requieren respuestas diferentes.
La guía de TrueFoundry sobre el almacenamiento en caché semántico explica cómo la comparación de similitudes basada en representaciones permite a las aplicaciones reutilizar respuestas a consultas formuladas de manera diferente. Sin embargo, ese ahorro no indica si la caché ha devuelto la respuesta correcta.
Pensemos en un asistente de atención al cliente bancaria. Un usuario pregunta: «¿Cómo puedo dar de baja mi tarjeta bancaria?». Otro pregunta: «¿Cómo puedo evitar que me den de baja la tarjeta bancaria?». Sus consultas comparten varias palabras y pueden tener representaciones similares, pero sus intenciones son distintas. Si la caché devuelve instrucciones para dar de baja la tarjeta al segundo usuario, la solicitud sigue contándose como un acierto. El sistema se ahorra una llamada al modelo, pero el usuario recibe una respuesta errónea.
Esa es la diferencia entre el rendimiento de la caché y su corrección. Debes seguir realizando un seguimiento de la tasa de aciertos, la latencia y los costes de inferencia, ya que estos indicadores muestran si el almacenamiento en caché mejora la eficiencia. Sin embargo, también es necesario medir con qué frecuencia un acierto devuelve una respuesta que no debería haberse reutilizado. Sin esa medida, no se puede determinar si una mayor tasa de aciertos refleja un mejor almacenamiento en caché o si la caché está dispuesta a aceptar coincidencias cuestionables.
Para comprender esa relación, hay que fijarse en el umbral de similitud y evaluar cómo varían tanto la tasa de aciertos como la tasa de falsos positivos al modificarlo.
El umbral es un punto intermedio entre dos fallos
Un umbral de similitud más alto puede reducir los resultados erróneos, pero también rechaza más consultas que podrían haber reutilizado una respuesta correcta. El umbral adecuado es aquel que cumple con tu objetivo de tasa de falsos positivos y, al mismo tiempo, conserva el mayor número posible de resultados correctos.
Una caché semántica suele convertir una consulta en una representación, compararla con las representaciones de consultas almacenadas y comprobar si la coincidencia más cercana alcanza el umbral. Si lo supera, la caché devuelve la respuesta almacenada. De lo contrario, la aplicación envía la consulta al modelo. El umbral controla la facilidad con la que la caché acepta una coincidencia, pero no establece que dos consultas tengan la misma intención.
Un umbral más alto exige una coincidencia más precisa, mientras que un umbral más bajo admite una gama más amplia de consultas. Este único parámetro influye en la frecuencia con la que la caché sirve una respuesta ya existente y en la frecuencia con la que rechaza una consulta que podría haberla utilizado.
Un umbral demasiado estricto puede socavar el ahorro que pretendías conseguir al implementar el almacenamiento en caché. Los usuarios rara vez formulan la misma pregunta de forma idéntica, y las pequeñas diferencias en la redacción no siempre indican un cambio de intención. Si tu caché rechaza demasiadas coincidencias válidas, tu aplicación realiza llamadas innecesarias al modelo. Acabas pagando por respuestas que podrías haber reutilizado, y la latencia aumenta.
Un umbral demasiado amplio plantea el problema contrario. La caché acepta más coincidencias, pero la similitud de incrustación no garantiza que dos consultas requieran la misma respuesta. Tal y como se explica en la guía de Portkey sobre los umbrales del almacenamiento en caché semántico, el umbral determina la facilidad con la que el sistema reutiliza una respuesta, y una configuración demasiado permisiva puede dar lugar a falsos positivos.
Ninguno de los dos extremos te ofrece una base fiable para elegir un umbral. Es necesario saber qué grado de reutilización ofrece cada configuración y con qué frecuencia la caché devuelve una respuesta que no corresponde a la consulta actual. Para ello, hay que evaluar conjuntamente la tasa de aciertos y la tasa de falsos positivos, en lugar de ajustar una métrica de forma aislada.
La decisión más práctica consiste en fijar primero un objetivo de precisión y, a continuación, determinar qué umbral lo cumple sin sacrificar más eficiencia de la caché de lo necesario. La configuración adecuada depende de tus consultas, de las consecuencias de una respuesta errónea y de los resultados de tu propia evaluación.
Cuánto cuesta realmente un golpe erróneo
Una falta de acierto en la caché te supone otra llamada al modelo. Un falso positivo puede dar al usuario una respuesta errónea, mientras que la aplicación indica que se ha producido un acierto en la caché.
El análisis de Tian Pan sobre el almacenamiento en caché semántico en entornos de producción pone de relieve el peligro de ofrecer respuestas erróneas con un alto nivel de confianza. Una caché semántica no siempre es capaz de detectar cuándo una coincidencia cercana altera el significado de una consulta. Puede encontrar una respuesta con una alta similitud en la representación, incluso cuando el usuario necesita una respuesta diferente.
La negación pone de manifiesto este problema de forma especialmente clara. Compara «cancelar mi tarjeta» con «no cancelar mi tarjeta». Las dos consultas comparten casi todas las palabras, pero expresan instrucciones opuestas. Reutilizar la respuesta incorrecta podría hacer que una aplicación actuara en contra de los deseos del usuario. No se puede dar por sentado que una puntuación de similitud alta signifique que las consultas sean intercambiables.
Los números y las fechas plantean otro riesgo. Una respuesta errónea de la caché puede devolver un resultado que parezca plausible, pero que contenga un valor obsoleto o incorrecto. En la Prueba 3, la consulta «Establecer mi límite diario de tarjeta en 2500» coincidió con una consulta almacenada en caché que utilizaba «250», con una puntuación de similitud de 0,962. A pesar de la alta puntuación, las dos consultas especifican límites diferentes. El ejemplo muestra por qué la similitud por sí sola no puede proteger los valores que alteran el significado de una solicitud.
Estos son los modos de fallo que la tasa de aciertos no puede revelar. Es posible que tu caché contabilice cada coincidencia como un acierto, incluso cuando un cambio en una palabra, una cantidad o una fecha haga que la respuesta almacenada ya no sea adecuada. El coste va más allá de otra llamada al modelo. Dependiendo de tu aplicación, una respuesta errónea puede inducir a error a un cliente, desencadenar una acción incorrecta o minar la confianza en el sistema.
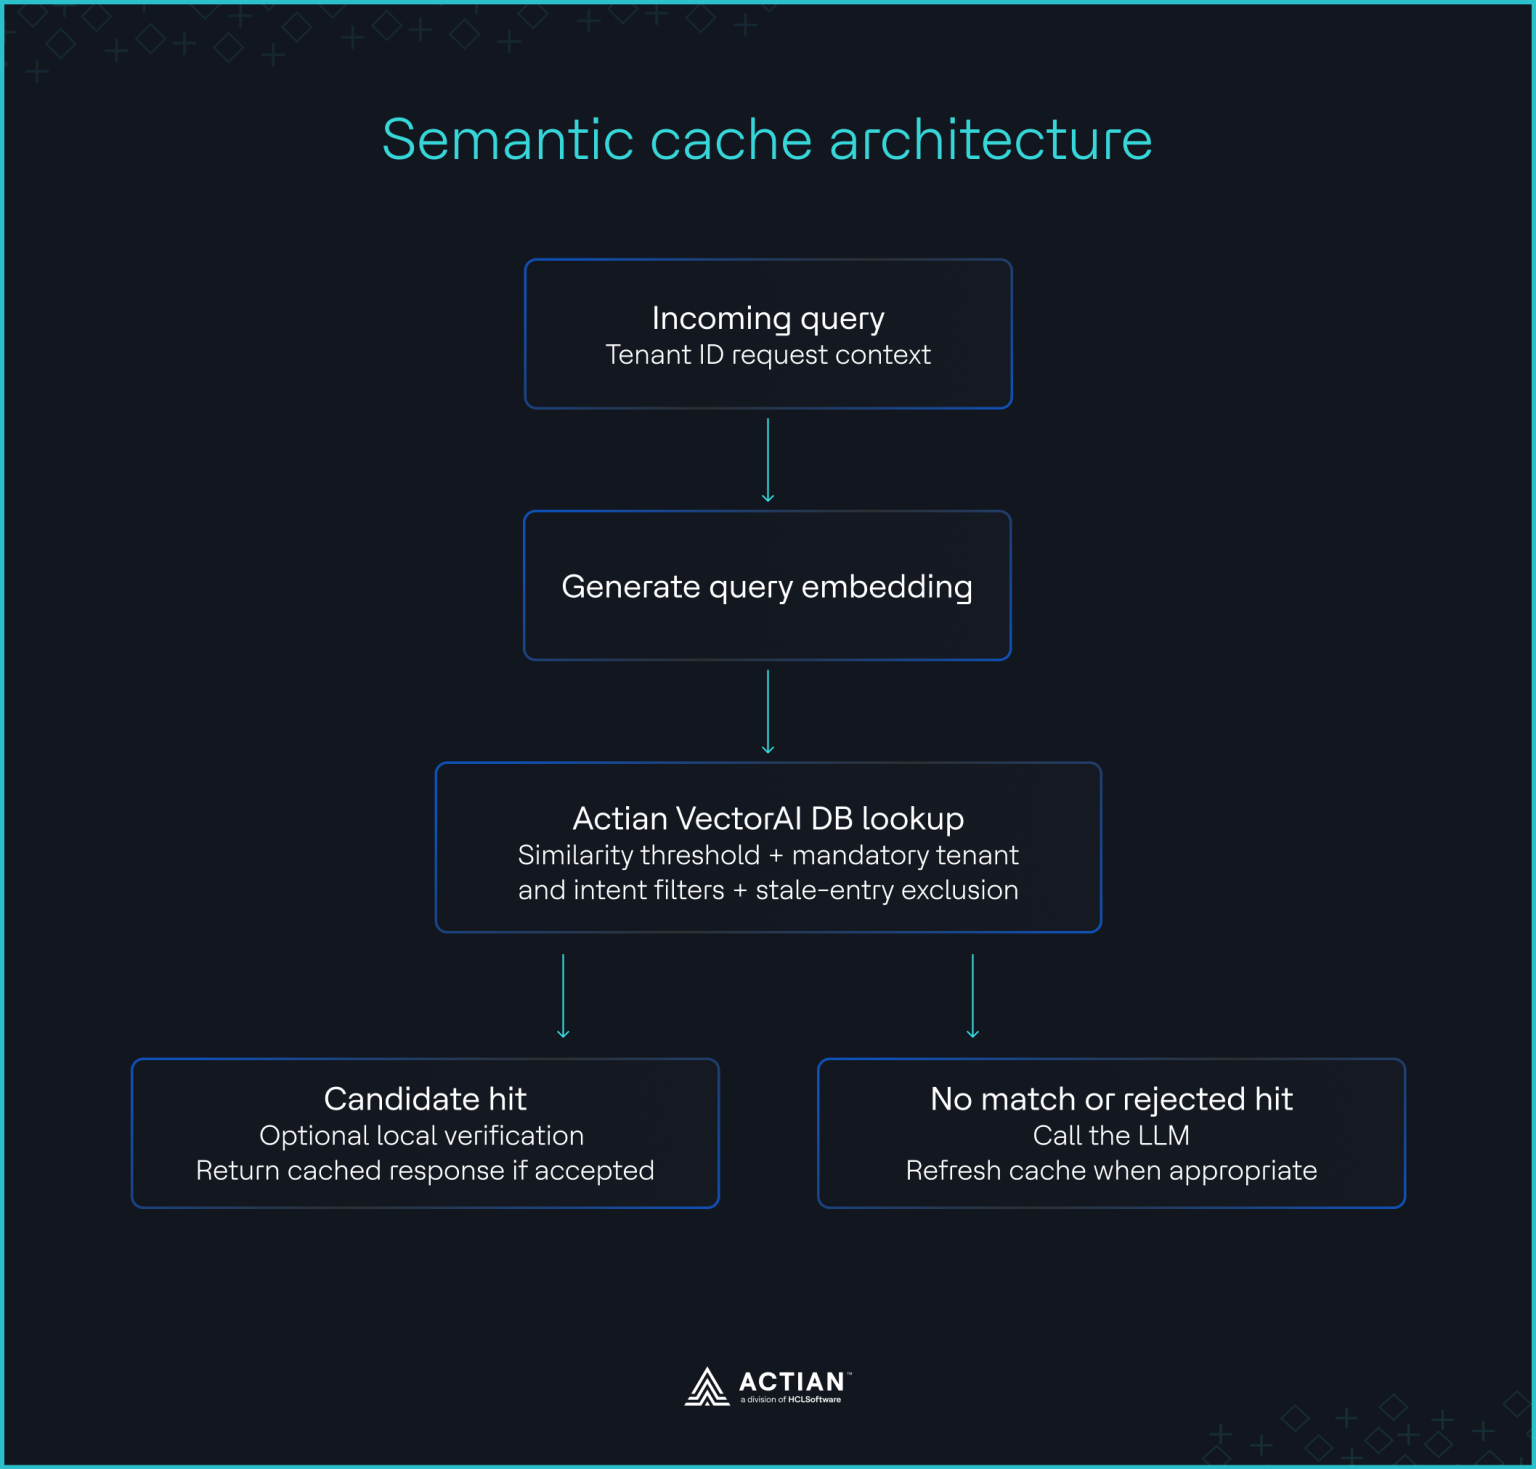
Arquitectura de caché semántica
Requisitos previos y configuración
Para reproducir los experimentos, necesitas Docker para ejecutar VectorAI DB de forma local, Python para ejecutar los scripts de prueba y uv para gestionar el entorno de Python y sus dependencias.
Antes de empezar, instala lo siguiente:
- Docker Desktop o Docker Engine con Docker Compose
- Python 3.11 o 3.12
- uv, el paquete de Python y gestor de entornos que utiliza el proyecto
Clona el repositorio e inicia VectorAI DB
En tu terminal, clona el repositorio «developer-content» de Actian y accede al directorio del proyecto «semantic cache».
git clone https://github.com/actian-devs/developer-content.git
cd developer-content/blog/semantic-cache-fp
Inicia VectorAI DB con Docker Compose.
docker-compose up -dDeberías ver el resultado:
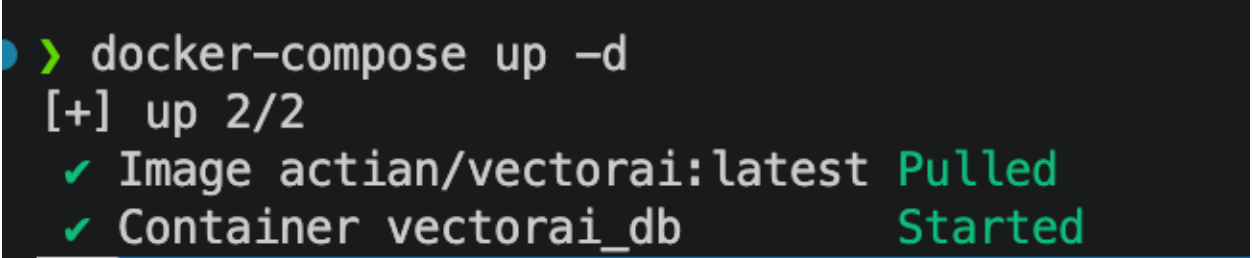
Inicio de VectorAI DB
Instala las dependencias de Python y crea el entorno virtual.
uv syncEspera a que VectorAI DB termine de iniciarse antes de ejecutar las pruebas. Puedes comprobar el estado del contenedor con el comando «docker ps».
Realiza las siete pruebas
Ejecuta primero el barrido de umbrales. Este evalúa umbrales comprendidos entre 0,50 y 0,99 e identifica un umbral que cumple el objetivo de una tasa de falsos positivos del 5 % en los datos de calibración.
uv run python test1_threshold_sweep.py --threshold 0.80Utiliza 0,80 para reproducir los resultados de las siete pruebas que se recogen en este artículo. El barrido de umbrales también evalúa qué umbral cumple el objetivo de una tasa de falsos positivos del 5 %. En nuestra evaluación, el valor de 0,83 cumplió ese objetivo en la partición de validación.
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
uv run python test4_partitions.py --threshold 0.80
uv run python test6_query_length.py --threshold 0.80
uv run python test7_stale_answers.py --threshold 0.80
La prueba 5 ejecuta un pequeño modelo de verificación. Exporta primero las consultas de caché y, a continuación, ejecuta el modelo sobre ellas. «decider-0.8b» se ejecuta en un ordenador portátil. Los modelos más grandes, como «decider-4b», necesitan una GPU.
uv run python test5_decider_verify.py \
  --threshold 0.80 \
  --export-hits data/test5_lookups.json
uv run --extra decider python test5_decider_verify.py \
  --threshold 0.80 \
  --model Mapika/decider-0.8b \
  --max-hits 100 \
  --hits-file data/test5_lookups.json
Una vez finalizadas las pruebas, elabora la tabla de resultados.
uv run python make_table.pyLos scripts escriben sus resultados en el archivo directorioresults/ . Entre ellos se incluyen los datos del barrido de umbrales, los datos utilizados para generar la tabla de resultados y los archivos JSON individuales que contienen las mediciones de cada prueba. La primera ejecución descarga el conjunto de datos y el modelo de incrustación, por lo que puede tardar más que las ejecuciones posteriores.
Siete pruebas, una imagen
Con un umbral de similitud de 0,80, la caché devolvió 610 aciertos de un total de 770 consultas, lo que supone una tasa de aciertos del 79,2 %. De esos aciertos, 39 eran erróneos, lo que da lugar a una tasa de falsos positivos del 6,4 %. El análisis de umbrales identificó 0,83 como el valor que cumplía el objetivo del 5 % de falsos positivos en la parte de evaluación reservada. En esa parte, la caché alcanzó una tasa de aciertos del 70,1 % y una tasa de falsos positivos del 4,8 %.
En los experimentos se utilizó VectorAI DB para almacenar las representaciones de 3.075 preguntas procedentes de Banking77, un conjunto de datos público de consultas de asistencia bancaria etiquetadas con 77 intenciones. Esto se ajusta al límite de 5.000 vectores de la Edición Comunitaria. Buscamos otras 770 preguntas del mismo conjunto de datos utilizando el sentence-transformers/all-MiniLM-L6-v2 modelo de incrustación. Para cada consulta, VectorAI DB devolvía la pregunta almacenada más cercana. Una coincidencia se consideraba un acierto cuando su similitud coseno alcanzaba el umbral de 0,80.
Definimos una coincidencia errónea como aquella en la que la pregunta almacenada en caché tenía una intención diferente, pertenecía a otro inquilino simulado o hacía referencia a una fuente que había cambiado. La tasa de falsos positivos (FPR) es el número de coincidencias erróneas dividido entre el total de coincidencias. Nuestro objetivo era una FPR del 5 % o inferior. Calibramos los umbrales en la mitad del conjunto de consultas y los evaluamos en la otra mitad.
El conjunto de datos es una muestra, no la colección completa de Banking77. Hemos simulado cambios en los inquilinos y en las fuentes, y hemos generado los pares utilizados en las pruebas de negación y de números a partir de plantillas. Por lo tanto, los resultados muestran cómo se comportan estos modos de fallo en condiciones controladas, no la frecuencia con la que se producen en cada caché de producción.
Prueba 1: El barrido de umbral
Qué evalúa: La mayoría de las cachés semánticas se basan en un parámetro principal: el umbral de similitud. Esta prueba analiza cómo varía la precisión al ajustar ese valor. Se consultan 770 preguntas en la caché con cada umbral, desde 0,50 hasta 0,99, y se contabilizan dos aspectos en cada paso: la frecuencia con la que la caché responde (tasa de aciertos) y la frecuencia con la que su respuesta es errónea (tasa de falsos positivos).
Con un valor de 0,80, la caché devolvió 39 respuestas erróneas de un total de 610 aciertos. Esto supone una tasa de falsos positivos (FPR) del 6,4 %, es decir, unas cinco respuestas erróneas por cada 100 consultas recibidas. Algunas coincidencias erróneas presentaban puntuaciones de similitud muy elevadas. Por ejemplo, «¿Por qué no he podido realizar una transferencia?» coincidió con «¿Por qué no he podido completar mi transferencia?» con un valor de 0,921, a pesar de que las preguntas tenían diferentes intenciones de Banking77: «declined_transfer» y «failed_transfer».
Al elevar el umbral a 0,83, la tasa de predicción falsa positiva (FPR) se situó en el 4,8 % en el conjunto de evaluación retenido, cumpliendo así el objetivo del 5 %. La tasa de aciertos descendió al 70,1 %. Esa es la contrapartida que oculta un panel de control que solo muestra la tasa de aciertos. El umbral más alto redujo la reutilización incorrecta, pero también envió más consultas al modelo.
La figura 2 muestra la tasa de aciertos y la tasa de falsos positivos para los distintos umbrales probados. Utiliza la curva para elegir un punto de funcionamiento en función de un objetivo de precisión, en lugar de considerar como meta la tasa de aciertos más alta.

Índice de aciertos e índice de falsos positivos en función de los umbrales de similitud
Ejecuta la prueba 1 en tu terminal:
uv run python test1_threshold_sweep.py --threshold 0.80Pruebas 2 y 3: Negación, números y fechas
Qué se evalúa: Estas pruebas evalúan si una caché semántica es capaz de distinguir entre preguntas similares con significados distintos, al tiempo que reutiliza las respuestas para preguntas que significan lo mismo. Por ejemplo, «Cancelar mi tarjeta» y «No cancelar mi tarjeta» difieren en una sola palabra, pero requieren respuestas opuestas. Del mismo modo, «Enviar 250 $» y «Enviar 2.500 $» difieren en un solo dígito, pero especifican cantidades diferentes. Las pruebas almacenan en caché una pregunta de cada par y formulan la otra para comprobar que la caché no reutiliza incorrectamente la respuesta almacenada. También incluyen preguntas reformuladas con el mismo significado para verificar que la caché reutiliza correctamente esas respuestas.
La caché semántica tuvo dificultades para distinguir preguntas con significados opuestos, incluso cuando solo se diferenciaban en una palabra. Reutilizó incorrectamente las respuestas almacenadas en caché en 74 de las 75 preguntas negadas (el 98,7 %). Por ejemplo, «¿No debería cancelar mi tarjeta?» se emparejó con «¿Debería cancelar mi tarjeta?» con una puntuación de similitud de 0,990, a pesar de que la intención era opuesta.
El ajuste del umbral por sí solo no bastó para resolver este problema. Los pares negados presentaban una similitud mediana de 0,946, superior al 0,936 registrado para las paráfrasis que conservaban la intención original. Ningún umbral, ni siquiera uno de 0,99, evitó al menos el 95 % de los errores de negación. Por el contrario, una simple comprobación que rechazaba las coincidencias cuando solo una de las consultas contenía negación redujo la proporción de preguntas con negación servidas del 98,7 % al 4,0 %, al tiempo que se mantenía una tasa de paráfrasis del 72,1 %.
Los números y las fechas modificados plantearon un reto similar. Los 38 pares con valores modificados tenían una similitud mediana de 0,906, cercana a la mediana de 0,911 de los 44 pares de paráfrasis. La caché atendió las 38 consultas con valores modificados. Por ejemplo, «Establecer mi límite diario de tarjeta en 2 500 $» coincidió con «Establecer mi límite diario de tarjeta en 250 $» con un valor de 0,962. Del mismo modo, una pregunta sobre un cargo el 21 de junio coincidió con otra sobre el 21 de julio con un valor de 0,964.
Para bloquear al menos el 95 % de estas consultas con valores modificados se requirió un umbral de 0,97, lo que redujo la tasa de paráfrasis del 95,5 % al 13,6 %. Una comprobación de coincidencia exacta para números y términos de fecha bloqueó todos los valores modificados en esta prueba, al tiempo que mantuvo la tasa de paráfrasis en el 95,5 %.
Estas comprobaciones son deliberadamente sencillas y presentan limitaciones. La comprobación de negación puede pasar por alto cambios indirectos en el significado, mientras que la comprobación de valor no reconoce formatos equivalentes como «cincuenta dólares» y «50 $».
Ejecuta las pruebas 2 y 3 en tu terminal:
uv run python test2_negation.py --threshold 0.80
uv run python test3_numbers_dates.py --threshold 0.80
Prueba 4: Límites de los inquilinos y de la intención
Qué comprueba: Esta prueba comprueba si una caché puede evitar que las respuestas se compartan entre clientes (inquilinos) o temas no relacionados. Por ejemplo, un cliente no debería recibir la respuesta almacenada en caché de otro cliente, y una pregunta sobre comisiones de tarjetas no debería devolver una respuesta sobre transferencias. La prueba utiliza tres inquilinos simulados para identificar coincidencias incorrectas en la caché y, a continuación, repite las búsquedas con filtros de VectorAI DB para comprobar si restringir las búsquedas por inquilino y tema evita estos errores.
Sin filtros, 425 de las 610 coincidencias eran erróneas, lo que supone una tasa de falsos positivos del 69,7 %. De esas coincidencias, 409 —es decir, el 67,1 % del total— traspasaban los límites de los inquilinos. El resto de coincidencias erróneas incluían consultas que se ajustaban a una intención incorrecta dentro de un mismo inquilino.
Un filtro «MUST» aplicado al inquilino eliminó las coincidencias entre inquilinos y redujo la tasa de falsos positivos (FPR) global al 9,1 %, con una tasa de acierto del 61,4 %. Los errores restantes incluían coincidencias con intenciones vecinas. Dado que cada partición de inquilino contenía menos ejemplos por intención, era más probable que la coincidencia más cercana disponible procediera de una intención diferente.
La incorporación de un segundo filtro «MUST» para la intención predicha por un clasificador ligero redujo la tasa de falsos positivos (FPR) al 4,7 %, con una tasa de aciertos del 58,4 %. El clasificador predijo la intención correcta el 88,4 % de las veces. Al permitir coincidencias de las dos principales intenciones del clasificador mediante un filtro «SHOULD», se obtuvo una tasa de aciertos más alta, del 60,6 %, pero la tasa de falsos positivos (FPR) aumentó hasta el 7,9 %.
Los umbrales por intención no mejoraron el resultado en este experimento. Al disponer solo de unas cinco preguntas por intención para la calibración, la tasa de falsos positivos (FPR) en las consultas de validación fue del 9,6 %. Se trata de una limitación de esta muestra, no de una prueba de que los umbrales por intención no puedan funcionar con más datos.
Los resultados muestran por qué la similitud por sí sola no constituye un mecanismo de control de acceso. Una consulta a la caché debería respetar los límites de los inquilinos y, cuando proceda, restringir los candidatos según la intención antes de seleccionar una respuesta.
Ejecuta la prueba 4 en tu terminal:
uv run python test4_partitions.py --threshold 0.80Prueba 5: Verificación local
Qué comprueba: Los umbrales y los filtros siguen dejando pasar algunas respuestas incorrectas. Esta prueba añade una segunda opinión: antes de que la caché sirva una respuesta, un pequeño modelo local lee ambas preguntas y determina si una sola respuesta puede servir para ambas. La prueba mide cuántas respuestas incorrectas detecta el modelo, cuántas respuestas correctas rechaza por error y cuánto tiempo añade cada comprobación.
Para probar una medida de seguridad adicional, enviamos 100 resultados seleccionados al modelo «decider-0.8b» de Mapika en un MacBook con Apple Silicon M3.
Con un umbral de probabilidad de «sí» de 0,5, el verificador detectó cuatro de las seis coincidencias erróneas de la muestra. Asimismo, rechazó 25 de las 94 coincidencias correctas, lo que supone un 26,6 %. La latencia mediana de verificación fue de 106 milisegundos por coincidencia, con un percentil 95 de 116 milisegundos en el ordenador portátil con un tamaño de lote de uno.
Un umbral inferior de 0,3 rechazó solo dos coincidencias válidas, pero detectó únicamente una coincidencia errónea. Estos resultados ilustran el equilibrio entre detectar coincidencias erróneas y conservar las coincidencias útiles de la caché. Dado que la muestra solo contenía seis coincidencias erróneas, se trata de un resultado preliminar, no de una estimación fiable de la eficacia del verificador. Aún es necesaria una evaluación completa de las 610 coincidencias. La latencia medida no constituye un punto de referencia de producción. Considera la verificación local como una medida de seguridad que merece la pena probar en casos de alto riesgo, no como una solución probada.
Prueba 6: Consultas cortas frente a consultas largas
Qué evalúa: Las preguntas breves, como «la tarjeta no funciona», contienen pocos detalles, por lo que preguntas breves que no guardan relación entre sí pueden parecer similares. Esta prueba divide las 770 preguntas en breves, medias y largas, compara la frecuencia con la que cada grupo obtiene una respuesta incorrecta y comprueba si resulta útil aplicar un umbral más estricto para las preguntas breves.
La longitud de las consultas también influyó en la fiabilidad. Las consultas de ocho palabras o menos representaban el 43 % del conjunto de búsqueda y suponían 27 de los 39 resultados erróneos. Con un umbral de 0,80, su tasa de falsos positivos (FPR) fue del 9,4 %, frente al 2,9 % de las consultas medias de entre nueve y once palabras y al 4,6 % de las consultas de más de once palabras.
Para alcanzar el objetivo del 5 %, los umbrales calibrados fueron de 0,87 para las consultas cortas, 0,80 para las consultas medias y 0,83 para las consultas largas. La aplicación de estos umbrales adaptados a la longitud redujo la tasa de falsos positivos (FPR) al 2,0 % en las consultas de validación, con una tasa de aciertos del 64,2 %. En comparación, el umbral único de 0,83 produjo una tasa de falsos positivos (FPR) del 4,8 % y una tasa de aciertos del 70,1 %.
Los umbrales que tienen en cuenta la longitud mejoraron la precisión en esta muestra, a costa de obtener menos resultados. Deberías validar el mismo patrón con tu propia distribución de consultas antes de adoptar umbrales diferentes en función de la longitud.
Ejecuta la prueba 6 en tu terminal:
uv run python test6_query_length.py --threshold 0.80Prueba 7: Respuestas obsoletas tras cambios en el código fuente
Qué comprueba: Una respuesta almacenada en caché puede coincidir perfectamente con la pregunta y, aun así, ser incorrecta, ya que la política en la que se basa ha cambiado desde que se guardó en caché. Esta prueba modifica el 20 % de las políticas subyacentes tras el almacenamiento en caché y, a continuación, comprueba con qué frecuencia la caché ofrece una respuesta obsoleta. A continuación, marca las entradas afectadas como caducadas en la base de datos de VectorAI y vuelve a comprobarlo.
Tratamos cada intención de Banking77 como una fuente y modificamos 15 de las 77 fuentes tras el almacenamiento en caché. Antes de la invalidación, la tasa de falsos positivos (FPR) ascendió al 24,9 %. En 113 resultados, la caché encontró una pregunta con la intención correcta, pero devolvió una respuesta obsoleta.
Utilizamos una llamada filtrada a «set_payload» para marcar como obsoletas las 600 entradas procedentes de las fuentes modificadas y, a continuación, añadimos un filtro «MUST NOT» para excluir las entradas obsoletas de las búsquedas. La tasa de falsos positivos (FPR) descendió del 24,9 % al 11,4 %, y la tasa de aciertos fue del 67,4 %. Esto redujo el problema, pero no lo eliminó. Algunas consultas sobre políticas modificadas coincidían con una intención vecina que aún superaba el umbral de similitud. Por lo tanto, la invalidación debería combinarse con una recarga de la caché o un filtrado adecuado de intenciones, seguido de otra evaluación para comprobar si quedan errores.
Ejecuta la prueba 7 en tu terminal:
uv run python test7_stale_answers.py --threshold 0.80Los resultados en una tabla
| Prueba | Modo de fallo | Mitigación | Resultado |
| 1. Barrido de umbral | Un umbral admite demasiadas coincidencias erróneas | Calibrar con un objetivo de FPR del 5 % | Con un valor de 0,83, la tasa de falsos positivos (FPR) fue del 4,8 % y la tasa de acierto, del 70,1 % en las consultas de validación. |
| 2. Negación | Las preguntas con negación se puntúan como las paráfrasis | Comprueba si hay diferencias en la negación | Las consultas rechazadas se redujeron del 98,7 % al 4,0 %; la tasa de paráfrasis se mantuvo en el 72,1 % |
| 3. Números y fechas | Los valores modificados siguen coincidiendo | Exigir coincidencias exactas en los números y las expresiones de fecha | Las consultas con valores modificados se redujeron del 100 % al 0 %; la tasa de paráfrasis se mantuvo en el 95,5 %. |
| 4. Límites de los inquilinos y de la intención | Coincide con particiones cruzadas o intenciones | MUST aplica filtros según el inquilino y la intención prevista | El FPR descendió al 4,7 %, con una tasa de acierto del 58,4 % |
| 5. Verificación local | Las coincidencias erróneas superan el umbral y los filtros | Comprueba los resultados muestreados con Decider-0.8b | El FPR descendió del 6,0 % al 2,8 % en una muestra de 100 resultados; los resultados son provisionales |
| 6. Longitud de la consulta | Las consultas cortas generan más resultados erróneos | Calibrar los umbrales en función de la longitud de la consulta | El FPR descendió al 2,0 %, con una tasa de acierto del 64,2 % en las consultas de la muestra de control. |
| 7. Respuestas obsoletas | Las respuestas almacenadas en caché perduran más que sus datos de origen | Marcar las entradas obsoletas y excluirlas de la búsqueda | El FPR descendió del 24,9 % al 11,4 %; filtrar las intenciones de recarga o reposición |
El FPR global de 0,80 ocultaba fallos que se concentraban en tipos específicos de consultas y condiciones de caché. La negación y los valores modificados superaban los umbrales de similitud, los límites de los inquilinos requerían filtros y las respuestas obsoletas exigían su invalidación. Las consultas cortas se beneficiaron de un umbral más estricto, mientras que la verificación local se mostró prometedora, aunque requiere una evaluación más amplia.
Estos resultados dependen del modelo de incrustación seleccionado, de la muestra de Banking77 y de la definición de «respuesta incorrecta» utilizada en el experimento. Las etiquetas de intención son un indicador imperfecto para determinar si dos preguntas pueden compartir una respuesta con seguridad, por lo que algunas coincidencias pueden clasificarse erróneamente en cualquier sentido. Los resultados constituyen una prueba útil de modos de fallo específicos, pero no una predicción universal del rendimiento en producción.
Cómo gestionar una caché en la que puedas confiar
Empieza por fijarte un objetivo de precisión, no un objetivo de porcentaje de aciertos. Decide cuántas respuestas incorrectas puede aceptar tu aplicación y, a continuación, configura la caché para que se ajuste a ese número.
Establece el umbral en función de un objetivo de corrección
Mide la tasa de falsos positivos en una muestra etiquetada de tu propio tráfico, prueba diferentes valores del umbral y elige el más bajo que cumpla con tu objetivo. Indica la tasa de falsos positivos junto a la tasa de aciertos en cada panel de control. Utiliza un umbral más estricto para las consultas cortas.
Divide el espacio de tal forma que un impacto no pueda cruzar un límite
Almacena el inquilino, la intención y la fuente con cada entrada almacenada en caché, y deja que VectorAI DB las utilice como filtros durante la búsqueda. Un filtro «MUST» sobre el inquilino garantiza que cada cliente permanezca dentro de sus propios datos. Un filtro de intención evita que una pregunta de tarjeta reciba una respuesta de transferencia. Un filtro «MUST NOT» sobre un indicador de caducidad excluye las respuestas obsoletas cuando cambia la fuente.
Comprueba los resultados que no te puedes permitir equivocarte
Antes de mostrar un resultado, compara los detalles en los que no coinciden: negaciones, importes y fechas. Para operaciones de alto riesgo, como reembolsos y cancelaciones, añade un modelo de verificación local. Realiza un seguimiento de los resultados erróneos que detecta, de los resultados correctos que rechaza y de la latencia que añade.
Realiza esta comprobación de forma periódica. La tasa de aciertos solo tiene sentido si se indica junto a ella la tasa de falsos positivos.
Conclusión
Una tasa de aciertos elevada indica que tu caché semántica está funcionando, no que sea correcta. Las siete pruebas demuestran que las respuestas erróneas se concentran donde más cuestan: solicitudes negadas, importes y fechas modificados, datos de otro cliente y políticas obsoletas. Un umbral por sí solo no basta para detectarlas. Establece el umbral en función de un objetivo de exactitud, divide la caché con los filtros de VectorAI DB para que un acierto no pueda traspasar los límites de un cliente o de una intención, y verifica los aciertos en los que no puedes permitirte equivocarte.
Para comprobar el rendimiento de tu propia caché, empieza por utilizar Actian VectorAI DB Community Edition. Realiza las mismas comprobaciones con una muestra etiquetada de tus propias consultas, mide la frecuencia con la que las entradas en la caché devuelven respuestas incorrectas y utiliza esos resultados para ajustar tu umbral y tus medidas de seguridad.
Descarga la imagen de Docker de la Community Edition para empezar.
docker pull actian/vectorai:latestA continuación, sigue las instrucciones de la documentación de VectorAI DB para iniciar la base de datos y ejecutar tu evaluación. La edición Community admite hasta 5.000 vectores, lo que la hace adecuada para reproducir estos experimentos en un equipo de desarrollo local. Únete a la comunidad de Actian en Discord para obtener ayuda y participar en los debates.
Únase a Discord
Mantente conectado
Te ofrecemos información detallada sobre los datos.
(por ejemplo, sales@..., support@...)
