
Crear un sistema de búsqueda de defectos visuales sin conexión con CLIP y VectorAI DB


Principales conclusiones
- CLIP y Actian VectorAI DB permiten a los fabricantes buscar imágenes de defectos mediante texto o fotografías, manteniendo todo el flujo de trabajo sin conexión.
- CLIP convierte imágenes y texto en un espacio vectorial compartido, mientras que VectorAI DB almacena esos vectores junto con metadatos sobre defectos que permiten realizar búsquedas.
- El filtrado de metadatos permite a los equipos limitar los resultados por categoría de pieza o estado del defecto durante la búsqueda, en lugar de filtrarlos a posteriori.
- FAISS ofrece una búsqueda en datos sin procesar más rápida a pequeña escala, mientras que VectorAI DB aporta almacenamiento duradero, filtrado de metadatos y acceso desde varias máquinas.
- En las implementaciones industriales, el rendimiento de la codificación suele ser una limitación mayor que el almacenamiento de vectores o la latencia en las búsquedas en bases de datos.
Las plantas de fabricación suelen conservar fotografías de defectos de años atrás sin ninguna forma de buscarlas. Cuando una pieza sale de la línea de producción con una marca desconocida, alguien tiene que abrir carpetas y buscarla. CLIP convierte las imágenes y el texto en vectores que se pueden comparar. La base de datos Actian VectorAI almacena y busca esos vectores. Juntos, sustituyen las búsquedas en carpetas y funcionan sin conexión en el hardware de la propia planta.
Un ingeniero de calidad puede escribir una descripción o enviar al sistema una fotografía del nuevo defecto. Los dos ejemplos que se muestran a continuación se comparan con el conjunto de datos de defectos de MVTec AD.
Búsqueda por descripción:
$ uv run query.py --text "surface scratch on metal component" --part-category metal_nut

Text query: "surface scratch on metal component"  [part_category=metal_nut]
  score  category     defect           path
 0.2814  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/003.png
 0.2691  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/011.png
 0.2607  metal_nut    color            ./mvtec_ad/metal_nut/test/color/007.png
 0.2588  metal_nut    scratch          ./mvtec_ad/metal_nut/test/scratch/000.png
 0.2470  metal_nut    bent             ./mvtec_ad/metal_nut/test/bent/014.png

encode 18.4 ms | search 2.1 ms | total 20.5 ms
Búsqueda por fotografía:
$ uv run query.py --image ./line_capture_0412.png --defect-only

Image query: ./line_capture_0412.png  [is_defect=true]
  score  category     defect           path
 0.8912  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/006.png
 0.8744  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/002.png
 0.8593  hazelnut     print            ./mvtec_ad/hazelnut/test/print/010.png
 0.8471  hazelnut     hole             ./mvtec_ad/hazelnut/test/hole/004.png
 0.8226  hazelnut     crack            ./mvtec_ad/hazelnut/test/crack/013.png

encode 41.7 ms | search 1.9 ms | total 43.6 ms
Las puntuaciones del texto se sitúan en torno a 0,26. Las puntuaciones de las imágenes se sitúan en torno a 0,89. Una frase y una fotografía nunca se sitúan tan cerca entre sí como lo hacen dos fotografías. Compara las puntuaciones dentro de un mismo modo de búsqueda, nunca entre ellos.
Ambas búsquedas se realizaron con un filtro,--part-category limitó la búsqueda de texto a imágenes de tuercas metálicas, para que no apareciera ningún defecto relacionado con botellas o avellanas, y--defect-only excluyó de la búsqueda de fotografías todas las imágenes etiquetadas como «pieza en buen estado». Ambos filtros leen los metadatos almacenados junto a cada vector mientras se realiza la búsqueda, en lugar de filtrar la lista de resultados final una vez finalizada esta. Un índice vectorial simple no admite ninguno de los dos filtros, ya que solo almacena vectores e identificadores numéricos, sin ningún lugar donde registrar que una imagen muestra una tuerca metálica o que la pieza estaba defectuosa.
El tiempo de ejecución procede de un equipo que solo cuenta con CPU. La codificación CLIP es lo que más tiempo consume. La búsqueda en la base de datos tarda unos dos milisegundos. En la sección de pruebas de rendimiento se desglosan ambas cifras para el hardware indicado.
Por qué FAISS no funciona en entornos de producción
FAISS es un índice. VectorAI DB es una base de datos. FAISS almacena vectores e identificadores enteros dentro de un mismo proceso. VectorAI DB almacena cada vector junto con una carga útil de metadatos, filtra según esos campos durante la búsqueda y se ejecuta como un servicio al que pueden acceder otros equipos.
Una afirmación habitual es que FAISS no puede guardar un índice ni filtrar sus resultados. FAISS hace ambas cosas, como muestra este fragmento de código.
import faiss, numpy as np, tempfile, os

d, n = 512, 1000
x = np.random.randn(n, d).astype('float32'); faiss.normalize_L2(x)
idx = faiss.IndexFlatIP(d); idx.add(x)

fd, path = tempfile.mkstemp(suffix='.faiss'); os.close(fd)
faiss.write_index(idx, path)                                  # persistence
reloaded = faiss.read_index(path)
print(np.array_equal(idx.search(x[:1], 5)[1],
                     reloaded.search(x[:1], 5)[1]))           # True

allowed = np.array([5, 10, 15, 20, 25, 30], dtype='int64')
sel = faiss.IDSelectorBatch(allowed)                          # filtering
_, ids = idx.search(x[:1], 3, params=faiss.SearchParameters(sel=sel))
print(set(ids[0]).issubset(set(allowed.tolist())))            # True
La primera comprobación vuelve a cargar el índice desde el disco y devuelve los mismos vecinos que el original. La segunda limita la búsqueda a seis ID permitidos, y todos los resultados se encuentran dentro de esa lista. Un responsable del mantenimiento de FAISS confirmó write_index desde 2017, y IDSelector el filtrado es en la wiki.
FAISS sigue suponiendo tres gastos en la implantación de una planta.
- El almacenamiento de metadatos se gestiona manualmente: FAISS almacena vectores e identificadores enteros. No almacena información del tipo «esto es una tuerca metálica, el defecto es un arañazo, el archivo está en esta ruta». Esa información se guarda en un archivo pickle o SQLite junto al índice, y mantener ambos sincronizados es tarea tuya. Filtrar por categoría de pieza implica crear una tabla de correspondencias entre categorías e identificadores, cargarla y construir un IDSelector para cada consulta; después, hay que volver a crear la tabla cada vez que cambie el corpus. Cuando una ejecución de ingesta se interrumpe a mitad de camino, debes conciliar el índice y el sidecar manualmente.
- El filtrado en un índice de grafos afecta a la recuperación, a la latencia o a ambas: El fragmento de código anterior utiliza IndexFlatIP, que es exacto, por lo que filtrar allí no tiene coste. Los corpus de producción utilizan HNSW en su lugar. Un filtro selectivo interactúa mal con el recorrido del grafo. El recorrido sigue encontrando vecinos que el filtro rechaza. Con la configuración predeterminada, la búsqueda pasa por alto la mayor parte de lo que debería encontrar y, en ocasiones, ni siquiera puede completar el conjunto de resultados. Recuperar esa recuperación implica elevar el valor de efSearch muy por encima del predeterminado y pagar por ello en tiempo de consulta. La sección de pruebas de rendimiento mide esta relación de trade-off en cifras reales. VectorAI DB aplica el filtro dentro de la búsqueda en lugar de dejar que el usuario descubra este parámetro por sí mismo.
- No hay ningún servidor: FAISS se ejecuta dentro de un único proceso de Python. Dos estaciones de inspección que consultan el mismo corpus implican dos copias del índice en dos procesos, o bien que escribas tú mismo la capa de servicio, incluyendo su comportamiento en cuanto a concurrencia y reinicio.
VectorAI DB proporciona esos tres elementos directamente. Los metadatos se encuentran en la carga útil, los filtros se aplican durante la búsqueda y la base de datos se ejecuta en un contenedor al que puede acceder cualquier máquina. Esas mismas propiedades permiten que un proceso de recuperación en el borde funcione sin conexión a Internet, y este sistema las aplica a las imágenes. FAISS sigue siendo la herramienta adecuada para comparar métodos de recuperación en un cuaderno de trabajo, y si quieres conocer con más detalle en qué casos son adecuadas FAISS y otras bibliotecas similares frente a una base de datos de producción, consulta «Las mejores bibliotecas de bases de datos vectoriales en Python».
Lo que estás construyendo
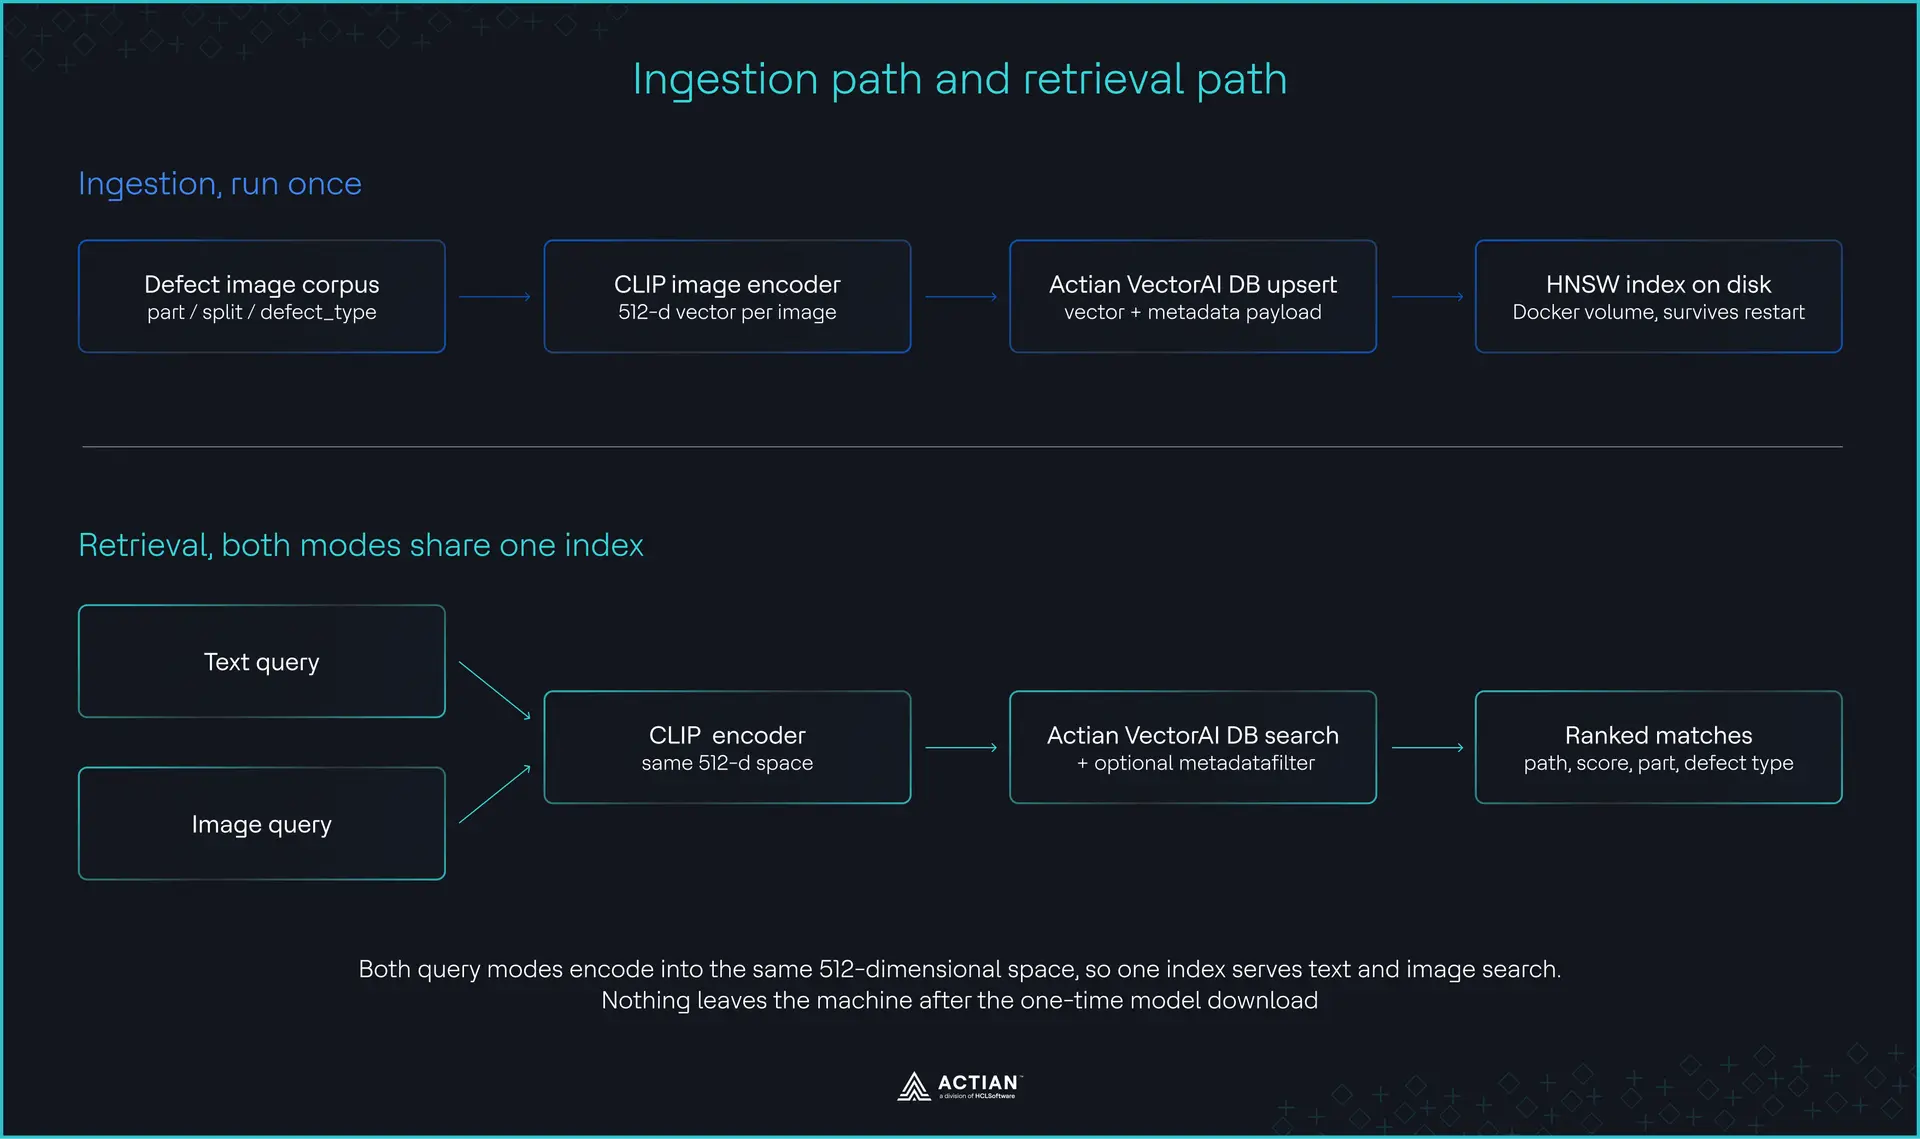
Crearás un único índice que responda a ambos tipos de consultas y que, una vez configurado, no realice llamadas de red.
Vía de ingestión y vía de recuperación
CLIP es lo que permite utilizar ambos modos desde un único índice. El openai/clip-vit-base-patch32 Checkpoint ejecuta un codificador de imágenes ViT-B/32 y un transformador de texto de doce capas, y luego proyecta ambos en el mismo espacio. Su conjuntos de configuración de modelos projection_dim hasta 512, por lo que tanto una fotografía como una frase se convierten en vectores de 512 dimensiones que comparten un mismo sistema de coordenadas. Ese simple hecho es la razón por la que una sola colección responde a ambas preguntas.
VectorAI DB almacena cada vector junto con una carga útil: part_category, defect_type, image_path, y un is_defect indicador. La carga útil es lo que convierte la función «buscar imágenes similares» en «buscar defectos similares en botellas, excluyendo las unidades en buen estado».
Hay una advertencia que conviene señalar antes de seguir adelante con esto. La propia ficha del modelo de OpenAI indica que CLIP no se desarrolló para su implementación general, recomienda realizar pruebas exhaustivas en el ámbito de aplicación antes de su uso práctico y señala que el rendimiento varía en función de cómo se diseñen las clases. La calidad de la recuperación es algo que debes medir, no dar por sentado. En la sección de pruebas comparativas se explica cómo hacerlo.
Una vez descargado el modelo, nada de lo que hay aquí se conecta a la red.
Configuración de la pila
Antes de indexar nada, es necesario tener los pesos CLIP en el disco, la base de datos en funcionamiento con un volumen montado y un corpus en el que realizar la búsqueda.
Crea el proyecto y añade las dependencias
Este tutorial utiliza UV, que resuelve y fija todo en un solo paso y garantiza que el entorno sea reproducible.
uv init defect-search
cd defect-search
uv add torch transformers pillow actian-vectorai-client matplotlib
Si, en cambio, utilizas pip, pip install torch transformers pillow actian-vectorai-client matplotlib instala los mismos paquetes, y cada uno uv run lo que aparece a continuación se convierte en un texto sin formato python llamada.
Descarga los pesos CLIP mientras el equipo aún tenga acceso a la red, ya que es posible que el equipo de fábrica nunca lo tenga:
uv run huggingface-cli download openai/clip-vit-base-patch32El punto de control ocupa unos 605 MB y se almacena en caché en ~/.cache/huggingface, donde from_pretrained lo encuentra en cada ejecución posterior. Para trasladarlo a un equipo aislado, copia ese directorio y configura HF_HUB_OFFLINE=1 por lo que la biblioteca nunca intenta conectarse a Internet.
Iniciar VectorAI DB
Crear un docker-compose.yml Archivo para instalar VectorAI DB:
services:
  vectorai:
    image: actian/vectorai:latest
    container_name: vectorai
    ports:
      - "6573:6573"   # REST API
      - "6574:6574"   # gRPC API, used by the Python SDK
      - "6575:6575"   # local web UI
    volumes:
      - ./vectorai_data:/var/lib/actian-vectorai
    environment:
      - ACTIAN_VECTORAI_ACCEPT_EULA=YES
    restart: unless-stopped
Inicia el contenedor ejecutando el siguiente comando:
docker-compose up -dDeberías ver el resultado:

Inicio de VectorAI DB
Las asignaciones de puertos y la variable EULA proceden del Guía de configuración de VectorAI DB en Docker. Antes de continuar, guarda esto como smoke_test.py y ejecútalo para comprobar las respuestas de la base de datos:
# smoke_test.py
from actian_vectorai import VectorAIClient

with VectorAIClient("localhost:6574") as client:
    print(client.health_check())
Ejecuta la prueba de la siguiente manera:
uv run smoke_test.pySi se muestran los datos del servidor en lugar de un error de conexión, la base de datos está lista.
Consigue un corpus
En este tutorial se utiliza MVTec AD, que contiene 5.354 imágenes de alta resolución repartidas en 15 categorías de objetos y texturas —cinco texturas y diez objetos—, con más de setenta tipos de defectos distintos.
Descárgalo de la página web de MVTec y descomprímelo en ./mvtec_ad.
Licencia del conjunto de datos: solo para investigación y evaluación. MVTec AD se distribuye bajo CC BY-NC-SA 4.0. MVTec indica que el conjunto de datos está destinado a fines de investigación no comerciales y no puede utilizarse con fines comerciales, por lo que, si estás desarrollando esto para una planta que comercializa lo que fabrica, no incluyas imágenes de MVTec en el producto. Nota ingest.py en tu propio archivo de inspección. Aquí nada depende de MVTec: el script lee cualquier directorio estructurado como <part_category>/<split>/<defect_type>/<image>, y scan_corpus Es la única función que debes modificar si la tuya es diferente.
Escribe el codificador compartido
Ambos scripts importan desde un mismo módulo, por lo que la ruta de la imagen y la del texto no pueden divergir.
# clip_encoder.py
from __future__ import annotations

from pathlib import Path
from typing import Sequence

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

MODEL_ID = "openai/clip-vit-base-patch32"
EMBED_DIM = 512


def _features(out) -> torch.Tensor:
    """
    transformers 4.x returns a Tensor from get_image_features and
    get_text_features. transformers 5.x returns a
    BaseModelOutputWithPooling whose pooler_output holds the
    projected vector. Handle both so this does not break on upgrade.
    """
    return out if isinstance(out, torch.Tensor) else out.pooler_output


class ClipEncoder:
    def __init__(self, model_id: str = MODEL_ID, device: str | None = None) -> None:
        self.device = device or ("cuda" if torch.cuda.is_available() else "cpu")
        self.model = CLIPModel.from_pretrained(model_id).to(self.device).eval()
        self.processor = CLIPProcessor.from_pretrained(model_id)

    @torch.inference_mode()
    def encode_images(self, paths: Sequence[str | Path]) -> torch.Tensor:
        images = [Image.open(p).convert("RGB") for p in paths]
        inputs = self.processor(images=images, return_tensors="pt").to(self.device)
        vecs = _features(self.model.get_image_features(**inputs))
        return torch.nn.functional.normalize(vecs, dim=-1).cpu()

    @torch.inference_mode()
    def encode_text(self, texts: Sequence[str]) -> torch.Tensor:
        inputs = self.processor(
            text=list(texts), return_tensors="pt", padding=True, truncation=True
        ).to(self.device)
        vecs = _features(self.model.get_text_features(**inputs))
        return torch.nn.functional.normalize(vecs, dim=-1).cpu()
Eso features La función auxiliar existe porque se modificó la versión 5.x de Transformers get_image_features para devolver un BaseModelOutputWithPooling objeto en lugar de un tensor. La llamada de una sola línea que aparece en la mayoría de los tutoriales publicados sobre CLIP ahora falla en una instalación nueva conAttributeError: 'BaseModelOutputWithPooling' object has no attribute 'shape', y la función auxiliar funciona en ambas versiones. Normalizar cada vector antes de devolverlo convierte la similitud coseno en un simple producto escalar.
Indexación del corpus de defectos
La ingesta codifica por lotes y actualiza o inserta cada vector junto con sus metadatos. La codificación CLIP es el cuello de botella; las escrituras en la base de datos no suponen ningún problema en comparación.
MVTec almacena los archivos como <part_category>/<split>/<defect_type>/<file>.png, lo que significa que la estructura de directorios ya contiene todos los campos de metadatos que necesitas:
# ingest.py
from __future__ import annotations

import argparse
import time
from pathlib import Path

from actian_vectorai import (
    VectorAIClient, PointStruct, VectorParams, Distance, CollectionExistsError,
)

from clip_encoder import ClipEncoder, EMBED_DIM

IMAGE_SUFFIXES = {".png", ".jpg", ".jpeg", ".bmp"}


def scan_corpus(root: Path) -> list[dict]:
    """Read metadata straight out of the directory layout."""
    records: list[dict] = []
    for path in sorted(root.rglob("*")):
        if path.suffix.lower() not in IMAGE_SUFFIXES:
            continue
        if "ground_truth" in path.parts:      # segmentation masks, not photos
            continue
        try:
            rel = path.relative_to(root)
            part_category, _split, defect_type = rel.parts[0], rel.parts[1], rel.parts[2]
        except (ValueError, IndexError):
            continue
        records.append(
            {
                "image_path": str(path),
                "part_category": part_category,
                "defect_type": defect_type,
                "is_defect": defect_type != "good",
            }
        )
    return records


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--data", default="./mvtec_ad")
    ap.add_argument("--collection", default="defect_search")
    ap.add_argument("--url", default="localhost:6574")
    ap.add_argument("--batch-size", type=int, default=32)
    args = ap.parse_args()

    records = scan_corpus(Path(args.data))
    if not records:
        raise SystemExit(f"No images found under {args.data}")
    print(f"Found {len(records)} images")

    encoder = ClipEncoder()
    print(f"CLIP running on {encoder.device}")

    with VectorAIClient(args.url) as client:
        try:
            client.collections.create(
                args.collection,
                vectors_config=VectorParams(size=EMBED_DIM, distance=Distance.Cosine),
            )
            print(f"Created collection '{args.collection}'")
        except CollectionExistsError:
            print(f"Collection '{args.collection}' already exists, appending")

        started = time.perf_counter()
        done = 0

        for start in range(0, len(records), args.batch_size):
            batch = records[start : start + args.batch_size]
            vectors = encoder.encode_images([r["image_path"] for r in batch])

            client.points.upsert(
                args.collection,
                points=[
                    PointStruct(id=start + offset, vector=vec.tolist(), payload=record)
                    for offset, (record, vec) in enumerate(zip(batch, vectors))
                ],
            )

            done += len(batch)
            elapsed = time.perf_counter() - started
            rate = done / elapsed if elapsed else 0.0
            remaining = (len(records) - done) / rate if rate else 0.0
            print(
                f"\r{done}/{len(records)} images "
                f"| {rate:.1f} img/s | ~{remaining/60:.1f} min left",
                end="", flush=True,
            )

        print(f"\nIndexed {done} images in {(time.perf_counter()-started)/60:.1f} min")
        print(f"Collection now holds {client.points.count(args.collection)} points")


if __name__ == "__main__":
    main()
Algunas líneas de ese script parecen elecciones arbitrarias, pero modificarlas causaría problemas. scan_corpus se salta el ground_truth carpetas porque contienen máscaras de píxeles, y las máscaras de indexación llenan los resultados de formas en blanco y negro que no se corresponden con nada de lo que produce una cámara. La colección se crea con 512 dimensiones y distancia coseno para adaptarse al codificador, y una discrepancia en este punto no genera ningún error, sino solo resultados de búsqueda que, poco a poco, dejan de tener sentido.
El except cláusulas de captura CollectionExistsError precisamente porque un simple except Exception También ocultaría una conexión rechazada o un conflicto de dimensiones, y lo que quieres es que un conflicto de dimensiones detenga el script inmediatamente, en lugar de que se manifieste semanas más tarde en forma de resultados erróneos.
Ejecuta la ingesta:
uv run ingest.py --data ./mvtec_ad
Found 5354 images
CLIP running on cpu
Created collection 'defect_search'
5354/5354 images | 2.1 img/s | ~0.0 min left
Indexed 5354 images in 42.5 min
Collection now holds 5354 points
Calcula entre 45 y 90 minutos para el corpus completo en un equipo que utilice únicamente la CPU, y unos pocos minutos en una GPU moderna. La ejecución anterior se realizó en un Ryzen 7 5800X con 32 GB de RAM, utilizando únicamente la CPU. Un tamaño de lote de 32 es un valor predeterminado razonable; auméntalo si dispones de VRAM libre.
La comprobación de persistencia
Esta es la diferencia con respecto a FAISS, y se tarda diez segundos en demostrarlo:
docker compose restart
uv run query.py --text "cracked surface"
Los resultados se obtienen de inmediato para los 5.354 vectores. No se vuelve a codificar nada, ya que el índice se fue escribiendo en el volumen montado a medida que se creaba, en lugar de generarse una instantánea al final.
Ejecución de consultas
Ambos modos de consulta siguen los mismos tres pasos: codificación, filtrado y búsqueda. Lo único que cambia es el codificador.
# query.py
from __future__ import annotations

import argparse
import time

from actian_vectorai import VectorAIClient, FilterBuilder, Field

from clip_encoder import ClipEncoder

COLLECTION = "defect_search"   # must match the name ingest.py created


def build_filter(part_category: str | None = None, defect_only: bool = False):
    """Metadata filter, applied inside the search rather than after it."""
    builder = FilterBuilder()
    if part_category:
        builder = builder.must(Field("part_category").eq(part_category))
    if defect_only:
        builder = builder.must(Field("is_defect").eq(True))
    return None if builder.is_empty() else builder.build()


def search_by_text(client, encoder, text, part_category=None, defect_only=False, limit=5):
    vector = encoder.encode_text([text])[0].tolist()
    return client.points.search(
        COLLECTION, vector, limit=limit,
        filter=build_filter(part_category, defect_only), with_payload=True,
    )


def search_by_image(client, encoder, image_path, part_category=None, defect_only=False, limit=5):
    vector = encoder.encode_images([image_path])[0].tolist()
    return client.points.search(
        COLLECTION, vector, limit=limit,
        filter=build_filter(part_category, defect_only), with_payload=True,
    )


def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--text")
    ap.add_argument("--image")
    ap.add_argument("--part-category")
    ap.add_argument("--defect-only", action="store_true")
    ap.add_argument("--limit", type=int, default=5)
    args = ap.parse_args()
    if not args.text and not args.image:
        raise SystemExit("Pass --text or --image")

    encoder = ClipEncoder()
    with VectorAIClient("localhost:6574") as client:
        t0 = time.perf_counter()
        if args.text:
            results = search_by_text(client, encoder, args.text,
                                     args.part_category, args.defect_only, args.limit)
        else:
            results = search_by_image(client, encoder, args.image,
                                      args.part_category, args.defect_only, args.limit)
        total = (time.perf_counter() - t0) * 1000

    print(f"  score  {'category':<12} {'defect':<16} path")
    for r in results:
        p = r.payload
        print(f"{r.score:7.4f}  {p['part_category']:<12} {p['defect_type']:<16} {p['image_path']}")
    print(f"\ntotal {total:.1f} ms")


if __name__ == "__main__":
    main()
El COLLECTION El nombre debe coincidir con lo que ingest.py se crea, o bien todas las búsquedas fallan con un error de «colección no encontrada», mientras que los datos permanecen intactos en la base de datos. También merece la pena echar un segundo vistazo al generador de filtros: FilterBuilder.must() Acepta una condición por llamada y devuelve el constructor, por lo que se encadenan las llamadas para añadir condiciones en lugar de pasar varias a la vez.
Realiza cualquiera de los dos tipos de búsqueda desde la línea de comandos:
uv run query.py --text "surface scratch on metal component" --part-category metal_nut
uv run query.py --image ./line_capture_0412.png --defect-only
Si las estaciones de inspección deben acceder al sistema a través de la red en lugar de ejecutar Python localmente, se puede instalar un pequeño servicio FastAPI delante de él. Esta parte es opcional:
# app.py  (optional)
from fastapi import FastAPI
from actian_vectorai import VectorAIClient
from clip_encoder import ClipEncoder
from query import search_by_text

app = FastAPI()
encoder = ClipEncoder()          # load once at startup, not on every request
client = VectorAIClient("localhost:6574")
client.connect()


@app.get("/search")
def search(q: str, part_category: str | None = None, limit: int = 5):
    hits = search_by_text(client, encoder, q, part_category=part_category, limit=limit)
    return [
        {"score": h.score, "path": h.payload["image_path"], "defect_type": h.payload["defect_type"]}
        for h in hits
    ]
En este momento, ambos tipos de búsqueda funcionan con un único índice filtrado sin dependencia de la red, por lo que puedes hacer que busquen en tus propias fotos de inspección con VectorAI DB Community Edition antes de consultar las cifras de rendimiento.
El punto de referencia
Mide dos cosas: cómo evoluciona la latencia de la búsqueda a medida que crece el corpus y si los resultados son correctos.
benchmark.py ejecuta 100 consultas por tamaño de corpus y proporciona los valores p50 y p99; a continuación, calcula el Recall@5 con respecto a la división de prueba de MVTec. Un resultado se considera un acierto cuando al menos uno de los cinco vecinos principales comparte el tipo de defecto de la imagen de consulta:
# benchmark.py
def measure_recall_at_k(client, encoder, collection, test_records, k=5) -> float:
    hits = 0
    for record in test_records:
        vec = encoder.encode_images([record["image_path"]])[0].tolist()
        results = client.points.search(
            collection, vector=vec, limit=k + 1, with_payload=True
        )
        neighbours = [
            r for r in results if r.payload["image_path"] != record["image_path"]
        ][:k]
        if any(r.payload["defect_type"] == record["defect_type"] for r in neighbours):
            hits += 1
    return hits / len(test_records) if test_records else 0.0
Excluir la imagen de consulta no es opcional. Si la dejas incluida, todas las consultas se recuperan con una similitud de 1,0, y el Recall@5 se sitúa en el 100 %, independientemente del rendimiento del modelo.
Hay dos normas que regulan cómo se deben presentar las cifras.
Hay que diferenciar la latencia de búsqueda de la latencia de codificación. Su evolución es diferente, y promediarlas no aporta información sobre ninguna de las dos. La búsqueda en la base de datos crece mucho más lentamente que el corpus porque el recorrido HNSW es sublineal. La codificación CLIP es constante por consulta y, en la CPU, predomina sobre el total. Preséntalas por separado; de lo contrario, tu gráfico medirá el modelo en lugar de la base de datos.
Indica el hardware y nunca mezcles las ejecuciones de CPU y GPU en una misma tabla. Una cifra de latencia sin ningún equipo asociado no es una medición, y que el tiempo de codificación de la CPU aparezca en la misma columna que el de la GPU es peor que no indicar ningún valor. make_chart.py toma la cadena de hardware como argumento obligatorio precisamente por ese motivo:
uv run benchmark.py --out benchmark.csv
uv run make_chart.py --csv benchmark.csv --hardware "Ryzen 7 5800X, 32GB RAM, CPU-only"
Esta es la tendencia que cabe esperar, calculada con 100 consultas por tamaño de corpus, tomando como referencia el índice plano de FAISS:
| Corpus | VectorAI DB p50 | VectorAI DB, pág. 99 | FAISS plano p50 | FAISS plano p99 | Recall@5 |
|---|---|---|---|---|---|
| 1,000 | 0,148 ms | 0,198 ms | 0,053 ms | 0,112 ms | 1.000 |
| 5,000 | 0,676 ms | 0,725 ms | 0,410 ms | 0,462 ms | 0.996 |
| 10,000 | 1,036 ms | 1,272 ms | 0,809 ms | 0,863 ms | 0.974 |
Hardware: indica tu CPU, RAM y si CLIP se ejecutó en la CPU o en la GPU. Solo tiempo de búsqueda; se excluye la codificación de CLIP.
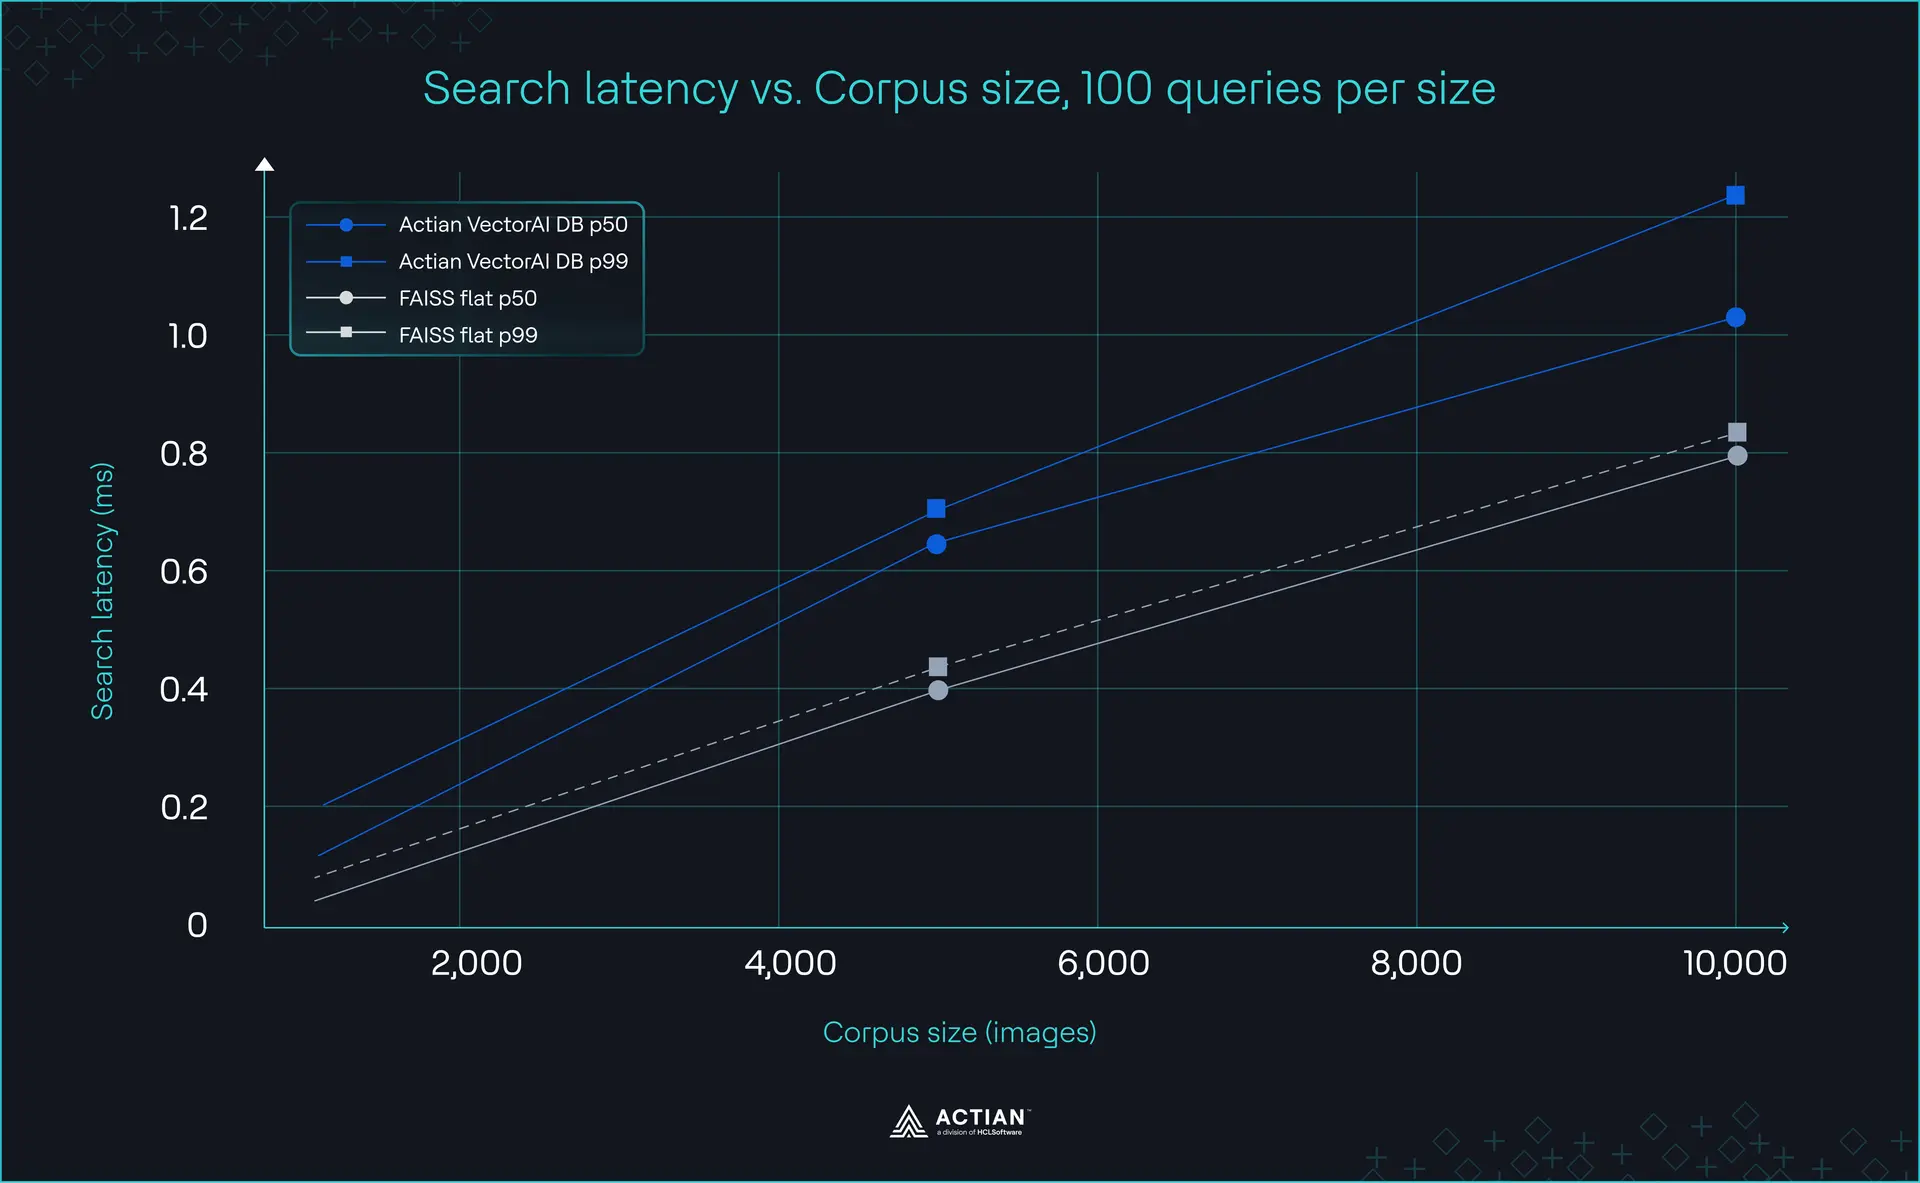
Gráfico de latencia: p50/p99 frente al tamaño del corpus, generado a partir de los resultados de la prueba de rendimiento
FAISS sale ganando en cuanto al tiempo de búsqueda bruto a esta escala, y esa es la conclusión sincera. Un índice plano de más de diez mil vectores supone un producto escalar por fuerza bruta en el mismo proceso, sin grafos que recorrer ni transporte entre la consulta y los vectores. VectorAI DB responde a través de gRPC, por lo que cada cifra de sus columnas conlleva un coste fijo por llamada. El Recall@5 se mantiene en 0,974 o por encima en todo momento, por lo que la calidad de la recuperación no es lo que se está sacrificando.
A cambio de una fracción de milisegundo, obtienes filtrado de metadatos, escrituras duraderas y un servicio al que pueden acceder varias máquinas a la vez. En un corpus de este tamaño, ese coste es insignificante. Y sigue siendo insignificante a medida que el corpus crece, ya que el índice plano escala linealmente con el número de vectores, mientras que el índice de grafo no lo hace.
La operación «filtered-HNSW» es la cifra que más te sorprenderá.
Este es el coste al que se refería la sección FAISS. Se procesaron 20 000 vectores con un filtro que admite el uno por ciento del corpus, y se compararon los resultados con una búsqueda filtrada exacta como referencia:
| efSearch | Resultados encontrados (de 10) | Recall@10 | ms/consulta |
|---|---|---|---|
| 16 (por defecto) | 9.0 | 0.17 | 0.12 |
| 64 | 10.0 | 0.39 | 0.35 |
| 256 | 10.0 | 0.77 | 1.11 |
| 1024 | 10.0 | 0.99 | 2.62 |
Con la configuración predeterminada, la búsqueda filtrada omite la mayor parte de los resultados que debería mostrar y no siempre consigue completar el conjunto de resultados. Para conseguir una recuperación superior a 0,95 se necesitó efSearch 64 veces más que el valor por defecto y aumentó el tiempo de consulta de 0,12 ms a 2,62 ms. El filtro funciona, hay que pagarlo y hay que saber cómo ajustarlo.
Hay que tener en cuenta dos matizaciones sobre esa tabla. Procede de un contenedor Intel Xeon en el que se ejecuta faiss-cpu 1.15.0, y utiliza vectores gaussianos aleatorios, que se acercan al peor de los casos para el recorrido de grafos. Las incrustaciones reales de CLIP se agrupan, por lo que tu recuperación en un efSearch quedará mejor. Reprodúcelo en tus propios vectores con filter_recall_test.py antes de ajustar el tamaño de cualquier elemento en ella.
En cuanto al almacenamiento: con 512 dimensiones en float32, una incrustación ocupa 2 KB, por lo que todo el corpus de MVTec supone unos 11 MB de vectores frente a aproximadamente 5 GB de imágenes originales. El almacenamiento de características no es la limitación, que es donde suelen equivocarse las implementaciones industriales. Planifica, en cambio, en función del rendimiento de la codificación. A un ritmo de dos imágenes por segundo en la CPU, un archivo de 50 000 imágenes se procesa en un fin de semana. Solo hay que pagar una vez, a menos que se cambien los modelos de incrustación, ya que los vectores de dos modelos diferentes no son comparables, ni siquiera con dimensiones idénticas.
Preguntas frecuentes
¿Qué es CLIP y cómo funciona en la búsqueda de imágenes?
CLIP es un modelo de OpenAI entrenado con pares de imágenes y leyendas que aprende a situar una imagen y su descripción cerca una de otra en un espacio vectorial compartido. Para la búsqueda, ese espacio compartido es la clave: se codifica el corpus de imágenes una sola vez y, en el momento de la recuperación, se codifica bien una consulta de texto o bien una imagen de consulta, y se compara mediante la similitud coseno. La variante utilizada aquí,clip-vit-base-patch32, genera vectores de 512 dimensiones y se ejecuta en una CPU.
¿Cómo puedo buscar imágenes de defectos de fabricación por similitud visual?
Codifica todas las imágenes de tu archivo con el codificador de imágenes de CLIP y almacena los vectores en una base de datos junto con metadatos como la categoría de la pieza y el tipo de defecto. Cuando un operador detecte un nuevo defecto, codifica esa fotografía de la misma manera y realiza una búsqueda del vecino más cercano. Los resultados son imágenes anteriores que tienen un aspecto similar, ordenadas por similitud coseno, lo que en la práctica significa defectos similares en piezas similares.
¿Puedo utilizar la búsqueda de imágenes de CLIP sin conexión, sin necesidad de un servicio en la nube?
Sí, y esa es la configuración que se describe aquí. Los pesos de CLIP se descargan una sola vez (unos 605 MB) y, a continuación, se ejecutan localmente en la CPU o la GPU. VectorAI DB se ejecuta como un contenedor de Docker en tu propio hardware. Tras la descarga inicial, ninguna imagen, consulta o representación sale de la máquina, lo que hace que este enfoque sea viable en una planta aislada de la red.
¿Cuál es la diferencia entre FAISS y VectorAI DB para la búsqueda de imágenes?
FAISS es una biblioteca de búsqueda por similitud que almacena vectores e identificadores enteros dentro de un mismo proceso. Se guarda en disco mediantewrite_index, y filtra por ID a través de IDSelector, al contrario de lo que se suele afirmar. No almacena metadatos junto con los vectores, no filtra por campos con nombre ni da servicio a varios procesos. VectorAI DB hace esas tres cosas, que es lo que realmente significa en la práctica la distinción entre «base de datos, no un índice».
Pruébalo con tu propio corpus:
docker pull actian/vectorai:latestLa edición Community es de autoalojamiento y gratuita hasta 5.000 vectores, lo que cubre casi exactamente el corpus de MVTec. La documentación aborda el ajuste de la recopilación y la sintaxis de los filtros, y el canal de Discord de Actian es el lugar donde los usuarios que utilizan esta pila intercambian opiniones.
Mantente conectado
Te ofrecemos información detallada sobre los datos.
(por ejemplo, sales@..., support@...)
