
¿Qué son los agentes de IA que evolucionan por sí mismos?


Principales conclusiones
- Los agentes autoevolutivos mejoran con el tiempo modificando las instrucciones, la memoria, las herramientas o los flujos de trabajo en función de la experiencia contrastada.
- A diferencia de los agentes estáticos, los cambios que tienen éxito persisten e influyen en el comportamiento del agente en ejecuciones futuras.
- La memoria semántica persistente permite a los agentes recordar fallos similares y reutilizar soluciones que han demostrado su eficacia, en lugar de empezar desde cero.
- Regenesis, Rewire y Gradient desarrollaron diferentes partes de sus pilas de tecnología basándose en señales externas de corrección.
- Actian VectorAI DB ofrece almacenamiento persistente, recuperación semántica y escritura diferida verificada para facilitar la superación continua de los agentes.
Los agentes autoevolutivos modifican parte de su propia pila —ya sean indicaciones, memoria, herramientas o el propio gráfico de flujo de trabajo— basándose en la experiencia y la retroalimentación, en lugar de permanecer fijos tras su implementación. Es casi seguro que el agente que tienes en producción ahora mismo no funciona así. Sus indicaciones son fijas, sus herramientas están preconfiguradas y, cuando falla, revisas el seguimiento, editas la configuración y lanzas una nueva versión.
Eso no significa que los agentes autoevolutivos vuelvan a entrenar su modelo tras cada tarea. Significa que algún elemento de la pila del agente puede cambiar en función de lo ocurrido durante interacciones anteriores. Si estás creando agentes que permanecen desplegados, la diferencia es práctica: un agente estático trata cada tarea como si fuera nueva, mientras que un agente autoevolutivo aprovecha la experiencia verificada, reduce las correcciones manuales y mejora la fiabilidad con el tiempo. Esa experiencia acumulada reside en la capa de recuperación situada debajo del agente, lo cual es una de las razones por las que las cargas de trabajo de los agentes están obligando a replantearse la arquitectura de las bases de datos vectoriales y la forma en que los equipos eligen una biblioteca sobre la que desarrollar.
En el Hackathon de Agentes Autoevolutivos, organizado por tokens& en San Francisco en julio de 2026, tres equipos demostraron este patrón de diferentes maneras. Regenesis hizo evolucionar su configuración de reglas. Rewire hizo evolucionar su grafo de conversación. Gradient hizo evolucionar sus clústeres taxonómicos. Las implementaciones eran diferentes, pero compartían un requisito: una memoria persistente y consultable que permitiera al agente aprovechar la experiencia la próxima vez que actuara.
Este artículo muestra qué es lo que realmente cambia en el interior de la arquitectura y cómo evolucionaron esas tres versiones cuando se les sometió a una señal de corrección real.
La mayoría de los agentes de IA no aprenden de la experiencia
La mayoría de los agentes de IA que se utilizan hoy en día cuentan con indicaciones fijas, herramientas preconfiguradas y un comportamiento estático. Cuando uno comete un error, un humano revisa el registro, modifica la indicación y vuelve a ponerlo en marcha. El propio agente no aprende de ese fallo.
Fíjate en lo que hace tu agente al procesar una sola solicitud hoy en día. Observa unos datos de entrada, los analiza, recurre a una o dos herramientas, genera una respuesta y finaliza. Cada uno de esos pasos lee información de una configuración en la que el agente no puede escribir. La línea de comandos es una constante de cadena en tu repositorio. La lista de herramientas es una matriz fija. El índice de recuperación es el que hayas introducido en el momento de la compilación.
Ese diseño es intencionado y, desde hace mucho tiempo, acertado. Las constantes son predecibles, y la previsibilidad es lo que hace que un agente sea seguro a la hora de ponerlo en contacto con los clientes.
El coste se hace patente en el segundo fallo. Como nada ha cambiado en la propia pila del agente tras el primero, la misma entrada produce el mismo resultado erróneo. Un agente que inventa un precio el lunes lo vuelve a inventar el martes. Cada fallo se reinicia a cero, y los mismos errores se repiten de una sesión a otra. La única vía de mejora pasa por una persona, una revisión del código y una implementación. Tu organización aprende. Tu agente, no.
¿Qué hace que un agente sea capaz de evolucionar por sí mismo?
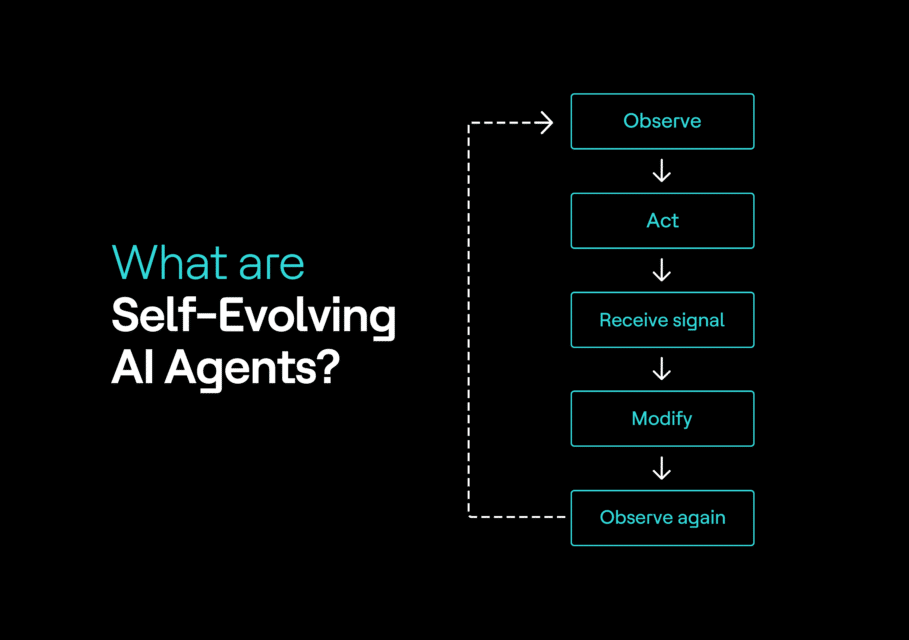
Un agente que evoluciona por sí mismo funciona mediante un bucle de retroalimentación cerrado: observar, actuar, recibir una señal, modificar. Eso lo convierte en un sistema de aprendizaje continuo, en lugar de uno fijo. Una parte de su propia pila cambia en función de la experiencia, en lugar de mediante una intervención manual.
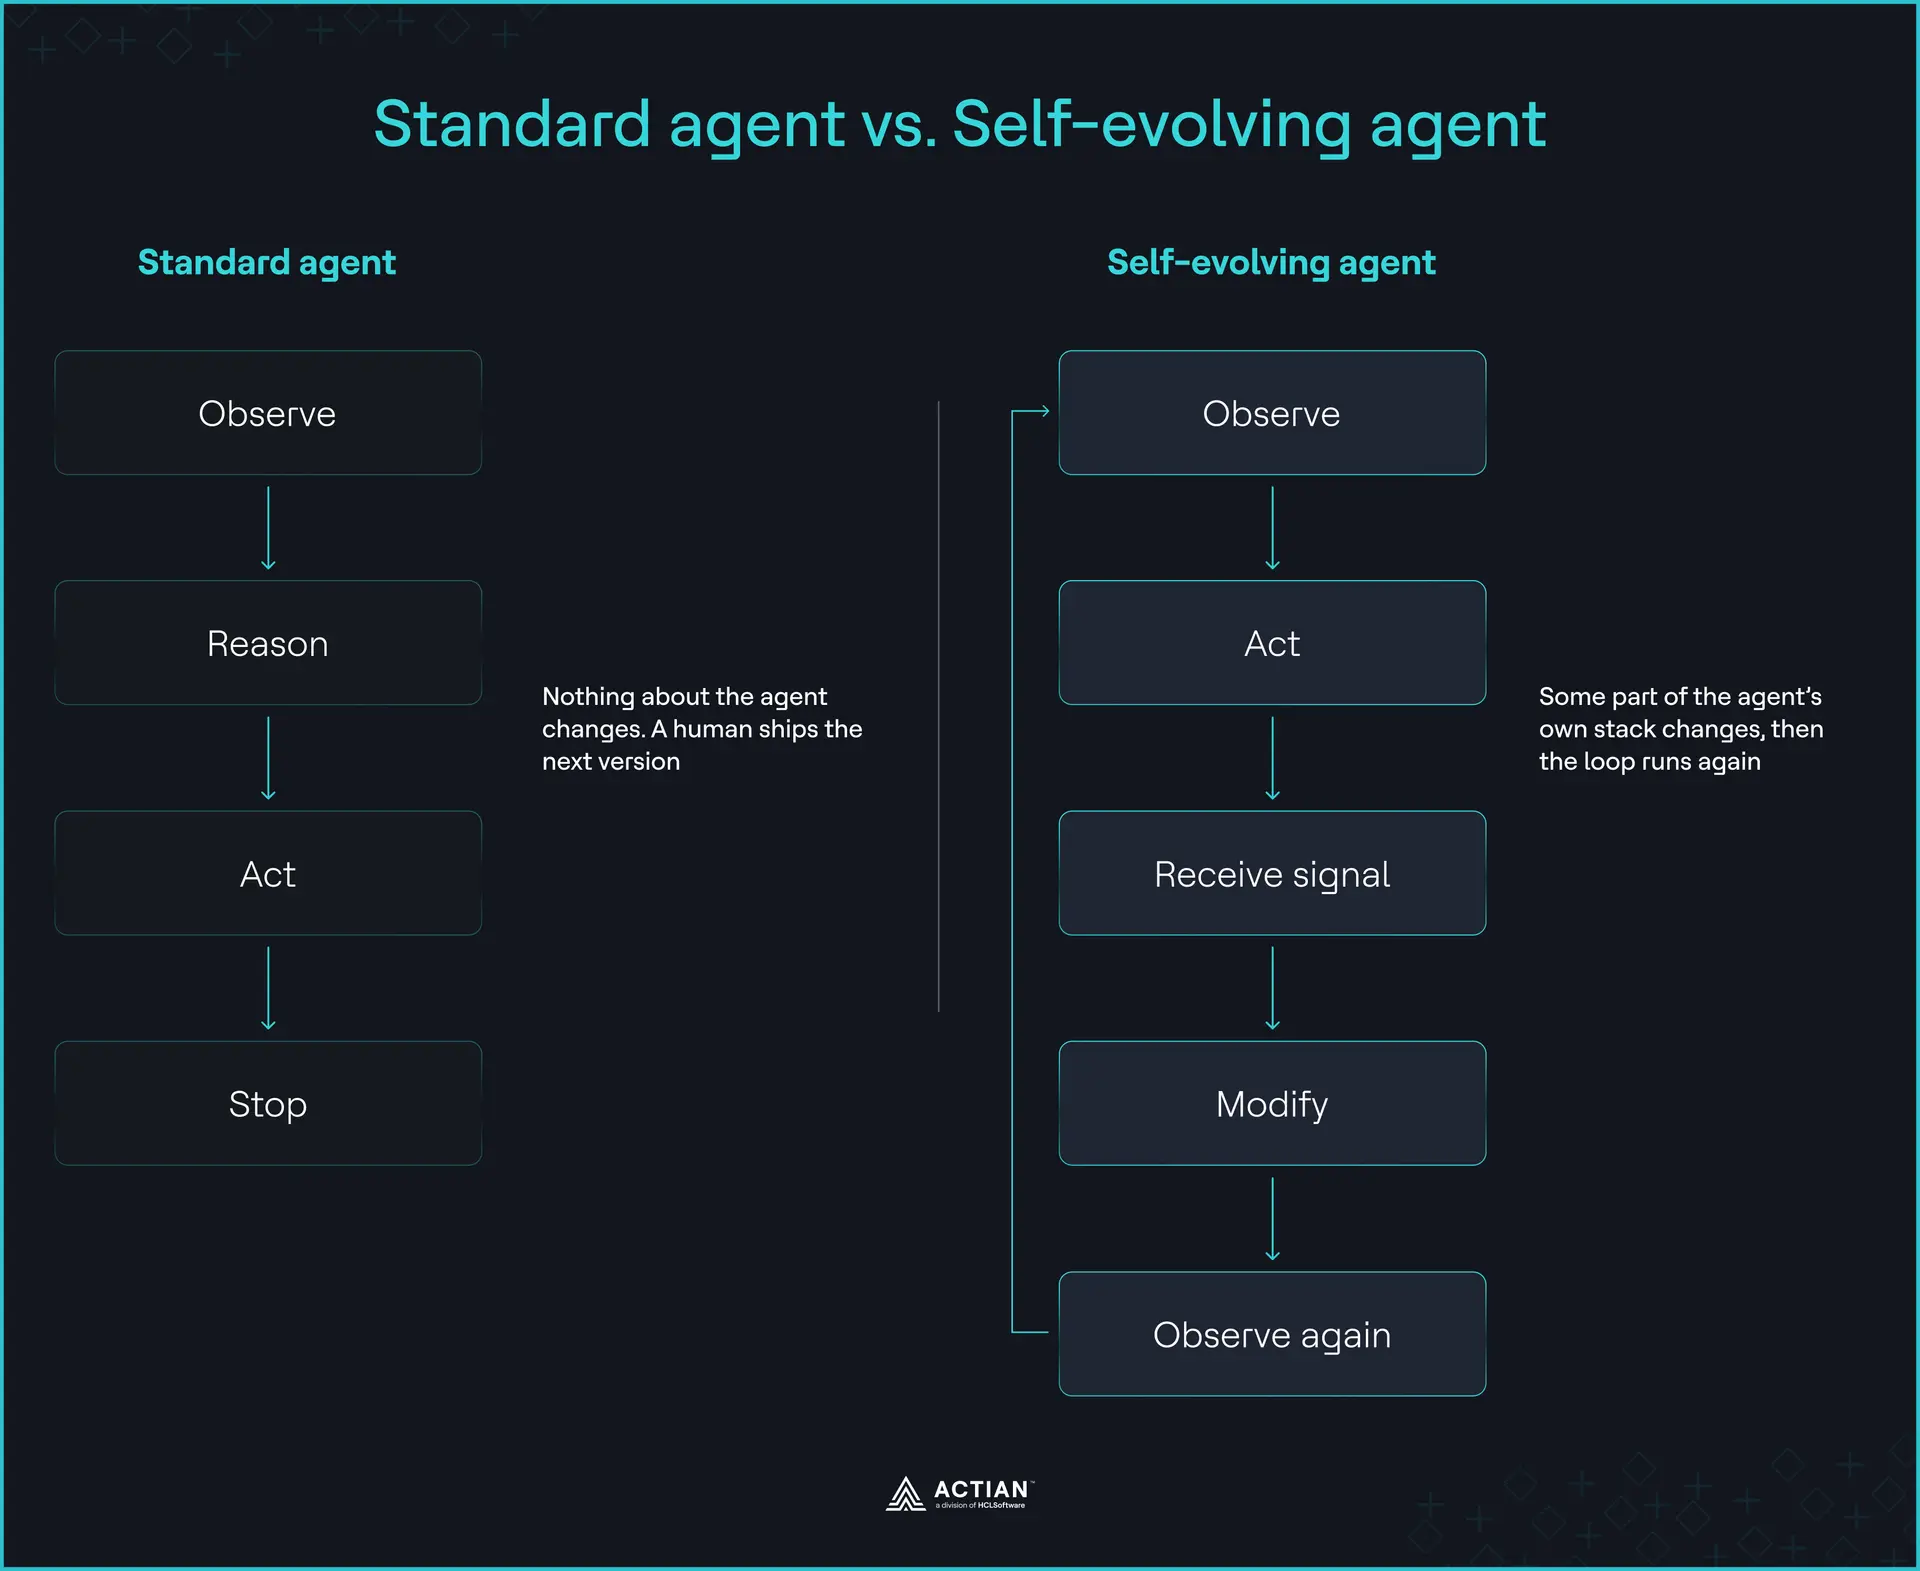
Un agente estándar finaliza tras una sola pasada. Un agente autoevolutivo cierra el bucle sobre sí mismo.
La palabra clave es «modificar». Un agente estándar modifica su resultado, que no es más que una inferencia. Un agente autoevolutivo se modifica a sí mismo, lo que significa que el artefacto que ha generado el resultado es diferente en la siguiente ejecución de lo que era en esta. Esa es toda la diferencia, y es de carácter estructural más que filosófico.
Desde el punto de vista estructural, todo se reduce a qué partes de tu pila son modificables dentro del marco del agente. En un agente estándar, las indicaciones, las reglas de decisión y la memoria del agente son constantes que solo pueden modificarse mediante una implementación. En un agente que evoluciona por sí mismo, al menos una de esas partes es modificable. Esa parte modificable necesita una ruta de escritura definida, una señal que autorice el cambio y un almacenamiento duradero para el resultado.
Ese tercer requisito es el que los equipos subestiman. Una modificación que el agente no puede recordar en la siguiente ejecución no es evolución; es un nuevo intento. El bucle solo se cierra si el cambio persiste en algún lugar que el agente consulte antes de volver a actuar, de modo que pueda adaptarse a las señales de su entorno.
La señal es igual de importante. Un agente que reescribe sus propias instrucciones basándose únicamente en su propia confianza acabará, sin dudarlo, por converger en una conclusión errónea, pero de la que estará convencido. Cada versión que se analiza a continuación se somete a un oráculo de corrección externo como parte de su evaluación. Ese oráculo puede ser una especificación de seguridad aprobada, una base de conocimientos verificada o una persona que pulse «aceptar» o «rechazar».
¿Qué puede evolucionar, cuándo y cómo?
Los agentes autoevolutivos pueden modificar diferentes partes de la pila, en distintos momentos y mediante distintos mecanismos. La tabla siguiente desglosa qué cambia, cuándo cambia y cómo se aplica el cambio. En primer lugar, decide qué debe ser modificable. A continuación, decide cuándo debe producirse ese cambio. Solo después de eso debes elegir el mecanismo que haga que el cambio se mantenga.
| Eje | Opciones | Ejemplo de compilación |
|---|---|---|
| ¿Qué evolucionar | Parámetros del modelo, indicaciones, memoria, herramientas y habilidades, gráficos de flujo de trabajo | Regenesis desarrolló una configuración de reglas; Rewire desarrolló un gráfico de conversación; Gradient desarrolló grupos taxonómicos |
| Cuando evolucionar | Intra-tarea (dentro de una misma ejecución) o inter-tarea (entre ejecuciones) | Regenesis se modifica en el transcurso de un ciclo de curación; Gradient actualiza los grupos tras cada aceptación o rechazo. |
| ¿Cómo evolucionar | Eliminación basada en la repetición, recuperación de la memoria antes de la acción, reescritura de la retroalimentación | Rewire eliminó a 27 de los 33 candidatos repitiendo la historia; Regenesis consulta la memoria antes de aplicar los parches; Gradient vuelve a escribir las decisiones de aceptación o rechazo en sus clústeres. |
Qué mejorar. Cinco opciones, ordenadas aproximadamente según su dificultad de implementación. Los parámetros del modelo son los más difíciles, ya que modificarlos implica volver a entrenar el modelo o ajustarlo. Eso los convierte en un proceso lento, costoso y de alcance global. Las indicaciones son las más accesibles, razón por la cual los marcos de optimización de indicaciones fueron los primeros en aparecer. Sin embargo, reescribir una indicación sigue siendo un método poco preciso. La memoria es el bucle más rápido y el más específico, ya que escribir un hecho verificado cambia la recuperación de información sin alterar nada más. Las herramientas y las habilidades son acumulativas: el agente adquiere una capacidad que no tenía y puede generar o integrar nuevas herramientas con el tiempo. Los gráficos de flujo de trabajo son estructurales, ya que modifican nodos y aristas en lugar de texto. Por eso son importantes para los flujos de trabajo agentivos y operativos.
Un ejemplo es EvoAgentX, que genera flujos de trabajo multiagente a partir de indicaciones y los optimiza mediante algoritmos que evolucionan por sí mismos.
Para la mayoría de los equipos, la memoria es el punto de partida adecuado. Es la única de las cinco en la que revertir una escritura errónea no supone un gran coste.
Cuándo realizar cambios. «Intra-tarea» significa que el agente modifica algo dentro de una misma ejecución, antes de que esta finalice. «Inter-tarea» significa que el cambio se produce entre ejecuciones y se refleja en la siguiente. La modificación «inter-tarea» es más segura y habitual, ya que permite validar el cambio antes de que ningún elemento posterior dependa de él. La modificación «intra-tarea» reacciona más rápido y es mucho más fácil cometer errores, ya que una modificación a mitad de la ejecución no tiene un punto de reversión claro.
Cómo evolucionar. Hay tres mecanismos que abarcan la mayor parte de lo que funciona en la práctica. La eliminación basada en la repetición es una estrategia de búsqueda: genera varios cambios posibles y los comprueba uno a uno con casos históricos, seleccionando únicamente aquel que soluciona el nuevo fallo sin provocar uno anterior. La recuperación de la memoria antes de actuar hace que el agente consulte primero su propio historial, de modo que un fallo conocido se resuelve a partir de la memoria en lugar de tener que redescubrirse. La retroalimentación por reescritura toma una señal verificada y la reescribe directamente en la capa de recuperación, remodelando lo que el agente mostrará la próxima vez.
En qué se ha transformado cada versión de SwarmHack
Las tres versiones se ejecutaron con datos reales frente a un oráculo de corrección externo, y no basándose en su propio nivel de confianza. Esto las convierte en pruebas útiles, ya que se situaron en tres puntos distintos del marco anterior y abordaron la misma restricción desde tres perspectivas diferentes.
| Construir | En qué se convirtió | Cómo lo hizo posible VectorAI DB |
|---|---|---|
| Regenesis | La configuración de las reglas, considerada como un genoma mutable | Historial de fallos guardado y función de recuperación de la memoria activada antes de aplicar el parche |
| Rewire | El gráfico de conversación dentro de un entorno de ejecución de voz en tiempo real | Se han clasificado los fallos por tipo y se han reproducido las llamadas históricas comparándolas con las soluciones de la competencia. |
| Gradiente | Los grupos taxonómicos utilizados para la búsqueda | Almacenó las señales de aceptación o rechazo y las utilizó para modificar la recuperación futura |
Regenesis ejecutaba una aplicación de planificación de turnos hospitalarios en un bucle cerrado de autorreparación. El equipo dividió la aplicación en dos partes: las reglas son mutables y un agente puede reescribirlas, mientras que las invariantes son una especificación de seguridad inmutable y aprobada. Un oráculo audita la aplicación en ejecución comparándola con esa especificación fija, por lo que las infracciones que notifica se calculan en lugar de estar predefinidas. A continuación, el agente consulta su propia memoria antes de aplicar los parches, y solo las correcciones exitosas se recogen como soluciones. Una clase de defecto que ya haya detectado anteriormente se resuelve directamente desde la memoria, en lugar de volver a diagnosticarse.
Rewire abordó un modo de fallo que la simple recuperación no puede solucionar. Su agente de voz generó un precio que contradecía la base de conocimientos, pero la causa no fue una recuperación defectuosa: la instrucción del nodo permitía responder sin recurrir en absoluto a la herramienta de búsqueda. Solucionar eso implica modificar la instrucción, no el índice. Así pues, el sistema transforma el gráfico de conversación, compara las respuestas posibles con llamadas anteriores y selecciona únicamente aquella que corrige el nuevo fallo sin provocar otro anterior. Dado que cada corrección que se mantiene se almacena en función de la estructura del fallo y no de su tema, una solución aprendida sobre los precios de los frenos resolvió posteriormente un copago sanitario en un ámbito que casi no compartía vocabulario con el anterior.
Gradiente convirtió datos de publicaciones en redes sociales ya clasificados en planes de interés y desarrolló su propia taxonomía a partir de señales reales de aceptación o rechazo y de los comentarios de los usuarios. Cuando un usuario acepta o rechaza un elemento, esa señal se registra en el almacén de vectores y reestructura los clústeres que el agente recupera en la siguiente pasada, generándose automáticamente nuevas categorías a medida que cambia la taxonomía. Toda la pila se ejecuta localmente, con incrustaciones a través de nomic-embed-text-v1.5 y generación mediante un proceso cuantificado Qwen3 modelo. No se vuelve a entrenar nada. El cambio de comportamiento se debe exclusivamente a que la capa de recuperación se reorganiza en torno a señales verificadas.
En conjunto, estas analíticas apuntan a un patrón que se observa en la planificación de intereses en los ámbitos de la asistencia sanitaria, los agentes de voz y las publicaciones en redes sociales.
Por qué la memoria es la capa fundamental
Todas las implementaciones que dieron lugar a una evolución auténtica compartían una característica: el agente consultaba su propio historial antes de actuar, lo que convertía a la memoria en el mecanismo para una verdadera superación personal, en lugar de un bucle de reintentos. Eso es lo que impone unos requisitos específicos a tu capa de memoria.
Hay tres características que son imprescindibles en la tienda que elijas. La memoria debe persistir entre sesiones; de lo contrario, el agente se reinicia desde cero y vuelve a aprender lo que ya sabía. Debe poder consultarse por similitud semántica, ya que el siguiente fallo nunca es idéntico, ni siquiera en un solo byte, al anterior. Y debe poder escribirse en respuesta a señales verificadas, de modo que la reescritura forme parte de una autoevolución continua, en lugar de una actualización puntual basada en lo que el agente creía en ese momento.
Una base de datos convencional cumple el primer requisito, pero no el segundo. La búsqueda por coincidencia exacta solo se activa cuando el nuevo caso es idéntico al almacenado, lo que rara vez ocurre en el caso de los fallos de los agentes en condiciones de aprendizaje abierto. La recuperación semántica permite la generalización, y Rewire es la demostración más clara de ello: se recuperó un parche aprendido sobre los precios de los frenos para un fallo relacionado con el copago sanitario, ya que ambos fallos eran estructuralmente similares, no textualmente. Ningún índice de palabras clave encuentra eso.
El reentrenamiento no es la alternativa que la mayoría de los equipos creen que es. El ajuste fino es lento, caro y global, y los enfoques más intensivos, como el aprendizaje por refuerzo o las actualizaciones generales de parámetros, son aún más difíciles de aislar y muy complicados de revertir. La evolución de la memoria es específica, rápida y reversible: se define un punto, se delimita un comportamiento y se elimina si resulta ser incorrecto.
Ese es el sustrato sobre el que se ejecutaron las tres compilaciones, y es la razón por la que cada una sigue mejorando con cada ejecución. Las tres utilizaron la base de datos Actian VectorAI, alojada en sus propios servidores, para el almacenamiento persistente, la recuperación semántica de su propio historial y la escritura diferida condicionada a una señal verificada. Las tres la ejecutaron localmente, lo cual, para un agente que se modifica a sí mismo, tiene un valor intrínseco: el registro de lo que tu agente ha aprendido y por qué permanece en una infraestructura que tú controlas.
Empieza por la capa de memoria, ajusta bien la puerta de escritura y decide qué parte de la pila puede modificar el agente. Eso es lo que hace que la autoevolución sea duradera y no accidental. Ese orden es el camino más corto hacia un agente que, en su centésima ejecución, sea significativamente diferente de lo que era en la primera.
Para probar la configuración, prueba VectorAI DB Community Edition a través de Docker.
Mantente conectado
Te ofrecemos información detallada sobre los datos.
(por ejemplo, sales@..., support@...)
