Datenqualität | Der Unternehmensleitfaden zur Datenqualität
Datenqualität bezeichnet den Grad, in dem Daten genau, vollständig, konsistent, aktuell, gültig und eindeutig genug sind, um für den vorgesehenen Zweck geeignet zu sein. In der Praxis bedeutet dies, dass ein „ Datensatz “ nur dann als qualitativ hochwertig bezeichnet werden kann, wenn er die Entscheidung, den Prozess, die Analyse oder das KI-Modell, das darauf basiert, zuverlässig unterstützt.
Datenqualität ist kein technisches Merkmal, auf das man gerne verzichten kann. Sie wirkt sich auf die Umsatzberichterstattung, Customer-Experience, die Einhaltung von Vorschriften, die betriebliche Effizienz und das Vertrauen der Teams in die Daten aus, die sie täglich nutzen. Sind die Daten, die einem dashboard, Maschinelles Lernen Workflow oder einer behördlichen Einreichung zugrunde liegen, fehlerhaft, unvollständig, veraltet oder doppelt vorhanden, ist auch das Ergebnis unzuverlässig.
Was ist Datenqualität?
Die Datenqualität ist ein Maß dafür, inwieweit Daten festgelegte Standards für einen bestimmten use case erfüllen. Diese Standards umfassen in der Regel sechs Kernaspekte: Genauigkeit, Vollständigkeit, Beständigkeit, Aktualität, Gültigkeit und Eindeutigkeit.
Der entscheidende Begriff lautet „zweckmäßig“. Daten, die für einen bestimmten Zweck ausreichend sind, können für einen anderen Zweck ungeeignet sein. Kundendaten, die für die Rechnungsstellung präzise genug sind, sind möglicherweise nicht vollständig genug für die Vorhersage von Kundenabwanderungen. Finanzdaten, die für die interne Berichterstattung geeignet sind, erfüllen möglicherweise nicht die Anforderungen an Rückverfolgbarkeit und Genauigkeit, die für die externe aufsichtsrechtliche Berichterstattung gelten.
Aus diesem Grund legen Unternehmen Qualitätsschwellenwerte nach Fachbereich, Datensatz und Geschäftsprozess fest, anstatt davon auszugehen, dass überall ein einheitlicher Standard gilt.
Warum Datenqualität wichtig ist
Die Datenqualität ist entscheidend, da jede auf der Grundlage von Daten getroffene Entscheidung von der Zuverlässigkeit dieser Daten abhängt. Sinkt die Qualität, verlieren Analysen, Betriebsabläufe, Governance und KI an Zuverlässigkeit.
Bessere Entscheidungen
Prognosen, Leistungsberichte und strategische Pläne sind nur so gut wie die ihnen zugrunde liegenden Daten. Ungenaue Werte in der Vertriebspipeline verzerren Umsatzprognosen. Veraltete Bestandsdaten können zu Fehlern bei der Auftragsabwicklung führen. Uneinheitliche Definitionen in den verschiedenen Abteilungen führen dazu, dass Führungskräfte widersprüchliche Zahlen für dieselbe Kennzahl sehen.
Aufsichts- und Prüfungswesen Bereitschaft
Die Einhaltung von Vorschriften hängt von vertrauenswürdigen Aufzeichnungen ab. Genauigkeit, Vollständigkeit und Rückverfolgbarkeit sind entscheidend, wenn Unternehmen nachweisen müssen, dass die für die Berichterstattung oder den Umgang mit Kunden Aufzeichnung en verwendeten Daten zuverlässig sind. Qualitätsmängel können zu Problemen bei Prüfungen, Fehlern in der Berichterstattung und regulatorischen Risiken führen.
KI und Analytik, auf die Sie sich verlassen können
KI-Systeme übernehmen die Stärken und Schwächen ihrer „ Training “ sowie der Eingabedaten. Sind die Daten unvollständig, veraltet oder falsch gekennzeichnet, lernen die Modelle falsche Muster und liefern unzuverlässige Ergebnisse. Hochwertige Daten sind eine Grundvoraussetzung für vertrauenswürdige Analysen und KI-taugliche Informationen.
Geringere operative Reibungsverluste
Eine schlechte Datenqualität verursacht versteckten Arbeitsaufwand. Ingenieure beheben Fehler in den Datenpipelines, Analysten überprüfen Berichte erneut, und die Fachabteilungen korrigieren Datensätze manuell oder gleichen widersprüchliche Systeme ab. Selbst wenn das Problem für die Führungskräfte nicht sichtbar ist, machen sich die Kosten in Form von Verzögerungen, Nacharbeiten und Vertrauensverlust bemerkbar.
Die sechs Dimensionen der Datenqualität
Die gängigste Antwort auf die Frage „Welche Dimensionen umfasst die Datenqualität?“ lautet: sechs Kerndimensionen. Einige Rahmenwerke fügen weitere hinzu, wie beispielsweise Integrität oder Zuverlässigkeit, doch diese sechs bilden die standardmäßige Grundlage.
|
Dimension |
Was das bedeutet |
Beispiel für schlechte Datenqualität |
|---|---|---|
|
Genauigkeit |
Daten geben das reale Objekt, Ereignis oder den Wert, den sie beschreiben, korrekt wieder. |
Unter der Kundenadresse ist immer noch ein Standort angegeben, den der Kunde bereits vor zwei Jahren verlassen hat. |
|
Vollständigkeit |
Alle erforderlichen Felder und Datensätze sind vorhanden und nutzbar. |
In Tausenden von Kundendatensätzen fehlen E-Mail-Adressen oder Angaben zum Kontostatus. |
|
Beständigkeit |
Die gleichen Daten haben systemübergreifend dieselbe Bedeutung und dasselbe Format. |
„Aktiver Kunde“ bedeutet 90 Tage in einem System und 180 Tage in einem anderen. |
|
Rechtzeitigkeit |
Die Daten sind aktuell und stehen bei Bedarf zur Verfügung. |
Die gestrigen Bestandsdaten werden zur Bearbeitung der heutigen Bestellungen herangezogen. |
|
Gültigkeit |
Die Daten entsprechen dem vorgeschriebenen Format, Typ, Bereich und den Geschäftsregeln. |
Ein Datumsfeld enthält einen Wert, der keinem der zulässigen Datumsformate entspricht. |
|
Einzigartigkeit |
Jede reale Entität wird einmal dargestellt, ohne unnötige Duplikate. |
Derselbe Kunde taucht mehrmals mit geringfügigen Abweichungen in der Schreibweise auf. |
Unternehmen fragen manchmal nach den „5 Elementen“, den „7 C’s“ oder den „7 Dimensionen“ der Datenqualität. Dabei handelt es sich zwar um alternative Rahmenkonzepte, doch die meisten Unternehmensdatenprogramme konzentrieren sich nach wie vor auf die oben genannten sechs Dimensionen, da diese messbar, allgemein anerkannt und für die Governance sowie den Betrieb praktikabel sind.
Beispiel zur Datenqualität
Ein einfaches Beispiel für Datenqualität ist eine Kundentabelle, die für die Rechnungsstellung, das Marketing und den Kundensupport verwendet wird. Wenn ein Kunde dreimal aufgeführt ist, bei einem Kunden Aufzeichnung die Adresse veraltet ist und bei einem anderen die E-Mail-Adresse fehlt, weist die Datensatz Probleme hinsichtlich Eindeutigkeit, Richtigkeit und Vollständigkeit auf.
Diese Probleme haben konkrete Folgen:
- Rechnungen können an die falsche Adresse geschickt werden.
- Die Marketingabteilung versendet möglicherweise doppelte Kampagnennachrichten.
- Supportmitarbeiter haben möglicherweise keinen vollständigen Überblick über die Kundenbeziehung.
- Analytik-Teams könnten die Zahl der aktiven Kunden zu hoch ansetzen.
Ein Programm zur Datenqualitätssicherung würde diese Probleme mithilfe von Profiling-, Validierungs- und Abgleichregeln erkennen und anschließend die Ursachen an den Punkten der Dateneingabe, -integration und -synchronisation beheben.
Was führt zu schlechter Datenqualität?
Eine schlechte Datenqualität wird in der Regel eher durch Prozesslücken, Systemkomplexität und unzureichende Kontrollmechanismen verursacht als durch eine einzelne fehlerhafte Datenquelle ( Datensatz). Zu den häufigsten Ursachen zählen manuelle Eingabefehler, fehlende Validierungsregeln, inkonsistente Geschäftsdefinitionen, doppelte Datensätze, fehlerhafte Integrationen und Daten, die zu spät für die Datenverarbeitungsphase ( use case) eintreffen.
Zu den typischen Ursachen zählen:
- Manuelle Dateneingabe ohne Format- oder Wertprüfungen.
- Verschiedene Systeme, die unterschiedliche Definitionen für denselben Geschäftsbegriff verwenden.
- Unvollständige Ingest-Pipelines und Zuordnungsfehler während Dateneingang.
- Schemaänderungen, die nachgelagerte Transformationen und Regeln beeinträchtigen.
- Fehlende Dublettenbereinigung und Identitätsabgleich.
- Mangelndes Verantwortungsbewusstsein und fehlende Rechenschaftspflicht bei der Behebung wiederkehrender Probleme.
- Fehlender geschäftlicher Kontext in der Geschäftsglossar oder technischen Metadaten.
Qualitätsprobleme bleiben selten auf sich allein beschränkt. Ein einziges fehlerhaftes Quellsystem kann Fehler auf die Berichterstellung, die Analytik und KI-Pipelines ausweiten, wenn nicht frühzeitig Kontrollmaßnahmen ergriffen werden.
Wie die Datenqualität gemessen wird
Die Datenqualität wird gemessen, indem Datensätze anhand festgelegter Regeln, Schwellenwerte und erwarteter Muster geprüft werden. Die gängigsten Methoden sind Profiling, Validierung, Scoring und kontinuierliche Überwachung.
Datenprofilierung
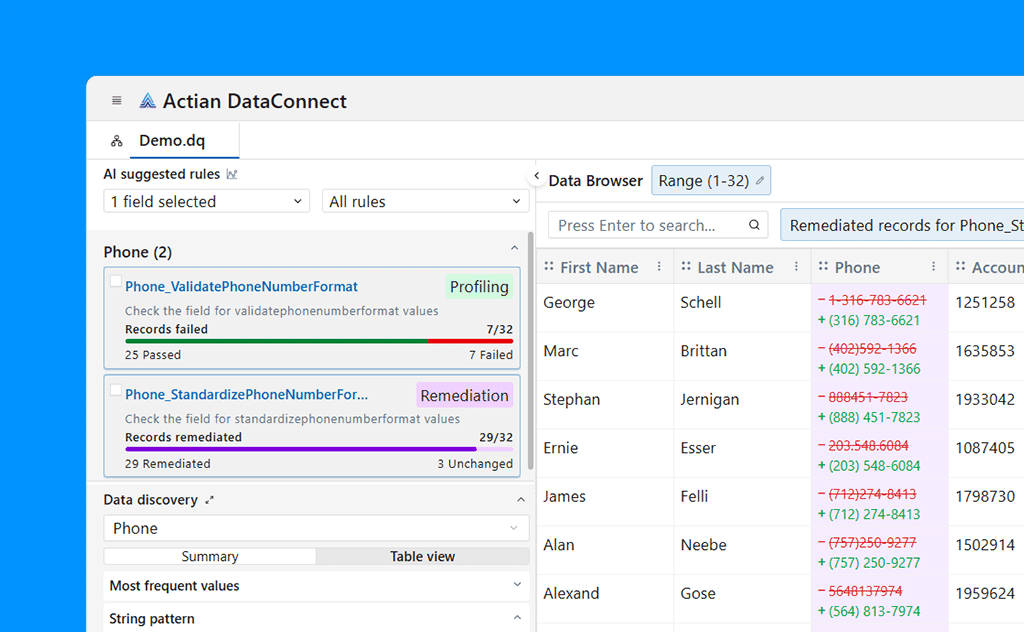
Bei der Datenprofilierung wird der tatsächliche Inhalt eines „ Datensatz “ untersucht, um Nullwerte, eindeutige Werte, Muster, Ausreißer, Verteilungen und Duplikate zu ermitteln. Die Profilierung dient als Ausgangsbasis und hilft den Teams, Probleme zu identifizieren, bevor Maßnahmen zur Behebung festgelegt werden.
Validierungsregeln
Validierungsregeln legen fest, wie zulässige Daten aussehen müssen. Diese Regeln können Pflichtfelder, zulässige Wertebereiche, akzeptierte Formate, referenzielle Integrität oder feldübergreifende Logik prüfen. Eine Regel könnte beispielsweise vorschreiben, dass jedes aktive Kundenkonto über eine gültige Region, einen gültigen Inhaber und ein gültiges Datum der letzten Aktivität verfügen muss.
Qualitätsbewertungen
Ein Datenqualitätswert ist eine numerische Zusammenfassung darüber, wie gut ein „ Datensatz “ die Prüfungen besteht. Beispielsweise kann ein „ Datensatz “, das 96 von 100 erforderlichen Tests besteht, einen Wert von 96 % erhalten. Anhand dieser Werte können Teams Assets vergleichen, Trends im Zeitverlauf verfolgen und entscheiden, ob ein „ Datensatz “ für den produktiven Einsatz bereit ist.
Kontinuierliche Überwachung
Die kontinuierliche Überwachung beobachtet Qualitätskennzahlen im Zeitverlauf und benachrichtigt die Teams, wenn Schwellenwerte überschritten werden. Dies ist besonders wichtig in modernen Pipelines, in denen Änderungen hinsichtlich Volumen, Schema oder Quellverhalten das Vertrauen in nachgelagerte Prozesse schnell untergraben können.
In der Praxis funktioniert die Qualitätsmessung am besten, wenn sie mit dem „ Metadaten “-Management, Geschäftsdefinitionen, der Nutzungshistorie und der Datenherkunft verknüpft ist. Dieser Kontext hilft den Nutzern zu verstehen, nicht nur, ob ein „ Datensatz “ eine Prüfung bestanden hat, sondern auch, warum das Ergebnis von Bedeutung ist und wer darauf reagieren sollte.
Dimensionen der Datenqualität im Vergleich zu verwandten Konzepten
Die Datenqualität steht in engem Zusammenhang mit verschiedenen anderen Bereichen der Datenwissenschaft, ist jedoch mit keinem davon identisch.
|
Konzept |
Inwiefern unterscheidet es sich von der Datenqualität? |
|---|---|
|
Datenqualitätsmanagement |
Datenqualität bezeichnet den Zustand der Daten. Das Datenqualitätsmanagement ist ein fortlaufendes Programm, mit dem dieser Zustand gemessen, verbessert und gesteuert wird. |
|
Data Governance |
Data Governance legt Richtlinien, Zuständigkeiten, Standards und Rechenschaftspflichten fest. Im Rahmen der Datenqualität werden diese Standards auf reale Datensätze angewendet. |
|
Das Daten Beobachtbarkeit überwacht den Zustand und das Verhalten von Datenpipelines und Datensätzen. Bei der Datenqualität steht im Vordergrund, ob die Daten selbst für die Verwendung geeignet sind. |
|
|
Datenbereinigung behebt bestehende Probleme. Zur Datenqualität gehören Prävention, Messung, Überwachung und die Beseitigung der Ursachen – nicht nur die Bereinigung. |
|
|
Datengenauigkeit |
Die Genauigkeit ist nur ein Aspekt der Datenqualität, nicht das gesamte Konzept. Ein „ Datensatz “ kann zwar genau sein, aber dennoch unvollständig, veraltet oder doppelt vorhanden sein. |
Wie sich gute Datenqualität in der Praxis zeigt
Gute Datenqualität bedeutet, dass Nutzer Daten finden, verstehen und ihnen vertrauen können, ohne jedes Mal dieselben manuellen Überprüfungen wiederholen zu müssen. Sie ist sichtbar, messbar und in den geschäftlichen Kontext eingebettet.
In einer ausgereiften Umgebung:
- Ein Datenanalyst kann Datensätze vor ihrer Verwendung hinsichtlich ihres Zertifizierungsstatus, ihrer Aktualität und ihres Qualitätswerts vergleichen.
- Ein Dateningenieur kann die Auswirkungen auf nachgelagerte Prozesse abschätzen, bevor er ein Schema ändert, da Abhängigkeiten und die Datenherkunft sichtbar sind.
- Ein Verwalter oder Eigentümer kann wiederkehrende Mängel bis zum Quellsystem zurückverfolgen und die Verantwortung für deren Behebung zuweisen.
- Geschäftsanwender können Kennzahlen einheitlich interpretieren, da Geschäftsbegriffe, Regeln und „ Metadaten “ miteinander verknüpft sind.
Genau hier kommt einem modernen Data-Intelligence-Ansatz eine entscheidende Rolle zu. Zuverlässige, KI-fähige Daten beruhen nicht nur auf isolierten Regeln. Sie hängen davon ab, dass technische Metadaten, geschäftliche Definitionen, Zuständigkeiten, Nutzung und Datenherkunft über verteilte Systeme hinweg miteinander verknüpft werden, damit Qualitätsprobleme im Kontext verstanden und an der Quelle behoben werden können.
Bewährte Verfahren zur Verbesserung der Datenqualität
Die Verbesserung der Datenqualität erfordert einen wiederholbaren Prozess Framework und kein einmaliges Bereinigungsprojekt. Die effektivsten Programme verbinden Governance, Automatisierung und Verantwortlichkeit.
- Definieren Sie Qualität anhand von use case. Legen Sie Schwellenwerte je nach Bereich und geschäftlichen Anforderungen fest, anstatt sich auf allgemeine Standards zu verlassen.
- Verantwortlichkeiten zuweisen. Klären Sie, wem die Daten gehören, wer sie „ Datenverwalter “ und wer wiederkehrende Probleme behebt.
- Definitionen vereinheitlichen. Geschäftsbegriffe, Regeln und Feldbedeutungen systemübergreifend vereinheitlichen.
- Frühzeitig validieren. Erkennen Sie Probleme bereits an den Eingabe-, Erfassungs- und Transformationspunkten, anstatt darauf zu warten, dass Berichte fehlschlagen.
- Kontinuierlich überwachen. Verfolgen Sie die Qualität im Zeitverlauf und benachrichtigen Sie die Teams, wenn sich die Bedingungen ändern.
- Kontext verknüpfen. Verknüpfen Sie Qualitätskennzahlen mit „ Metadaten “, der Herkunftsverfolgung und der nachgelagerten Nutzung, damit Teams die Auswirkungen von Fehlern erkennen können.
FAQ
Datenqualität bezeichnet, inwieweit Daten den für ihren Verwendungszweck erforderlichen Standards entsprechen. In den meisten Organisationen bedeutet dies, dass die Daten genau, vollständig, konsistent, aktuell, gültig und eindeutig genug sind, um zuverlässige Entscheidungen und Abläufe zu unterstützen.
Einige Quellen beschreiben fünf Elemente der Datenqualität, doch gibt es kein einheitliches, allgemeingültiges Fünf-Teile-Modell. Das am weitesten verbreitete Unternehmens Framework l umfasst sechs Dimensionen: Genauigkeit, Vollständigkeit, Beständigkeit, Aktualität, Gültigkeit und Eindeutigkeit.
Viele Teams verwenden sechs Kerndimensionen und fügen eine siebte hinzu, wie beispielsweise Integrität, Zuverlässigkeit oder Konformität. Die genaue Liste variiert je nach Framework, doch die standardmäßige Grundlage bilden weiterhin Genauigkeit, Vollständigkeit, Beständigkeit, Aktualität, Gültigkeit und Eindeutigkeit.
Die „7 C’s“ sind eine alternative Methode, mit der manche Organisationen die Merkmale der Datenqualität beschreiben, stellen jedoch nicht das vorherrschende Unternehmensmodell dar. Die meisten Fachleute strukturieren ihre Arbeit im Bereich der Datenqualität nach wie vor anhand messbarer Dimensionen wie Genauigkeit, Vollständigkeit, Beständigkeit, Aktualität, Gültigkeit und Eindeutigkeit.
Ein Datenqualitätswert ist eine numerische Zusammenfassung darüber, wie gut ein „ Datensatz “ die festgelegten Prüfungen besteht. Er hilft Teams dabei, Assets zu vergleichen, Trends zu beobachten und zu entscheiden, ob die Daten für die Berichterstellung, Analysen oder den Einsatz von KI bereit sind.
Die Datenqualität wirkt sich direkt auf die KI aus, da Modelle aus den ihnen zur Verfügung gestellten Daten lernen. Ungenaue, unvollständige, inkonsistente oder veraltete Daten führen zu schwachen „ Training “-Signalen, unzuverlässigen Vorhersagen und Ergebnissen, denen man nur schwer vertrauen oder die man nur schwer verteidigen kann.
Die Verantwortung für die Datenqualität wird gemeinsam getragen. Die Dateneigentümer sind für die Geschäftsergebnisse verantwortlich, die Daten Datenverwalter verwalten die täglichen Qualitätsprozesse, und die technischen Teams setzen die Kontrollen, Pipelines und Überwachungsmaßnahmen um, mit denen die Standards durchgesetzt werden.
Die Datengenauigkeit ist ein Aspekt der Datenqualität. Bei der Genauigkeit geht es darum, ob ein Wert korrekt ist, während die Datenqualität eine breitere Palette von Merkmalen bewertet, darunter Vollständigkeit, Beständigkeit, Aktualität, Gültigkeit und Eindeutigkeit.