Calidad de los datos | La guía empresarial sobre la calidad de los datos
La calidad de los datos es el grado en que estos son lo suficientemente precisos, completos, coherentes, oportunos, válidos y únicos como para ser adecuados para el fin al que están destinados. En la práctica, esto significa que un conjunto de datos solo puede considerarse de alta calidad si respalda de forma fiable la decisión, el proceso, el análisis o el modelo de inteligencia artificial que depende de él.
La calidad de los datos no es un simple atributo técnico «opcional». Influye en la presentación de informes de ingresos, la experiencia del cliente, el cumplimiento normativo, la eficiencia operativa y la confianza que los equipos depositan en los datos que utilizan a diario. Si los datos en los que se basan un panel de control, un flujo de trabajo de aprendizaje automático o una presentación reglamentaria son erróneos, incompletos, obsoletos o están duplicados, el resultado tampoco será fiable.
¿Qué es la calidad de los datos?
La calidad de los datos es una medida de hasta qué punto los datos cumplen con los estándares definidos para un caso de uso concreto. Dichos estándares suelen incluir seis dimensiones fundamentales: precisión, exhaustividad, coherencia, actualidad, validez y unicidad.
La frase clave es «adecuado para su finalidad». Los datos que son suficientes para un uso pueden no serlo para otro. Los registros de clientes lo suficientemente precisos para la facturación pueden no ser lo bastante completos para la predicción de la pérdida de clientes. Los datos financieros adecuados para la elaboración de informes internos pueden no cumplir los requisitos de trazabilidad y precisión exigidos por los informes reglamentarios externos.
Por eso las organizaciones definen umbrales de calidad por ámbito, conjunto de datos y proceso empresarial, en lugar de dar por sentado que existe una norma universal válida para todos los casos.
Por qué es importante la calidad de los datos
La calidad de los datos es importante porque toda decisión que se tome a partir de ellos depende de la fiabilidad de dichos datos. Cuando la calidad disminuye, tanto los análisis como las operaciones, la gobernanza y la inteligencia artificial pierden credibilidad.
Mejores decisiones
Las previsiones, los informes de rendimiento y los planes estratégicos solo son tan fiables como los datos en los que se basan. Los valores inexactos del proceso de ventas distorsionan las previsiones de ingresos. Los datos de inventario desactualizados pueden provocar errores en la gestión de pedidos. Las definiciones inconsistentes entre departamentos hacen que los ejecutivos vean cifras contradictorias para una misma métrica empresarial.
Preparación normativa y de auditoría
El cumplimiento normativo depende de que los registros sean fiables. La precisión, la exhaustividad y la trazabilidad son factores fundamentales cuando las organizaciones deben demostrar que los datos utilizados en la elaboración de informes o en la gestión de los registros de clientes son fiables. Las deficiencias en la calidad pueden dar lugar a problemas de auditoría, errores en los informes y riesgos normativos.
Inteligencia artificial y análisis en los que puedes confiar
Los sistemas de IA heredan los puntos fuertes y débiles de sus datos de entrenamiento y de entrada. Si los datos están incompletos, desactualizados o mal etiquetados, los modelos aprenden patrones erróneos y generan resultados poco fiables. Disponer de datos de alta calidad es un requisito imprescindible para obtener análisis fiables e información apta para la IA.
Menor fricción operativa
La mala calidad de los datos genera trabajo oculto. Los ingenieros se ven obligados a solucionar problemas en los flujos de datos defectuosos, los analistas vuelven a comprobar los informes y los equipos de negocio corrigen manualmente los registros o concilian sistemas contradictorios. Aunque el problema no sea visible para la dirección, el coste se traduce en retrasos, trabajo repetido y pérdida de confianza.
Las seis dimensiones de la calidad de los datos
La respuesta más habitual a la pregunta «¿cuáles son las dimensiones de la calidad de los datos?» es que hay seis dimensiones fundamentales. Algunos marcos de referencia añaden otras, como la integridad o la fiabilidad, pero estas seis constituyen la base estándar.
|
Dimensión |
Qué significa |
Ejemplo de mala calidad de los datos |
|---|---|---|
|
Precisión |
Los datos representan correctamente el objeto, el suceso o el valor del mundo real que describen. |
La dirección de un cliente sigue indicando una ubicación de la que se marchó hace dos años. |
|
Integridad |
Todos los campos y registros obligatorios están presentes y son utilizables. |
En miles de registros de clientes faltan direcciones de correo electrónico o valores de estado de la cuenta. |
|
cohérence |
Los mismos datos tienen el mismo significado y formato en todos los sistemas. |
Por «cliente activo» se entiende una permanencia de 90 días en un sistema y de 180 días en otro. |
|
Oportunidad |
Los datos están actualizados y disponibles cuando se necesitan. |
Los datos de existencias de ayer se utilizan para tramitar los pedidos de hoy. |
|
Validez |
Los datos se ajustan al formato, tipo, rango y reglas de negocio exigidos. |
Un campo de fecha contiene un valor que no se ajusta a ningún formato de fecha válido. |
|
Singularidad |
Cada entidad del mundo real se representa una sola vez, sin duplicados innecesarios. |
El mismo cliente aparece varias veces con ligeras diferencias ortográficas. |
A veces, las organizaciones preguntan por los «5 elementos», las «7 C» o las «7 dimensiones» de la calidad de los datos. Se trata de marcos alternativos, pero la mayoría de los programas de datos empresariales siguen centrándose en las seis dimensiones mencionadas anteriormente, ya que son medibles, se comprenden ampliamente y resultan prácticas para la gobernanza y las operaciones.
Ejemplo de calidad de los datos
Un ejemplo sencillo de calidad de los datos es una tabla de clientes que se utiliza para la facturación, el marketing y la atención al cliente. Si un cliente aparece tres veces, un registro tiene una dirección desactualizada y a otro le falta la dirección de correo electrónico, el conjunto de datos presenta problemas de unicidad, exactitud y exhaustividad.
Esos problemas tienen consecuencias reales:
- Es posible que los extractos de facturación se envíen a una dirección incorrecta.
- Es posible que el departamento de marketing envíe mensajes duplicados de las campañas.
- Es posible que los agentes de atención al cliente no tengan una visión completa de la relación con el cliente.
- Es posible que los equipos de análisis sobreestimen el número de clientes activos.
Un programa de calidad de datos detectaría esos problemas mediante el análisis de perfiles, la validación y las reglas de correspondencia, y posteriormente subsanaría las causas fundamentales en los puntos de introducción, integración y sincronización de los datos.
¿A qué se debe la mala calidad de los datos?
La mala calidad de los datos suele deberse a deficiencias en los procesos, a la complejidad de los sistemas y a controles deficientes, más que a un único conjunto de datos erróneo. Entre las causas más comunes se encuentran los errores de introducción manual, la falta de reglas de validación, las definiciones empresariales incoherentes, los registros duplicados, las integraciones defectuosas y los datos que llegan demasiado tarde para el caso de uso.
Entre las causas fundamentales más habituales se encuentran:
- Introducción manual de datos sin comprobaciones de formato ni de valores.
- Diferentes sistemas que utilizan definiciones distintas para el mismo término empresarial.
- Procesos de importación incompletos y errores de mapeo durante la importación de datos.
- Cambios en el esquema que impiden el correcto funcionamiento de las transformaciones y reglas posteriores.
- Falta de deduplicación y de cotejo de identidades.
- Falta de compromiso y de responsabilidad a la hora de resolver los problemas recurrentes.
- Falta contexto empresarial en el glosario empresarial o en los metadatos técnicos.
Los problemas de calidad rara vez se limitan a un caso aislado. Un sistema fuente inexacto puede propagar errores a los procesos de generación de informes, análisis y inteligencia artificial si no se establecen controles con la suficiente antelación.
Cómo se mide la calidad de los datos
La calidad de los datos se mide comparando los conjuntos de datos con reglas, umbrales y patrones esperados previamente definidos. Los métodos más habituales son la elaboración de perfiles, la validación, la puntuación y la supervisión continua.
Perfilado de datos
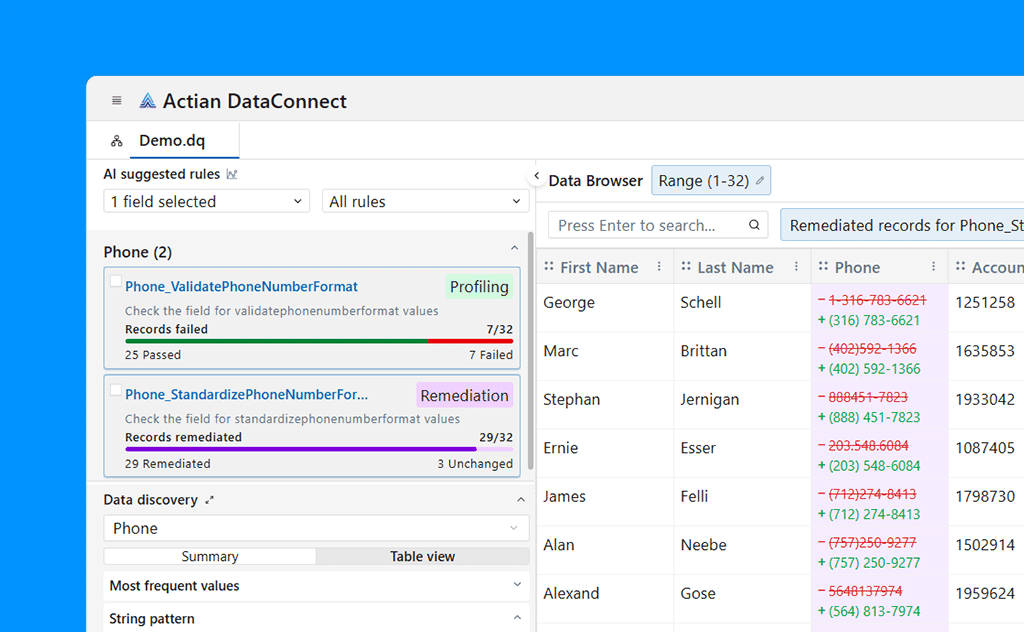
La elaboración de perfiles de datos consiste en examinar el contenido real de un conjunto de datos para comprender las tasas de valores nulos, los valores distintos, los patrones, los valores atípicos, las distribuciones y las tasas de duplicados. La elaboración de perfiles establece una referencia y ayuda a los equipos a detectar problemas antes de definir las medidas correctoras.
Reglas de validación
Las reglas de validación especifican cómo deben ser los datos aceptables. Estas reglas pueden comprobar los campos obligatorios, los rangos permitidos, los formatos aceptados, la integridad referencial o la lógica entre campos. Por ejemplo, una regla podría exigir que todas las cuentas de clientes activas tengan una región, un titular y una fecha de última actividad válidas.
Puntuaciones de calidad
Una puntuación de calidad de los datos es un resumen numérico que indica en qué medida un conjunto de datos supera las comprobaciones correspondientes. Por ejemplo, un conjunto de datos que supere 96 de las 100 pruebas obligatorias puede recibir una puntuación del 96 %. Las puntuaciones ayudan a los equipos a comparar activos, realizar un seguimiento de las tendencias a lo largo del tiempo y decidir si un conjunto de datos está listo para su uso en producción.
Supervisión continua
La supervisión continua analiza los indicadores de calidad a lo largo del tiempo y avisa a los equipos cuando se superan los umbrales establecidos. Esto resulta especialmente importante en los flujos de trabajo modernos, en los que los cambios en el volumen, el esquema o el comportamiento de las fuentes pueden mermar rápidamente la confianza en las fases posteriores del proceso.
En la práctica, la medición de la calidad funciona mejor cuando se vincula a la gestión de metadatos, las definiciones de negocio, el historial de uso y el linaje. Ese contexto ayuda a los usuarios a comprender no solo si un conjunto de datos ha superado una comprobación, sino también por qué el resultado es importante y quién debe actuar en consecuencia.
Dimensiones de la calidad de los datos frente a conceptos relacionados
La calidad de los datos está estrechamente relacionada con otras disciplinas relacionadas con los datos, pero no es lo mismo que ninguna de ellas.
|
Concepto |
En qué se diferencia de la calidad de los datos |
|---|---|
|
Gestión de la calidad de los datos |
La calidad de los datos es el estado en que se encuentran estos. La gestión de la calidad de los datos es el programa continuo que se utiliza para medir, mejorar y regular dicho estado. |
|
Gobernanza de datos |
La gobernanza de los datos define las políticas, la titularidad, las normas y la rendición de cuentas. La calidad de los datos aplica esas normas a conjuntos de datos reales. |
|
La observabilidad de los datos supervisa el estado y el comportamiento de los flujos de datos y los conjuntos de datos. La calidad de los datos se centra en determinar si los datos en sí mismos son aptos para su uso. |
|
|
La limpieza de datos soluciona los problemas existentes. La calidad de los datos abarca la prevención, la medición, el seguimiento y la mejora de las causas fundamentales, no solo la limpieza. |
|
|
Exactitud de los datos |
La precisión es una de las dimensiones de la calidad de los datos, pero no el concepto en su totalidad. Un conjunto de datos puede ser preciso, pero aun así estar incompleto, desactualizado o contener duplicados. |
Cómo se traduce en la práctica una buena calidad de los datos
Una buena calidad de los datos significa que los usuarios pueden encontrar, comprender y confiar en los datos sin tener que repetir las mismas comprobaciones manuales cada vez. Es visible, medible y está vinculada al contexto empresarial.
En un entorno maduro:
- Un analista de datos puede comparar conjuntos de datos en función de su estado de certificación, su actualidad y su puntuación de calidad antes de utilizarlos.
- Un ingeniero de datos puede evaluar el impacto en las fases posteriores antes de modificar un esquema, ya que las dependencias y el linaje de los datos son visibles.
- Un administrador o propietario puede rastrear los defectos recurrentes hasta el sistema de origen y asignar la responsabilidad de su corrección.
- Los usuarios empresariales pueden interpretar las métricas de forma coherente, ya que los términos empresariales, las reglas y los metadatos están interrelacionados.
Aquí es donde cobra importancia un enfoque moderno de inteligencia de datos. Para disponer de datos fiables y preparados para la inteligencia artificial no basta con reglas aisladas. Es necesario conectar los metadatos técnicos, las definiciones empresariales, la titularidad, el uso y el linaje a través de sistemas distribuidos, de modo que los problemas de calidad puedan entenderse en su contexto y resolverse en el origen.
Buenas prácticas para mejorar la calidad de los datos
Para mejorar la calidad de los datos se necesita un marco repetible, no un proyecto de limpieza puntual. Los programas más eficaces combinan gobernanza, automatización y rendición de cuentas.
- Define la calidad en función de cada caso de uso. Establece umbrales en función del ámbito y las necesidades empresariales, en lugar de basarte en normas genéricas.
- Asignar la titularidad. Aclara quién es el propietario de los datos, quién se encarga de su gestión y quién resuelve los problemas recurrentes.
- Estandarizar las definiciones. Armonizar los términos empresariales, las reglas y los significados de los campos en todos los sistemas.
- Valida lo antes posible. Detecta los problemas en los puntos de entrada, ingesta y transformación, en lugar de esperar a que los informes den error.
- Realiza un seguimiento continuo. Realice un seguimiento de la calidad a lo largo del tiempo y avise a los equipos cuando cambien las condiciones.
- Relaciona el contexto. Relaciona las métricas de calidad con los metadatos, el linaje y el uso posterior para que los equipos conozcan el impacto de los defectos.
Preguntas frecuentes
La calidad de los datos se refiere al grado en que estos cumplen los estándares exigidos para el uso previsto. En la mayoría de las organizaciones, esto significa que los datos son lo suficientemente precisos, completos, coherentes, actuales, válidos y únicos como para respaldar decisiones y operaciones fiables.
Algunas fuentes describen cinco elementos de la calidad de los datos, pero no existe un único modelo universal de cinco partes. El marco empresarial más utilizado incluye seis dimensiones: precisión, exhaustividad, coherencia, puntualidad, validez y unicidad.
Muchos equipos utilizan seis dimensiones fundamentales y añaden una séptima, como la integridad, la fiabilidad o la conformidad. La lista exacta varía según el marco de referencia, pero la base estándar sigue siendo la precisión, la exhaustividad, la coherencia, la puntualidad, la validez y la singularidad.
Las «7 C» son una forma alternativa en la que algunas organizaciones describen los atributos de la calidad de los datos, pero no constituyen el modelo empresarial predominante. La mayoría de los profesionales siguen organizando el trabajo relacionado con la calidad de los datos en torno a dimensiones cuantificables, como la precisión, la exhaustividad, la coherencia, la puntualidad, la validez y la unicidad.
Una puntuación de calidad de los datos es un resumen numérico que indica en qué medida un conjunto de datos supera las comprobaciones establecidas. Ayuda a los equipos a comparar activos, supervisar tendencias y decidir si los datos están listos para su uso en informes, análisis o inteligencia artificial.
La calidad de los datos afecta directamente a la IA, ya que los modelos aprenden a partir de los datos que se les proporcionan. Los datos inexactos, incompletos, incoherentes u obsoletos dan lugar a señales de entrenamiento débiles, predicciones poco fiables y resultados en los que es más difícil confiar o defender.
La responsabilidad sobre la calidad de los datos es compartida. Los propietarios de los datos son responsables de los resultados empresariales, los gestores de datos se encargan de los procesos cotidianos de control de calidad y los equipos técnicos se encargan de implementar los controles, los flujos de trabajo y la supervisión que garantizan el cumplimiento de las normas.
La exactitud de los datos es uno de los aspectos de la calidad de los datos. La exactitud se refiere a si un valor es correcto, mientras que la calidad de los datos evalúa un conjunto más amplio de características, entre las que se incluyen la exhaustividad, la coherencia, la actualidad, la validez y la unicidad.